

Salut, Habr ! Nous invitons des Data Engineers et des spécialistes en Machine Learning à un cours de démonstration gratuit . Et nous publions aussi un article de Luca Monno — Responsable de l'Analyse Financière chez CDP SpA.
L'une des méthodes les plus utiles et les plus simples d'apprentissage automatique est l'Ensemble Learning. L'Ensemble Learning est une méthode qui sous-tend XGBoost, le Bagging, le Random Forest et de nombreux autres algorithmes.
Sur Towards Data Science, il y a beaucoup d'articles intéressants, mais j'ai choisi deux histoires ( et ), qui m'ont le plus plu. Alors, pourquoi écrire un autre article sur l'EL ? Parce que je veux vous montrer comment cela fonctionne à travers un exemple simple, qui m'a fait comprendre qu'il n'y a pas de magie ici.
Quand j'ai vu l'EL en action (en travaillant avec quelques modèles de régression très simples), je n'en croyais pas mes yeux, et je me souviens encore du professeur qui m'a appris cette méthode.
J'avais deux modèles différents (deux algorithmes d'apprentissage faibles) avec des scores hors échantillon R² de 0,90 et 0,93 respectivement. Avant de regarder le résultat, je pensais que j'obtiendrais un R² quelque part entre les deux valeurs initiales. En d'autres termes, je pensais que l'EL pouvait être utilisé pour que le modèle ne fonctionne pas aussi mal que le pire, mais pas aussi bien que le meilleur modèle pourrait fonctionner.
À ma grande surprise, les résultats de la simple moyenne des prédictions ont donné un R² de 0,95.
Au début, j'ai commencé à chercher l'erreur, mais ensuite j'ai pensé qu'il pouvait y avoir une certaine magie !
Qu'est-ce que l'Ensemble Learning
Avec l'EL, on peut combiner les prédictions de deux modèles ou plus pour obtenir un modèle plus fiable et performant. Il existe de nombreuses méthodologies de travail avec des ensembles de modèles. Ici, je vais aborder les deux plus utiles pour donner une idée générale.
Avec la régression on peut faire la moyenne des performances des modèles existants.
Avec la classification permet aux modèles de choisir les étiquettes. L'étiquette choisie le plus souvent est celle qui sera sélectionnée par le nouveau modèle.
Pourquoi l'EL fonctionne mieux
La principale raison pour laquelle l'EL fonctionne mieux est que chaque prédiction a une erreur (nous le savons par la théorie des probabilités). La combinaison de deux prédictions peut aider à réduire l'erreur et, par conséquent, à améliorer les performances (RMSE, R², etc.).
Le graphique suivant montre comment deux algorithmes faibles fonctionnent avec un ensemble de données. Le premier algorithme a un coefficient angulaire plus élevé que nécessaire, tandis que le second est presque égal à zéro (peut-être en raison d'une régularisation excessive). Mais l'ensemble donne un résultat bien meilleur.
Si l'on considère la valeur de R², le premier et le deuxième algorithme d'apprentissage auront respectivement des valeurs de -0,01¹ et 0,22, tandis que l'ensemble aura une valeur de 0,73.
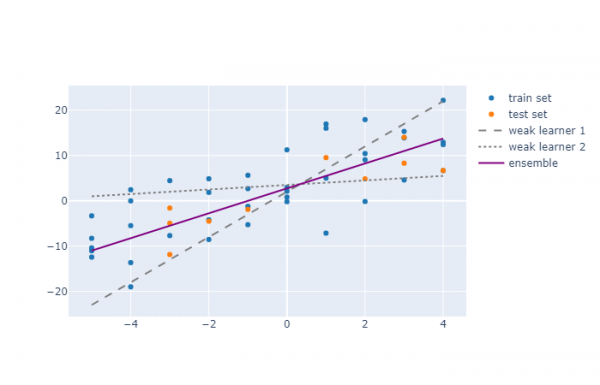
Il existe de nombreuses raisons pour lesquelles un algorithme peut se révéler une mauvaise modélisation même dans un exemple aussi basique que celui-ci : peut-être avez-vous choisi d'utiliser une régularisation pour éviter le sur-apprentissage, ou vous avez décidé de ne pas exclure certaines anomalies, ou peut-être avez-vous utilisé une régression polynomiale et choisi un mauvais degré (par exemple, utilisé un polynôme de second degré alors que les données test montrent une asymétrie évidente qui nécessiterait un degré supérieur).
Quand l'EL fonctionne mieux
Considérons deux algorithmes d'apprentissage travaillant avec les mêmes données.
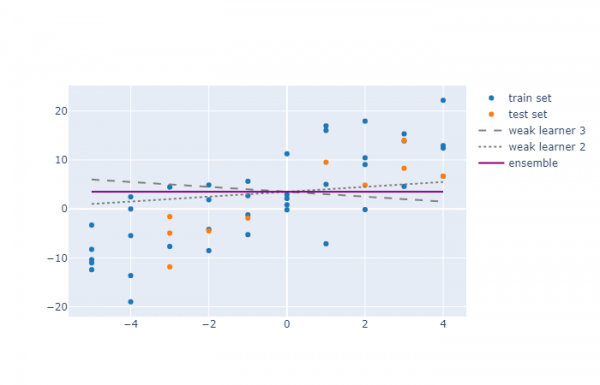
Ici, nous voyons que la combinaison de deux modèles n'a pas beaucoup amélioré les performances. Initialement, pour les deux algorithmes d'apprentissage, les valeurs de R² étaient respectivement de -0,37 et 0,22, tandis que pour l'ensemble, cela a donné -0,04. Cela signifie que le modèle EL a obtenu une moyenne des performances.
Cependant, il existe une grande différence entre ces deux exemples : dans le premier exemple, les erreurs des modèles étaient corrélées négativement, tandis que dans le second, elles l'étaient positivement (les coefficients des trois modèles n'ont pas été évalués, mais simplement choisis par l'auteur à titre d'exemple).
Par conséquent, l'apprentissage en ensemble peut être utilisé pour améliorer l'équilibre biais/variance dans tous les cas, mais lorsque les erreurs des modèles ne sont pas corrélées positivement, l'utilisation de l'EL peut entraîner une amélioration des performances..
Modèles homogènes et hétérogènes
L'EL est souvent utilisé avec des modèles homogènes (comme dans cet exemple ou dans une forêt aléatoire), mais vous pouvez en réalité combiner différents modèles (régression linéaire + réseau de neurones + XGBoost) avec divers ensembles de variables explicatives. Cela entraînera probablement des erreurs non corrélées et une amélioration des performances.
Comparaison avec la diversification de portefeuille
L'EL fonctionne de manière analogue à la diversification en théorie de portefeuille, mais c'est encore mieux pour nous.
Avec la diversification, vous essayez de réduire la dispersion de vos indicateurs en investissant dans des actions non corrélées. Un portefeuille d'actions bien diversifié affichera une performance meilleure que l'action la plus mauvaise, mais jamais mieux que l'action la meilleure.
En citant Warren Buffett :
« La diversification est une protection contre l'ignorance, pour celui qui ne sait pas ce qu'il fait, elle [la diversification] a très peu de sens. »
En apprentissage automatique, l'EL aide à réduire la dispersion de votre modèle, mais cela peut conduire à la création d'un modèle avec une performance globale meilleure que celle du meilleur modèle initial.
Pour résumer
Combiner plusieurs modèles en un seul est une méthode relativement simple qui peut résoudre le problème de biais-variance et améliorer la performance.
Si vous avez deux modèles ou plus qui fonctionnent bien, ne choisissez pas entre eux : utilisez-les tous (mais avec prudence) !
Intéressé à développer dans ce domaine ? Inscrivez-vous pour un cours Demo gratuit et participez à — Ingénieur en apprentissage automatique chez Mail.ru Group.
Source : habr.com
