

La classification des données basée sur le contenu est un problème ouvert. Les systèmes traditionnels de prévention de la perte de données (DLP) abordent ce problème en créant des empreintes des données concernées et en surveillant les points finaux. Étant donné le grand nombre de ressources de données en constante évolution sur Facebook, cette approche n'est pas seulement non évolutive, mais elle est également inefficace pour déterminer où se trouvent les données. Cet article se concentre sur un système de bout en bout conçu pour détecter des types sémantiques sensibles sur Facebook à grande échelle et pour garantir automatiquement le stockage des données et le contrôle d'accès.
L'approche décrite ici est notre premier système de confidentialité de bout en bout, qui tente de résoudre ce problème en intégrant des signaux de données, de l'apprentissage automatique et des méthodes traditionnelles d'empreintes pour afficher et classifier toutes les données sur Facebook. Le système décrit est exploité dans un environnement de production, atteignant un score moyen F2 de 0,9+ pour diverses catégories de confidentialité tout en traitant un grand nombre de ressources de données dans des dizaines de stockages. Nous présentons la traduction de la publication Facebook sur ArXiv concernant la classification des données évolutive pour garantir la sécurité et la confidentialité basées sur l'apprentissage automatique.
Introduction
Aujourd'hui, les organisations collectent et stockent de grands volumes de données dans divers formats et emplacements [1], puis les données sont utilisées dans de nombreux endroits, parfois copiées ou mises en cache plusieurs fois, entraînant la dispersion d'informations commerciales précieuses et confidentielles à travers de nombreux entrepôts de données d'entreprise. Lorsqu'une organisation doit se conformer à certaines exigences légales ou réglementaires, comme respecter les règlements durant un procès civil, il devient nécessaire de collecter des données sur l'emplacement des données requises. Lorsque l'ordonnance de confidentialité stipule qu'une organisation doit masquer tous les numéros de sécurité sociale (NSS) lors de la transmission d'informations personnelles à des tiers non autorisés, la première étape naturelle consiste à rechercher tous les NSS dans les entrepôts de données de l'ensemble de l'organisation. Dans de telles circonstances, la classification des données devient cruciale [1]. Un système de classification permettra aux organisations d'assurer automatiquement le respect de la confidentialité et des politiques de sécurité, telles que l'inclusion de politiques de gestion des accès et de conservation des données. Facebook présente un système conçu par nos soins chez Facebook, qui utilise de nombreux signaux de données, une architecture système évolutive et l'apprentissage automatique pour détecter des types de données sémantiques sensibles.
La détection et la classification des données consistent à chercher et à étiqueter les données de manière à ce que l'information pertinente puisse être extraite rapidement et efficacement si nécessaire. Le processus actuel est plutôt manuel et consiste à examiner les lois ou règlements pertinents, à déterminer quels types d'informations doivent être considérés comme sensibles et quels sont les différents niveaux de sensibilité, puis à construire des classes et des politiques de classification appropriées [1]. Après cela, les systèmes de prévention de la perte de données (DLP) créent des empreintes des données et suivent les points de terminaison en aval pour obtenir les empreintes. Travailler avec un stockage contenant un grand nombre d'actifs et des pétaoctets de données, une telle approche n'est tout simplement pas évolutive.
Notre objectif est de construire un système de classification des données qui se développe à la fois pour les données stables et instables, sans aucune restriction supplémentaire sur le type ou le format des données. C'est un objectif audacieux, et il est naturellement associé à des défis. Toute entrée de données peut faire des milliers de caractères de long.
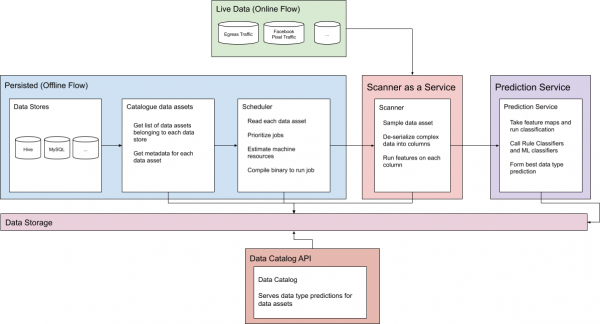
Figure 1. Flux de prévisions en ligne et hors ligne
Nous devons donc la représenter efficacement, en utilisant un ensemble de caractéristiques communes qui peuvent ensuite être intégrées et facilement transférées. Ces caractéristiques doivent non seulement garantir une classification précise, mais aussi assurer la flexibilité et l'évolutivité pour l'ajout et la découverte faciles de nouveaux types de données à l'avenir. Deuxièmement, il faut gérer de grandes tables autonomes. Les données stables peuvent être stockées dans des tables de plusieurs pétaoctets. Cela peut entraîner une diminution de la vitesse de scan. Troisièmement, nous devons respecter une classification SLA stricte pour les données instables. Cela oblige le système à être hautement performant, rapide et précis. Enfin, nous devons garantir une classification à faible latence pour les données instables, afin d'effectuer une classification en temps réel, ainsi que pour des cas d'utilisation sur Internet.
Cet article décrit comment nous avons abordé les problèmes mentionnés ci-dessus, et présente un système de classification rapide et évolutif qui classe les éléments de données de tous types, formats et sources, basé sur un ensemble de caractéristiques communes. Nous avons étendu l'architecture système et créé un modèle d'apprentissage automatique dédié pour la classification rapide des données en ligne et hors ligne. Cet article est organisé comme suit : dans la section 2, nous présentons la conception générale du système. La section 3 discute des parties du système d'apprentissage automatique. Les sections 4 et 5 traitent du travail connexe et tracent de futures directions.
Architecture
Pour faire face aux défis des données stables et des données en ligne à l'échelle de Facebook, le système de classification dispose de deux flux distincts que nous détaillerons.
Données stables
Le système doit d'abord identifier de nombreux actifs d'information sur Facebook. Pour chaque stockage, des informations de base sont collectées, telles que le centre de données contenant ces données, le système qui gère ces données et les actifs situés dans un stockage de données spécifique. Cela forme un catalogue de métadonnées permettant au système d'extraire efficacement des données sans surcharger les clients et les ressources utilisées par d'autres ingénieurs.
Ce catalogue de métadonnées fournit une source fiable pour tous les actifs scannés et permet de suivre l'état des différents actifs. Grâce à ces informations, la priorité du planning est établie en fonction des données collectées et des informations internes du système, telles que la dernière fois que l'actif a été scanné avec succès et sa date de création, ainsi que les anciennes demandes de mémoire et de processeur pour cet actif, s'il a déjà été scanné. Ensuite, pour chaque ressource de données (au fur et à mesure que les ressources deviennent disponibles), une tâche d'actualisation du scan de la ressource est appelée.
Chaque tâche est un fichier binaire compilé qui effectue un échantillonnage de Bernoulli sur les dernières données disponibles pour chaque actif. L'actif est divisé en colonnes distinctes, où le résultat de la classification de chaque colonne est traité indépendamment. De plus, le système scanne toutes les données saturées à l'intérieur des colonnes. JSON, tableaux, structures encodées, URL, données sérialisées base 64 et bien d'autres éléments sont tous scannés. Cela peut considérablement augmenter le temps d'exécution du scan, car une table peut contenir des milliers de colonnes imbriquées dans un grand objet binaire. json.
Pour chaque ligne sélectionnée dans l'actif de données, le système de classification extrait des objets flottants et textuels du contenu et lie chaque objet à la colonne d'où il a été extrait. Le résultat de l'étape d'extraction des objets est une carte de tous les objets pour chaque colonne trouvée dans l'actif de données.
À quoi servent les caractéristiques ?
La notion de caractéristiques est un point clé. Au lieu des caractéristiques float et text, nous pouvons transmettre des échantillons bruts de chaînes directement extraits de chaque ressource de données. De plus, les modèles d'apprentissage automatique peuvent être formés directement sur chaque échantillon, plutôt que sur des centaines de calculs de caractéristiques qui tentent seulement de s'approcher de l'échantillon. Il y a plusieurs raisons à cela :
- La confidentialité avant tout : le plus important, c'est que la notion de caractéristiques nous permet de conserver en mémoire uniquement les échantillons que nous extrayons. Cela garantit que nous stockons les échantillons dans un but unique et que nous ne les enregistrons jamais par nos propres efforts. C'est particulièrement crucial pour les données volatiles, car le service doit maintenir une certaine classification avant de fournir des prévisions.
- Mémoire : certains échantillons peuvent avoir une longueur de plusieurs milliers de caractères. Stocker de telles données et les transmettre en morceaux au système sans nécessité consomme beaucoup de bytes supplémentaires. Deux facteurs peuvent se cumuler avec le temps, étant donné qu'il existe de nombreuses ressources de données avec des milliers de colonnes.
- Agrégation des caractéristiques : grâce aux caractéristiques, les résultats de chaque scan sont clairement représentés, permettant au système de combiner les résultats des scans précédents d'une même ressource de données de manière pratique. Cela peut être utile pour agréger les résultats d'un scan d'une ressource de données au cours de plusieurs exécutions.
Les caractéristiques sont ensuite envoyées au service de prévision, où nous utilisons une classification basée sur des règles et de l'apprentissage automatique pour prédire les étiquettes des données de chaque colonne. Le service s'appuie sur à la fois des classificateurs de règles et de l'apprentissage automatique et choisit la meilleure prévision fournie par chaque objet de prévision.
Les classificateurs de règles sont une heuristique manuelle, utilisant des calculs et des coefficients pour normaliser un objet dans une plage de 0 à 100. Une fois qu'un score initial est généré pour chaque type de données et nom de colonne associé à ces données, sans tomber dans aucun "liste noire", le classificateur de règles sélectionne le score normalisé le plus élevé parmi tous les types de données.
En raison de la complexité de la classification, l'utilisation d'heuristiques manuelles uniquement entraîne une faible précision de classification, en particulier pour les données non structurées. Pour cette raison, nous avons développé un système d'apprentissage automatique pour gérer la classification des données non structurées, telles que le contenu utilisateur et les adresses. L'apprentissage automatique a permis de commencer à s'éloigner des heuristiques manuelles et d'appliquer des signaux de données supplémentaires (comme les noms de colonnes, l'origine des données), augmentant considérablement la précision de détection. Nous plongerons profondément dans notre architecture d'apprentissage automatique plus tard.
Le service de prévision stocke les résultats pour chaque colonne avec des métadonnées concernant le temps et l'état du scan. Tous les consommateurs et processus en aval dépendant de ces données peuvent les lire à partir du jeu de données publié quotidiennement. Ce jeu agrège les résultats de toutes ces tâches de scan ou API en temps réel du catalogue de données. Les prévisions publiées sont la base de l'application automatique de la politique de confidentialité et de sécurité.
Enfin, après que le service de prévision enregistre toutes les données et que toutes les prévisions sont sauvegardées, notre API de catalogue de données peut renvoyer toutes les prévisions de types de données pour la ressource en temps réel. Chaque jour, le système publie un jeu de données contenant toutes les prévisions récentes pour chaque actif.
Données non persistantes
Bien que le processus décrit ci-dessus soit conçu pour les actifs persistants, le trafic non conservé est également considéré comme faisant partie des données de l'organisation et peut être important. Pour cette raison, le système fournit une API en ligne pour la génération de prévisions de classification en temps réel pour tout trafic non persistant. Le système de prévision en temps réel est largement utilisé lors de la classification du trafic sortant, du trafic entrant dans les modèles d'apprentissage automatique et des données des annonceurs.
Dans ce cas, l'API prend deux arguments principaux : la clé de regroupement et les données brutes à prédire. Le service effectue la même extraction d’objets décrite ci-dessus et regroupe les objets pour une même clé. Ces caractéristiques sont également conservées dans le cache sauvegardé pour la récupération après incident. Pour chaque clé de regroupement, le service garantit qu'il a vu suffisamment d'échantillons avant d'appeler le service de prévision, conformément au processus décrit précédemment.
Optimisation
Pour scanner certains entrepôts, nous utilisons des bibliothèques et des méthodes d'optimisation de la lecture à partir d'un stockage chaud [2] et garantissons qu'il n'y a pas d'interruptions de la part d'autres utilisateurs accédant au même entrepôt.
Pour des tables extrêmement grandes (50+ pétaoctets), malgré toutes les optimisations et l'efficacité de la mémoire, le système lutte pour scanner et calculer tout avant que la mémoire ne s'épuise. En fin de compte, le scan est entièrement calculé en mémoire et n'est pas enregistré pendant le scan. Si de grandes tables contiennent des milliers de colonnes avec des grappes de données non structurées, la tâche peut échouer en raison d'un manque de ressources mémoire lors de la réalisation de prévisions pour la table entière. Cela diminuera la couverture. Pour lutter contre cela, nous avons optimisé le système pour utiliser la vitesse de scan comme intermédiaire pour évaluer à quel point le système gère la charge actuelle. Nous utilisons la vitesse comme un mécanisme de prévision pour identifier les problèmes de mémoire et lors du calcul préventif de la carte des objets. Ce faisant, nous utilisons moins de données que d'habitude.
Signaux de données
Le système de classification est aussi bon que les signaux des données. Ici, nous examinerons tous les signaux utilisés par le système de classification.
- Basé sur le contenu : bien sûr, le premier et le plus important signal est le contenu. Une sélection de Bernoulli est effectuée pour chaque actif de données que nous scannons et nous extrayons des caractéristiques selon le contenu des données. De nombreuses caractéristiques proviennent du contenu. Il peut y avoir n'importe quel nombre d'objets flottants qui représentent des calculs sur combien de fois un certain type d'échantillon a été observé. Par exemple, nous pouvons avoir des indicateurs sur le nombre d'e-mails vus dans l'échantillon, ou des caractéristiques sur le nombre d'émoticônes remarquées dans l'échantillon. Ces calculs de caractéristiques peuvent être normalisés et agrégés à travers différents scans.
- Origines des données : un signal important qui peut aider lorsque le contenu a changé depuis la table parente. Un exemple courant est les données hachées. Lorsque les données dans la table enfant sont hachées, elles proviennent souvent de la table parente, où elles restent sous une forme claire. Les données d'origine aident à classifier certains types de données lorsqu'elles ne sont pas clairement lisibles ou sont transformées depuis la table en amont.
- Annotations : un autre signal de haute qualité, aidant à l'identification de données non structurées. En fait, les annotations et les données d'origine peuvent travailler ensemble pour diffuser des attributs entre différents actifs de données. Les annotations aident à identifier la source de données non structurées, tandis que les données d'origine peuvent aider à suivre le flux de ces données à travers le stockage.
- Injection de données — c'est une méthode où des caractères spéciaux non lisibles sont intentionnellement introduits dans des sources connues avec des types de données connus. Ensuite, chaque fois que nous scannons le contenu avec la même séquence de caractères non lisibles, nous pouvons conclure que le contenu provient de ce type de données connu. C'est un autre signal qualitatif des données, similaire aux annotations. À la seule différence que la détection basée sur le contenu aide à identifier les données injectées.
Mesure des métriques
Un composant important est une méthodologie rigoureuse de mesure des métriques. Les principales métriques d'itération pour l'amélioration de la classification sont la précision et le rappel de chaque étiquette, avec l'évaluation F2 étant primordiale.
Pour évaluer ces indicateurs, une méthodologie indépendante de marquage des actifs de données est nécessaire, qui ne dépend pas du système lui-même, mais peut être utilisée pour une comparaison directe avec celui-ci. Nous décrirons ci-dessous comment nous recueillons la vérité fondamentale de Facebook et l'utilisons pour former notre système de classification.
Collecte de données fiables
Nous accumulons des données fiables provenant de chaque source énumérée ci-dessous, dans sa propre table. Chaque table est responsable de l'agrégation des dernières valeurs observées provenant de cette source spécifique. Chaque source a une vérification de qualité des données pour garantir que les valeurs observées pour chaque source sont de haute qualité et contiennent les dernières étiquettes de types de données.
- Configurations de la plateforme de journalisation : certains champs dans les tables de type de ruche sont remplis avec des données concernant un type spécifique. L'utilisation et la diffusion de ces données constituent une source fiable de données fiables.
- Mise en étiquette manuelle : les développeurs soutenant le système ainsi que les étiqueteurs externes sont formés pour marquer les colonnes. Cela fonctionne généralement bien pour tous les types de données dans le stockage, et peut être la source principale de fiabilité pour certaines données non structurées, telles que les données de messages ou le contenu utilisateur.
- Les colonnes des tables parente peuvent être marquées ou annotées comme contenant des données spécifiques, et nous pouvons suivre ces données dans les tables en aval.
- Échantillonnage des flux d'exécution : les flux d'exécution dans Facebook portent des données d'un type spécifique. En utilisant notre scanner comme architecture de service, nous pouvons échantillonner des flux ayant des types de données connus et les envoyer à travers le système. Le système promet de ne pas stocker ces données.
- Tables d'échantillonnage : de grandes tables de type ruche, qui, selon des informations, contiennent l'ensemble des données, peuvent également être utilisées comme données d'apprentissage et transmises via le scanner en tant que service. Cela convient parfaitement aux tables contenant une gamme complète de types de données, de sorte qu'un échantillonnage aléatoire d'une colonne équivaut à l'échantillonnage de l'ensemble de cet ensemble de types de données.
- Données synthétiques : nous pouvons même utiliser des bibliothèques qui génèrent des données à la volée. Cela fonctionne bien pour des types de données simples et accessibles au public, comme une adresse ou un GPS.
- Gouverneurs de données : les programmes de confidentialité utilisent généralement des gouverneurs de données pour lier manuellement des politiques à des parties des données. Cela sert de source de crédibilité très précise.
Nous consolidons chaque source principale de données fiables en un seul corps contenant toutes ces informations. Le plus gros défi en matière de crédibilité est de s'assurer qu'elle soit représentative de l'entrepôt de données. Sinon, les moteurs de classification peuvent surapprendre. Pour contrer cela, toutes les sources mentionnées précédemment sont utilisées pour garantir un équilibre lors de l'entraînement de modèles ou du calcul de métriques. De plus, les annotateurs humains sélectionnent uniformément différentes colonnes dans l'entrepôt et étiquettent les données en conséquence, afin que la collecte de valeurs fiables reste impartiale.
Intégration continue
Pour garantir une itération et une amélioration rapides, il est essentiel de mesurer en permanence les performances du système en temps réel. Nous pouvons mesurer chaque amélioration de la classification par rapport au système actuel, ce qui nous permet d'orienter tactiquement les données dans les améliorations futures. Ici, nous examinerons comment le système complète le cycle de rétroaction assuré par des données fiables.
Lorsque le système de planification fait face à un actif marqué par une source fiable, nous planifions deux tâches. La première utilise notre scanner de production et, par conséquent, nos capacités de production. La deuxième tâche utilise le scanner de la dernière version avec les dernières caractéristiques. Chaque tâche écrit sa sortie dans sa propre table, en marquant les versions avec les résultats de classification.
Ainsi, nous comparons les résultats de classification du candidat de version et du modèle de production en temps réel.
Tant que les ensembles de données comparent les attributs RC et PROD, de nombreuses variations du moteur de classification ML du service de prévision sont enregistrées. Le modèle d'apprentissage automatique le plus récemment construit, le modèle actuel en production et tous les modèles expérimentaux. La même approche nous permet de « découper » différentes versions du modèle (agnostique de nos classificateurs de règles) et de comparer les métriques en temps réel. Il est alors facile de déterminer quand une expérience ML est prête à être mise en production.
Chaque nuit, les attributs RC calculés pour la journée sont envoyés dans le pipeline d'apprentissage ML, où le modèle est entraîné sur les derniers attributs RC et évalue sa performance par rapport à un ensemble de données de référence.
Chaque matin, le modèle termine son entraînement et est automatiquement publié en tant qu'expérimental. Il est automatiquement ajouté à la liste des expérimentations.
Quelques résultats
Plus de 100 types de données différents sont étiquetés avec une grande précision. Les types bien structurés, tels que les e-mails et les numéros de téléphone, sont classés avec un score f2 supérieur à 0,95. Les types de données libres, comme le contenu utilisateur et le nom, fonctionnent également très bien, avec des scores F2 supérieurs à 0,85.
Chaque jour, un grand nombre de colonnes de données stables et instables sont classées dans tous les entrepôts. Plus de 500 téraoctets sont scannés quotidiennement dans plus de 10 entrepôts de données. La couverture de la plupart de ces entrepôts est supérieure à 98 %.
Au fil du temps, la classification est devenue très efficace, car les tâches de classification dans le flux autonome enregistré prennent en moyenne 35 secondes, depuis le scan de l'asset jusqu'au calcul des prévisions pour chaque colonne.
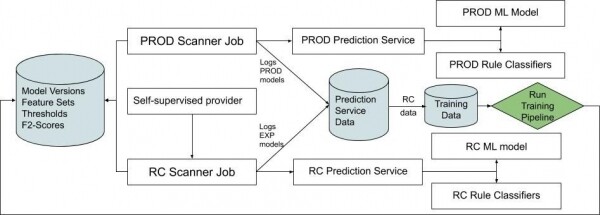
Fig. 2. Diagramme décrivant le flux continu d'intégration, afin de comprendre comment les objets RC sont générés et envoyés au modèle.
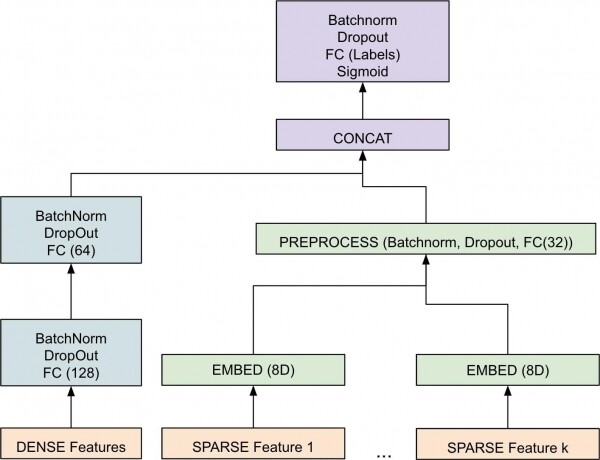
Fig. 3. Diagramme de haut niveau du composant d'apprentissage automatique.
Composant du système d'apprentissage automatique
Dans la section précédente, nous avons plongé en profondeur dans l'architecture de l'ensemble du système, en soulignant l'échelle, l'optimisation et les flux de données en mode autonome et en ligne. Dans cette section, nous examinerons le service de prévision et décrirons le système d'apprentissage automatique qui fait fonctionner le service de prévision.
Avec plus de 100 types de données et certains contenus non structurés, tels que les données de messages et le contenu généré par les utilisateurs, l'utilisation d'une heuristique manuelle uniquement entraîne une précision de classification suboptimale, en particulier pour les données non structurées. Pour cette raison, nous avons également développé un système d'apprentissage automatique pour gérer les complexités des données non structurées. L'utilisation de l'apprentissage automatique permet de s'éloigner de l'heuristique manuelle et de travailler avec des caractéristiques et des signaux de données supplémentaires (par exemple, les noms de colonnes, l'origine des données) afin d'améliorer la précision.
Le modèle mis en œuvre étudie les représentations vectorielles [3] sur des objets denses et clairsemés séparément. Ils sont ensuite combinés pour former un vecteur qui passe par une série d'étapes de normalisation par lots [4] et de non-linéarité pour obtenir le résultat final. Le résultat final est un nombre à virgule flottante compris entre [0-1] pour chaque étiquette, indiquant la probabilité que l'exemple appartienne à ce type de sensibilité. L'utilisation de PyTorch pour le modèle nous a permis d'avancer plus rapidement, donnant aux développeurs hors de l'équipe la possibilité d'apporter et de tester rapidement des modifications.
Lors de la conception de l'architecture, il était important de modéliser séparément les objets clairsemés (par exemple, textuels) et denses (par exemple, numériques) en raison de leur différence interne. Pour l'architecture finale, il était également crucial d'effectuer un déploiement des paramètres pour trouver la meilleure valeur pour le taux d'apprentissage, la taille de lot et d'autres hyperparamètres. Le choix de l'optimiseur était également un hyperparamètre important. Nous avons découvert que l'optimiseur populaire Adamentraîne souvent un surapprentissage, tandis que le modèle avec SGD plus stable. Il y avait des nuances supplémentaires que nous devions inclure directement dans le modèle. Par exemple, des règles statiques qui garantissaient que le modèle faisait une prévision déterministe lorsque le caractère avait une valeur spécifique. Ces règles statiques sont définies par nos clients. Nous avons découvert que les inclure directement dans le modèle créait une architecture plus autonome et fiable, contrairement à la mise en œuvre d'une étape de post-traitement pour gérer ces cas particuliers. Notez également qu'au cours de l'entraînement, ces règles sont désactivées pour ne pas perturber le processus d'entraînement par descente de gradient.
Problèmes
L'un des problèmes était la collecte de données fiables de haute qualité. Le modèle a besoin de fiabilité pour chaque classe afin qu'il puisse apprendre les associations entre les objets et les étiquettes. Dans la section précédente, nous avons discuté des méthodes de collecte de données à la fois pour mesurer le système et pour entraîner les modèles. L'analyse a montré que des classes de données telles que les numéros de carte de crédit et les comptes bancaires ne sont pas très répandues dans notre entrepôt. Cela complique la collecte de grandes quantités de données fiables pour l'entraînement des modèles. Pour résoudre ce problème, nous avons développé des processus pour obtenir des données fiables synthétiques pour ces classes. Nous générons de telles données pour des types sensibles, y compris SSN, numéros de carte de crédit et IBAN-numéros pour lesquels le modèle ne pouvait pas faire de prévision auparavant. Cette approche permet de traiter des types de données confidentielles sans le risque de confidentialité associé à la dissimulation de données confidentielles réelles.
Outre les problèmes de données fiables, il y a des problèmes architecturaux ouverts sur lesquels nous travaillons, tels que l'isolation des changements et l'arrêt précoce. L'isolation des changements est importante pour que lorsque des modifications sont apportées à différentes parties du réseau, l'impact soit isolé des classes spécifiques et n'affecte pas largement les performances globales de prédiction. L'amélioration des critères d'arrêt précoce est également cruciale afin que nous puissions arrêter le processus d'entraînement à un point stable pour toutes les classes, plutôt qu'à un point où certaines classes sur-apprennent et d'autres non.
Importance de la caractéristique
Lorsque nous introduisons une nouvelle caractéristique dans le modèle, nous souhaitons connaître son influence globale sur le modèle. Nous voulons également nous assurer que les prévisions sont interprétables par l'homme, afin que l'on puisse comprendre exactement quelles caractéristiques sont utilisées pour chaque type de données. Pour cela, nous avons développé et introduit par classe l'importance des caractéristiques pour le modèle PyTorch. Notez que cela diffère de l'importance globale de la caractéristique, qui est généralement prise en charge, car elle ne nous dit pas quelles caractéristiques sont importantes pour une classe spécifique. Nous mesurons l'importance d'un objet en calculant l'augmentation de l'erreur de prévision après avoir permuté l'objet. Une caractéristique est « importante » lorsque la permutation des valeurs augmente l'erreur du modèle, car dans ce cas, le modèle se fie à la caractéristique dans ses prévisions. Une caractéristique est « non importante » lorsque le mélange de ses valeurs laisse l'erreur du modèle inchangée, car dans ce cas, le modèle l'ignore [5].
L'importance de la caractéristique pour chaque classe permet de rendre le modèle interprétable, afin que nous puissions voir sur quoi le modèle se concentre lors de la prévision de l'étiquette. Par exemple, lorsque nous analysons ADDR, nous garantissons que la caractéristique associée à l'adresse, telle que AddressLinesCount, se classe haut dans le tableau des importances des caractéristiques pour chaque classe, afin que notre intuition humaine soit bien alignée avec ce que le modèle a appris.
Évaluation
Il est important de définir une métrique unique de succès. Nous avons choisi F2 — un équilibre entre le rappel et la précision (le rappel étant légèrement plus pondéré). Le rappel est plus important pour le cas d'utilisation de la confidentialité que la précision, car il est crucial pour l'équipe de ne manquer aucune donnée confidentielle (tout en maintenant une précision raisonnable). Les données réelles d'évaluation de la performance F2 de notre modèle dépassent le cadre de cet article. Cependant, avec un réglage minutieux, nous pouvons atteindre un score F2 élevé (0,9+) pour les classes sensibles les plus importantes.
Travail connexe
Il existe de nombreux algorithmes de classification automatique de documents non structurés utilisant diverses méthodes, telles que le matching de motifs, la recherche de similarités entre documents et différentes techniques d'apprentissage automatique (bayésiennes, arbres de décision, k-plus proches voisins, et bien d'autres) [6]. Chacune d'entre elles peut être utilisée dans le cadre de la classification. Cependant, le problème réside dans la scalabilité. L'approche de classification développée dans cet article privilégie la flexibilité et la performance. Cela nous permet de prendre en charge de nouvelles classes à l'avenir tout en maintenant une faible latence.
Il existe également de nombreux travaux portant sur l'extraction d'empreintes à partir des données. Par exemple, les auteurs dans [7] décrivent une solution qui se concentre sur le problème de la captation des fuites de données sensibles. L'hypothèse principale repose sur la possibilité d'une empreinte à partir des données afin de la comparer à un ensemble de données sensibles connues. Les auteurs dans [8] abordent un problème similaire de fuite de confidentialité, mais leur solution est basée sur une architecture Android spécifique et ne se classe que si les actions de l'utilisateur ont conduit à l'envoi d'informations personnelles ou si l'application sous-jacente a des fuites de données utilisateur. La situation ici est quelque peu différente, car les données utilisateur peuvent également être très non structurées. Nous avons donc besoin d'une technique plus complexe que celle de l'extraction d'empreintes.
Enfin, pour faire face au manque de données pour certains types de données sensibles, nous avons introduit des données synthétiques. Il existe une vaste littérature sur l'augmentation des données, par exemple, les auteurs dans [9] ont étudié le rôle de l'injection de bruit pendant l'entraînement et ont observé des résultats positifs dans un cadre d'apprentissage supervisé. Notre approche en matière de confidentialité est différente, car l'introduction de données bruitées peut être contre-productive, et nous nous concentrons plutôt sur des données synthétiques de haute qualité.
Conclusion
Dans cet article, nous avons présenté un système capable de classer un fragment de données. Cela nous permet de créer des systèmes de conformité aux politiques de confidentialité et de sécurité. Nous avons montré que l'infrastructure évolutive, l'intégration continue, l'apprentissage automatique et des données de haute qualité sur la véracité des données jouent un rôle clé dans le succès de nombreuses initiatives liées à la vie privée.
Il existe de nombreuses directions pour le travail futur. Cela peut inclure le soutien pour les données non structurées (fichiers), la classification non seulement du type de données, mais également du niveau de sensibilité, ainsi que l'utilisation de l'apprentissage autonome directement durant la formation en générant des exemples synthétiques précis. Ceux-ci, à leur tour, aideront le modèle à réduire les pertes au maximum. Le travail futur pourrait également se concentrer sur le flux de travail d'investigation, où nous allons au-delà de la détection et fournissons une analyse des causes profondes de diverses violations de la vie privée. Cela aidera dans des cas tels que l'analyse de la sensibilité (c'est-à-dire si la sensibilité de la confidentialité du type de données est élevée (comme l'IP de l'utilisateur) ou basse (comme l'IP interne de Facebook)).
Bibliographie
- David Ben-David, Tamar Domany et Abigail Tarem. Classification des données d'entreprise utilisant des technologies du web sémantique. Dans Peter F.Ï Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks, et Birte Glimm, éditeurs, Le Web Sémantique – ISWC 2010, pages 66–81, Berlin, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang et Sanjeev Kumar. f4 : le système de stockage BLOB chaud de Facebook. Dans 11ème Symposium USENIX sur la conception et l'implémentation des systèmes d'exploitation (OSDI 14), pages 383–398, Broomfield, CO, octobre 2014. USENIX Association.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado et Jeff Dean. Représentations distribuées des mots et des phrases et leur compositionnalité. Dans C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani et K. Q. Weinberger, éditeurs, Avancées dans les Systèmes de Traitement de l'Information Neurale 26, pages 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe et Christian Szegedy. Normalisation par lots : Accélérer l'entraînement de réseaux profonds en réduisant le déplacement de covariance interne. Dans Francis Bach et David Blei, éditeurs, Procédures de la 32ème Conférence Internationale sur l'Apprentissage Automatique, volume 37 de Procédures de la Recherche en Apprentissage Automatique, pages 448–456, Lille, France, 07–09 juil. 2015. PMLR.
- Leo Breiman. Forêts aléatoires. Mach. Appr., 45(1):5–32, octobre 2001.
- Thair Nu Phyu. Enquête sur les techniques de classification dans l'exploration de données.
- X. Shu, D. Yao et E. Bertino. Détection de l'exposition de données sensibles en préservant la vie privée. Transactions IEEE sur la forensic et la sécurité de l'information, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning et Xiaoyang Wang. Appintent : Analyse de la transmission de données sensibles sur Android pour la détection de fuites de confidentialité. pages 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong et Quoc V. Le. Augmentation de données non supervisée.
Découvrez les détails pour acquérir une profession recherchée depuis le début ou faire évoluer vos compétences et salaire en suivant des cours en ligne SkillFactory :
- (12 mois)
- (12 semaines)
- (20 semaines)
- (20 semaines)
Autres cours
- (9 mois)
- (8 mois)
- (9 mois)
- (12 mois)
- (18 mois)
- (12 mois)
- (9 mois)
- (7 mois)
Source : habr.com
