

Avec la base de données Apache Cassandra et la nécessité de l'exploiter dans une infrastructure basée sur Kubernetes, nous y sommes régulièrement confrontés. Dans cet article, nous partagerons notre vision des étapes nécessaires, des critères et des solutions existantes (y compris un aperçu des opérateurs) pour la migration de Cassandra vers K8s.
« Qui peut gérer une femme, peut aussi gérer un État »
Qui est donc Cassandra ? C'est un système de stockage distribué, conçu pour gérer de grands volumes de données, tout en garantissant une haute disponibilité sans point de défaillance unique. Le projet ne nécessite probablement pas une longue présentation, je vais donc simplement évoquer les principales caractéristiques de Cassandra, qui seront pertinentes dans le contexte de cet article :
- Cassandra est écrite en Java.
- La topologie de Cassandra comprend plusieurs niveaux :
- Node — une instance déployée de Cassandra ;
- Rack — un groupe d'instances Cassandra réunies par un critère commun, situées dans le même centre de données ;
- Datacenter — l'ensemble des groupes d'instances Cassandra se trouvant dans un même centre de données ;
- Cluster — l'ensemble de tous les centres de données.
- Pour identifier un nœud, Cassandra utilise une adresse IP.
- Pour la rapidité des opérations d'écriture et de lecture, une partie des données de Cassandra est stockée en mémoire vive.
Maintenant, passons à la potentielle migration vers Kubernetes.
Check-list pour le transfert
En parlant de la migration de Cassandra vers Kubernetes, nous espérons qu'avec ce déménagement, sa gestion deviendra plus facile. Que faudra-t-il pour cela, et qu'est-ce qui pourra aider ?
1. Stockage pour les données
Comme cela a été précisé, une partie des données de Cassandra est stockée en mémoire vive — dans le Memtable. Mais il y a aussi une autre partie des données qui est sauvegardée sur disque, — sous forme de SSTable. À ces données s'ajoute l'entité Commit Log — des enregistrements de toutes les transactions, qui sont également sauvegardées sur disque.
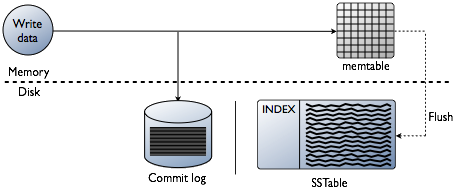
Schéma des transactions d'écriture dans Cassandra
Dans Kubernetes, nous pouvons utiliser PersistentVolume pour le stockage des données. Grâce à des mécanismes éprouvés, travailler avec les données dans Kubernetes devient chaque année de plus en plus facile.
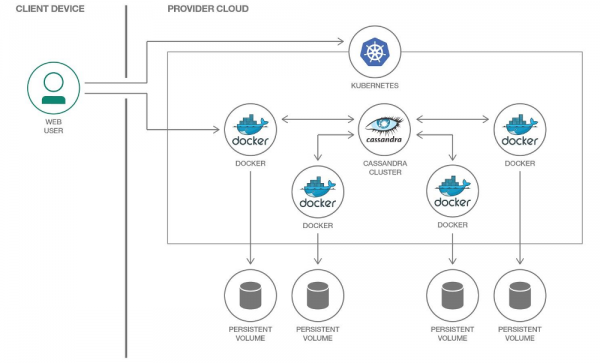
Nous allouerons un PersistentVolume à chaque pod Cassandra.
Il est important de noter que Cassandra implique elle-même la réplication des données, offrant pour cela des mécanismes intégrés. Ainsi, si vous créez un cluster Cassandra à partir d'un grand nombre de nœuds, il n'est pas nécessaire d'utiliser des systèmes de stockage distribués comme Ceph ou GlusterFS. Dans ce cas, il serait logique de stocker les données sur le disque du nœud en utilisant ou un montage hostPath.
Une autre question se pose si vous souhaitez créer un environnement distinct pour chaque branche de fonctionnalités pour les développeurs. Dans ce cas, l'approche appropriée serait de déployer un nœud Cassandra et de stocker les données dans un stockage distribué, c'est-à-dire que les mentions de Ceph et GlusterFS deviendront votre option. Ainsi, le développeur sera assuré de ne pas perdre les données de test même en cas de perte d'un des nœuds du cluster Kubernetes.
2. Surveillance
Le choix pratiquement sans alternative pour la mise en œuvre de la surveillance dans Kubernetes est Prometheus (nous en avons parlé en détail dans ). Comment se comportent Cassandra et les exportateurs de métriques pour Prometheus ? Et, ce qui est même plus important, en ce qui concerne les tableaux de bord appropriés pour Grafana ?
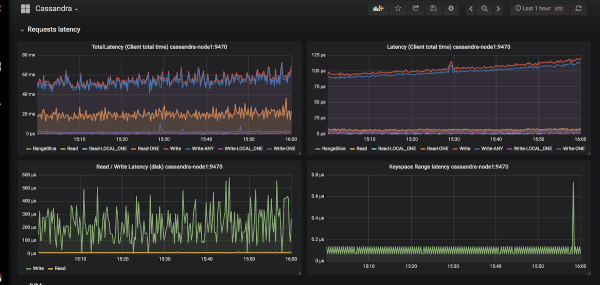
Exemple de l'apparence des graphiques dans Grafana pour Cassandra
Il n'y a que deux exportateurs : et .
Nous avons choisi le premier car :
- Le JMX Exporter évolue et se développe, tandis que le Cassandra Exporter n'a pas réussi à obtenir le soutien nécessaire de la communauté. Le Cassandra Exporter ne prend toujours pas en charge la plupart des versions de Cassandra.
- Il peut être lancé comme javaagent en ajoutant le drapeau
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Pour lui, il existe un , qui n'est pas compatible avec le Cassandra Exporter.
3. Choix des primitives Kubernetes
Selon la structure du cluster Cassandra exposée ci-dessus, essayons de traduire tout ce qui y est décrit en termes de Kubernetes :
- Nœud Cassandra → Pod
- Rack Cassandra → StatefulSet
- Datacenter Cassandra → pool d’StatefulSets
- Cluster Cassandra → ???
Il semble qu'il manque une entité supplémentaire pour gérer tout le cluster Cassandra à la fois. Mais s'il n'y a pas quelque chose, nous pouvons le créer ! Dans Kubernetes, il existe un mécanisme de définition des ressources personnalisées pour cela — .
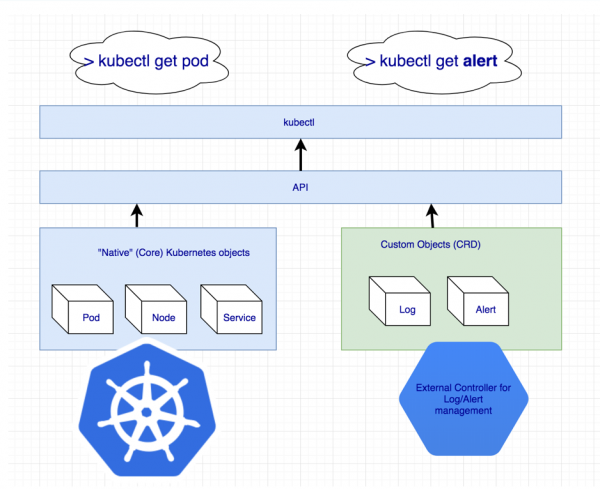
Déclaration de ressources supplémentaires pour les journaux et les alertes
Mais la ressource personnalisée en elle-même ne signifie rien : car elle a besoin d'un contrôleur. Il peut être nécessaire de faire appel à un …
4. Identification des pods
Dans le point précédent, nous avons convenu qu'un noeud Cassandra équivaut à un pod dans Kubernetes. Cependant, les adresses IP des pods seront différentes à chaque fois. Et l'identification d'un noeud dans Cassandra se fait précisément sur la base de l'adresse IP… Il en découle qu'après chaque suppression de pod, le cluster Cassandra ajoutera un nouveau noeud.
Il existe des solutions, et même plusieurs :
- Nous pouvons suivre par identifiants de hosts (UUIDs, qui identifient de manière unique les instances de Cassandra) ou par adresses IP et conserver tout cela dans des structures/tableaux. Cette méthode présente deux principaux inconvénients :
- Le risque d'une condition de course lors de la chute simultanée de deux noeuds. Après leur redémarrage, les noeuds Cassandra iront demander une adresse IP à la table en même temps et rivaliseront pour la même ressource.
- Si un noeud Cassandra perd ses données, nous ne pourrons plus l'identifier.
- La deuxième solution semble être un petit hack, mais néanmoins : nous pouvons créer un Service avec ClusterIP pour chaque noeud Cassandra. Les problèmes de cette implémentation :
- S'il y a beaucoup de noeuds dans le cluster Cassandra, nous devrons créer un grand nombre de Services.
- La possibilité de ClusterIP est implémentée via iptables. Cela peut poser problème si le cluster Cassandra comporte beaucoup (1000… ou même 100 ?) de noeuds. Bien que puisse résoudre ce problème.
- La troisième solution consiste à utiliser le réseau de noeuds Cassandra au lieu d'un réseau dédié pour les pods en activant l'option
hostNetwork: true. Cette méthode impose certaines restrictions :- Sur le remplacement des noeuds. Il est nécessaire que le nouveau noeud ait exactement la même adresse IP que l'ancien (dans des environnements cloud comme AWS, GCP, cela est pratiquement impossible) ;
- En utilisant le réseau de noeuds du cluster, nous commençons à rivaliser pour les ressources réseau. Par conséquent, déployer plus d'un pod Cassandra sur un même noeud de cluster sera problématique.
5. Sauvegardes
Nous souhaitons sauvegarder une version complète des données d'un noeud Cassandra selon un planning. Kubernetes offre une possibilité pratique via , mais ici, Cassandra elle-même nous complique la tâche.
Rappelons que Cassandra stocke une partie de ses données en mémoire. Pour effectuer une sauvegarde complète, il faut transférer les données de la mémoire (Memtables) vers le disque (SSTables). À ce moment-là, le noeud Cassandra cesse d'accepter des connexions, se retirant complètement des opérations du cluster.
Après cela, la sauvegarde (snapshot) est réalisée et le schéma est sauvegardé (keyspace). Et ici, on découvre que simplement faire une sauvegarde ne nous donne rien : il faut conserver les identifiants des données pour lesquelles le nœud Cassandra est responsable — ce sont des jetons spéciaux.
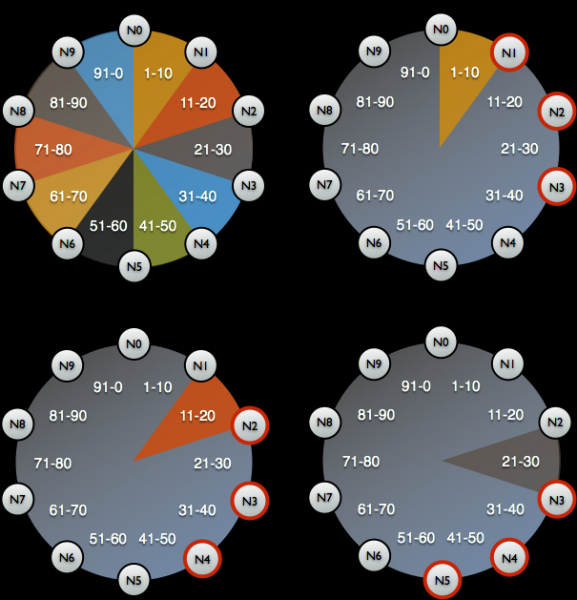
Distribution des jetons d'identification pour savoir quelles données sont gérées par les nœuds Cassandra
Un exemple de script pour effectuer une sauvegarde de Cassandra depuis Google sur Kubernetes peut être trouvé à . Le seul point que le script ne prend pas en compte est la réinitialisation des données sur le nœud avant de prendre le snapshot. Cela signifie que la sauvegarde n'est pas effectuée sur l'état actuel, mais sur un état légèrement antérieur. Mais cela aide à ne pas déconnecter le nœud, ce qui semble très logique.
set -eu

if [[ -z "$1" ]]; then
  info "Veuillez fournir un keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Erreur lors de la création du snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk 'Snapshot directory: { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Exemple de script bash pour effectuer une sauvegarde d'un nœud Cassandra
Solutions prêtes à l'emploi pour Cassandra sur Kubernetes
Que sont actuellement utilisées pour déployer Cassandra sur Kubernetes et quelles sont celles qui répondent le mieux aux exigences données ?
1. Solutions basées sur StatefulSet ou Helm charts
Utiliser les fonctionnalités de base de StatefulSets pour lancer un cluster Cassandra est une bonne option. En utilisant un Helm chart et des modèles Go, on peut offrir à l'utilisateur une interface flexible pour déployer Cassandra.
Cela fonctionne généralement bien… jusqu'à ce qu'un imprévu survienne — par exemple, qu'un nœud tombe en panne. Les outils standard de Kubernetes ne peuvent tout simplement pas prendre en compte toutes les caractéristiques ci-dessus. De plus, cette approche est très limitée dans la mesure où elle peut être étendue pour des utilisations plus complexes : remplacement de nœuds, sauvegarde, récupération, surveillance, etc.
Représentants :
- ;
- .
Les deux charts sont également bons, mais sont sujets aux problèmes mentionnés ci-dessus.
2. Solutions basées sur Kubernetes Operator
Ces options sont plus intéressantes car elles offrent de larges possibilités de gestion du cluster. Pour concevoir un opérateur Cassandra, comme pour toute autre base de données, un bon modèle ressemble à Sidecar Controller CRD :
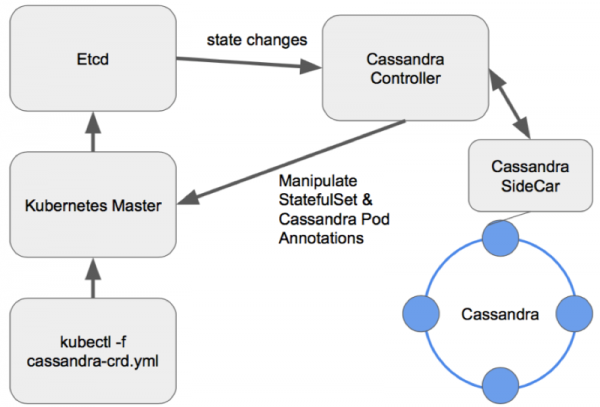
Schéma de gestion des nœuds dans un opérateur Cassandra correctement conçu
Examinons les opérateurs existants.
1. Cassandra-operator d'instaclustr
- État : Alpha
- Licence : Apache 2.0
- Réalisé en : Java
C'est un projet très prometteur et en pleine évolution d'une entreprise qui propose des déploiements Cassandra gérés. Comme mentionné ci-dessus, il utilise un conteneur sidecar qui reçoit des commandes via HTTP. Écrit en Java, il lui manque parfois certaines fonctionnalités avancées de la bibliothèque client-go. De plus, l'opérateur ne prend pas en charge différents racks pour un même datacenter.
Cependant, l'opérateur possède des avantages, tels que le support de la surveillance, une gestion de cluster à haut niveau par le biais des CRD et même une documentation sur la sauvegarde.
2. Navigator de Jetstack
- État : Alpha
- Licence : Apache 2.0
- Réalisé en : Golang
Un opérateur destiné à déployer DB-as-a-Service. Actuellement, il prend en charge deux bases de données : Elasticsearch et Cassandra. Il comprend des solutions intéressantes, comme le contrôle d'accès à la base de données via RBAC (pour cela, un serveur d'API navigator séparé est mis en place). C'est un projet intéressant, à examiner, mais le dernier commit a été effectué il y a un an et demi, ce qui réduit clairement son potentiel.
3. Cassandra-operator de vgkowski
- État : Alpha
- Licence : Apache 2.0
- Réalisé en : Golang
Nous n'avons pas considéré son utilisation « sérieusement », car le dernier commit dans le dépôt a plus d'un an. Le développement de l'opérateur a été abandonné : la dernière version de Kubernetes, annoncée comme prise en charge, est la 1.9.
4. Cassandra-operator de Rook
- État : Alpha
- Licence : Apache 2.0
- Réalisé en : Golang
Un opérateur dont le développement n'avance pas aussi rapidement que souhaité. Il dispose d'une structure CRD bien pensée pour la gestion de cluster, résout le problème d'identification des nœuds grâce à un Service avec ClusterIP (ce fameux « hack »)... mais pour l'instant, c'est tout. Il n'y a pas de surveillance et de sauvegarde intégrées pour le moment (soit dit en passant, pour la surveillance, nous ). Un point intéressant est qu'avec cet opérateur, on peut également déployer ScyllaDB.
NB : Cet opérateur, avec quelques modifications mineures, a été utilisé dans l'un de nos projets. Aucun problème d'exploitation de l'opérateur n'a été observé durant toute la période d'utilisation (~4 mois de fonctionnement).
5. CassKop d'Orange
- État : Alpha
- Licence : Apache 2.0
- Réalisé en : Golang
Le plus jeune opérateur de la liste : le premier commit a été effectué le 23 mai 2019. Déjà, il possède dans son arsenal un grand nombre de fonctionnalités de notre liste, que vous pouvez découvrir plus en détail dans le référentiel du projet. L'opérateur est construit sur la base du populaire operator-sdk. Il prend en charge la surveillance « out of the box ». La principale différence avec d'autres opérateurs est l'utilisation , réalisé en Python et utilisé pour la communication entre les nœuds Cassandra.
Conclusions
Le nombre d'approches et de possibilités pour migrer Cassandra vers Kubernetes parle de lui-même : le sujet est en demande.
À ce stade, essayer quelque chose de ce qui précède se fait à vos risques et périls : aucun des développeurs ne garantit un fonctionnement à 100 % de sa solution dans un environnement de production. Mais dès maintenant, de nombreux produits semblent prometteurs pour être utilisés dans des environnements de développement.
Je pense que dans le futur, cette femme sur le bateau sera utile !
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com
