

Bonjour à tous.
Je suis administrateur système linux, j'ai déménagé de Russie en Australie avec un visa professionnel indépendant en 2015, mais cet article ne parlera pas de comment un petit cochon a obtenu un tracteur. Il y a déjà suffisamment d'articles à ce sujet (cela dit, si cela vous intéresse, je peux aussi en écrire un), donc je voudrais parler de la manière dont, dans mon travail en Australie en tant qu'ingénieur linux-ops, j'ai été à l'initiative de la migration d'un système de monitoring à un autre. Plus précisément — de Nagios à Icinga2.
L'article est en partie technique et en partie axé sur la communication avec les gens et les problèmes liés aux différences culturelles et aux méthodes de travail.
Malheureusement, la balise «code» ne met pas en lumière le code Puppet et yaml, j'ai donc dû utiliser «plaintext».
Rien ne laissait présager le danger le matin du 21 décembre 2016. Comme d'habitude, je lisais Habr de manière anonyme durant les premières demi-heures de ma journée de travail, en buvant mon café, et je suis tombé sur .
Étant donné que Nagios était utilisé dans ma société, je n'ai pas tardé à créer un ticket dans Redmine et à partager le lien dans le chat général, car je pensais que c'était important. L’initiative est punie même en Australie, donc l'ingénieur principal a chargé cette question sur mes épaules, puisque je l'avais découvert.
Capture d'écran de Redmine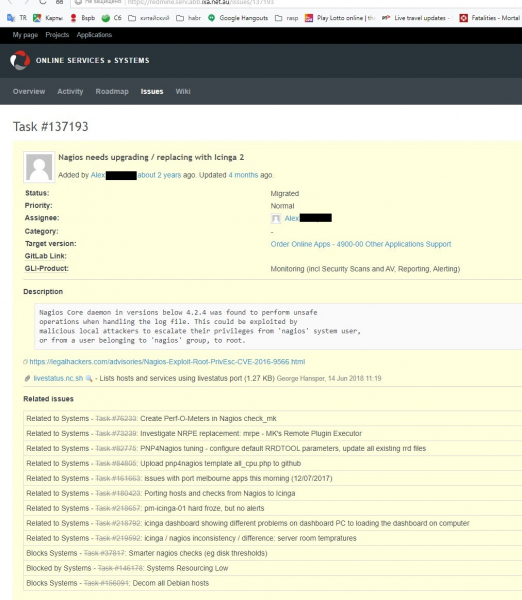
Dans notre département, avant de donner notre avis, il est habituel de proposer au moins une alternative, même si le choix est évident, donc j'ai commencé par chercher sur Google quelles sont les systèmes de surveillance actuellement pertinents, car, en Russie, lors de ma dernière expérience professionnelle, j'avais mon propre système fait maison, très primitif, mais néanmoins fonctionnel et accomplissant toutes les tâches qui lui étaient assignées. Python, l'Institut Polytechnique de Saint-Pétersbourg et le métro déchirent. Non, le métro c’est nul. C'est personnel (11 ans de travail) et mérite un article à part, mais pas maintenant.
Un peu sur les règles de modification des configurations d'infrastructure à mon poste actuel. Nous utilisons Puppet, Gitlab et le principe d'Infrastructure as Code, donc:
- Aucun changement manuel via SSH en modifiant manuellement des fichiers sur des machines virtuelles. Au cours des trois années de travail, j'ai reçu des retours pour cela à plusieurs reprises, le dernier remontant à une semaine, et je ne pense pas que ce soit la dernière fois. En réalité, corriger une ligne dans la configuration, redémarrer le service et vérifier si le problème est réglé prend 10 secondes. Créer une nouvelle branche dans Gitlab, pousser les modifications, attendre que r10k fonctionne sur Puppetmaster, lancer Puppet —environment=mybranch et encore patienter quelques minutes pendant tout ce traitement prend au moins 5 minutes.
- Tous les changements se font en créant une Merge Request dans Gitlab, et il est nécessaire d'obtenir l'approbation d'au moins un membre de l'équipe. Des changements significatifs, décidés par le leader de l'équipe, nécessitent deux ou trois approbations.
- Tous les changements sont d'une manière ou d'une autre textuels (puisque les manifestes Puppet, les scripts et les données Hiera sont du texte), les fichiers binaires sont fortement déconseillés et des raisons solides sont nécessaires pour approuver de tels fichiers.
Alors, les options que j'ai envisagées :
- Munin — si l'infrastructure compte plus de 10 serveurs, l'administration devient un véritable cauchemar (je n'avais pas vraiment envie de vérifier cela, alors j'ai fait confiance à la parole). Zabbix — je l'avais déjà observé depuis longtemps, même en Russie, mais à l'époque, il était trop complexe pour mes besoins. Ici, j'ai dû l'éliminer à cause de l'utilisation de Puppet comme gestionnaire de configuration et Gitlab comme système de contrôle de version. À ce moment-là, autant que j'ai compris, Zabbix stocke toute la configuration dans une base de données, ce qui compliquait la gestion de la configuration dans les conditions actuelles et le suivi des modifications.
- Prometheus — c'est vers quoi nous allons finalement, selon l'humeur du département, mais à ce moment-là, je n'ai pas réussi à le maîtriser et je n'ai pas pu démontrer un prototype fonctionnel (Proof of Concept), donc j'ai dû abandonner.
- Il y avait encore quelques autres options qui nécessitaient soit une refonte complète du système, soit étaient à un stade embryonnaire / abandonnées et ont donc été rejetées pour cette raison.
- En fin de compte, je me suis arrêté sur Icinga2 pour trois raisons :
En fin de compte, j'ai choisi Icinga2 pour trois raisons :
1 — compatibilité avec Nrpe (le service client qui exécute des vérifications sur les commandes de Nagios). C'était très important, car nous avions à ce moment 135 (aujourd'hui, en 2019, il y en a 165) machines virtuelles avec une multitude de services/tests personnalisés, et tout refaire aurait été un véritable casse-tête.
2 — tous les fichiers de configuration sont au format texte, ce qui permet de les modifier facilement et de créer des demandes de fusion avec la possibilité de voir ce qui a été ajouté ou supprimé.
3 — c'est un projet OpenSource vivant et en développement. Nous aimons beaucoup l'OpenSource et contribuons autant que possible en créant des Pull Requests et des Issues pour résoudre des problèmes.
Alors, c'est parti, Icinga2.
Le premier problème auquel j'ai dû faire face — l'inertie des collègues. Tout le monde était habitué à Nagios/Nadjius (bien qu'on n'ait même pas pu parvenir à un compromis sur la prononciation) et à l'interface de CheckMK. Avec Icinga, l'interface est radicalement différente (c'était un inconvénient), mais il y a la possibilité de configurer de manière flexible ce que l'on veut voir à l'aide de filtres sur pratiquement n'importe quel paramètre (c'était un avantage, mais je me suis battu pour cela).
Filtres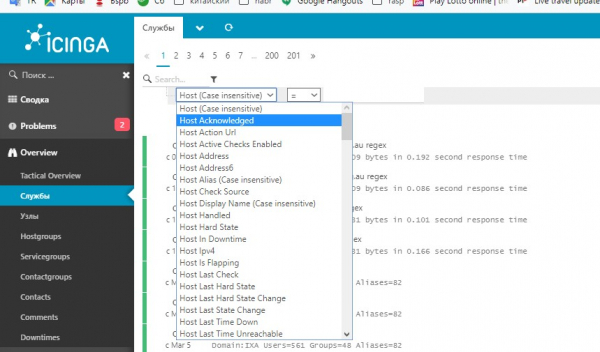
Évaluez la taille de la barre de défilement par rapport à la taille de la zone de défilement.
Deuxièmement — tout le monde était habitué à voir toute l'infrastructure sur un seul écran, car CheckMk permet de travailler avec plusieurs hôtes Nagios, mais l'interface d'Icinga ne le faisait pas (en fait, elle le faisait, mais j'en parlerai plus bas). Une alternative était un truc appelé Thruk, mais son design faisait vomir tous les membres de l'équipe, sauf un — celui qui l'a proposé (ce n'était pas moi).
Au diable Thruk — décision unanime de l'équipe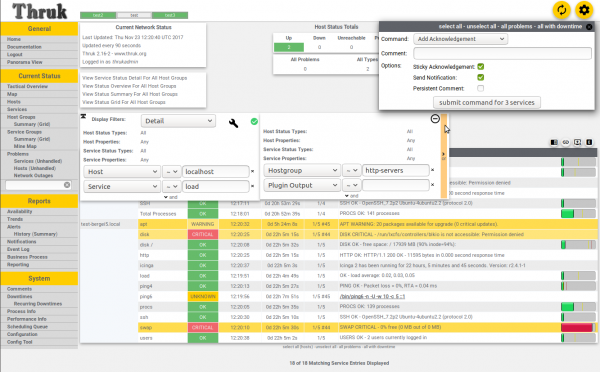
Après quelques jours de brainstorming, j'ai proposé l'idée de la surveillance de cluster, où il y a un maître-hôte dans la zone de production et deux hôtes subordinés — un dans dev/test et un hôte externe, situé chez un autre fournisseur, afin de surveiller nos services du point de vue du client ou d'un observateur extérieur. Cette configuration permettait de voir tous les problèmes dans une seule interface web et fonctionnait tout à fait bien, mais Puppet… Le problème avec Puppet était que le maître-hôte devait maintenant être au courant de tous les hôtes et services/vérifications dans le système et devait les répartir entre les zones (dev-test, staging-prod, ext), mais l'envoi de modifications via l'API Icinga prend quelques secondes, alors que la compilation de l'annuaire Puppet de tous les services pour tous les hôtes prend plusieurs minutes. Cela m'est encore reproché, bien que j'aie déjà expliqué plusieurs fois comment tout fonctionne et pourquoi cela prend autant de temps.
Troisièmement, une multitude de SnowFlakes (flocons de neige) — des éléments qui se distinguent du système global car ils ont quelque chose de particulier, donc les règles générales ne s'appliquent pas. Cela se résolvait par une attaque frontale — s'il y a des alertes, mais qu'en réalité tout va bien, alors il faut creuser plus profondément et comprendre pourquoi cela me génère une alerte, alors que ce n'est pas nécessaire. Ou inversement — pourquoi Nagios panique alors qu'Icinga ne le fait pas.
Quatrièmement, Nagios fonctionnait ici depuis trois ans avant moi et il y avait initialement plus de confiance en lui qu'en mon système moderne et sophistiqué, donc chaque fois qu'Icinga déclenchait une alerte, personne ne faisait rien tant que Nagios ne s'inquiétait pas pour le même problème. Mais très rarement, Icinga émettait de vraies alertes avant Nagios et je considère cela comme un sérieux problème, que j'aborderai dans la section « Conclusions ».
Au final, la mise en service a été retardée de plus de 5 mois (prévue pour le 28 juin 2018, en réalité — le 3 décembre 2018), principalement à cause du « contrôle de parité » — ce phénomène où plusieurs services dans Nagios dont personne n'a entendu parler ces deux dernières années, mais EXACTEMENT MAINTENANT, ils ont, bon sang, émis une alerte urgente sans aucune raison et je devais expliquer pourquoi ils n'étaient pas sur mon tableau de bord et je devais les ajouter dans Icinga pour que « le contrôle de parité soit complet » (Tous les services/vérifications dans Nagios correspondent aux services/vérifications dans Icinga).
Mise en œuvre :
La première chose — la guerre entre Code et Data, dans le style Puppet. Toutes les données, vraiment toutes, doivent être dans Hiera et rien d'autre. Tout le code est dans des fichiers .pp. Les variables, abstractions, fonctions — tout va dans pp.
Au final, nous avons une multitude de machines virtuelles (165 au moment de la rédaction de cet article) et 68 applications web à surveiller pour garantir leur fonctionnalité et la validité des certificats SSL. Cependant, en raison de complications historiques, les informations pour la surveillance des applications proviennent d'un référentiel gitlab séparé et le format des données n'a pas changé depuis les temps de Puppet 3, ce qui crée des complexités supplémentaires dans la configuration.
Code Puppet pour les applications, préservez vos yeux
define profiles::services::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # ajoute des notifications pour le groupe par défaut (systèmes) + tout groupe défini dans int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Sélectionne une regex à vérifier

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/ },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Divise une application par domaines s'il y en a deux ou plus
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Fait de l'adresse IP un tableau si ce n'est pas le cas, car askizzy a 2 ips et c'est un tableau
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Fusionne la zone par défaut (où l'application est définie) et les zones supplémentaires s'il y en a
      $web_ipaddress.each | String $ip_address | {            # Pour chaque IP (si nous en avons plusieurs)
        $suffix = length($web_ipaddress) ? {                  # Si nous avons plus d'une - ajoute l'IP comme suffixe à ce nom d'hôte pour éviter la duplication des ressources
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Utiliser seulement le dernier octet cause une collision entre nginx-vip 203.15.70.94 et l'ip ext. 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Si c'est un hôte pour ext - le préfixe devient 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Le code de configuration des hôtes et des services a également une apparence horrible :
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # sera activé lorsque nous passerons complètement à icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Veuillez vous assurer que le noeud a le fait $location défini (int, pm, ext)')
    }
  }

  file { '\/etc\/icinga2\/conf.d\/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"\/etc\/icinga2\/conf.d\/${file_name}":
      ensure => present,
      source => "puppet:\/\/modules\/profiles\/services\/monitoring\/default_config\/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # Ceci est pour l'invasion de vaisseau spatial lorsque cela sera prêt.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Division des listes de sites par groupes d'hôtes - docker_host\/gluster_host\/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Division des listes de groupe par hôtes
      # Ce host est-il dans le tableau $hosts_has_large_disks ? Si oui, définissez host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Fusionner les vars séparément

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Tous les hôtes gérés par API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Division des hôtes api par zones
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Division des listes de sites par groupes d'hôtes - docker_host\/gluster_host\/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Division des listes de groupe par hôtes
          # Ce host est-il dans le tableau $hosts_has_large_disks ? Si oui, définissez host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}\/${zone}\/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### FIN DES HOSTS ####

####   SERVICES   ####

  $services.each | String $service_group, Hash $s_list |{             # Groupe de services et liste de services dans ce groupe
    $service_list = $s_list['checks']                                 # Liste des contrôles réels, séparément des paramètres du groupe SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # paramètres globaux de service + paramètres de groupe de service
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Si nous remplaçons le timeout de contrôle par défaut, mais pas le timeout nrpe, faisons en sorte que le timeout nrpe soit le même que le timeout de contrôle
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga convertira 1m en 60 automatiquement!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Par défaut, nous utilisons nrpe et toutes les commandes sont exécutées via nrpe. Donc vars.nrpe_command = $service_name est une valeur par défaut
      # Si c'est une commande Icinga côté serveur - nous n'avons pas besoin de 'nrpe_command'
      # mais il n'y a aucun mal à avoir cette var et le code est plus court

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Assemblage de $vars à partir des paramètres de service par défaut globaux, des paramètres de groupe de service, des paramètres de ce contrôle particulier et n'oublions pas les paramètres nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick est requis partout, sinon cela devient "La valeur '' ne peut pas être convertie en numérique"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Assignez le groupe par défaut (systèmes) si d'autres groupes ne sont pas définis

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Cela doit être fusionné séparément, car la fusion en tant que partie de MERGED_DATA écrase les tableaux plutôt que de les fusionner, donc nous perdons certaines valeurs d'"assign" et "ignore"

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### FIN DES SERVICES ####

#### AUTRES CHOSES ENNUYEUSES ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Fusion des paramètres de notification pour les utilisateurs avec d'autres paramètres
  $users_oncall = deep_merge($users, $oncall)
  # Magie. Ne touchez pas.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles\/os\/redhat\/centos7\/sudoers\/icinga.erb',
  }

}
Je travaille encore sur ce code et l'améliore autant que possible. Cependant, ce type de code a permis d'utiliser une syntaxe simple et compréhensible dans Hiera :
Données
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Tous les checks sont regroupés en catégories, et chaque catégorie possède des paramètres par défaut concernant où et à quelle fréquence exécuter ces checks, quelles notifications envoyer et à qui.
Dans chaque check, on peut redéfinir n'importe quelle option et tout cela s'additionne également aux paramètres par défaut de tous les checks en général. C'est pourquoi dans config.pp il y a ce code - il s'agit de la fusion de tous les paramètres par défaut avec les paramètres des groupes et ensuite avec chaque check individuel.
Un autre changement important a été la possibilité d'utiliser des fonctions dans les paramètres, par exemple, une fonction pour modifier le port, l'adresse et l'URL pour le check http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Cela signifie que — si dans la définition de l'hôte existe une variable http_port — il faut l'utiliser, sinon 443. Par exemple, l'interface web de jabber est sur 9090, et Unifi est sur 7443.
http_vhost signifie ignorer DNS et prendre cette adresse.
Si l'URI est précisé dans l'hôte — il faut s'y rendre, sinon prendre «\/».
Une histoire amusante s'est produite avec http_ssl — ce dernier ne voulait pas s'éteindre comme demandé. J'ai longtemps pataugé dans cette ligne, jusqu'à ce que je réalise que la variable dans la définition de l'hôte :
http_ssl: falseSubstitué dans l'expression
if(host.vars.http_ssl) { return false } else { return true }comment faux et au final, cela donne
if(false) { return false } else { return true }c'est-à-dire que la vérification ssl est toujours active. Cela a été résolu en changeant la syntaxe :
http_ssl: noConclusions:
Avantages :
- Nous avons maintenant un système de surveillance unique, et non plus deux, comme c'était le cas au cours des 7-8 derniers mois, ou un, obsolète et vulnérable.
- La structure des données des hôtes / services (vérifications) est maintenant (à mon avis) beaucoup plus lisible et compréhensible. Pour d'autres, ce n'était pas si évident, donc j'ai dû créer quelques pages dans le wiki local pour expliquer comment tout cela fonctionne et ce qui doit être corrigé.
- Il existe une possibilité de configuration flexible des vérifications à l'aide de variables et de fonctions, par exemple pour vérifier http_regexp, le motif recherché, le code de retour, l'url et le port peuvent être spécifiés dans les paramètres de l'hôte.
- Il y a plusieurs panneaux (dashboards), pour chacun d'eux, il est possible de définir sa propre liste d'alertes affichées et de tout gérer via Puppet et des demandes de fusion.
Inconvénients :
- L'inertie des membres de l'équipe — Nagios travaillait, travaillait et travaillait, tandis que cette Icinga de ton côté plante constamment. Et comment voir l'historique ici ? Ah mince, elle ne se met pas à jour... (Le problème réel — l'historique des alertes ne se met pas à jour automatiquement, seulement avec F5)
- L'inertie du système — lorsque je clique dans l'interface web sur « mettre à jour » (check now) — le résultat de l'exécution dépend de la météo sur Mars, surtout pour les services complexes qui nécessitent des dizaines de secondes pour être exécutés. Un tel résultat est courant.

- Dans l'ensemble, selon les statistiques d'un semestre de fonctionnement des deux systèmes côte à côte, Nagios a toujours fonctionné plus rapidement qu'Icinga, et cela m'agaçait beaucoup. Il me semble qu'il y a eu des problèmes avec les temporisateurs et que la vérification toutes les cinq minutes se fait en fait toutes les 5:30 ou quelque chose comme ça.
- Si je redémarre le service à tout moment (systemctl restart icinga2) — toutes les vérifications qui étaient en cours d'exécution à ce moment-là afficheront une alerte critique <terminated by signal 15> à l'écran et de l'extérieur, cela semble comme si tout était tombé ().
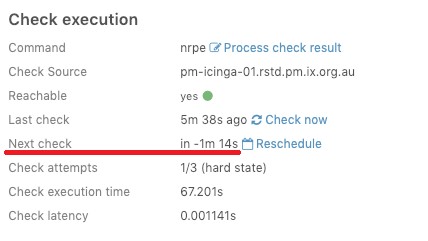
Mais dans l'ensemble, cela fonctionne.
Source : habr.com
