

19 septembre à Moscou première rencontre thématique HUG (Highload++ User Group) consacrée aux microservices. Lors de celle-ci, nous avons présenté une conférence intitulée « L'exploitation des microservices : la taille a son importance, même si vous avez Kubernetes », où nous avons partagé l'expérience approfondie de la société « Flant » dans l'exploitation de projets ayant une architecture microservices. Cela sera principalement utile à tous les développeurs qui envisagent d'appliquer cette approche dans leurs projets actuels ou futurs.
Nous présentons (50 minutes, bien plus informatif qu'un article), ainsi qu'un résumé principal sous forme de texte.
NB : La vidéo et la présentation sont également disponibles à la fin de cette publication.
Introduction
En général, une bonne histoire a une introduction, un corps principal et une conclusion. Cette conférence ressemble davantage à une introduction, qui est en plus tragique. Il est également important de noter qu'elle présente un point de vue sur les microservices. d'exploitation.
Je commencerai par ce graphique, dont l'auteur (en 2015) est Martin Fowler :
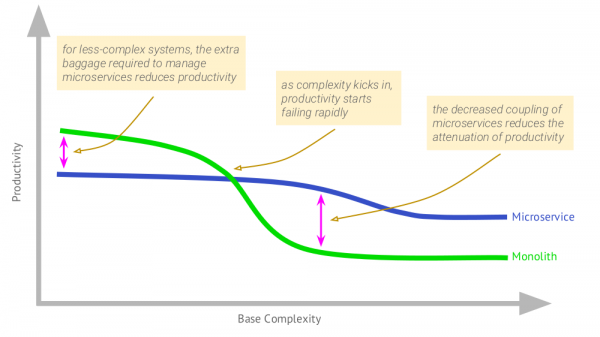
On peut y voir que dans le cas d'une application monolithique, après avoir atteint une certaine taille, la productivité commence à chuter. Les microservices se distinguent par le fait que leur productivité initiale est plus faible, mais à mesure que la complexité augmente, la dégradation de l'efficacité pour eux est moins évidente.
Je compléterai ce graphique pour le cas d'utilisation de Kubernetes :
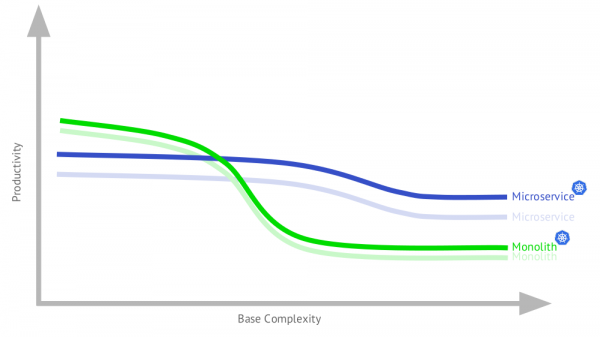
Pourquoi l'application avec microservices s'est améliorée ? Parce que cette architecture impose des exigences sérieuses en matière d'architecture, qui sont à leur tour bien satisfaites par les possibilités de Kubernetes. D'autre part, une partie de cette fonctionnalité sera également utile pour le monolithe, surtout parce que le monolithe typique aujourd'hui n'est pas tout à fait un monolithe (les détails seront abordés plus tard dans la conférence).
Comme on peut le voir, le graphique final (quand les applications monolithiques et microservices sont dans une infrastructure avec Kubernetes) ne diffère pas beaucoup de l'original. Ensuite, nous aborderons les applications exploitées avec Kubernetes.
L'utilité et la nocivité des microservices
Et ici, la pensée principale :
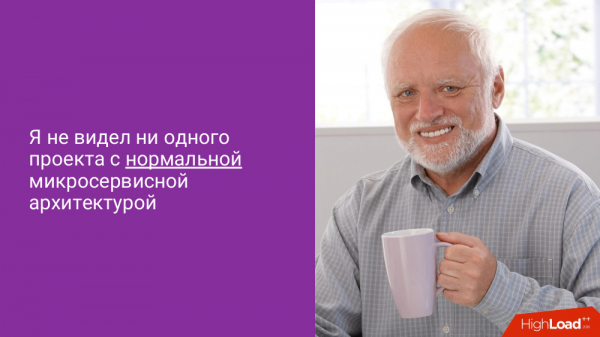
Qu'est-ce que une architecture microservices normale ? Elle doit vous apporter un réel bénéfice, en augmentant l'efficacité du travail. Si l'on se réfère au graphique, voici à quoi cela ressemble :
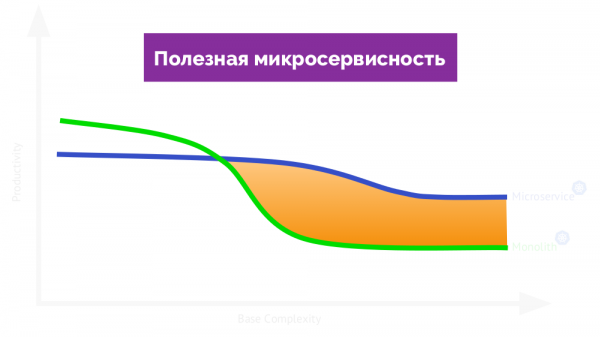
Si on l'appelle utile, alors de l'autre côté du graphique se trouvera la nocivité des microservices (qui nuisent au travail) :
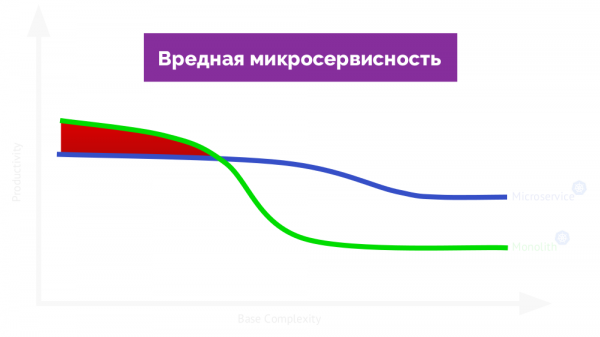
Revenons à la «pensée principale» : faut-il faire confiance à mon expérience ? Depuis le début de cette année, j'ai regardé 85 projets. Tous n'étaient pas des microservices (environ un tiers à la moitié d'entre eux avaient cette architecture), mais c'est quand même un grand nombre. Nous (la société «Flant») en tant que sous-traitants avons la chance de voir une large variété d'applications, développées tant par de petites entreprises (avec 5 développeurs) que par de grandes (~500 développeurs). Un autre point positif est que nous voyons comment ces applications vivent et évoluent au fil des ans.
Pourquoi les microservices ?
Sur la question de l'utilité des microservices, il existe bien spécifique
- d'un certain Martin Fowler :
- des frontières claires de modularité ;
- un déploiement indépendant ;
la liberté de choix des technologies.
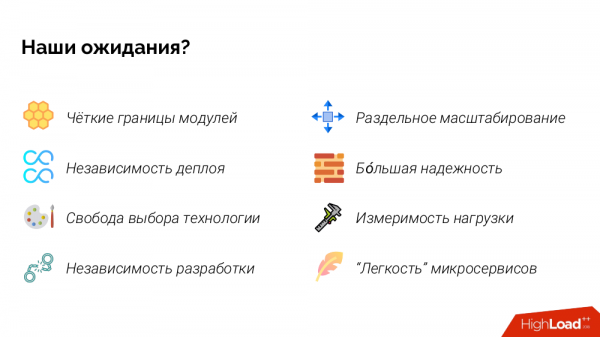
J'ai beaucoup discuté avec des architectes et des développeurs de logiciels, leur demandant pourquoi ils ont besoin de microservices. J'ai élaboré ma propre liste de leurs attentes. Voici ce que j'ai trouvé :
- Si je devais décrire «en sentiments» certains de ces points, cela donnerait :
- des frontières claires des modules : nous avons un terrible monolithe, et maintenant tout sera soigneusement ordonné dans des dépôts Git, où tout est «à sa place», sans mélanger le chaud et le doux ;
- indépendance de déploiement : nous pourrons déployer les services de manière indépendante, pour accélérer le développement (publier de nouvelles fonctionnalités simultanément) ;
- bdeplus de fiabilité : si une dégradation partielle se produit (un microservice sur 20 tombe), alors seule un bouton cessera de fonctionner, et le système dans son ensemble continuera à fonctionner.
Une architecture microservices typique (nuisible)
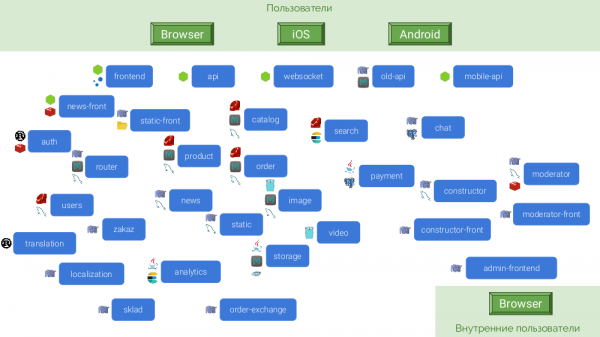
Pour expliquer pourquoi dans la réalité tout n'est pas comme nous l'attendons, je vais présenter une représentation collective de l'architecture des microservices, basée sur l'expérience de nombreux projets différents.
Prenons l'exemple d'une boutique en ligne abstraite, qui cherche à concurrencer Amazon ou au moins OZON. Son architecture de microservices ressemble à ceci :
Pour diverses raisons, ces microservices sont écrits sur différentes plateformes :

Puisqu chaque microservice doit être autonome, bon nombre d'entre eux nécessitent leur propre base de données et cache. L'architecture finale se présente comme suit :
Quelles en sont les conséquences ?
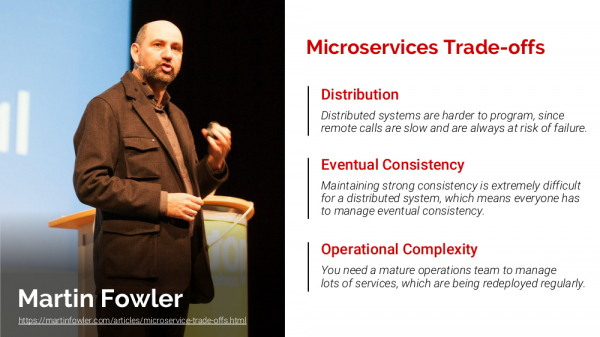
Fowler a à ce sujet — sur le « prix » à payer pour l'utilisation des microservices :
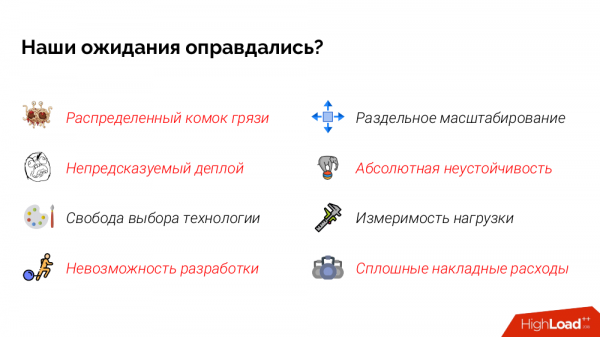
Nous allons voir si nos attentes étaient justifiées.
Des frontières claires entre les modules…
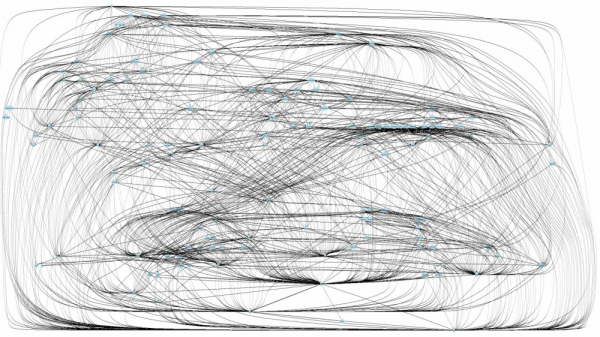
Mais combien de microservices devons-nous réellement ajuster, pour déployer le changement ? Pouvons-nous vraiment comprendre comment tout fonctionne, sans traceur distribué (puisque chaque requête est traitée par la moitié des microservices) ?
Il existe un modèle de «», et ici nous avons carrément une boule de boue distribuée. Pour l'illustrer, voici un schéma approximatif de la circulation des requêtes :
Indépendance du déploiement…
Techniquement, elle est atteinte : nous pouvons redéployer chaque microservice individuellement. Mais en pratique, il faut prendre en compte que de nombreux microservices sont toujours déployés en même temps, et nous devons considérer l'ordre de leur déploiement. Idéalement, nous devrions vraiment tester dans un environnement séparé, dans le bon ordre pour le déploiement de la version.
Liberté de choix technologique…
Elle existe. Juste rappeler que cette liberté frôle souvent l'anarchie. Il est crucial ici de ne pas choisir des technologies juste pour le plaisir de les « essayer ».
Indépendance du développement…
Comment créer un environnement de test pour toute l'application (avec autant de composants) ? De plus, il faut le maintenir à jour. Tout cela conduit à ce que le nombre réel d'environnements de test, que nous pouvons effectivement maintenir, s'avère minimal..
Et déployer tout cela localement ? En réalité, souvent le développeur travaille indépendamment, mais « au petit bonheur la chance », car il doit attendre qu'un environnement de test se libère.
Scalabilité distincte…
Oui, mais elle est limitée par les systèmes de gestion de bases de données utilisés. Dans l'exemple donné, il n'y aura pas de problèmes avec Cassandra, mais il y en aura avec MySQL et PostgreSQL.
Unedeplus grande fiabilité…
Non seulement la défaillance d'un microservice compromet souvent le bon fonctionnement de l'ensemble du système, mais il y a aussi un nouveau problème : rendre chaque microservice résistant aux pannes est très difficile. Parce que dans les microservices, différentes technologies sont utilisées (memcache, Redis, etc.), pour chacune, il faut tout réfléchir et mettre en œuvre, ce qui, bien sûr, est possible, mais nécessite d'énormes ressources.
Mesure de la charge…
Tout va vraiment bien avec ça.
La « légèreté » des microservices…
Nous avons non seulement de grandes surcharges réseau (multipliant les requêtes DNS, etc.), mais aussi à cause de nombreux sous-appels, nous avons commencé à répliquer des données (stocker des caches), ce qui a conduit à un volume de stockage significatif.
Et voici le résultat par rapport à nos attentes :
Mais ce n'est pas tout !
Parce que :
- Nous aurons probablement besoin d'un bus de messages.
- Comment faire une sauvegarde cohérente à un moment donné ? La seule vraie option est de couper le trafic pour cela. Mais comment faire cela en production ?
- S'il s'agit de soutenir plusieurs régions, organiser la résilience dans chacune d'elles est une tâche très laborieuse.
- Il y a un problème de modifications centralisées. Par exemple, si nous devons mettre à jour la version PHP, nous devrons faire un commit dans chaque dépôt (et il y en a des dizaines).
- La croissance de la complexité opérationnelle semble exponentielle.
Que faire avec tout cela ?
Commencez par une application monolithique. L'expérience de Fowler montre que presque toutes les applications microservices réussies ont commencé par un monolithe devenu trop grand, qui a ensuite été divisé. En même temps, pratiquement tous les systèmes construits comme microservices depuis le début ont rencontré de graves problèmes tôt ou tard.
Une autre pensée précieuse est que pour qu'un projet avec une architecture microservices soit réussi, vous devez très bien comprendre à la fois le domaine et comment créer des microservices. Et le meilleur moyen de connaître un domaine, c'est de créer un monolithe.
Mais que faire si nous nous trouvons déjà dans cette situation ?
La première étape pour résoudre tout problème est de le reconnaître et de comprendre qu'il s'agit d'un problème, que nous ne voulons plus souffrir.
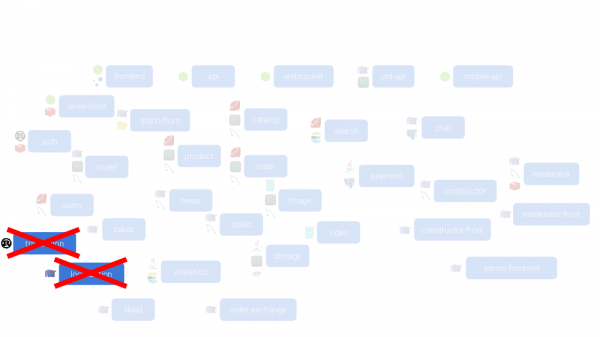
Dans le cas d'un monolithe surdimensionné (lorsque nous avons épuisé notre capacité à ajouter des ressources), nous le divisons, mais dans ce cas, c'est l'inverse : lorsque l'excès de microservices ne fait plus de bien, mais nuit — découpez le superflu et regroupez!
Par exemple, pour l'image composite ci-dessus…
Éliminez les microservices les plus douteux :
Regroupez tous les microservices responsables de la génération du frontend :
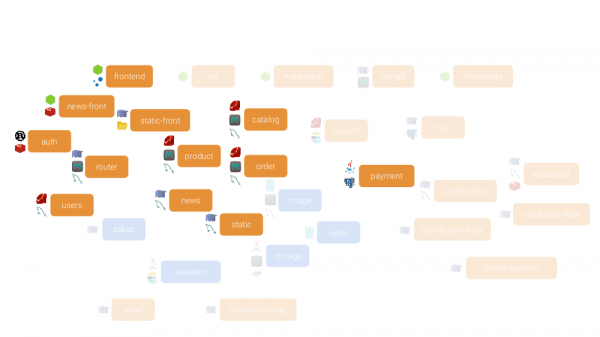
… en un microservice écrit dans un (moderne et normal, comme vous le pensez) langage / framework :
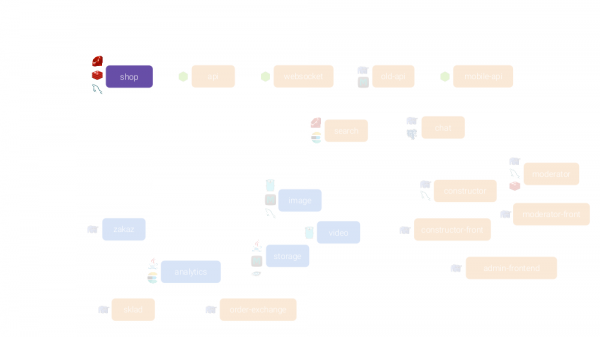
Il disposera d'un ORM (une base de données) et d'abord de quelques applications :
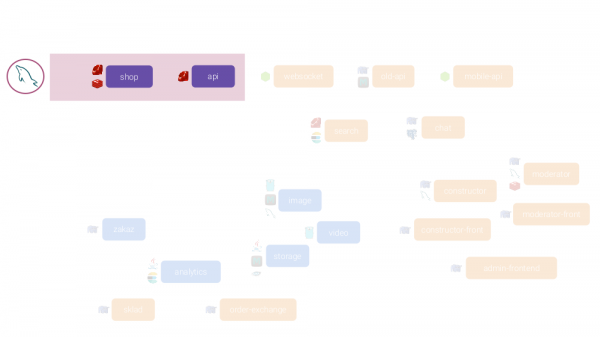
… mais en réalité, il est possible d'en transférer beaucoup plus, obtenant ainsi ce résultat :
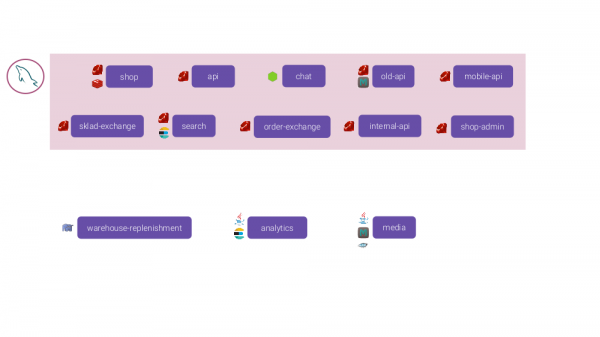
Dans Kubernetes, nous lançons tout cela en tant qu'exemplaires séparés, ce qui signifie que nous pouvons toujours mesurer la charge et les mettre à l'échelle séparément.
En résumé
Regardez la situation de manière plus large. Très souvent, tous ces problèmes avec les microservices surviennent parce que quelqu'un a pris sa tâche, mais voulait « jouer avec les microservices ».
Dans le mot « microservices », la partie « micro » est superflue. Ils sont « micro » uniquement parce qu'ils sont plus petits qu'un énorme monolithe. Mais il ne faut pas penser à eux comme à quelque chose de petit.
Et pour conclure, revenons au graphique initial :
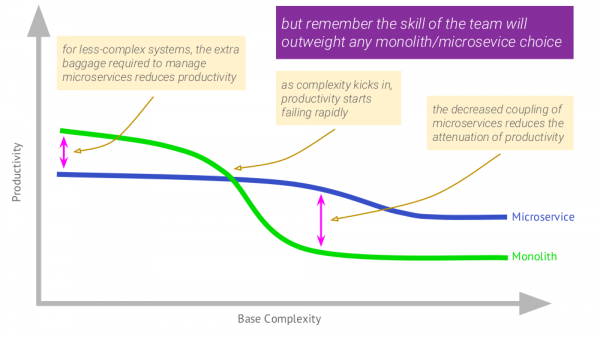
La note écrite à son intention (en haut à droite) revient à dire que les compétences de l'équipe qui réalise votre projet sont toujours primordiales — c'est elles qui joueront un rôle clé dans votre choix entre microservices et monolithes. Si l'équipe manque de compétences mais commence à créer des microservices, l'histoire sera certainement fatale.
Vidéos et diapositives
Vidéo de la présentation (~50 minutes ; malheureusement, elle ne transmet pas les nombreuses émotions des visiteurs, qui ont en grande partie déterminé l'ambiance de l'exposé, mais c'est comme ça) :
Présentation de l'exposé :
P.S.
D'autres exposés sur notre blog :
- «» (Dmitry Stolyarov ; 28 mai 2018 à RootConf);
- «» (Dmitry Stolyarov ; 7 novembre 2017 à HighLoad++);
- «» (Dmitry Stolyarov ; 6 juin 2017 à RootConf);
- «» (Dmitry Stolyarov ; 8 novembre 2016 à HighLoad++);
- «» (Dmitry Stolyarov ; 31 mai 2016 à RootConf).
Vous serez peut-être également intéressé par les publications suivantes :
- «»;
- «»;
- «».
Source : habr.com
