

Bonjour à tous ! Je suis développeur CV chez KROK. Cela fait déjà 3 ans que nous réalisons des projets dans le domaine du CV. Durant ce temps, nous avons fait toutes sortes de choses, par exemple : surveiller les conducteurs pour qu'ils ne boivent pas, ne fument pas, ne parlent pas au téléphone et regardent la route, plutôt que de rêvasser ou de contempler les nuages ; enregistrer les amateurs qui empruntent les voies réservées et occupent plusieurs places de parking ; veiller à ce que les employés portent des casques, des gants, etc. ; identifier un employé qui souhaite entrer sur le site ; compter tout ce qu'il est possible de compter.
Pourquoi tout cela ?
Au cours de la réalisation des projets, nous avons accumulé des difficultés, de nombreuses difficultés, dont certaines vous sont familières, ou que vous découvrirez à l'avenir.
Modélisons une situation
Imaginons que nous avons rejoint une jeune entreprise « N », dont l'activité est liée à l'IA. Nous travaillons sur un projet d'IA (DL, CV), puis pour une raison quelconque, nous passons à un autre travail, faisons une pause, et revenons à notre propre ou à un projet d'un autre.
- Le moment de vérité arrive, il faut se rappeler où l'on en était, quels hyperparamètres on avait essayés et, surtout, quels résultats ils ont donnés. Il peut y avoir de nombreuses façons de stocker des informations sur tous les lancements : dans la tête, dans des configurations, dans un carnet, dans un environnement de travail dans le cloud. J'ai déjà vu un cas où les hyperparamètres étaient stockés sous forme de lignes commentées dans le code, un vrai vol de créativité. Et maintenant, imaginez que vous ne revenez pas à votre projet, mais à celui d'une personne qui a quitté l'entreprise, et vous avez hérité du code et d'un modèle nommé model_1.pb. Pour compléter le tableau et partager toute la douleur, imaginons que vous êtes également un spécialiste débutant.
- Continuons. Pour exécuter le code, nous et tous ceux qui travailleront avec doivent créer un environnement. Il arrive souvent que cet environnement ne nous ait pas été transmis pour une raison quelconque. Cela peut aussi devenir une tâche non triviale. Vous ne voulez pas passer du temps sur cette étape, n'est-ce pas ?
- Nous entraînons un modèle (par exemple, un détecteur de voitures). Nous atteignons un moment où il devient assez bon — c'est le moment de sauvegarder le résultat. Appelons-le car_detection_v1.pb. Ensuite, nous entraînons un autre modèle — car_detection_v2.pb. Un certain temps plus tard, nos collègues ou nous-mêmes continuons à former encore et encore, en utilisant différentes architectures. Au final, une multitude d'artefacts se forme, dont nous devons rassembler les informations avec soin (mais nous le ferons plus tard, il y a des affaires plus urgentes à traiter pour l'instant).
- Et voilà ! Nous avons un modèle ! Nous pouvons commencer à entraîner le prochain modèle, à développer l'architecture pour résoudre un nouveau problème ou bien aller prendre un thé ? Mais qui va déployer cela ?
Identifier les problèmes
Travailler sur un projet ou un produit représente l'effort de nombreuses personnes. Avec le temps, des gens partent et d'autres arrivent, les projets se multiplient et deviennent plus complexes. D'une manière ou d'une autre, des situations du cycle décrit ci-dessus (et d'autres) se produiront sous diverses combinaisons d'itération en itération. Tout cela se traduit par une perte de temps, de la confusion, une nervosité, éventuellement du mécontentement de la part des clients, et finalement — de l'argent perdu. Bien que nous ayons tendance à toujours retomber dans les mêmes travers, je pense que personne ne souhaite revivre ces moments encore et encore.
Ainsi, nous avons parcouru un cycle de développement et constatons qu'il y a des problèmes à résoudre. Pour cela, nous devons :
- conserver les résultats de manière pratique ;
- faciliter l'intégration de nouveaux employés ;
- simplifier le processus de déploiement de l'environnement de développement ;
- configurer le processus de versioning des modèles ;
- avoir un moyen pratique de validation des modèles ;
- trouver un outil de gestion de l'état des modèles ;
- trouver un moyen de livrer les modèles en production.
Il semble nécessaire de concevoir un workflow qui permettrait de gérer facilement et efficacement ce cycle de vie ? Cette pratique a un nom : MLOps.
MLOps, ou DevOps pour l'apprentissage automatique, permet aux équipes d'experts en traitement et analyse de données et aux professionnels de l'informatique de collaborer, ainsi que d'accélérer le développement et le déploiement des modèles grâce à la surveillance, la validation et un système de gestion pour les modèles d'apprentissage automatique.
Vous pouvez , ce que les gars de Google en pensent. De l'article, il est clair que MLOps est un sujet assez vaste.
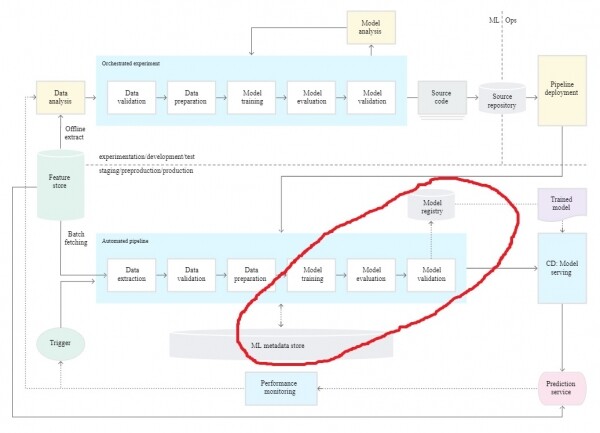
Dans cet article, je vais décrire seulement une partie du processus. Pour sa mise en œuvre, j'utiliserai l'outil MLflow, car c'est un projet open-source nécessitant peu de code pour la connexion et offrant une intégration avec des frameworks ML populaires. Vous pouvez rechercher d'autres outils en ligne, tels que Kubeflow, SageMaker, Trains, etc., et peut-être trouver celui qui correspond le mieux à vos besoins.
"Construisons" MLOps à travers l'utilisation de l'outil MLFlow
MLFlow est une plateforme open-source pour la gestion du cycle de vie des modèles ML ().
MLflow comprend quatre composants :
- MLflow Tracking — gère la documentation des résultats et des paramètres ayant conduit à ces résultats ;
- MLflow Project — permet d'emballer le code et de le reproduire sur n'importe quelle plateforme ;
- MLflow Models — gère le déploiement des modèles en production ;
- MLflow Registry — permet de stocker des modèles et de gérer leur état dans un référentiel centralisé.
MLflow opère avec deux entités :
- un essai — c'est un cycle d'apprentissage complet, les paramètres et les métriques que nous souhaitons enregistrer ;
- un expérience — c'est un "thème" qui regroupe les essais.
Tous les étapes de l'exemple sont mises en œuvre sur le système d'exploitation Ubuntu 18.04.
1. Déployer le serveur
Pour que nous puissions facilement gérer notre projet et obtenir toutes les informations nécessaires, nous allons déployer un serveur. Le serveur de suivi MLflow comprend deux composants principaux :
- backend store — responsable du stockage des informations sur les modèles enregistrés (il prend en charge 4 SGBD : mysql, mssql, sqlite et postgresql) ;
- artifact store — responsable du stockage des artefacts (il prend en charge 7 options de stockage : Amazon S3, Azure Blob Storage, Google Cloud Storage, serveur FTP, serveur SFTP, NFS, HDFS).
En tant que artifact store pour simplifier, prenons un serveur SFTP.
- créons un groupe
$ sudo groupadd sftpg - ajoutons un utilisateur et définissons son mot de passe
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - ajustons quelques paramètres d'accès
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - ajoutons quelques lignes dans /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - redémarrons le service
$ sudo systemctl restart sshd
En tant que backend store prenons postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Créer un nouvel utilisateur : mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Entrez le nom du rôle à ajouter : mlflow_user
Entrez le mot de passe pour le nouveau rôle : mlflow
Entrez-le à nouveau : mlflow
Le nouveau rôle doit-il être superutilisateur ? (y/n) n
Le nouveau rôle doit-il être autorisé à créer des bases de données ? (y/n) n
Le nouveau rôle doit-il être autorisé à créer d'autres nouveaux rôles ? (y/n) n
# Créer la base de données mlflow_bd possédée par mlflow_user
$ createdb -O mlflow_user mlflow_db
Pour lancer le serveur, il est nécessaire d'installer les packages Python suivants (je recommande de créer un environnement virtuel séparé) :
pip install mlflow
pip install pysftp
Lançons notre serveur
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Ajouter le suivi
Pour que les résultats de nos entraînements ne soient pas perdus, que les générations futures de développeurs comprennent ce qui s'est passé, et que les collègues et vous puissiez analyser le processus d'apprentissage sereinement, nous devons ajouter le suivi. Par suivi, nous entendons la sauvegarde des paramètres, des métriques, des artefacts et toute information supplémentaire sur l'exécution de l'apprentissage, dans notre cas, sur le serveur.
À titre d'exemple, j'ai créé un petit avec Keras pour la segmentation de tout ce qui se trouve dans . Pour ajouter le suivi, j'ai créé le fichier mlflow_training.py.
Voici les lignes où se passe l'essentiel :
def run(self, epochs, lr, experiment_name):
        # obtenir l'id de l'expérience, créer une expérience en son absence
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # créer un "run" et obtenir son id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # indiquer que nous voulons sauvegarder les résultats sur un serveur distant
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Ici, self.remote_server est un petit wrapper autour des méthodes mlflow.tracking. MlflowClient (que j'ai créé pour la commodité), grâce auquel je crée un essai et un lancement sur le serveur. Ensuite, j'indique où les résultats du lancement doivent être envoyés (mlflow.set_tracking_uri(self.tracking_uri)). Je connecte la journalisation automatique mlflow.keras.autolog(). À ce jour, MLflow Tracking prend en charge la journalisation automatique pour TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Si vous ne trouvez pas votre framework ou bibliothèque, vous pouvez toujours journaliser explicitement. Nous allons démarrer l'entraînement. Nous enregistrons les tags et les paramètres d'entrée sur le serveur distant.
Avec quelques lignes, vous pouvez, comme tout le monde, accéder aux informations sur tous les lancements. Génial ?
3. Création du projet
Nous allons maintenant faire en sorte qu'il soit très simple de lancer le projet. Pour cela, nous allons ajouter un fichier MLproject et conda.yaml à la racine du projet.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'liste des catégories du jeu de données coco'}
        epochs: {type: int, help: 'nombre d'époques d'entraînement'}

        lr: {type: float, default: 0.001, help: 'taux d'apprentissage'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'exemples de resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'l'adresse du serveur'}
        experiment_name: {type: str, default: 'Mon_experience', help: 'nom de l’expérience distante et locale'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
Le projet MLflow possède plusieurs propriétés :
- Name — nom de votre projet ;
- Environment — dans mon cas, conda_env indique que nous utilisons Anaconda pour l'exécution et que la description des dépendances se trouve dans le fichier conda.yaml ;
- Entry Points — indique quels fichiers et avec quels paramètres peuvent être lancés (tous les paramètres lors du lancement de l'entraînement sont automatiquement journalisés).
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Vous pouvez utiliser docker comme environnement d'exécution, pour plus de détails, consultez .
4. Nous lançons l'entraînement
Clonez le projet et accédez au répertoire du projet :
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Pour le lancement, vous devez installer les bibliothèques.
pip install mlflow
pip install pysftp
Comme dans l'exemple, j'utilise conda_env, Anaconda doit être installé sur votre ordinateur (mais cela peut également être contourné en installant tous les paquets nécessaires manuellement et en jouant avec les paramètres de lancement).
Tous les préparatifs sont terminés et nous pouvons commencer l'entraînement. Depuis la racine du projet :
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Après avoir saisi la commande, un environnement conda sera automatiquement créé et l'entraînement sera lancé.
Dans l'exemple ci-dessus, j'ai passé le nombre d'époques pour l'entraînement, les catégories sur lesquelles nous souhaitons segmenter (la liste complète peut être consultée ) et l'adresse de notre serveur distant.
La liste complète des paramètres possibles peut être consultée dans le fichier MLproject.
5. Évaluation des résultats de l'entraînement
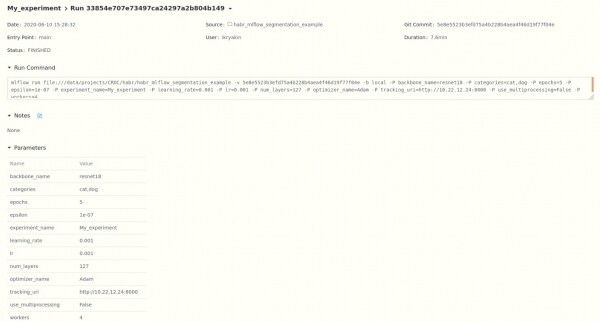
Après l'achèvement de l'entraînement, nous pouvons aller dans le navigateur à l'adresse de notre serveur
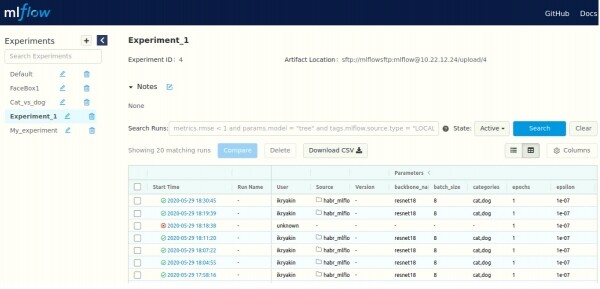
Ici, nous voyons la liste de toutes les expériences (en haut à gauche), ainsi que les informations concernant les lancements (au milieu). Nous pouvons consulter des informations plus détaillées (paramètres, métriques, artefacts et d'autres informations supplémentaires) pour chaque lancement.
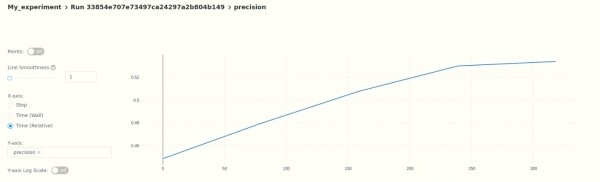
Pour chaque métrique, nous pouvons observer l'historique des changements.
C'est-à-dire, à ce stade, nous pouvons analyser les résultats en mode "manuel", vous pouvez également configurer une validation automatique en utilisant l'API MLflow.
6. Enregistrement du modèle
Après avoir analysé notre modèle et décidé qu'il est prêt à être déployé, nous procédons à son enregistrement. Pour cela, nous sélectionnons le lancement qui nous intéresse (comme indiqué dans le point précédent) et faisons défiler vers le bas.
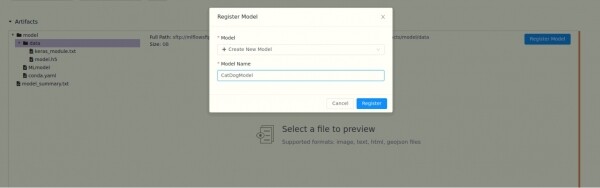
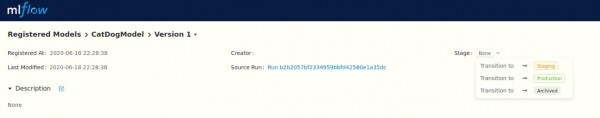
Après avoir donné un nom à notre modèle, il obtient une version. Lors de l'enregistrement d'un autre modèle avec le même nom, la version sera automatiquement incrementée.
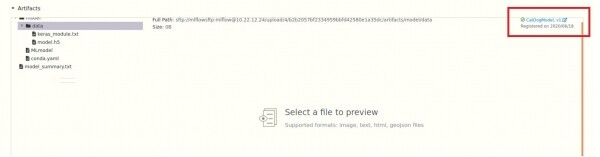
Pour chaque modèle, nous pouvons ajouter une description et choisir l'un des trois états (Staging, Production, Archived), ce qui, avec la gestion des versions, offre une flexibilité supplémentaire grâce à l'API.
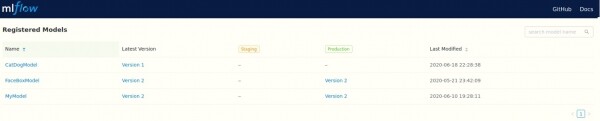
Nous avons également un accès facile à tous les modèles
et leurs versions.
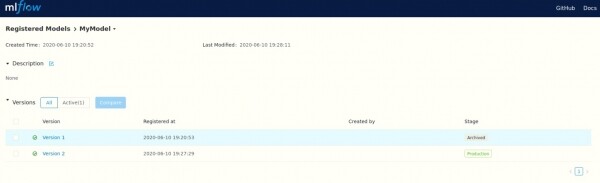
Comme dans le point précédent, toutes les opérations peuvent être réalisées via l'API.
7. Déploiement du modèle
À ce stade, nous avons déjà un modèle entraîné (keras). Voici un exemple de la façon dont nous pouvons l'utiliser :
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Ici, self.registry est à nouveau un petit wrapper autour de mlflow.tracking.MlflowClient, pour la commodité. L'idée est que j'accède à un serveur distant et que je recherche le modèle avec le nom spécifié, à savoir, la dernière version en production. Ensuite, je télécharge l'artefact localement dans le dossier .\/model et je construis le modèle à partir de ce répertoire mlflow.keras.load_model(local_path). Maintenant, nous pouvons utiliser notre modèle. Les développeurs de CV (ML) peuvent tranquillement se concentrer sur l'amélioration du modèle et publier de nouvelles versions.
En conclusion
J'ai présenté un système qui permet :
- de stocker de manière centralisée les informations sur les modèles ML, le cours et les résultats de l'apprentissage ;
- de déployer rapidement un environnement de développement ;
- de suivre et d'analyser le travail sur les modèles ;
- de gérer facilement la version et l'état des modèles ;
- de déployer facilement les modèles obtenus.
Cet exemple est simpliste et sert de point de départ pour construire votre propre système, qui pourrait inclure l'automatisation de l'évaluation des résultats et de l'enregistrement des modèles (p.5 et p.6 respectivement), ou vous pourriez ajouter la gestion des versions des ensembles de données, ou peut-être autre chose ? J'ai essayé de transmettre l'idée qu'il vous faut MLOps dans son ensemble, MLflow n'est qu'un moyen d'atteindre cet objectif.
Dites-moi quelles problèmes vous avez rencontrés, que je n'ai pas mentionnés ?
Que souhaiteriez-vous ajouter au système pour qu'il réponde à vos besoins ?
Quels outils et approches utilisez-vous pour résoudre tout ou partie des problèmes ?
P.S. Je laisse quelques liens :
projet github —
MLflow —
Mon email professionnel, pour les questions — ikryakin@croc.ru
Nous organisons régulièrement divers événements pour les professionnels de l'informatique. Par exemple, le 8 juillet à 19h00 (heure de Moscou), un meetup sur le CV se tiendra en ligne. Si cela vous intéresse, vous pouvez participer, l'inscription est ouverte. .
Source : habr.com
