

En 2018, dans les cercles professionnels et lors des conférences spécialisées sur l'IA, le concept d'MLOps est apparu, se solidifiant rapidement dans l'industrie et se développant aujourd'hui comme un domaine autonome. À terme, MLOps pourrait devenir l'un des secteurs les plus recherchés dans le domaine de l'IT. Qu'est-ce que c'est et comment cela fonctionne, nous allons le découvrir.
Qu'est-ce que MLOps
MLOps (fusion des technologies et des processus d'apprentissage automatique et des approches pour intégrer les modèles développés dans les processus d'affaires) est une nouvelle manière de collaboration entre les représentants du secteur des affaires, les chercheurs, les mathématiciens, les spécialistes de l'apprentissage automatique et les ingénieurs IT lors de la création de systèmes d'intelligence artificielle.
Autrement dit, c'est un moyen de transformer les méthodes et les technologies d'apprentissage automatique en un outil utile pour résoudre les problèmes commerciaux.
Il est important de comprendre que la chaîne de productivité commence bien avant le développement du modèle. Son premier pas consiste à définir le problème commercial, les hypothèses sur la valeur pouvant être extraite des données, et l'idée commerciale de son application.
Le concept même de MLOps est né comme une analogie du concept de DevOps appliqué aux modèles et technologies d'apprentissage automatique. DevOps est une approche de développement de logiciels qui permet d'augmenter la vitesse de mise en œuvre des changements tout en maintenant la flexibilité et la fiabilité grâce à une série d'approches, parmi lesquelles le développement continu, la séparation des fonctions en plusieurs microservices indépendants, le test automatisé et le déploiement de changements, le suivi global de la fonctionnalité, le système de réponse opérationnelle aux pannes détectées, etc.
DevOps a défini le cycle de vie des logiciels et l'idée a émergé dans la communauté des spécialistes d'appliquer la même méthodologie aux grands ensembles de données. DataOps est une tentative d'adapter et d'élargir la méthodologie en tenant compte des particularités de stockage, de transmission et de traitement de grands volumes de données sur diverses plateformes interconnectées.
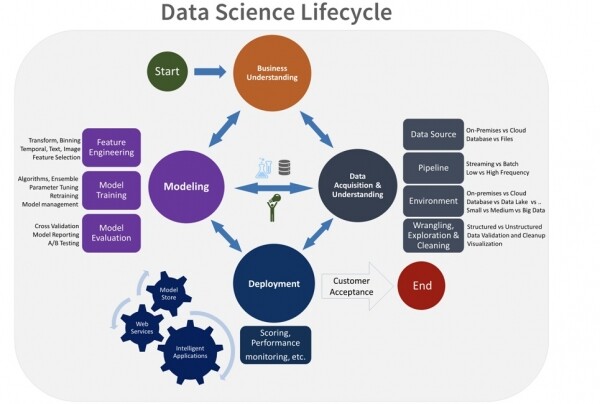
Avec un certain nombre critique de modèles de machine learning intégrés dans les processus métier des entreprises, une forte similitude a été observée entre le cycle de vie des modèles mathématiques de machine learning et celui des logiciels. La seule différence est que les algorithmes des modèles sont créés à l'aide d'outils et de méthodes de machine learning. Il en résulte naturellement l'idée d'appliquer et d'adapter les approches de développement logiciel déjà connues pour les modèles de machine learning. Ainsi, dans le cycle de vie des modèles de machine learning, on peut distinguer les étapes clés suivantes :
- définition de l'idée commerciale;
- entraînement du modèle;
- test et déploiement du modèle dans le processus métier;
- exploitation du modèle.
Lorsqu'il est nécessaire de modifier ou de réentraîner le modèle sur de nouvelles données dans le cadre de l'exploitation, le cycle redémarre - le modèle est retravaillé, testé et une nouvelle version est déployée.
Remarque. Pourquoi réentraîner plutôt que surentraîner ? Le terme « surentraînement du modèle » a une double signification : parmi les spécialistes, il désigne un défaut du modèle, lorsque le modèle prédit bien, répétant en fait le paramètre prédit sur l'échantillon d'apprentissage, mais fonctionne beaucoup moins bien sur un échantillon externe de données. Naturellement, un tel modèle est défectueux, car ce défaut ne permet pas de l'appliquer.
Dans ce cycle de vie, il semble logique d'utiliser des outils DevOps : tests automatisés, déploiement et surveillance, présentation du calcul des modèles sous forme de microservices distincts. Cependant, il existe également plusieurs particularités qui empêchent l'application directe de ces outils sans une connexion ML supplémentaire.
Comment faire fonctionner les modèles et en tirer profit
À titre d'exemple pour illustrer l'application de l'approche MLOps, prenons la tâche classique de robotisation d'un chat de support pour un produit bancaire (ou tout autre). En général, le processus commercial de support par chat se déroule comme suit : le client saisit un message avec une question dans le chat et reçoit une réponse de l'expert selon un arbre de dialogues prédéfini. La tâche d'automatisation d'un tel chat est généralement résolue à l'aide de systèmes de règles définis par des experts, très laborieux à développer et à maintenir. L'efficacité de cette automatisation, selon le niveau de complexité de la tâche, peut atteindre 20 à 30 %. Naturellement, l'idée émerge que l'implémentation d'un module d'intelligence artificielle – un modèle développé à l'aide de l'apprentissage automatique – est plus bénéfique car il :
- est capable de traiter un plus grand nombre de requêtes sans l'intervention d'un opérateur (selon le sujet, dans certains cas, l'efficacité peut atteindre 70 à 80 %) ;
- s'adapte mieux aux formulations non standards dans le dialogue – sait identifier l'intention, le véritable désir de l'utilisateur à partir d'une demande mal formulée ;
- sait déterminer quand la réponse du modèle est adéquate, et quand il existe des doutes quant à la « connaissance » de cette réponse, nécessitant de poser une question de clarification supplémentaire ou de passer à un opérateur ;
- peut être réapprise automatiquement (au lieu d'un groupe de développeurs adaptant et corrigeant constamment les scénarios de réponse, un spécialiste en Data Science réapprend le modèle, en utilisant les bibliothèques d'apprentissage automatique appropriées).
Comment faire fonctionner un tel modèle avancé ?
Comme pour toute autre tâche, avant de développer un tel module, il est nécessaire de définir le processus commercial et de décrire formellement la tâche spécifique que nous allons résoudre en appliquant la méthode d'apprentissage automatique. C'est à ce stade que commence le processus d'opérationnalisation, désigné par l'abréviation Ops.
La prochaine étape consiste pour le spécialiste des données à collaborer avec l'ingénieur en données afin de vérifier la disponibilité et l'adéquation des données, ainsi que l'hypothèse commerciale sur la viabilité de l'idée d'affaires, en développant un prototype de modèle et en vérifiant son efficacité réelle. Ce n'est qu'après la confirmation par l'entreprise que la transition de la phase de développement du modèle à son intégration dans les systèmes exécutant un processus commercial spécifique peut commencer. Une planification globale de l'intégration, ainsi qu'une compréhension approfondie, à chaque étape, de la manière dont le modèle sera utilisé et de l'impact économique qu'il apportera, sont fondamentales dans les processus d'implémentation des approches MLOps dans le paysage technologique de l'entreprise.
Avec l'évolution des technologies de l'IA, le nombre et la variété des tâches pouvant être résolues par l'apprentissage automatique augmentent de manière exponentielle. Chaque processus commercial entraîne des économies pour l'entreprise grâce à l'automatisation des tâches de postes de masse (centre d'appels, vérification et tri de documents, etc.), une expansion de la base de clients grâce à l'ajout de nouvelles fonctionnalités attrayantes et pratiques, des économies de coûts grâce à une utilisation optimale et à un réaffectation des ressources, et bien plus encore. In fine, chaque processus est axé sur la création de valeur et doit donc générer un certain effet économique. Il est crucial de formuler clairement l'idée commerciale et d'estimer le bénéfice attendu de l'implémentation du modèle dans la structure globale de création de valeur de l'entreprise. Des situations se présentent parfois où l'implémentation du modèle n'est pas rentable, et le temps que les spécialistes de l'apprentissage automatique y consacrent est bien plus coûteux qu'un poste d'opérateur effectuant cette tâche. C'est pourquoi il est essentiel d'identifier ces cas le plus tôt possible dans la création de systèmes d'IA.
Par conséquent, le modèle commence à générer des profits uniquement lorsqu'une tâche commerciale a été correctement formulée dans le cadre de MLOps, que les priorités ont été établies, et qu'un processus d'intégration du modèle dans le système a été défini dès les premières étapes de développement.
Nouveau processus – nouveaux défis
Une réponse complète à la question fondamentale des entreprises concernant l'applicabilité des modèles d'apprentissage machine pour la résolution de problèmes, la question générale de la confiance envers l'IA — est l'un des défis clés dans le développement et la mise en œuvre des approches MLOps. Au départ, les entreprises perçoivent avec scepticisme l'intégration de l'apprentissage machine dans les processus — il est difficile de se fier à des modèles dans des domaines où les gens ont traditionnellement travaillé. Pour les entreprises, les programmes apparaissent comme une « boîte noire », dont la pertinence des réponses doit encore être prouvée. De plus, dans le secteur bancaire, les entreprises de télécommunications et d'autres secteurs, il existe des exigences strictes de la part des régulateurs gouvernementaux. Tous les systèmes et algorithmes intégrés dans les processus bancaires sont soumis à un audit. Pour résoudre ce défi, prouver aux entreprises et aux régulateurs la validité et la correction des réponses de l'intelligence artificielle, des outils de surveillance sont intégrés avec le modèle. De plus, il existe une procédure de validation indépendante, obligatoire pour les modèles réglementaires, qui répond aux exigences de la Banque centrale. Un groupe d'experts indépendant effectue un audit des résultats obtenus par le modèle en tenant compte des données d'entrée.
Le deuxième défi est l'évaluation et la prise en compte des risques liés aux modèles lors de l'intégration d'un modèle d'apprentissage machine. Même une personne ne peut pas répondre avec une certitude absolue à la question de savoir si cette robe était blanche ou bleue, donc l'intelligence artificielle a aussi le droit de se tromper. Il faut également prendre en compte que les données peuvent évoluer avec le temps, et les modèles doivent être réentraînés pour fournir des résultats suffisamment précis. Pour que le processus commercial ne soit pas affecté, il est nécessaire de gérer les risques liés aux modèles et de surveiller le fonctionnement du modèle, en le réentraînant régulièrement sur de nouvelles données.
Mais après la première phase de méfiance, un effet inverse commence à se manifester. Plus il y a de modèles qui sont intégrés avec succès dans les processus, plus l'appétit des entreprises pour l'utilisation de l'intelligence artificielle grandit — de nouveaux défis apparaissent, qui peuvent être résolus par des méthodes d'apprentissage machine. Chaque tâche déclenche un processus entier, nécessitant diverses compétences :
- les data engineers préparent et traitent les données ;
- les data scientists appliquent des outils d'apprentissage machine et développent le modèle ;
- L'IT intègre le modèle dans le système;
- L'ingénieur ML détermine comment intégrer correctement ce modèle dans le processus, quel outil IT utiliser en fonction des exigences relatives au mode d'application du modèle, en tenant compte du flux des requêtes, du temps de réponse, etc.
- L'architecte ML conçoit comment réaliser physiquement le produit logiciel dans un système industriel.
L'ensemble du cycle nécessite un grand nombre de spécialistes hautement qualifiés. À un certain stade de développement et de pénétration des modèles ML dans les processus commerciaux, il s'avère que l'augmentation linéaire du nombre de spécialistes proportionnellement à l'augmentation du nombre de tâches devient coûteuse et inefficace. C'est pourquoi se pose la question de l'automatisation du processus MLOps - la définition de plusieurs classes standard de tâches d'apprentissage automatique, le développement de pipelines typiques de traitement des données et de réentraînement des modèles. Dans un scénario idéal pour résoudre de telles tâches, des professionnels ayant des compétences équivalentes dans les domaines de Big Data, Data Science, DevOps et IT sont nécessaires. Ainsi, le plus grand problème de l'industrie de la Data Science et le plus grand défi lors de l'organisation des processus MLOps est l'absence d'une telle compétence sur le marché de la formation des ressources humaines. Les spécialistes répondant à ces critères sont actuellement rares sur le marché du travail et sont très recherchés.
Concernant les compétences
En théorie, toutes les tâches MLOps peuvent être résolues avec des outils classiques de DevOps sans recourir à une extension spécialisée du modèle de rôle. Comme nous l'avons déjà mentionné, le data scientist doit être non seulement un mathématicien et un spécialiste de l'analyse des données, mais aussi un gourou de l'ensemble du pipeline - il est responsable de la conception de l'architecture, de la programmation des modèles dans plusieurs langages en fonction de l'architecture, de la préparation de la vitrine des données et du déploiement de l'application elle-même. Cependant, la création d'une infrastructure technologique mise en œuvre dans le processus continu de MLOps représente jusqu'à 80 % de la charge de travail, ce qui signifie qu'un mathématicien qualifié, qui est un bon Data Scientist, ne consacrera que 20 % de son temps à sa spécialité. Par conséquent, la délimitation des rôles des spécialistes impliqués dans le processus d'intégration des modèles d'apprentissage automatique devient une nécessité vitale.
La façon dont les rôles doivent être clairement définis dépend de l'échelle de l'entreprise. D'un côté, dans une startup, un seul spécialiste, multitâche et polyvalent, peut agir à la fois comme ingénieur, architecte et DevOps. D'un autre côté, dans une grande entreprise, tous les processus de développement de modèles sont concentrés entre les mains de quelques spécialistes de Data Science de haut niveau, tandis qu'un programmeur ou un spécialiste des bases de données, qui est une compétence plus commune et moins coûteuse sur le marché du travail, peut assumer une grande partie des tâches routinières.
Ainsi, la limite entre le choix des spécialistes pour assurer le processus MLOps et la façon dont le processus opérationnel des modèles développés est organisé dépend directement de la vitesse et de la qualité des modèles développés, de la productivité de l'équipe et du climat de travail au sein de celle-ci.
Ce que notre équipe a déjà accompli
Nous avons récemment commencé à construire la structure des compétences et les processus MLOps. Mais déjà à ce stade, nos projets de gestion du cycle de vie des modèles et d'application des modèles en tant que service sont en phase de test pour un produit minimum viable (MVP).
Nous avons également défini la structure de compétences optimale et l'organisation de l'interaction entre tous les participants au processus pour une grande entreprise. Des équipes Agile ont été mises en place, résolvant des problèmes pour l'ensemble du spectre des clients commerciaux, et un processus d'interaction avec les équipes de projet a été établi pour la création de plateformes et d'infrastructures, qui constituent la base de la construction de MLOps.
Questions pour l'avenir
MLOps est un domaine en développement, qui souffre d'un manque de compétences et qui prendra de l'ampleur à l'avenir. Pour l'instant, il est préférable de s'appuyer sur les acquis et pratiques de DevOps. L'objectif principal de MLOps est d'utiliser plus efficacement les modèles de ML pour résoudre des problèmes commerciaux. Cependant, de nombreuses questions se posent :
- Comment réduire le temps de mise en production des modèles ?
- Comment réduire les frictions bureaucratiques entre les équipes de différentes compétences et améliorer la collaboration ?
- Comment suivre les modèles, gérer les versions et organiser un suivi efficace ?
- Comment créer un véritable cycle de vie cyclique pour un modèle de ML moderne ?
- Comment standardiser le processus d'apprentissage automatique ?
Les réponses à ces questions détermineront en grande partie la vitesse à laquelle MLOps réalisera son potentiel complet.
Source : habr.com
