

Dans cet article, je vais aborder une situation qui s'est récemment produite avec l'un de nos serveurs cloud VPS, me mettant dans une impasse pendant plusieurs heures. Je configure et dépanne des serveurs Linux depuis environ 15 ans, mais ce cas ne correspondait pas du tout à ma pratique : j'ai fait plusieurs suppositions erronées et j'ai légèrement désespéré avant de pouvoir identifier correctement la cause du problème et la résoudre.
Préambule
Nous exploitons un cloud de taille moyenne, construit sur des serveurs standard avec la configuration suivante : 32 cœurs, 256 Go de RAM et un disque NVMe PCI-E Intel P4500 de 4 To. Nous aimons beaucoup cette configuration, car elle nous permet de ne pas nous soucier de l'insuffisance des IO, assurant une limitation correcte au niveau des types d'instances VM. Étant donné que le NVMe Intel présente des performances impressionnantes, nous pouvons garantir à la fois un provisionnement complet des IOPS pour les machines et la sauvegarde du stockage sur le serveur de sauvegarde sans attente d'E/S.
Nous faisons partie de ces anciens qui n'utilisent pas les SDN hyper-convergents et autres trucs branchés pour le stockage des volumes VM, pensant que plus le système est simple, plus il est facile de le dépanner dans des conditions où le "gourou principal est parti à la montagne". En fin de compte, nous stockons les volumes VM au format QCOW2 sur XFS ou EXT4, qui est déployé sur LVM2.
L'utilisation de QCOW2 est également imposée par le produit que nous utilisons pour l'orchestration : Apache CloudStack.
Pour effectuer les sauvegardes, nous prenons une image complète du volume, comme un instantané LVM2 (oui, nous savons que les instantanés LVM2 sont lents, mais l'Intel P4500 nous sauve ici aussi). Nous faisons lvmcreate -s .. et grâce à dd nous envoyons la sauvegarde sur un serveur distant avec stockage ZFS. Ici, nous sommes tout de même légèrement progressistes — ZFS sait stocker des données de manière compressée, et nous pouvons les récupérer rapidement grâce à DD ou extraire des volumes VM individuels avec mount -o loop ....
Bien sûr, il est également possible de prendre une image non complète du volume LVM2, en montant le système de fichiers en mode
ROet nous copions les images QCOW2, cependant, nous avons rencontré des problèmes avec XFS qui devenait instable, non pas immédiatement mais de manière imprévisible. Nous n’aimons pas du tout lorsque les hyperviseurs « bloquent » soudainement pendant le week-end, la nuit ou les jours fériés à cause d'erreurs dont l’apparition est imprévisible. Par conséquent, pour XFS, nous n'utilisons pas le montage de snapshots en modeROpour l'extraction des volumes, mais nous copions simplement l'intégralité du volume LVM2.
La vitesse de sauvegarde sur le serveur de sauvegarde est déterminée dans notre cas par la performance du serveur de sauvegarde, qui est d'environ 600-800 Mo/s pour des données non compressibles, étant donné que le canal 10Gbit/s est la prochaine limite, auquel le serveur de sauvegarde est connecté au cluster.
Ainsi, un serveur de sauvegarde reçoit les sauvegardes de 8 serveurs hyperviseurs simultanément. Par conséquent, les sous-systèmes de disque et réseau du serveur de sauvegarde, étant plus lents, ne surchargent pas les sous-systèmes de disque des hôtes hyperviseurs, car ils ne peuvent tout simplement pas traiter, disons, 8 Go/s, que les hôtes hyperviseurs peuvent fournir facilement.
Le processus de copie décrit ci-dessus est très important pour le récit suivant, y compris les détails - l'utilisation du disque rapide Intel P4500, l'utilisation de NFS et probablement l'utilisation de ZFS.
Histoire de la sauvegarde
Sur chaque nœud hyperviseur, nous avons une petite partition SWAP de 8 Go, et le nœud hyperviseur lui-même est « déployé » à partir de DD l'image de référence. Pour le volume système sur les serveurs, nous utilisons 2xSATA SSD RAID1 ou 2xSAS HDD RAID1 sur un contrôleur matériel LSI ou HP. En gros, nous nous moquons de ce qui se trouve à l’intérieur, car le volume système fonctionne en mode « presque readonly », sauf pour le SWAP. Et comme nous avons beaucoup de RAM sur le serveur et qu'elle est libre à 30-40%, nous ne pensons pas au SWAP.
Processus de création de sauvegarde. La tâche ressemble à cela :
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Veuillez noter que ionice -c3, en fait, ce truc est complètement inutile pour les appareils NVMe, car le planificateur IO pour eux est configuré comme suit :
cat /sys/block/nvme0n1/queue/scheduler
[none]
Cependant, nous avons une série de nœuds legacy avec des RAID SSD classiques, pour lesquels cela est pertinent, donc cela est transféré AS IS. En général, c'est juste un morceau de code intéressant qui explique l'inutilité de ionice dans ce type de configuration.
Notez le drapeau iflag=direct pour DD. Nous utilisons le direct IO hors du cache tampon pour éviter de faire des remplacements de tampon IO inutiles lors de la lecture. Cependant, oflag=direct nous ne le faisons pas car nous avons rencontré des problèmes de performance avec ZFS lors de son utilisation.
Ce schéma a été utilisé avec succès par nous pendant plusieurs années sans problèmes.
Et c'est là que ça a commencé… Nous avons découvert qu'une de nos nœuds n’effectuait plus de sauvegarde, tandis que la précédente avait été réalisée avec un IOWAIT monstrueux atteignant 50%. En essayant de comprendre pourquoi la sauvegarde n'était pas effectuée, nous sommes tombés sur le phénomène :
Groupe de volumes "images" non trouvéNous avons commencé à penser que "la fin était arrivée pour l’Intel P4500", cependant, avant d'éteindre le serveur pour remplacer le disque, il fallait tout de même réaliser la sauvegarde. Nous avons réparé LVM2 en restaurant les métadonnées depuis la sauvegarde LVM2 :
vgcfgrestore imagesNous avons lancé la sauvegarde et avons vu ce tableau :
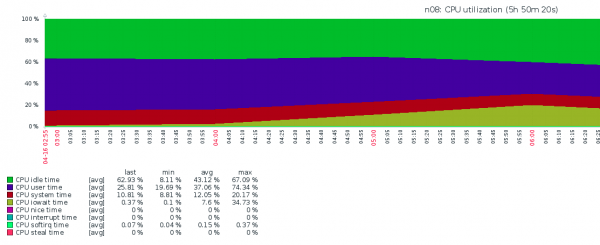
Encore une fois très tristes — il était clair que nous ne pouvions pas continuer ainsi, car tous les VPS seraient affectés, ce qui signifierait que nous souffririons aussi. Ce qui se passait était totalement incompréhensible — iostat montrait des IOPS pitoyables et un IOWAIT très élevé. L'idée, à part "remplacer le NVMe", n'était pas évidente, mais une illumination est arrivée à temps.
Analyse de la situation étape par étape
Journal historique. Quelques jours auparavant, il avait été nécessaire de créer un grand VPS sur ce serveur avec 128 Go de RAM. Il y avait apparemment suffisamment de mémoire, mais par précaution, nous avons alloué encore 32 Go pour la partition d'échange. Le VPS a été créé, a résolu son problème avec succès et l'incident a été oublié, mais la partition SWAP est restée.
Caractéristiques de configuration. Pour tous les serveurs du cloud, le paramètre vm.swappiness avait été défini sur la valeur par défaut 60. Et le SWAP a été créé sur un RAID1 HDD SAS.
Ce qui se passait (selon la rédaction). Lors de la sauvegarde DD de nombreuses données étaient écrites dans des tampons RAM avant d'être enregistrées dans le NFS. Le noyau du système, suivant la politique swappiness, déplaçait de nombreuses pages de mémoire VPS vers la zone d'échange, qui se trouvait sur le volume lent HDD RAID1. Cela faisait croître fortement l'IOWAIT, non pas en raison de l'IO NVMe, mais à cause de l'IO HDD RAID1.
Comment le problème a été résolu. La partition d'échange de 32 Go a été désactivée. Cela a pris 16 heures, sur la manière et le pourquoi du fonctionnement lent de la désactivation du SWAP, vous pouvez lire séparément. Les paramètres ont été modifiés swappiness à une valeur égale à 5 dans tout le cloud.
Comment cela aurait-il pu arriver. Tout d’abord, si le SWAP avait été sur un appareil SSD RAID ou NVMe, deuxièmement, s’il n’y avait pas eu d’appareil NVMe, mais un appareil plus lent qui n’aurait pas pu fournir un tel volume de données - par ironie, le problème est survenu parce que le NVMe est trop rapide.
Après cela, tout a recommencé à fonctionner comme auparavant - avec un IOWAIT nul.
Source : habr.com
