

Je veux partager avec vous ma première expérience réussie de restauration de la pleine fonctionnalité de la base de données Postgres. J'ai découvert le SGBD Postgres il y a six mois, avant cela je n'avais aucune expérience en administration de bases de données.
Je travaille en tant qu'ingénieur semi-DevOps dans une grande entreprise informatique. Notre société développe des logiciels pour des services à forte charge, et je suis responsable du bon fonctionnement, de la maintenance et du déploiement. On m'a donné une tâche classique : mettre à jour une application sur un serveur. L'application est écrite en Django, et lors de la mise à jour, des migrations (changement de la structure de la base de données) sont effectuées, et avant ce processus, nous réalisons une sauvegarde complète de la base de données via le programme standard pg_dump, juste au cas où.
Lors de la réalisation de la sauvegarde, une erreur imprévue est survenue (version Postgres – 9.5) :
pg_dump : L'extraction du contenu de la table “ws_log_smevlog” a échoué : PQgetResult() a échoué. pg_dump : Message d'erreur du serveur : ERREUR : page invalide dans le bloc 4123007 de la relation base/16490/21396989 pg_dump : La commande était : COPY public.ws_log_smevlog [...] pg_dump : [architecture parallèle] Un processus de travail s'est arrêté de manière inattendue. Erreur “page invalide dans le bloc” indique des problèmes au niveau du système de fichiers, ce qui est très mauvais. Divers forums ont suggéré de faire FULL VACUUM avec l'option zero_damaged_pages pour résoudre ce problème. Eh bien, essayons...
Préparation à la restauration
ATTENTION ! Assurez-vous de faire une sauvegarde de Postgres avant toute tentative de restauration de la base de données. Si vous avez une machine virtuelle, arrêtez la base de données et effectuez un snapshot. Si vous ne pouvez pas faire de snapshot, arrêtez la base et copiez le contenu du répertoire Postgres (y compris les fichiers wal) dans un endroit sûr. L'essentiel dans notre affaire est de ne pas aggraver les choses. Lisez .
Comme ma base fonctionnait globalement, je me suis limité à une sauvegarde classique de la base de données, mais j'ai exclu la table contenant des données corrompues (option -T, —exclude-table=TABLE dans pg_dump).
Le serveur était physique, il était impossible de faire un snapshot. La sauvegarde a été réalisée, passons à la suite.
Vérification du système de fichiers
Avant de tenter de restaurer la base de données, il est nécessaire de s'assurer que tout va bien au niveau du système de fichiers. En cas d'erreurs, il faut les corriger, car sinon, cela ne fera qu'aggraver les choses.
Dans mon cas, le système de fichiers de la base de données était monté dans «/srv» et le type était ext4.
Nous arrêtons la base de données : systemctl stop postgresql@9.5-main.service et nous vérifions que le système de fichiers n'est utilisé par personne et qu'il peut être démonté avec la commande lsof:
lsof +D /srv
J'ai également dû arrêter la base de données redis, car elle l'utilisait aussi «/srv». Ensuite, j'ai démonté /srv (umount).
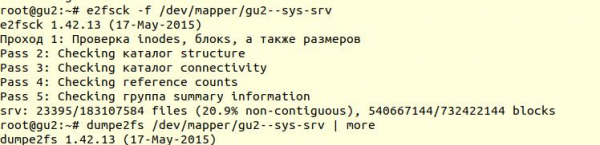
La vérification du système de fichiers a été effectuée à l'aide de l'utilitaire e2fsck avec l'option -f (Forcer la vérification même si le système de fichiers est marqué comme propre):
Ensuite, à l'aide de l'utilitaire dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) on peut s'assurer que la vérification a effectivement été effectuée :
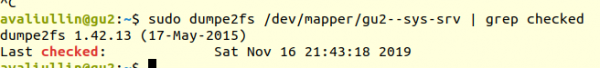
e2fsck indique qu'aucun problème au niveau du système de fichiers ext4 n'a été trouvé, ce qui signifie que nous pouvons continuer à essayer de restaurer la base de données, plus précisément revenir à vacuum full (bien sûr, il est nécessaire de remonter le système de fichiers et de relancer la base de données).
Si vous avez un serveur physique, vérifiez l'état des disques (via smartctl -a /dev/XXX) ou du contrôleur RAID, pour vous assurer que le problème n'est pas au niveau matériel. Dans mon cas, le RAID était "matériel", donc j'ai demandé au responsable local de vérifier l'état du RAID (le serveur était à plusieurs centaines de kilomètres de moi). Il a dit qu'il n'y avait pas d'erreurs, ce qui signifie que nous pouvons certainement commencer la restauration.
Essai 1 : zero_damaged_pages
Nous nous connectons à la base via psql avec un compte possédant des droits de superutilisateur. Nous avons justement besoin d'un superutilisateur, car l'option zero_damaged_pages ne peut être changée que par lui. Dans mon cas, c'est postgres :
psql -h 127.0.0.1 -U postgres -s [database_name]
L'option zero_damaged_pages est nécessaire pour ignorer les erreurs de lecture (du site postgrespro) :
En cas de découverte d'un en-tête de page corrompu, Postgres Pro signale généralement une erreur et interrompt la transaction en cours. Si le paramètre zero_damaged_pages est activé, le système émet un avertissement à la place, remet la page endommagée à zéro en mémoire et continue le traitement. Ce comportement détruit les données, à savoir toutes les lignes de la page corrompue.
Nous activons l'option et essayons de faire un full vacuum de la table :
VACUUM FULL VERBOSE 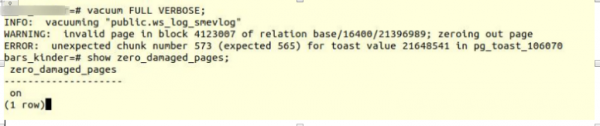
Malheureusement, échec.
Nous avons rencontré une erreur similaire :
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mécanisme de stockage des "longs données" dans Postgres, s'ils ne peuvent pas tenir dans une page (par défaut 8 Ko).
Essai 2 : reindex
Le premier conseil de Google n'a pas aidé. Après quelques minutes de recherche, j'ai trouvé un deuxième conseil – faire un reindex table endommagée. J'ai rencontré ce conseil à plusieurs endroits, mais il n'était pas très convaincant. Faisons un reindex :
reindex table ws_log_smevlog 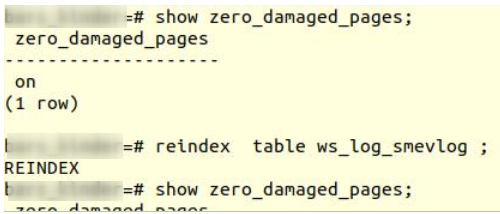
reindex s'est terminé sans problèmes.
Cependant, cela n'a pas aidé, VACUUM FULL il s'est terminé de manière inattendue avec une erreur similaire. Comme j'étais habitué à des échecs, j'ai commencé à chercher des conseils en ligne et je suis tombé sur une information assez intéressante. .
Tentative 3 : SELECT, LIMIT, OFFSET
Dans l'article ci-dessus, il était suggéré d'examiner la table ligne par ligne et de supprimer les données problématiques. Pour commencer, il fallait passer en revue toutes les lignes :
for ((i=0; i/dev/null || echo $i; doneDans mon cas, la table contenait 1 628 991 lignes ! Il aurait été préférable de s'occuper de , mais c'est un sujet pour une discussion séparée. C'était samedi, j'ai lancé cette commande dans tmux et je suis allé dormir :
for ((i=0; i/dev/null || echo $i; doneAu matin, j'ai décidé de vérifier comment ça se passait. À ma grande surprise, j'ai découvert qu'après 20 heures, seulement 2 % des données avaient été scannées ! J'avais pas envie d'attendre 50 jours. Un nouvel échec complet.
Mais je ne me suis pas laissé abattre. J'ai commencé à me demander pourquoi le scan durait si longtemps. D'après la documentation (encore sur postgrespro), j'ai appris :
OFFSET indique le nombre de lignes à ignorer avant de commencer à rendre les lignes.
Si OFFSET et LIMIT sont spécifiés, le système commence d'abord par ignorer les lignes OFFSET, puis commence à compter les lignes pour la limite LIMIT.Il est important d'utiliser LIMIT avec la clause ORDER BY pour que les lignes de résultat soient rendues dans un ordre déterminé. Sinon, des sous-ensembles imprévisibles de lignes peuvent être retournés.
Il est clair que la commande écrite ci-dessus était erronée : d'abord, il n'y avait pas de order by, le résultat pouvait donc être erroné. Deuxièmement, Postgres aurait d'abord dû scanner et ignorer les lignes OFFSET, et cela avec l'augmentation, OFFSET la performance diminuerait encore davantage.
Tentative 4 : faire un dump en texte brut
Par la suite, j'ai eu l'idée, qui semblait géniale, de faire un dump en texte brut et d'analyser la dernière ligne enregistrée.
Mais d'abord, examinons la structure de la table ws_log_smevlog:
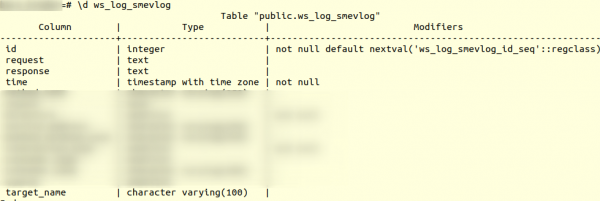
Dans notre cas, nous avons une colonne « id », qui contenait un identifiant unique (compteur) de la ligne. Le plan était le suivant :
- Commençons par faire un dump en texte brut (sous forme de commandes SQL)
- À un certain moment, le processus de sauvegarde a été interrompu en raison d'une erreur, mais le fichier texte aurait tout de même été sauvé sur le disque.
- En examinant la fin du fichier texte, nous trouvons l'identifiant (id) de la dernière ligne qui a été sauvegardée avec succès.
J'ai commencé à effectuer une sauvegarde sous forme de texte :
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpComme prévu, la sauvegarde s'est interrompue avec la même erreur :
pg_dump : Message d'erreur du serveur : ERREUR : page invalide dans le bloc 4123007 de la base de données /16490/21396989. Ensuite, à travers tail j'ai examiné la fin de la sauvegarde (tail -5 ./my_dump.dump) et j'ai découvert que la sauvegarde s'était arrêtée à la ligne avec l'id 186 525. « Donc, le problème vient de la ligne avec l'id 186 526, elle est corrompue, il faut l'effacer ! » – pensais-je. Mais, après avoir fait une requête dans la base de données :
«select * from ws_log_smevlog where id=186529» il s'est avéré que cette ligne était en parfait état… Les lignes avec les indices 186 530 – 186 540 fonctionnaient aussi sans problème. Une autre « idée géniale » avait échoué. Plus tard, j'ai compris pourquoi cela s'était produit : lors de la suppression ou de la modification des données d'une table, celles-ci ne sont pas physiquement supprimées, mais marquées comme des « tuples morts », ensuite, un processus l'autovacuum les marque comme supprimées et permet de les réutiliser. Pour comprendre, si les données dans la table changent et que l'autovacuum est activé, alors elles ne sont pas stockées de manière consécutive.
Tentative 5 : SELECT, FROM, WHERE id=
Les échecs nous rendent plus forts. Il ne faut jamais abandonner, il faut aller jusqu'au bout et croire en soi et en ses capacités. C'est pourquoi j'ai décidé d'essayer une autre option : simplement examiner tous les enregistrements de la base de données un par un. Connaissant la structure de ma table (voir ci-dessus), nous avons un champ id, qui est unique (clé primaire). Il y a 1 628 991 lignes dans la table et id elles sont ordonnées, ce qui signifie que nous pouvons simplement les parcourir une par une :
for ((i=1; i/dev/null || echo $i; donePour ceux qui ne comprennent pas, la commande fonctionne comme suit : elle examine les lignes de la table et envoie la sortie standard à /dev/null, mais si la commande SELECT échoue, le texte de l'erreur s'affiche (la sortie d'erreur standard est envoyée à la console) et la ligne contenant l'erreur est affichée (grâce à ||, qui signifie qu'il y a eu un problème avec le select (le code de retour de la commande n'est pas 0)).
J'ai eu de la chance, j'avais des indices créés sur le champ id:
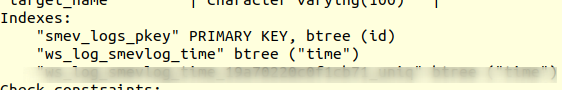
Et cela signifie que trouver la ligne avec l'id nécessaire ne devrait pas prendre beaucoup de temps. En théorie, cela devrait fonctionner. Eh bien, lançons la commande. tmux et nous allons nous coucher.
Le matin, j'ai découvert qu'environ 90 000 enregistrements avaient été consultés, ce qui représente un peu plus de 5 %. Un excellent résultat par rapport à la méthode précédente (2 %) ! Mais attendre 20 jours n'était pas ce que je voulais…
Tentative 6 : SELECT, FROM, WHERE id >= and id <
Un excellent serveur a été attribué au client pour la base de données : un serveur à double processeur Intel Xeon E5-2697 v2, avec pas moins de 48 threads disponibles ! La charge du serveur était moyenne, nous pouvions récupérer environ 20 threads sans problèmes majeurs. La mémoire vive était également suffisante : pas moins de 384 gigaoctets !
Il fallait donc paralléliser l'équipe :
for ((i=1; i/dev/null || echo $i; doneOn pouvait écrire un script beau et élégant, mais j'ai choisi la méthode de parallélisation la plus rapide : diviser manuellement la plage 0-1628991 en intervalles de 100 000 enregistrements et lancer séparément 16 commandes du type :
for ((i=N; i/dev/null || echo $i; doneMais ce n'est pas tout. En théorie, la connexion à la base de données prend également du temps et utilise des ressources système. Connexion à 1 628 991 ne serait pas très raisonnable, n'est-ce pas ? Alors, extrayons 1000 lignes par connexion au lieu d'une seule. Au final, la commande s'est transformée en ceci :
for ((i=N; i=$i and id/dev/null || echo $i; doneNous ouvrons 16 fenêtres dans une session tmux et exécutons les commandes :
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Après un jour, j'ai reçu les premiers résultats ! À savoir (les valeurs XXX et ZZZ ne sont déjà plus disponibles) :
ERREUR : numéro de morceau manquant 0 pour la valeur toast 37837571 dans pg_toast_106070
829000
ERREUR : numéro de morceau manquant 0 pour la valeur toast XXX dans pg_toast_106070
829000
ERREUR : numéro de morceau manquant 0 pour la valeur toast ZZZ dans pg_toast_106070
146000
Cela signifie que nous avons trois lignes contenant une erreur. L'identifiant du premier et du deuxième enregistrement problématique se situait entre 829 000 et 830 000, l'identifiant du troisième – entre 146 000 et 147 000. Ensuite, il ne nous restait plus qu'à trouver la valeur exacte de l'identifiant des enregistrements problématiques. Pour cela, nous parcourons notre plage avec des enregistrements problématiques par pas de 1 et identifions les identifiants :
for ((i=829000; i<830000; i=$((i+1)) )); do psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i<147000; i=$((i+1)) )); do psql -U my_user -d my_database -c "SELECT * FROM ws_log_smevlog where id=$i" >\/dev\/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Une fin heureuse
Nous avons trouvé des lignes problématiques. Nous accédons à la base via psql et essayons de les supprimer :
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
À ma grande surprise, les entrées ont été supprimées sans aucun problème même sans option zero_damaged_pages.
Ensuite, je me suis connecté à la base, j'ai fait VACUUM FULL (je pense que ce n'était pas nécessaire), et enfin, j'ai réussi à faire une sauvegarde avec pg_dump. La sauvegarde a été effectuée sans aucune erreur ! Le problème a été résolu de cette manière toute simple. La joie était immense, après tant d'échecs, j'ai pu trouver une solution !
Remerciements et conclusion
Voici ce qu'a été ma première expérience de récupération d'une vraie base de données Postgres. Je me souviendrai longtemps de cette expérience.
Et enfin, je voudrais remercier l'entreprise PostgresPro pour la documentation traduite en russe et pour , qui m'ont beaucoup aidé lors de l'analyse du problème.
Source : habr.com
