

Examinons le concept de surveillance de Kubernetes, découvrons l'outil Prometheus et parlons d'alerte.
Le sujet de la surveillance est vaste, il ne peut pas être entièrement couvert en un seul article. L'objectif de ce texte est de fournir un aperçu des outils, des concepts et des approches.
Le contenu de l'article est un extrait de . Si vous souhaitez suivre une formation complète, inscrivez-vous au cours sur .
Que surveille-t-on dans un cluster Kubernetes
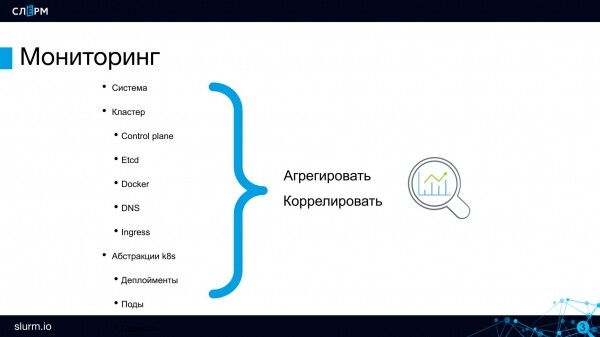
Serveurs physiques. Si le cluster Kubernetes est déployé sur vos propres serveurs, il est important de surveiller leur état. Pour cela, Zabbix s'en charge ; si vous travaillez avec, il n'y aura pas de conflit. C'est bel et bien Zabbix qui surveille l'état de nos serveurs.
Passons à la surveillance au niveau du cluster.
Composants du Control Plane : API, Scheduler et autres. Au minimum, il faut s'assurer que le nombre de serveurs API ou d'etcd est supérieur à 0. Etcd est capable de fournir de nombreuses métriques : sur les disques sur lesquels il fonctionne, sur la santé de son propre cluster etcd et d'autres.
Docker est apparu depuis longtemps et tout le monde connaît ses problèmes : de nombreux conteneurs provoquent des blocages et d'autres soucis. Par conséquent, il est également important de surveiller Docker en tant que système, ne serait-ce que pour sa disponibilité.
DNS. Si DNS est défaillant dans le cluster, alors tout le service Discovery s'en trouve affecté, et les communications entre les pods cessent de fonctionner. Dans ma pratique, je n'ai pas rencontré ce type de problème, mais cela ne signifie pas qu'il ne faut pas surveiller l'état de DNS. Les délais de requêtes et certaines autres métriques peuvent être suivis sur CoreDNS.
Ingress. Il est nécessaire de surveiller la disponibilité des ingress (y compris de l'Ingress Controller) en tant que points d'entrée dans le projet.
Nous avons examiné les principaux composants du cluster, maintenant descendons à un niveau d'abstraction inférieur.
À première vue, les applications s'exécutent dans des pods, donc elles devraient être surveillées, mais en réalité, ce n'est pas le cas. Les pods sont éphémères : aujourd'hui, ils fonctionnent sur un serveur, demain sur un autre ; aujourd'hui, il y en a 10, demain 2. Par conséquent, personne ne surveille simplement les pods. Dans le cadre d'une architecture de microservices, il est plus important de surveiller la disponibilité de l'application dans son ensemble. En particulier, vérifier la disponibilité des endpoints du service : quelque chose fonctionne-t-il ? Si l'application est disponible, que se passe-t-il derrière, combien de répliques y a-t-il en ce moment — ce sont des questions secondaires. Il n'est pas nécessaire de suivre les instances individuelles.
Au dernier niveau, il est essentiel de contrôler le fonctionnement de l'application elle-même, de relever les métriques business : le nombre de commandes, le comportement des utilisateurs, et d'autres aspects.
Prometheus
Le meilleur système pour surveiller un cluster est . Je ne connais aucun outil qui puisse rivaliser avec Prometheus en termes de qualité et de facilité d'utilisation. Il est parfaitement adapté aux infrastructures flexibles, c'est pourquoi lorsqu'on parle de « surveillance de Kubernetes », on fait généralement référence à Prometheus.
Il existe plusieurs options pour commencer à travailler avec Prometheus : on peut installer le Prometheus standard ou le Prometheus Operator avec Helm.
- Prometheus standard. Il fonctionne bien, mais il faut configurer le ConfigMap — en gros, rédiger des fichiers de configuration texte, comme nous le faisions auparavant avant l'architecture microservices.
- Le Prometheus Operator est un peu plus complexe, ayant une logique interne plus étendue, mais il est plus facile à utiliser : il y a des objets distincts, des abstractions qui s'ajoutent au cluster, ce qui facilite leur contrôle et leur configuration.
Pour comprendre le produit, je recommande d'abord d'installer le Prometheus standard. Il faudra tout configurer via le fichier de configuration, mais cela sera bénéfique : vous comprendrez à quoi chaque élément se rapporte et comment le configurer. Avec le Prometheus Operator, vous commencez immédiatement à un niveau d'abstraction supérieur, bien qu'il soit aussi possible d'explorer les profondeurs si vous le désirez.
Prometheus est bien intégré à Kubernetes : il peut interroger l'API Server et interagir avec lui.
Prometheus est populaire, c'est pourquoi un grand nombre d'applications et de langages de programmation le prennent en charge. Ce support est nécessaire, car Prometheus utilise son propre format de métriques, et pour le transmettre, il faut soit une bibliothèque intégrée dans l'application, soit un exportateur prêt à l'emploi. Il existe de nombreux exportateurs à cet égard. Par exemple, il y a le PostgreSQL Exporter : il extrait des données de PostgreSQL et les convertit au format Prometheus, permettant ainsi à Prometheus de les traiter.
L'architecture de Prometheus
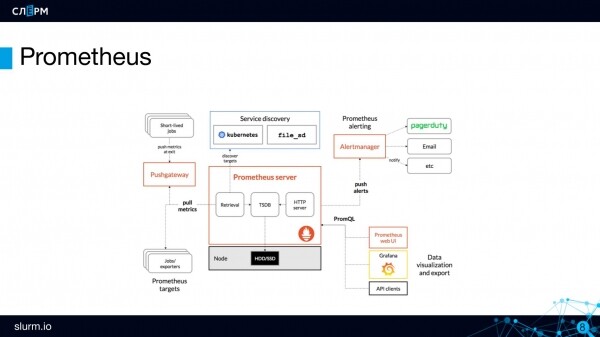
Serveur Prometheus — c'est la partie serveur, le cerveau de Prometheus. C'est ici que les métriques sont stockées et traitées.
Les métriques sont conservées dans une base de données de séries temporelles (TSDB). La TSDB n'est pas une base de données distincte, mais un paquet en Go qui est intégré dans Prometheus. Grosso modo, tout est contenu dans un seul binaire.
Ne conservez pas les données dans la TSDB trop longtemps.
L'infrastructure Prometheus n'est pas adaptée au stockage à long terme des métriques. Par défaut, la durée de stockage est de 15 jours. Il est possible de dépasser cette limitation, mais il faut garder à l'esprit que plus vous stockez de données dans la TSDB et plus longtemps vous le faites, plus elle consommera de ressources. Stocker des données historiques dans Prometheus est considéré comme une mauvaise pratique.
Si vous avez un trafic énorme, avec des centaines de milliers de métriques par seconde, il est préférable de limiter leur stockage en fonction de l'espace disque ou de la durée. En général, les « données chaudes » sont stockées dans la TSDB, c'est-à-dire des métriques datant de quelques heures seulement. Pour un stockage plus long, on utilise des stockages externes dans des bases de données qui conviennent vraiment à cet usage, comme InfluxDB, ClickHouse, etc. J'ai vu plus de bons retours sur ClickHouse.
Le serveur Prometheus fonctionne selon le modèle pull: il va chercher les métriques dans les points de terminaison que nous lui avons indiqués. On lui a dit : « va dans le serveur API », et il s'y rend toutes les n secondes pour récupérer les métriques.
Pour les objets ayant une courte durée de vie (job ou cron job), qui peuvent apparaître entre les périodes de scraping, il existe un composant appelé Pushgateway. Les métriques des objets à court terme sont envoyées au Pushgateway : un job démarre, exécute une action, envoie des métriques au Pushgateway, puis se termine. Au bout d'un certain temps, Prometheus ira chercher ces métriques dans le Pushgateway selon son rythme.
Pour configurer des notifications dans Prometheus, il existe un composant séparé — Alertmanager. Et les règles d'alerte — alerting rules. Par exemple, il peut être nécessaire de créer une alerte si le nombre de serveurs API est de 0. Lorsque l'événement se déclenche, l'alerte est transmise au gestionnaire d'alerte pour un envoi ultérieur. Dans le gestionnaire d'alerte, les paramètres de routage sont assez flexibles : un groupe d'alertes peut être envoyé dans un chat Telegram pour les administrateurs, un autre dans le chat des développeurs, et un troisième dans le chat des équipes infrastructure. Les notifications peuvent arriver sur Slack, Telegram, par email et dans d'autres canaux.
Enfin, je vais parler de la fonctionnalité phare de Prometheus — Discovering. Dans Prometheus, il n'est pas nécessaire d'indiquer des adresses spécifiques pour les objets à surveiller, il suffit de définir leur type. Autrement dit, il n'est pas nécessaire d'écrire « voici l'adresse IP, voici le port — surveillez », mais plutôt de déterminer selon quels principes trouver ces objets (cibles — cibles). Prometheus, en fonction des objets actuellement actifs, les tire et les ajoute à la surveillance.
Cette approche s'intègre bien dans la structure de Kubernetes, où tout est également fluide : aujourd'hui 10 serveurs, demain 3. Pour ne pas avoir à indiquer à chaque fois l'adresse IP du serveur, nous avons écrit une seule fois comment le trouver — et Discovering s'en occupera.
Le langage de Prometheus s'appelle PromQL. Avec ce langage, il est possible d'extraire des valeurs spécifiques de métriques et de les transformer pour en faire des analyses.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Requête simple

    container_memory_usage_bytes

Opérations mathématiques

    container_memory_usage_bytes / 1024 / 1024

Fonctions intégrées

    sum(container_memory_usage_bytes) / 1024 / 1024

Affinage de la requête

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Interface web de Prometheus
Prometheus a sa propre interface web, assez minimaliste. Elle est utile surtout pour le débogage ou la démonstration.
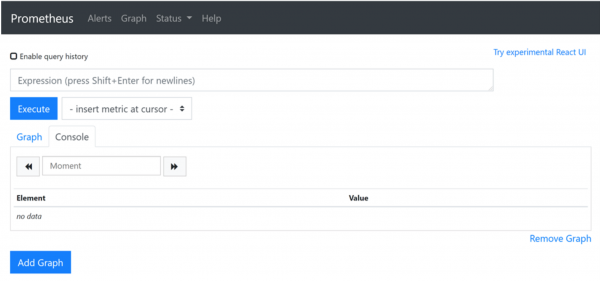
Dans la zone d'expression, vous pouvez écrire des requêtes en langage PromQL.
Dans l'onglet Alertes, vous trouverez des règles d'alerte — alerting rules, lesquelles ont trois statuts :
- inactive — si l'alerte n'est pas active pour le moment, c'est-à-dire que tout va bien et qu'elle ne s'est pas déclenchée ;
- pending — cela se produit lorsque l'alerte s'est déclenchée, mais que l'envoi n'a pas encore eu lieu. Un délai est fixé pour compenser les fluctuations du réseau : si un service donné est redémarré dans la minute, il n'est pas nécessaire d'alerter ;
- firing — c'est le troisième statut, lorsque l'alerte s'active et envoie des messages.
Dans le menu Statut, vous trouverez des informations sur ce qu'est Prometheus. Il y a aussi un accès aux cibles (targets) dont nous avons parlé précédemment.
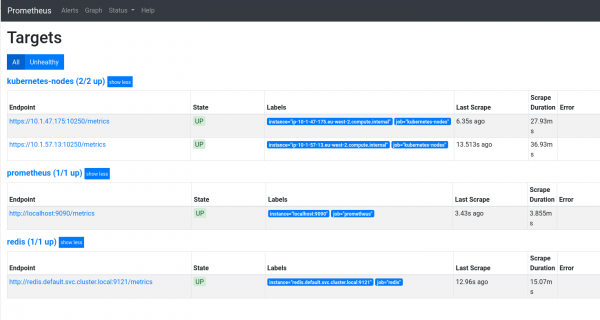
Pour un aperçu plus détaillé de l'interface de Prometheus, consultez .
Intégration avec Grafana
Dans l'interface web de Prometheus, vous ne trouverez pas de beaux et clairs graphiques permettant de tirer des conclusions sur l'état du cluster. Pour les créer, Prometheus s'intègre à Grafana. Cela produit des tableaux de bord comme ceux-ci.
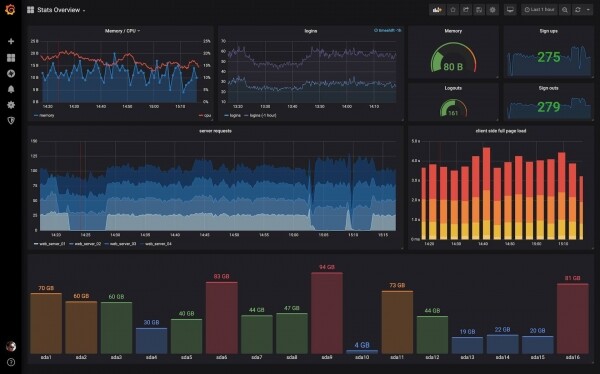
Configurer l'intégration entre Prometheus et Grafana est très simple, vous trouverez les instructions dans la documentation : , et je vais conclure ici.
Dans les articles suivants, nous continuerons sur le thème de la surveillance : nous parlerons de la collecte et de l'analyse des logs avec Grafana Loki et d'autres outils alternatifs.
Auteur : Marsel Ibraev, administrateur Kubernetes certifié, ingénieur pratiquant chez , conférencier et développeur des cours de Slurm.
Source : habr.com
