

Notre entreprise gère principalement l'infrastructure et le support technique 24/7 pour des projets web depuis 2008 : nous avons plus de 400 clients, ce qui représente environ 15 % du commerce électronique en Russie. Par conséquent, le support a une architecture très diverse. Si quelque chose tombe, nous devons le réparer dans les 15 minutes. Mais pour comprendre qu'une panne a eu lieu, il faut surveiller le projet et réagir aux incidents. Mais comment faire cela ?
Je pense qu'une mauvaise organisation du système de surveillance entraîne des problèmes. S'il n'y avait pas de problèmes, mon discours se résumerait à un seul point : « Installez, s'il vous plaît, Prometheus + Grafana et les plugins 1, 2, 3 ». Malheureusement, ce n'est plus suffisant. Et le principal problème est que tout le monde continue de croire en quelque chose qui existait en 2008, du point de vue des composants logiciels.
En ce qui concerne l'organisation du système de surveillance, je prends le risque de dire qu'il n'existe pas de projets avec une surveillance correcte. Et la situation est si mauvaise que si quelque chose tombe, il y a un risque que cela passe inaperçu — après tout, tout le monde est convaincu que « tout est surveillé ».
Peut-être que tout est surveillé. Mais comment ?
Nous avons tous été confrontés à une histoire comme celle-ci : un devops, un admin travaillent, une équipe de développeurs vient et dit : « Nous avons déployé, maintenant surveille-le ». Qu'est-ce qu'il faut surveiller ? Comment cela fonctionne ?
Ok. On fait la surveillance à l'ancienne. Mais cela change déjà, et il s'avère que vous surveillez le service A, qui est devenu le service B, qui interagit avec le service C. Mais l'équipe de développeurs vous dit : « Installez le logiciel, il doit tout surveiller ! »
Alors, qu'est-ce qui a changé ? — Tout a changé !
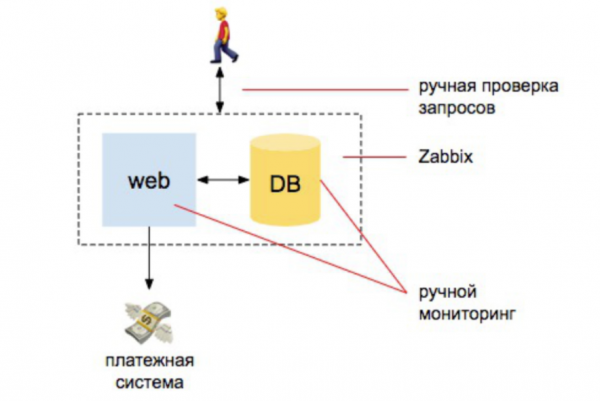
2008. Tout va bien
Il y a quelques développeurs, un serveur, un serveur DB. Tout commence ici. Nous avons certaines informations, nous installons zabbix, Nagios, cacti. Ensuite, nous établissons des alertes claires pour le CPU, pour le fonctionnement des disques, pour l'espace disque. Nous effectuons aussi quelques vérifications manuelles, pour voir si le site répond et si les commandes arrivent dans la base. Et voilà – nous sommes plus ou moins protégés.
Si l'on compare le volume de travail qu'un administrateur devait faire à l'époque pour assurer la surveillance, 98 % étaient automatisés : la personne chargée de la surveillance doit comprendre comment installer Zabbix, comment le configurer et paramétrer les alertes. Et 2 % concernent les vérifications externes : si le site répond et effectue des requêtes dans la base de données, si de nouvelles commandes sont arrivées.
L'année 2010. La charge augmente.
Nous commençons à faire évoluer nos sites web, ajoutons un moteur de recherche. Nous voulons nous assurer que le catalogue des produits contient tous les articles. Et que la recherche fonctionne. Que la base fonctionne, que les commandes sont passées, que le site répond à l'extérieur et répond de deux manières. serveurs Et l'utilisateur n'est pas éjecté du site pendant qu'il est rééquilibré sur un autre serveur, etc. Le nombre d'entités augmente.
De plus, l'entité liée à l'infrastructure reste toujours la plus importante dans l'esprit du gestionnaire. L'idée persiste que la personne chargée de la surveillance est celle qui installera Zabbix et sera capable de le configurer.
Mais en même temps, de nouveaux travaux apparaissent, tels que la réalisation de vérifications externes, la création d'un ensemble de scripts de requêtes pour l'indexation des recherches, un ensemble de scripts pour vérifier que la recherche évolue au cours de l'indexation, et un ensemble de scripts qui vérifient que les articles sont transmis au service de livraison, etc.
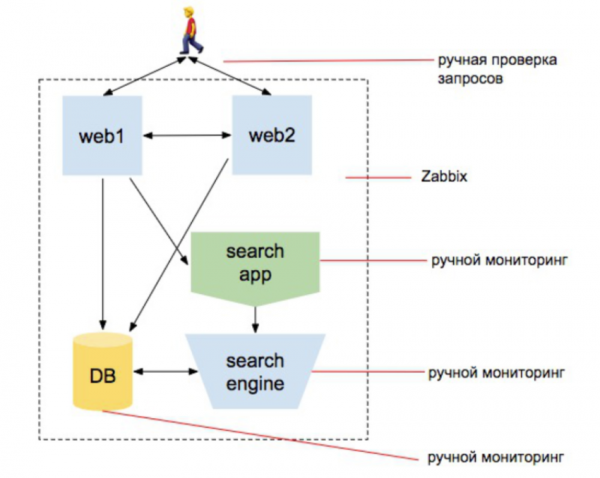
Remarquez : j'ai écrit « ensemble de scripts » trois fois. Cela signifie que la personne responsable de la surveillance n'est plus simplement celle qui installe Zabbix. C'est une personne qui commence à programmer. Mais, dans l'esprit de l'équipe, rien ne change encore.
En revanche, le monde change, se compliquant de plus en plus. Une couche de virtualisation et plusieurs nouveaux systèmes sont ajoutés. Ils commencent à interagir les uns avec les autres. Qui a dit « cela sent les microservices ? » Mais chaque service apparaît toujours comme un site distinct. Nous pouvons y accéder et comprendre qu'il fournit les informations nécessaires et fonctionne par lui-même. Et si vous êtes un administrateur, qui traite un projet qui évolue depuis 5, 7, 10 ans, ce savoir s'accumule : un nouveau niveau apparaît — vous l'avez saisi, un autre niveau apparaît — vous l'avez saisi...
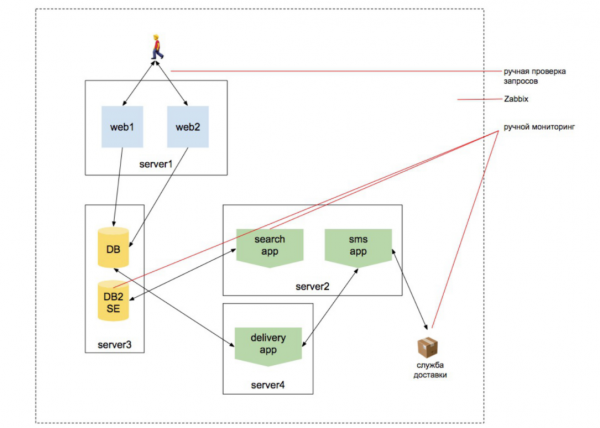
Mais il est rare que quelqu'un accompagne un projet pendant 10 ans.
Résumé du surveillant
Supposons que vous rejoigniez une nouvelle startup qui a immédiatement recruté 20 développeurs, écrit 15 microservices, et vous êtes l'administrateur à qui l'on dit : "Construisez CI/CD. S'il vous plaît." Vous avez construit CI/CD et tout à coup vous entendez : "Nous avons du mal à travailler avec la production dans le 'cube', sans comprendre comment l'application fonctionnera dedans. Créez-nous un bac à sable dans ce même 'cube'."
Vous créez un bac à sable dans ce cube. On vous dit tout de suite : "Nous voulons une base de données de stage, qui se met à jour tous les jours avec la production, pour comprendre que ça fonctionne sur cette base de données, sans pour autant endommager la base de données de production."
Vous vivez tout cela. Il reste 2 semaines avant la sortie, on vous dit : "Maintenant il faudrait tout surveiller..." C'est-à-dire surveiller l'infrastructure de cluster, surveiller l'architecture microservices, surveiller les interactions avec des services externes...
Et des collègues sortent de la tête un schéma habituel et disent : "Donc ici tout est clair ! Installe un programme qui surveillera tout ça." Oui, oui : Prometheus + Grafana + plugins.
Et ils ajoutent en même temps : "Tu as deux semaines, fais en sorte que tout soit fiable."
Dans la multitude de projets que nous voyons, on attribue une personne à la surveillance. Imaginez que nous voulons embaucher quelqu'un pour 2 semaines, pour s'occuper de la surveillance, et nous lui rédigeons un CV. Quelles compétences cette personne doit-elle avoir, en tenant compte de tout ce que nous avons dit précédemment ?
- Elle doit comprendre la surveillance et la spécificité de l'infrastructure matérielle.
- Elle doit comprendre la spécificité de la surveillance de Kubernetes (tout le monde veut aller dans le 'cube', car on peut s'abstraire de tout, se cacher, le reste, l'administrateur s'en occupera) — en soi, son infrastructure, et comprendre comment surveiller les applications à l'intérieur.
- Elle doit comprendre que les services communiquent de manières particulières et connaître les spécificités de l'interaction entre les services. Il est tout à fait possible de voir un projet où une partie des services communique de manière synchrone, car autrement ce n'est pas possible. Par exemple, le backend utilise REST, gRPC pour le service catalogue, récupère la liste des produits et renvoie la réponse. Ici, on ne peut pas attendre. Et avec d'autres services, il travaille de manière asynchrone. Passer une commande à un service de livraison, envoyer un e-mail, etc.
Vous, vous êtes probablement déjà perdu avec tout ça ? Mais l'administrateur qui doit le surveiller est encore plus perdu. - Il doit être capable de planifier et de planifier correctement, car le travail augmente de plus en plus.
- Il doit donc créer une stratégie à partir du service créé pour comprendre comment le surveiller concrètement. Il a besoin de comprendre l'architecture du projet et son développement, ainsi que les technologies utilisées dans le développement.
Rappelons un cas tout à fait normal : une partie des services est en php, une autre en Go, et une autre en JS. Ils fonctionnent ensemble d'une certaine manière. D'où le terme « microservice » : il y a tant de systèmes distincts que les développeurs ne peuvent pas comprendre le projet dans son ensemble. Une partie de l'équipe écrit des services en JS, qui fonctionnent de manière autonome et ne savent pas comment le reste du système fonctionne. Une autre partie écrit des services en Python et ne s'intéresse pas à la façon dont fonctionnent les autres services, ils sont isolés dans leur domaine. La troisième partie écrit des services en php ou dans d'autres langages.
Tous ces 20 personnes sont réparties sur 15 services, et il n'y a qu'un seul administrateur qui doit tout comprendre. Attendez ! Nous venons de diviser le système en 15 microservices, car 20 personnes ne peuvent pas comprendre l'ensemble du système.
Cependant, il faut trouver un moyen de le surveiller...
Quel est le résultat ? Au final, il y a une personne qui retient tout ce qu'une équipe entière de développeurs ne peut pas comprendre, et en plus, elle doit connaître et maîtriser ce que nous avons indiqué ci-dessus : l'infrastructure matérielle, l'infrastructure Kubernetes, etc.
Que dire... Houston, nous avons un problème.
La surveillance d'un projet logiciel moderne est en soi un projet logiciel.
Sous l'illusion que la surveillance est un logiciel, nous développons une foi en des miracles. Et malheureusement, il n'y a pas de miracles. On ne peut pas installer zabbix et s'attendre à ce que tout fonctionne. Il n'y a pas de sens à installer Grafana et espérer que tout ira bien. La plupart du temps sera consacré à l'organisation des vérifications du fonctionnement des services et de leur interaction, ainsi que des vérifications du fonctionnement des systèmes externes. En fait, 90 % du temps sera consacré à la création de logiciels et cela doit être fait par une équipe qui comprend le fonctionnement du projet.
Si dans cette situation, une seule personne est affectée à la surveillance, cela va mal tourner. Ce qui arrive malheureusement partout.
Par exemple, il existe plusieurs services qui communiquent entre eux via Kafka. Une commande arrive, nous envoyons le message de commande à Kafka. Il y a un service qui écoute les informations sur la commande et organise l'expédition des marchandises. Il y a un autre service qui écoute les informations sur la commande et envoie un e-mail à l'utilisateur. Puis d'autres services apparaissent, et nous commençons à nous embrouiller.
Et si vous confiez cela à un administrateur et aux développeurs à un moment où il reste peu de temps avant la sortie, la personne devra comprendre tout ce protocole. Autrement dit, un projet de cette ampleur prend un temps considérable, et cela doit être pris en compte dans le développement du système.
Mais très souvent, surtout dans les startups, nous voyons comment la surveillance est remise à plus tard. « Nous allons d'abord réaliser un Proof of Concept, le lancer, qu'il échoue – nous sommes prêts à faire des sacrifices. Et ensuite, nous ferons toute la surveillance ». Quand (ou si) le projet commence à rapporter de l'argent, l'entreprise souhaite ajouter encore plus de fonctionnalités — puisque ça commence à fonctionner, il faut aller plus loin ! Et vous vous retrouvez à un point où vous devez d'abord surveiller tout ce qui a précédé, ce qui prend non pas 1 % du temps, mais beaucoup plus. Et en passant, des développeurs seront nécessaires pour la surveillance, et il est plus facile de les affecter à de nouvelles fonctionnalités. En fin de compte, de nouvelles fonctionnalités sont écrites, tout se complique et vous vous trouvez en une boucle sans fin.
Alors, comment surveiller un projet depuis le début, et que faire si vous héritez d'un projet qui doit être surveillé et que vous ne savez pas par où commencer ?
Tout d'abord, il faut planifier.
Une parenthèse : très souvent, on commence par surveiller l'infrastructure. Par exemple, nous avons Kubernetes. Commençons par installer Prometheus avec Grafana, ajoutons des plugins pour surveiller le « cube ». Non seulement les développeurs, mais aussi les administrateurs ont la triste habitude suivante : « Nous allons installer ce plugin, et le plugin doit savoir comment le faire ». Les gens aiment commencer par des actions simples et compréhensibles, plutôt que par des actions importantes. Et la surveillance de l'infrastructure est simple.
Pour commencer, déterminez ce que vous souhaitez surveiller et comment, puis choisissez un outil, car d'autres personnes ne peuvent pas réfléchir à votre place. Et devraient-elles? D'autres personnes ont pensé à elles, à un système universel — ou n'ont tout simplement pas réfléchi lors de l'écriture de ce plugin. Et le fait que ce plugin ait 5000 utilisateurs ne signifie pas qu'il apporte une quelconque valeur. Il est possible que vous soyez le 5001ème simplement parce qu'il y avait déjà 5000 personnes avant vous.
Si vous avez commencé à surveiller l'infrastructure et que le backend de votre application a cessé de répondre, tous les utilisateurs perdront la connexion avec l'application mobile. Une petite erreur apparaîtra. On viendra vous dire : « L'application ne fonctionne pas, que faites-vous ? » — « Nous faisons de la surveillance. » — « Comment pouvez-vous surveiller si vous ne voyez même pas que l'application ne fonctionne pas ?! »
- Je pense qu'il est essentiel de commencer la surveillance à partir du point d'entrée de l'utilisateur. Si l'utilisateur ne voit pas que l'application fonctionne — c'est un échec. Et le système de surveillance doit alerter à ce sujet en premier lieu.
- Ce n'est qu'ensuite que nous pouvons surveiller l'infrastructure. Ou le faire en parallèle. Avec l'infrastructure, c'est plus simple — ici, nous pouvons enfin installer Zabbix.
- Et maintenant, il faut plonger dans les racines de l'application pour comprendre où ça ne fonctionne pas.
Ma principale idée est que la surveillance doit aller de pair avec le processus de développement. Si vous détournez l'équipe de surveillance vers d'autres tâches (création de CI/CD, bac à sable, réorganisation de l'infrastructure), la surveillance commencera à prendre du retard et vous ne serez peut-être jamais en mesure de rattraper le développement (ou il faudra tarde ou tôt l'arrêter).
Tout par niveaux
Voici comment je vois l'organisation du système de surveillance.
1) Niveau de l'application :
- surveiller la logique métier de l'application ;
- surveiller les métriques de santé des services ;
- surveillance d'intégration.
2) Niveau de l'infrastructure :
- surveillance du niveau d'orchestration ;
- surveillance des logiciels système ;
- surveillance du matériel.
3) Encore au niveau de l'application — mais déjà comme produit d'ingénierie :
- collecte et observation des journaux de l'application ;
- APM ;
- tracing.
4) Alerting :
- organisation du système de notifications ;
- organisation du système de gardes ;
- organisation de la « base de connaissances » et du flux de traitement des incidents.
Important: nous atteignons l'alerte immédiatement, pas après coup ! Il ne faut pas lancer la surveillance et « réfléchir plus tard » à qui recevra les alertes. Car l'objectif de la surveillance est de comprendre où quelque chose ne fonctionne pas dans le système et d'en informer les bonnes personnes. Si cela est laissé à la dernière minute, les personnes concernées n'apprendreont que lorsque « rien ne fonctionne chez nous ».
Niveau d'application — surveillance de la logique métier
Il s'agit ici de vérifier que l'application fonctionne pour l'utilisateur.
Ce niveau doit être mis en place au stade du développement. Par exemple, nous avons un Prometheus fictif : il accède au serveur qui réalise les vérifications, fait la demande à l'endpoint, et cet endpoint vérifie l'API.
Lorsque l'on demande souvent de surveiller la page d'accueil pour s'assurer que le site fonctionne, les développeurs donnent une requête qu'il est possible d'interroger chaque fois qu'il faut vérifier que l'API fonctionne. Pendant ce temps, les développeurs écrivent aussi /api/test/helloworld.
Le seul moyen de vérifier que tout fonctionne ? — Non !
- La création de telles vérifications est, en fait, la tâche des développeurs. Les tests unitaires doivent être écrits par les programmeurs qui codent. Parce que, si vous confiez cela à l'administrateur « Hé, voici la liste des protocoles API de toutes les 25 fonctions, s'il te plaît, surveille tout ! » — cela ne fonctionnera pas.
- Si vous faites print “hello world”, personne ne saura jamais que l'API doit fonctionner réellement. Chaque changement d'API doit être accompagné d'un changement des vérifications.
- Si vous êtes déjà dans cette situation — arrêtez les fonctionnalités et mobilisez les développeurs pour qu'ils écrivent ces vérifications, ou acceptez les pertes, acceptez que rien ne soit vérifié et que cela va échouer.
Conseils techniques :
- Organisez impérativement un serveur externe pour mettre en place des vérifications — vous devez être sûr que votre projet est accessible au monde extérieur.
- Organisez la vérification sur l'ensemble du protocole API, et non pas uniquement sur des endpoints séparés.
- Créez un endpoint prometheus avec les résultats des vérifications.
Niveau d'application — surveillance des métriques de santé
Il s'agit maintenant des métriques de santé externes des services.
Nous avons décidé que tous les « points de contrôle » de l'application seraient surveillés grâce à des vérifications externes que nous appelons depuis un système de monitoring externe. Mais ce sont précisément ces « points de contrôle » que l'utilisateur « voit ». Nous voulons nous assurer que nos services fonctionnent. Ici, l'histoire est un peu meilleure : dans K8s, il existe des checks de santé pour que, au moins, le « cube » s'assure que le service fonctionne. Mais la moitié des checks que j'ai vus, c'est le même print « hello world ». C'est-à-dire qu'il est déclenché une fois après le déploiement, il a reçu une réponse disant que tout va bien — et c'est tout. Or, pour un service qui expose son API via REST, il existe un grand nombre de points d'entrée de cette API qui doivent également être surveillés, car nous voulons savoir qu'il fonctionne. Et nous le surveillons déjà de l'intérieur.
Comment le mettre en œuvre correctement sur le plan technique : chaque service expose un endpoint sur son état de fonctionnement actuel, et dans les graphiques Grafana (ou toute autre application), nous voyons l'état de tous les services.
- Chaque modification de l'API doit entraîner une modification des vérifications.
- Créez un nouveau service avec des métriques de santé dès le départ.
- L'administrateur peut venir voir les développeurs et demander « ajoutez-moi quelques fonctionnalités pour que je comprenne tout et que j'ajoute ces informations à mon système de monitoring ». Mais les développeurs répondent généralement « Nous ne rajouterons rien deux semaines avant la sortie ».
Que les chefs de projet sachent qu'il y aura de telles pertes, que la direction des chefs de projet le sache aussi. Parce que, quand tout s'effondrera, quelqu'un appellera et exigera de surveiller le « service qui tombe constamment » (c) - Au fait, dédiez des développeurs à l'écriture de plugins pour Grafana — ce sera une bonne aide pour les administrateurs.
Niveau de l'application — Monitoring d'intégration
Le monitoring d'intégration se concentre sur la surveillance de la communication entre les systèmes critiques pour l'entreprise.
Par exemple, il y a 15 services qui communiquent entre eux. Ce ne sont plus des sites distincts. C'est-à-dire que nous ne pouvons pas juste interroger un service, obtenir /helloworld et comprendre que le service fonctionne. Parce que le service de commande doit envoyer des informations de commande au bus — et du bus, le service de gestion des stocks doit recevoir ce message et travailler avec. Et le service d'envoi d'e-mails doit traiter cela d'une certaine manière, etc.
Par conséquent, nous ne pouvons pas comprendre, en testant chaque service individuel, comment tout cela fonctionne. Car nous avons un certain bus par lequel tout communique et interagit.
Ainsi, cette étape doit représenter la phase de test des services en interaction avec d'autres services. Il n'est pas possible, en surveillant le courtier de messages, d'organiser la surveillance de la communication. S'il y a un service qui fournit des données et un autre qui les reçoit, en surveillant le courtier, nous ne verrons que les données qui circulent d'un côté à l'autre. Même si nous parvenons à surveiller l'interaction de ces données à l'intérieur — c'est-à-dire qu'un producteur publie des données, que quelqu'un les lit, que ce flux continue dans Kafka — cela ne nous donnera pas d'informations si un service a envoyé un message dans une version et qu'un autre service ne s'attendait pas à cette version et l'a ignoré. Nous ne le saurons pas, car les services nous diront que tout fonctionne.
Voici comment je recommande de procéder :
- Pour la communication synchrone : le point de terminaison effectue des requêtes aux services associés. C'est-à-dire que nous prenons ce point de terminaison, nous exécutons un petit script à l'intérieur du service, qui passe par tous les points et dit : « Je peux jeter un coup d'œil ici, et là, je peux jeter un coup d'œil… »
- Pour la communication asynchrone : les messages entrants — le point de terminaison vérifie le bus à la recherche de messages de test et fournit un statut de traitement.
- Pour la communication asynchrone : les messages sortants — le point de terminaison envoie des messages de test sur le bus.
Comme cela se passe généralement : nous avons un service qui envoie des données dans le bus. Nous allons dans ce service et demandons de nous parler de sa santé d'intégration. Et si le service doit produire un message quelque part (WebApp), il produit ce message de test. Et si nous sollicitons le service du côté de OrderProcessing, il publie d'abord ce qu'il peut publier indépendamment, et s'il y a des éléments dépendants — alors il lit sur le bus un ensemble de messages de test, comprend ce qu'il peut traiter, en informe et, si nécessaire, les publie plus loin, et à ce sujet, il dit — tout va bien, je suis vivant.
Nous entendons souvent la question : « comment pouvons-nous tester cela sur des données de production ? » Par exemple, il s'agit du même service de commandes. Une commande envoie des messages à l'entrepôt, où les produits sont déduits : nous ne pouvons pas tester cela sur des données de production, car « mes produits vont être déduits ! » La solution : à un stade précoce, planifiez tout ce test. Vous avez des tests unitaires qui font des mocks. Effectuez cela à un niveau plus profond, où votre canal de communication passera sans nuire au fonctionnement de l'entreprise.
Niveau d'infrastructure
La surveillance de l'infrastructure est considérée depuis longtemps comme la vraie surveillance.
- Il est possible et nécessaire de lancer la surveillance de l'infrastructure en tant que processus distinct.
- Il ne faut pas commencer par la surveillance de l'infrastructure dans un projet en cours, même si l'envie est forte. C'est une maladie pour tous les DevOps. « D'abord je vais surveiller le cluster, je vais surveiller l'infrastructure » – c'est-à-dire qu'il commencera par ce qui est en bas et ne s'intéressera pas à l'application. Parce que l'application est une chose confuse pour le DevOps. Il lui a été remis, et il ne comprend pas comment cela fonctionne. Mais il comprend l'infrastructure et commence par cela. Non, il faut toujours commencer par surveiller l'application.
- Ne surchargez pas le nombre de notifications. Étant donné la complexité des systèmes modernes, les alertes arrivent en continu, et il faut vivre avec cette multitude d'alertes. Une personne de garde, en voyant une centaine de nouvelles alertes, pensera « je ne veux pas en parler ». Les alertes doivent informer uniquement des choses critiques.
Niveau de l'application en tant qu'unité commerciale
Points clés :
- ELK. C'est la norme industrielle. Si, pour une raison quelconque, vous n'agrégez pas les logs, commencez d'urgence à le faire.
- APM. Les APM externes permettent de rapidement établir la surveillance de l'application (NewRelic, BlackFire, Datadog). Vous pouvez temporairement installer cet outil pour essayer de comprendre ce qui se passe chez vous.
- Tracing. Dans des dizaines de microservices, vous devez tracer tout, car la requête ne vit plus par elle-même. Ajouter cela par la suite est très difficile, donc il vaut mieux planifier le tracing dès le développement – c'est du travail et un outil pour les développeurs. Si ce n'est pas encore en place, implémentez-le ! Voir Jaeger/Zipkin.
Alerte
- Organisation du système d'alerte : dans un environnement de surveillance de plusieurs éléments, il doit y avoir un système unifié d'envoi d'alertes. Cela peut être fait avec Grafana. En Occident, tout le monde utilise PagerDuty. Les alertes doivent être claires (par exemple, d'où elles proviennent…). Il est également souhaitable de contrôler que les alertes parviennent effectivement à leur destination.
- Organisation du système de gardes : les alertes ne doivent pas être envoyées à tout le monde (sinon, tout le monde réagira en même temps, ou personne ne réagira). Les développeurs doivent également être en astreinte : définissez clairement les zones de responsabilité, établissez des instructions claires et indiquez à qui exactement téléphoner le lundi et le mercredi, et à qui le mardi et le vendredi (autrement, personne ne saura appeler même en cas de grave problème — ils auront peur de réveiller ou de déranger : les gens n'aiment généralement pas appeler ou réveiller les autres, surtout la nuit). Et expliquez que demander de l'aide n'est pas un signe d'incompétence (« demander de l'aide signifie que je suis un mauvais travailleur »), encouragez les demandes d'aide.
- Organisation de la « base de connaissances » et du workflow de traitement des incidents : pour chaque incident sérieux, un post-mortem doit être planifié, et en tant que mesure temporaire, les actions qui résolvent l'incident doivent être documentées. Et mettez en place une pratique selon laquelle les alertes répétées sont à proscrire ; elles doivent être corrigées dans le code ou les travaux d'infrastructure.
Environnement technologique
Imaginons que notre environnement soit le suivant :
- collecte de données — Prometheus + Grafana;
- analyse des journaux — ELK;
- pour APM ou Tracing — Jaeger (Zipkin).

Le choix des options n'est pas critique. Parce que, si au début vous comprenez comment surveiller le système et que vous élaborez un plan, ensuite vous commencez à choisir les outils en fonction de vos exigences. La question est de savoir ce que vous avez choisi de surveiller au départ. Parce qu'il est possible que l'outil que vous avez choisi au début ne soit pas du tout adapté à vos exigences.
Quelques points techniques que je constate partout ces derniers temps :
Prometheus est intégré à Kubernetes — qui a eu cette idée ?! Que ferez-vous si votre cluster s'effondre ? Si vous avez un cluster complexe à l'intérieur, il doit y avoir un certain système de surveillance interne au cluster, et un autre externe qui collectera des données à partir du cluster.
À l'intérieur du cluster, nous recueillons les journaux et tout le reste. Mais le système de surveillance doit être externe. Très souvent, dans un cluster où se trouve Prometheus, installé en interne, des systèmes qui effectuent des vérifications externes du site sont également présents. Et si votre connexion vers l'extérieur échoue et que l'application ne fonctionne pas ? Cela signifie que tout va bien à l'intérieur, mais cela ne facilite pas la tâche des utilisateurs.
Conclusions
- Le développement de la surveillance n'est pas l'installation d'outils, mais le développement d'un produit logiciel. 98 % de la surveillance actuelle est du codage. Du codage dans les services, du codage pour les vérifications externes, des vérifications des services externes, et ainsi de suite.
- Ne négligez pas le temps des développeurs pour la surveillance : cela peut représenter jusqu'à 30 % de leur travail, mais cela en vaut la peine.
- DevOps, ne vous inquiétez pas si vous n'arrivez pas à surveiller quelque chose, car certaines choses relèvent totalement d'une autre façon de penser. Vous n'étiez pas programmeur, et le travail de surveillance est précisément leur domaine.
- Si le projet fonctionne déjà et n'est pas surveillé (et que vous êtes le manager) — allouez des ressources pour la surveillance.
- Si le produit est déjà en production et que vous êtes DevOps, à qui on a demandé de « configurer la surveillance » — essayez d'expliquer à la direction ce dont j'ai parlé tout au long de ces lignes.
C'est une version étendue de la présentation faite lors de la conférence Saint Highload++.
Si mes idées et réflexions sur l'IT et les sujets connexes vous intéressent, vous pouvez 🙂
Source : habr.com
