

Dans cet article, nous allons aborder brièvement la surveillance des systèmes de stockage IBM Storwize et d'autres systèmes de stockage prenant en charge les protocoles CIM/WBEM. La nécessité de cette surveillance est acceptée comme une évidence. Nous utiliserons Zabbix comme système de surveillance.
Dans les dernières versions de Zabbix, l'entreprise a accordé beaucoup plus d'attention aux modèles — des modèles pour la surveillance des services, des SGBD, du matériel des serveurs (IMM/iBMC) via IPMI ont commencé à apparaître. La surveillance des systèmes de stockage reste en dehors des modèles par défaut, il est donc nécessaire d'utiliser des modèles personnalisés pour intégrer dans Zabbix les informations sur l'état et les performances des composants du système de stockage. Je vous propose un de ces modèles.
D'abord un peu de théorie.
Pour accéder à l'état et aux statistiques des systèmes de stockage IBM Storwize, vous pouvez utiliser :
- Les protocoles CIM/WBEM ;
- (pris en charge par IBM Storwize à partir de la version logicielle 8.1.3) ;
- SNMP Traps (jeu limité de traps, pas de statistiques) ;
- Connexion SSH pour un accès distant .
Les personnes intéressées peuvent en savoir plus sur les différentes méthodes de surveillance dans les sections correspondantes de la documentation du fournisseur, ainsi que dans le document .
Nous allons utiliser les protocoles CIM/WBEM, permettant d'obtenir des paramètres de fonctionnement des systèmes de stockage sans modifications significatives du logiciel pour différents systèmes de stockage. Les protocoles CIM/WBEM fonctionnent conformément à . La spécification de l'initiative de gestion de stockage est basée sur des normes ouvertes et , définies par .
WBEM fonctionne sur le protocole HTTP. Grâce à WBEM, il est possible de travailler non seulement avec des systèmes de stockage, mais aussi avec des HBA, des commutateurs et des bibliothèques de bandes.
Selon et , le composant principal de la mise en œuvre de SMI est le serveur WBEM, qui traite les requêtes CIM-XML des clients WBEM (dans notre cas — des scripts de surveillance) :
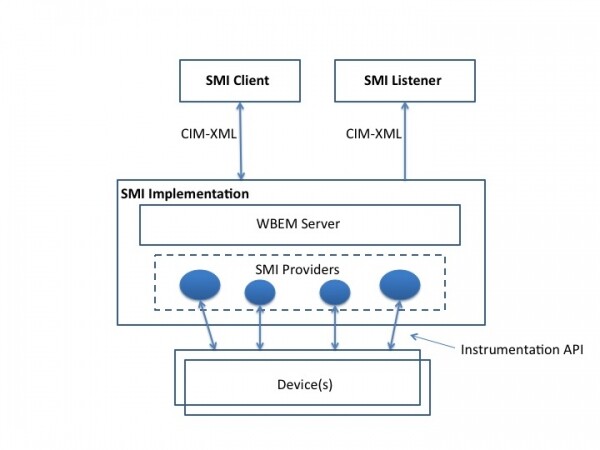
CIM est un modèle orienté objet basé sur le langage de modélisation unifié (UML).
Les éléments gérés sont définis sous forme de classes CIM, qui ont des propriétés et des méthodes pour représenter les données et fonctions gérées.
Selon , pour accéder à la matrice de stockage via CIM/WBEM, vous pouvez utiliser PyWBEM — une bibliothèque open source écrite en Python, qui permet aux développeurs et aux administrateurs système d'implémenter le protocole CIM pour accéder aux objets CIM et réaliser diverses opérations avec le serveur WBEM, conforme à SMI-S ou à d'autres spécifications CIM.
Pour se connecter au serveur WBEM, nous utilisons le constructeur de classe :
conn = pywbem.WBEMConnection(server_uri, (self.login, self.password),
            namespace, no_verification=True)
Il s'agit d'une connexion virtuelle, car CIM-XML/WBEM fonctionne par-dessus HTTP, la connexion réelle se produit au moment de l'appel des méthodes pour l'instance de la classe WBEMConnection. Conformément aux meilleures pratiques et aux directives de performance d'IBM System Storage SAN Volume Controller et Storwize V7000 (Exemple C-8, p. 412), nous utiliserons « root/ibm » comme namespace CIM pour la matrice de stockage IBM Storwize.
Veuillez noter que pour collecter des statistiques via le protocole CIM-XML/WBEM, il est nécessaire d'inclure l'utilisateur dans le groupe de sécurité approprié. Sinon, lors de l'exécution des requêtes WBEM, la sortie des attributs de l'instance de la classe sera vide..
Pour accéder aux statistiques de la matrice de stockage, l'utilisateur qui appelle le constructeur , doit disposer de droits au moins de RestrictedAdmin (disponible pour code_level > 7.8.0) ou Administrator (je ne recommande pas pour des raisons de sécurité).
Connectez-vous au stockage via SSH et vérifiez les numéros de groupe :
> lsusergrp
id name            role            remote
0  SecurityAdmin   SecurityAdmin   no
1  Administrator   Administrator   no
2  CopyOperator    CopyOperator    no
3  Service         Service         no
4  Monitor         Monitor         no
5  RestrictedAdmin RestrictedAdmin no
Ajoutons l'utilisateur zabbix au groupe nécessaire :
> chuser -usergrp 5 zabbix
De plus, conformément aux meilleures pratiques et directives de performance d'IBM System Storage SAN Volume Controller et Storwize V7000 (p. 415), il est nécessaire d'activer la collecte de statistiques sur le stockage. Pour cela, pour collecter des statistiques chaque minute :
> startstats -interval 1
Vérifions :
> lssystem | grep statistics
statistics_status on
statistics_frequency 1
Pour obtenir toutes les classes existantes de la matrice de stockage, il faut utiliser la méthode EnumerateClassNames().
Exemple :
classnames = conn.EnumerateClassNames(namespace='root/ibm', DeepInheritance=True)
for classname in classnames:
     print (classname)
Pour obtenir les valeurs des paramètres de la matrice de stockage, la méthode de la classe WBEMConnection retourne une liste d'instances .
Exemple :
instances = conn.EnumerateInstances(classname,
                   namespace=nd_parameters['name_space'])
for instance in instances:
     for prop_name, prop_value in instance.items():
          print('  %s: %r' % (prop_name, prop_value))
Pour certaines classes contenant un grand nombre d'instances, comme IBMTSSVC_StorageVolume, une requête complète de toutes les instances peut être assez lente. Elle peut générer de gros volumes de données qui doivent être préparés par le système de stockage, transférés via le réseau et traités par un script. Dans ce cas, il existe une méthode , qui permet de n'obtenir que les propriétés de l'instance de classe qui nous intéressent. Cette méthode implique l'utilisation d'un langage de requête semblable à SQL — soit le CIM Query Language (DMTF:CQL), soit le WBEM Query Language (WQL), pour interroger les objets CIM du système de stockage :
request = 'SELECT Name FROM IBMTSSVC_StorageVolumeStatistics'
objects_perfs_cim = wbem_connection.ExecQuery('DMTF:CQL', request)
Pour déterminer quelles classes nous devons interroger pour obtenir les paramètres des objets de stockage, nous lisons la documentation, par exemple .
. Ainsi, pour obtenir les paramètres (non compteurs de performance) des disques physiques (Disk Drives), nous interrogerons la classe IBMTSSVC_DiskDrive, pour obtenir les paramètres des Volumes — la classe IBMTSSVC_StorageVolume, pour obtenir les paramètres des tableaux — la classe IBMTSSVC_Array, pour obtenir les paramètres des MDisks — la classe IBMTSSVC_BackendVolume, etc.
Pour plus d'informations sur les performances, vous pouvez consulter (en particulier — ) et les meilleures pratiques et lignes directrices de performance de l'IBM System Storage SAN Volume Controller et du Storwize V7000 (Exemple C-11, p. 415).
Pour obtenir des statistiques de stockage sur les Volumes, il faut indiquer comme valeur du paramètre ClassName IBMTSSVC_StorageVolumeStatistics. Les propriétés nécessaires à la collecte de statistiques de la classe IBMTSSVC_StorageVolumeStatistics peuvent être consultées dans .
De plus, pour l'analyse des performances, on peut utiliser les classes IBMTSSVC_BackendVolumeStatistics, IBMTSSVC_DiskDriveStatistics, IBMTSSVC_NodeStatistics.
Pour enregistrer des données dans le système de surveillance, nous allons utiliser le mécanisme , implémenté en python dans le module . La structure des classes de stockage et de leurs propriétés sera située dans un dictionnaire au format JSON.
Nous chargeons le modèle sur le serveur Zabbix, nous nous assurons qu'il y a un accès au stockage en réseau (SAN) via le protocole WEB (TCP/5989) depuis le serveur de surveillance, puis nous plaçons les fichiers de configuration, les scripts de découverte et de surveillance sur le serveur de surveillance. Ensuite, nous ajoutons le lancement des scripts dans le planificateur. En fin de compte : nous découvrons les objets SAN (arrays, disques physiques et virtuels, enclaves, et bien d'autres), nous les transférons dans les découvertes Zabbix, nous lisons l'état de leurs paramètres, nous lisons les statistiques de performance (performance counters), et nous transmettons tout cela aux éléments Zabbix correspondants de notre modèle.
Le modèle Zabbix, les scripts python, la structure des classes SAN et leurs propriétés, ainsi que des exemples de fichiers de configuration, peuvent .
Source : habr.com
