

Contexte
Nous avons des distributeurs automatiques développés en interne. À l'intérieur, un Raspberry Pi et un peu de câblage sur une carte séparée. Ils sont connectés à un acceptateur de pièces, un acceptateur de billets, un terminal bancaire… Tout est géré par un logiciel sur mesure. L'historique de fonctionnement est enregistré dans un journal sur une clé USB (MicroSD), qui est ensuite transféré via Internet (via un modem USB) vers un serveur, où il est stocké dans une base de données. Les informations sur les ventes sont chargées dans 1C, et il existe également une interface web simple pour le suivi, etc.
Donc, le journal est absolument nécessaire — pour la comptabilité (avec les recettes, les ventes, etc.), et pour le monitoring (toutes sortes de pannes et autres circonstances imprévues); c'est, on peut dire, toute l'information que nous avons sur ce distributeur automatique.
Le problème
Les clés USB se révèlent être des dispositifs très peu fiables. Elles tombent régulièrement en panne. Cela entraîne à la fois des temps d'arrêt pour les distributeurs et (si pour une raison quelconque le journal ne pouvait pas être transmis en ligne) des pertes de données.
Ce n'est pas la première fois que nous utilisons des clés USB, il y avait auparavant un autre projet avec plus d'une centaine d'appareils, où le journal était stocké sur des clés USB, il y avait aussi des problèmes de fiabilité, et parfois le nombre de pannes par mois atteignait des dizaines. Nous avons essayé différentes clés, y compris des modèles de marques avec de la mémoire SLC, certaines modèles étant plus fiables que d'autres, mais le remplacement des clés USB n'a pas résolu le problème de manière radicale.
Attention ! Long read! Si vous n'êtes pas intéressé par le « pourquoi », mais seulement par le « comment », vous pouvez aller directement articles.
Solution
La première chose qui me vient à l'esprit : renoncer au MicroSD, opter par exemple pour un SSD, et démarrer depuis là. Théoriquement, c'est possible, mais relativement cher, et ce n'est pas si fiable (un adaptateur USB-SATA est ajouté ; les statistiques de défaillance des SSD bon marché ne sont pas très réjouissantes non plus).
Un disque dur USB ne semble pas non plus être une solution particulièrement attrayante.
C'est pourquoi nous avons opté pour cette solution : conserver le démarrage à partir du MicroSD, mais les utiliser en mode lecture seule, et stocker le journal de travail (et d'autres informations uniques pour chaque appareil — numéro de série, étalonnages des capteurs, etc.) ailleurs.
Le sujet des systèmes de fichiers en lecture seule pour Raspberry Pi a déjà été étudié en profondeur, je ne m'attarderai pas sur les détails de mise en œuvre dans cet article. (mais si cela vous intéresse, peut-être que j'écrirai un mini-article à ce sujet). Le seul point à noter est qu'en fonction de mon expérience personnelle et des retours d'expérience de ceux qui l'ont déjà intégré, il y a des gains en fiabilité. Oui, il est impossible de se débarrasser complètement des pannes, mais il est tout à fait réaliste de réduire considérablement leur fréquence. De plus, les cartes deviennent unifiées, ce qui facilite visiblement le remplacement pour le personnel de maintenance.
Partie matérielle
Il n'y avait pas de doutes particuliers sur le type de mémoire — NOR Flash.
Arguments :
- connexion simple (le plus souvent un bus SPI, dont l'expérience d'utilisation existe déjà, donc pas de problèmes 'matériels' à prévoir) ;
- prix dérisoire ;
- protocole de fonctionnement standard (une implémentation existe déjà dans le noyau Linux, si souhaité on peut prendre une externe, qui existe aussi, ou même écrire la sienne, c'est assez simple) ;
- fiabilité et endurance :
d'après une fiche technique typique : les données sont conservées pendant 20 ans, 100000 cycles d'effacement pour chaque bloc ;
d'après des sources externes : BER très bas, aucune nécessité de codes de correction d'erreurs postulée (dans certains travaux, l'ECC pour NOR est envisagé, mais en général on parle là de MLC NOR, ce genre de cas existe également).
Estimation des exigences en volume et en ressources.
Nous souhaitons que les données soient conservées de manière garantie pendant plusieurs jours. Cela est nécessaire pour que, en cas de problème de connexion, l'historique des ventes ne soit pas perdu. Nous viserons une période de 5 jours, durant laquelle (même en tenant compte des week-ends et des jours fériés) on peut résoudre le problème.
Actuellement, nous accumulons environ 100 Ko de journaux par jour (3-4 milliers d'entrées), mais ce chiffre augmente progressivement — la granularité augmente, de nouveaux événements sont ajoutés. De plus, il y a parfois des pics (un capteur commence à spammer avec de fausses activations, par exemple). Nous allons calculer sur 10 000 entrées de 100 octets — un mégaoctet par jour.
Au total, cela donne 5 Mo de données brutes (bien compressibles). À cela s'ajoute (estimation brute) 1 Mo de données de service.
Donc, nous avons besoin d'une puce de 8 Mo si nous ne sommes pas en mesure d'utiliser la compression, ou de 4 Mo si nous l'utilisons. Des chiffres tout à fait réels pour ce type de mémoire.
Quant aux ressources : si nous prévoyons que la mémoire sera complètement réécrite pas plus d'une fois tous les 5 jours, alors pour 10 ans de service, nous obtenons moins de mille cycles d'écriture.
Je rappelle que le fabricant promet cent mille.
Un peu sur NOR vs NAND
Aujourd'hui, la mémoire NAND est bien plus populaire, mais pour ce projet, je ne l'utiliserais pas : la NAND, contrairement à la NOR, nécessite toujours des codes de correction d'erreurs, des tableaux de blocs défectueux, etc., et les puces NAND ont généralement beaucoup plus de broches.
Les inconvénients de la NOR incluent :
- petit volume (et donc un prix par mégaoctet élevé);
- vitesse de transfert relativement faible (en grande partie à cause de l'utilisation d'une interface série, généralement SPI ou I2C);
- effacement lent (qui prend de quelques fractions de seconde à plusieurs secondes selon la taille du bloc).
Il n'y a rien de critique pour nous, donc continuons.
Pour ceux qui sont intéressés par les détails, le circuit intégré sélectionné est (ce qui n'est d'ailleurs pas important, il y a des milliers d'analogues sur le marché, compatibles en termes de brochage et de jeu de commandes ; même si nous voulions installer un circuit intégré d'un autre fabricant et/ou d'une autre capacité, tout fonctionnerait sans modification du code).
J'utilise le pilote intégré au noyau Linux, sur Raspberry grâce à la prise en charge des overlays de l'arbre des périphériques, c'est très simple — il suffit de placer l'overlay compilé dans /boot/overlays et de modifier légèrement /boot/config.txt.
Exemple de fichier dts
Honnêtement, je ne suis pas sûr que cela soit écrit sans erreurs, mais ça fonctionne.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Et une ligne supplémentaire dans config.txt
dtoverlay=at25:spimaxfrequency=50000000Je ne vais pas décrire la connexion du circuit intégré au Raspberry Pi. D'une part, je ne suis pas un spécialiste en électronique, d'autre part — c'est très simple même pour moi : le circuit intégré n'a que 8 broches, dont nous avons besoin de la terre, de l'alimentation, et de SPI (CS, SI, SO, SCK); les niveaux correspondent à ceux du Raspberry Pi, aucun câblage supplémentaire n'est nécessaire — il suffit de connecter les 6 broches indiquées.
Définition du problème
Comme d'habitude, la définition du problème passe par plusieurs itérations, je pense qu'il est temps pour une autre. Alors, arrêtons-nous, rassemblons ce qui a déjà été écrit, et clarifions les détails qui restent dans l'ombre.
Ainsi, nous avons décidé que le journal serait stocké dans la mémoire Flash SPI NOR.
Qu'est-ce que la mémoire Flash NOR pour ceux qui ne savent pas
C'est une mémoire non volatile avec laquelle on peut effectuer trois opérations :
- Lecture :
La lecture classique : nous donnons une adresse et lisons autant d'octets que nécessaire; - Écriture :
L'écriture dans la mémoire NOR flash ressemble à une écriture classique, mais elle a une particularité : on ne peut changer un 1 en 0, mais seulement l'inverse. Par exemple, si 0x55 était stocké dans la cellule de mémoire, après l'écriture de 0x0f, elle contiendra 0x05. (voir le tableau ci-dessous); - Effacer :
Évidemment, nous devons également être capables d'effectuer l'opération inverse — changer un 0 en 1, c'est précisément à cela que sert l'opération d'effacement. Contrairement aux deux premières opérations, elle opère non pas sur des octets mais sur des blocs (le bloc d'effacement minimal dans la puce choisie est de 4 Ko). L'effacement détruit l'ensemble du bloc et c'est le seul moyen de changer un 0 en 1. Par conséquent, lors du travail avec la mémoire flash, il est souvent nécessaire d'aligner les structures de données à la frontière du bloc d'effacement.
Écriture dans la mémoire NOR Flash :
Données binaires
Il y avait
01010101
Écrit
00001111
Il est devenu
00000101
Le journal lui-même représente une séquence d'entrées de longueur variable. La longueur typique d'une entrée est d'environ 30 octets (bien que parfois il y ait des entrées de plusieurs kilo-octets). Dans ce cas, nous travaillons avec elles simplement comme avec un ensemble d'octets, mais, si cela vous intéresse, CBOR est utilisé à l'intérieur des enregistrements.
En plus du journal, nous devons stocker certaines informations de "configuration", tant mises à jour qu'immuables : un certain ID de l'appareil, les calibrations des capteurs, un drapeau "appareil temporairement désactivé", etc.
Ces informations se présentent sous la forme d'un ensemble d'enregistrements key-value, également stocké en CBOR. Nous n'avons pas beaucoup de ces informations (un maximum de quelques kilo-octets), elles ne sont pas mises à jour fréquemment.
Nous l'appellerons désormais le contexte.
Si l'on se remémore le début de cet article, il est très important d'assurer la fiabilité du stockage des données et, si possible, un fonctionnement ininterrompu même en cas de défaillances matérielles ou de corruption des données.
Quelles sources de problèmes peut-on envisager ?
- Coupure de courant au moment des opérations d'écriture/effacement. C'est du type "contre un bâton, il n'y a pas de remède".
Informations de stackexchange : lors de la coupure de courant lors du travail avec la flash, que ce soit pour l'effacement (mise à 1) ou pour l'écriture (mise à 0), cela entraîne un comportement indéfini : les données peuvent être enregistrées, enregistrées partiellement (par exemple, nous avons transmis 10 octets/80 bits, mais seulement 45 bits ont pu être écrits), il est également possible qu'une partie des bits se trouve dans un état "intermédiaire" (la lecture peut renvoyer soit 0, soit 1) ; - Erreurs de la mémoire flash elle-même.
Le BER, bien que très bas, ne peut pas être nul ; - Erreurs sur le bus
Les données transmises par SPI ne sont pas protégées et peuvent subir des erreurs de bits individuelles ainsi que des erreurs de synchronisation — perte ou insertion de bits (ce qui entraîne des distorsions massives des données) ; - Autres erreurs/sabots
Erreurs de code, «bugs» Raspberry, interventions d'extraterrestres…
J'ai formulé des exigences dont je pense qu'elles sont nécessaires pour assurer la fiabilité :
- les enregistrements doivent être enregistrés en mémoire flash immédiatement, l'enregistrement différé n'est pas envisagé ; - si une erreur survient, elle doit être détectée et gérée le plus tôt possible ; - le système doit pouvoir restaurer son fonctionnement après une erreur.
(exemple de la vie «comment cela ne devrait pas être», avec lequel, je pense, tout le monde a été confronté : après un redémarrage d'urgence, le système de fichiers a été «endommagé» et le système d'exploitation ne démarre pas)
Idées, approches, réflexions
Lorsque j'ai commencé à réfléchir à cette tâche, une multitude d'idées a traversé mon esprit, par exemple :
- utiliser la compression de données ;
- utiliser des structures de données astucieuses, par exemple stocker les en-têtes des enregistrements séparément des enregistrements eux-mêmes, afin qu'en cas d'erreur dans l'un des enregistrements, les autres puissent être lus sans problème ;
- utiliser des champs bits pour contrôler l'achèvement de l'enregistrement en cas de coupure d'alimentation ;
- conserver des sommes de contrôle pour tout et n'importe quoi ;
- utiliser une sorte de codage résistant aux erreurs.
Certaines de ces idées ont été utilisées, d'autres ont été mises de côté. Faisons-les dans l'ordre.
Compression des données
Les événements que nous enregistrons dans le journal sont assez homogènes et répétitifs («jeter une pièce de 5 roubles», «appuyer sur le bouton pour rendre la monnaie», …). Par conséquent, la compression devrait s'avérer assez efficace.
Les frais généraux de compression sont insignifiants (notre processeur est suffisamment puissant, même le premier Pi avait un cœur à 700 MHz, les modèles actuels en ont plusieurs à plus d'un gigahertz), la vitesse d'échange avec le stockage est faible (quelques mégaoctets par seconde), et la taille des enregistrements est petite. Bref, si la compression affecte les performances, ce ne sera que de manière positive. (absolument non critique, je constate simplement). De plus, nous n'avons pas un véritable embedded, mais un Linux ordinaire — donc la mise en œuvre ne devrait pas nécessiter beaucoup d'efforts (il suffit de lier la bibliothèque et d'utiliser quelques fonctions de celle-ci).
Un extrait de journal d'un appareil en fonctionnement a été pris (1,7 Mo, 70 000 enregistrements) et d'abord vérifié pour sa compressibilité à l'aide de gzip, lz4, lzop, bzip2, xz, zstd disponibles sur l'ordinateur.
- gzip, xz, zstd ont montré des résultats proches (40 Ko).
Il est surprenant que le tendance xz ait montré ici des performances au niveau de gzip ou zstd; - lzip avec les paramètres par défaut a donné un résultat légèrement moins bon;
- lz4 et lzop ont montré des résultats plutôt médiocres (150 Ko);
- bzip2 a donné un résultat étonnamment bon (18 Ko).
Ainsi, les données se compressent très bien.
Donc (si nous ne trouvons pas de défauts fatals) la compression sera là ! Juste parce que plus de données pourront tenir sur la même clé USB.
Réfléchissons aux inconvénients.
Le premier problème : nous avons déjà convenu que chaque enregistrement doit être immédiatement écrit sur la clé. En général, un compresseur accumule les données du flux d'entrée jusqu'à ce qu'il juge qu'il est temps d'écrire dans le flux de sortie. Nous avons besoin d'obtenir immédiatement un bloc de données compressées et de les enregistrer dans une mémoire non volatile.
Je vois trois solutions :
- Compresser chaque enregistrement à l'aide de la compression par dictionnaire au lieu des algorithmes mentionnés ci-dessus.
C'est une option fonctionnelle, mais je ne l'aime pas. Pour maintenir un niveau de compression à peu près acceptable, le dictionnaire doit être « adapté » aux données spécifiques, tout changement entraînera une chute catastrophique du taux de compression. Oui, ce problème peut être résolu en créant une nouvelle version du dictionnaire, mais c'est un véritable casse-tête — nous devrons conserver toutes les versions du dictionnaire ; chaque enregistrement devra indiquer avec quelle version du dictionnaire il a été compressé… - Compresser chaque enregistrement avec des algorithmes « classiques », mais indépendamment les uns des autres.
Les algorithmes de compression examinés ne sont pas conçus pour fonctionner avec des enregistrements de cette taille (dizaines d'octets), le taux de compression sera clairement inférieur à 1 (c'est-à-dire une augmentation du volume des données au lieu de compression); - Faire un FLUSH après chaque enregistrement.
De nombreuses bibliothèques de compression prennent en charge le FLUSH. C'est une commande (ou un paramètre de la procédure de compression) qui, une fois reçue, fait en sorte que le compresseur génère un flux compressé permettant de restaurer tout les données non compressées qui ont déjà été reçues. Une sorte d'analoguesyncdans les systèmes de fichiers oucommitdans sql.
Ce qui est important, c'est que les opérations de compression suivantes pourront utiliser le dictionnaire accumulé et le taux de compression ne sera pas aussi affecté que dans l'option précédente.
Je pense qu'il est évident que j'ai choisi la troisième option, examinons-la plus en détail.
Trouvé sur FLUSH dans zlib.
J'ai effectué un test inspiré d'un article, j'ai pris 70 000 enregistrements d'un journal d'un appareil réel, avec une taille de page de 60 Ko (Nous reviendrons sur la taille de la page) j'ai obtenu :
Données d'origine
Compression gzip -9 (sans FLUSH)
zlib avec Z_PARTIAL_FLUSH
zlib avec Z_SYNC_FLUSH
Volume, Ko
1692
40
352
604
À première vue, le coût apporté par FLUSH semble excessif, cependant en réalité nos choix ne sont pas nombreux — soit ne pas compresser du tout, soit compresser (et de manière très efficace) en utilisant FLUSH. N'oublions pas que nous avons 70 000 enregistrements, le surcoût apporté par Z_PARTIAL_FLUSH est de seulement 4-5 octets par enregistrement. Et le taux de compression s'est avéré presque de 5:1, ce qui est plus qu'un excellent résultat.
Il peut sembler surprenant, mais en réalité Z_SYNC_FLUSH est une méthode plus efficace pour effectuer un FLUSH.
Dans le cas de l'utilisation de Z_SYNC_FLUSH, les 4 derniers octets de chaque enregistrement seront toujours 0x00, 0x00, 0xff, 0xff. Et si nous les connaissons, nous pouvons ne pas les stocker, donc la taille finale ne fait que 324 Ko.
Dans l'article auquel je fais référence, il y a une explication :
Un nouveau bloc de type 0 avec un contenu vide est ajouté.
Un bloc de type 0 avec un contenu vide se compose de :
- l'en-tête de bloc de trois bits ;
- de 0 à 7 bits égaux à zéro, pour atteindre l'alignement des octets ;
- la séquence de quatre octets 00 00 FF FF.
Comme il n'est pas difficile de le remarquer, dans le dernier bloc avant ces 4 octets, il y a de 3 à 10 bits à zéro. Cependant, la pratique a montré qu'il y a en fait au moins 10 bits à zéro.
Il s'avère que de si courts blocs de données sont généralement (toujours ?) codés avec un bloc de type 1 (bloc fixe), qui se termine obligatoirement par 7 bits à zéro, ce qui nous donne entre 10 et 17 bits à zéro garantis (et les autres seront à zéro avec une probabilité d'environ 50%).
Donc, sur les données de test, dans 100 % des cas, avant 0x00, 0x00, 0xff, 0xff, il y a un octet à zéro, et dans plus d'un tiers des cas — deux octets à zéro. (peut-être est-ce parce que j'utilise un CBOR binaire, et lors de l'utilisation de JSON textuel, on rencontrerait plus fréquemment des blocs de type 2 — blocs dynamiques, de sorte qu'on rencontrerait des blocs sans octets supplémentaires à zéro avant 0x00, 0x00, 0xff, 0xff).
Ainsi, sur les données de test existantes, on peut se conformer à moins de 250 Ko de données compressées.
On peut encore économiser un peu en jonglant avec les bits : maintenant, nous ignorons la présence de plusieurs bits nuls à la fin du bloc, et quelques bits au début du bloc ne changent également pas...
Mais ici, j'ai pris la décision de m'arrêter, sinon, à ce rythme, je pourrais finir par développer mon propre archiveur.
En résumé, j'ai obtenu de mes données de test 3 à 4 octets par écriture, et le taux de compression a dépassé 6:1. Honnêtement, je ne m'attendais pas à un tel résultat, à mon avis, tout ce qui est meilleur que 2:1 est déjà un résultat justifiant l'utilisation de la compression.
Tout va bien, mais zlib (deflate) reste un algorithme de compression archaïque, méritant et un peu démodé. Déjà, le fait qu'il utilise les 32 Ko les plus récents du flux de données non compressées semble étrange aujourd'hui (c'est-à-dire que si un bloc de données ressemble beaucoup à ce qui était dans le flux d'entrée il y a 40 Ko, il commencera à être compressé à nouveau, plutôt que de faire référence à une entrée précédente). Dans les archiveurs modernes à la mode, la taille du dictionnaire est souvent mesurée en mégaoctets, et non en kilo-octets.
Donc, nous continuons notre mini-recherche sur les archiveurs.
Le suivant à être testé a été bzip2 (rappelons-le, sans FLUSH il a montré un taux de compression fantastique, presque 100:1). Malheureusement, avec FLUSH, il a montré de très mauvais résultats, la taille des données compressées était supérieure à celle des données non compressées.
Mes hypothèses sur les raisons de l'échec
Libbz2 n'offre qu'une seule option de flush, qui semble nettoyer le dictionnaire (analogue de Z_FULL_FLUSH dans zlib), il est difficile de parler d'une compression efficace après cela.
Et enfin, le dernier testé a été zstd. Selon les paramètres, il compresse soit au niveau de gzip, mais beaucoup plus rapidement, soit mieux que gzip.
Malheureusement, avec FLUSH, il a également montré des résultats « pas très impressionnants » : la taille des données compressées a atteint environ 700 Ko.
Je sur la page du projet sur github, et j'ai reçu une réponse indiquant qu'on doit s'attendre à environ 10 octets de données de service pour chaque bloc de données compressées, ce qui est proche des résultats obtenus, on ne pourra jamais égaler deflate.
J'ai décidé d'arrêter mes expériences avec les archiveurs (rappelons que xz, lzip, lzo, lz4 n'ont pas été performants lors des tests sans FLUSH, et je n'ai pas voulu envisager des algorithmes de compression plus exotiques).
Retournons aux problèmes d'archivage.
Le deuxième problème (comme on le dit en termes d'ordre et non de signification) est que les données compressées se présentent sous la forme d'un flux unique, contenant constamment des références à des sections précédentes. Ainsi, si une partie des données compressées est endommagée, nous perdons non seulement le bloc de données non compressées qui y est lié, mais également tous les suivants.
Il existe plusieurs approches pour résoudre ce problème :
- Prévenir l'apparition du problème en ajoutant une redondance aux données compressées, ce qui permettra de détecter et de corriger les erreurs ; nous en parlerons plus tard;
- Minimiser les conséquences en cas de problème
Nous avons déjà mentionné précédemment que chaque bloc de données peut être compressé indépendamment, ce qui résoudrait le problème (la corruption des données d'un bloc entraînerait la perte de données uniquement pour ce bloc). Cependant, c'est un cas extrême où la compression des données serait inefficace. L'autre extrême : utiliser les 4 Mo de notre puce comme une seule archive, ce qui donnerait une excellente compression, mais des conséquences catastrophiques en cas de corruption des données.
Oui, un compromis en termes de fiabilité est nécessaire. Mais il faut garder à l'esprit que nous développons un format de stockage des données pour une mémoire non volatile avec un TBER extrêmement bas et une durée de conservation des données déclarée de 20 ans.
Au cours de mes expériences, j'ai découvert que des pertes de niveau de compression plus ou moins perceptibles commencent avec des blocs de données compressées d'une taille inférieure à 10 Ko.
Il a été mentionné précédemment que la mémoire utilisée est organisée par pages, et je ne vois pas de raisons pour lesquelles il ne faudrait pas utiliser la correspondance 'une page - un bloc de données compressées'.
C'est-à-dire que la taille minimale raisonnable d'une page est de 16 Ko (avec une réserve pour les informations de service). Cependant, une si petite taille de page impose des restrictions substantielles sur la taille maximale de l'enregistrement.
Bien que je n'anticipe pas encore d'enregistrements plus grands qu'un kilooctet en version compressée, j'ai décidé d'utiliser des pages de 32 Ko (ce qui donne un total de 128 pages par puce).
Résumé :
- Nous stockons les données compressées à l'aide de zlib (deflate);
- Pour chaque enregistrement, nous définissons Z_SYNC_FLUSH;
- Pour chaque enregistrement compressé, nous coupons les octets finaux (par exemple, 0x00, 0x00, 0xff, 0xff); dans l'en-tête, nous indiquons combien d'octets nous avons coupés;
- Les données sont stockées par pages de 32 Ko; à l'intérieur de la page, nous avons un flux continu de données compressées; à chaque page, nous recommençons la compression.
Et, avant de terminer avec la compression, je voudrais souligner que nous n'obtenons qu'une poignée d'octets compressés par enregistrement, il est donc crucial de ne pas gonfler les informations de service, chaque octet compte ici.
Stockage des en-têtes de données
Comme nous avons des enregistrements de longueur variable, nous devons trouver un moyen de déterminer l'emplacement / les limites des enregistrements.
Je connais trois approches :
- Tous les enregistrements sont stockés dans un flux continu, d'abord l'en-tête de l'enregistrement, contenant la longueur, puis l'enregistrement lui-même.
Dans ce cas, les en-têtes et les données peuvent avoir une longueur variable.
En gros, nous obtenons une liste chaînée qui est utilisée à profusion. - Les en-têtes et les enregistrements eux-mêmes sont stockés dans des flux séparés.
En utilisant des en-têtes de longueur fixe, nous garantissons qu'une corruption d'un en-tête n'affecte pas les autres.
Une telle approche est utilisée, par exemple, dans de nombreux systèmes de fichiers. - Les enregistrements sont stockés dans un flux continu, la limite de l'enregistrement est définie par un certain marqueur (symbole / séquence de symboles qui sont interdits à l'intérieur des blocs de données). Si un marqueur apparaît dans l'enregistrement, nous le remplaçons par une certaine séquence (nous l'échappons).
Une telle approche est utilisée, par exemple, dans le protocole PPP.
Je vais illustrer.
Option 1 :
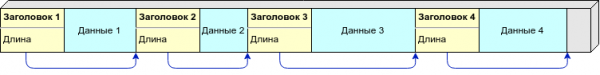
Ici, c'est très simple : en connaissant la longueur de l'enregistrement, nous pouvons calculer l'adresse du prochain en-tête. Ainsi, nous avançons à travers les en-têtes jusqu'à ce que nous rencontrions une zone remplie de 0xff (zone libre) ou la fin de la page.
Option 2 :
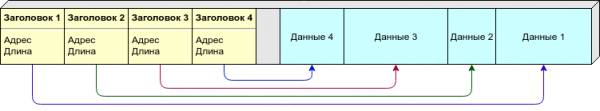
En raison de la longueur variable des enregistrements, nous ne pouvons pas dire à l'avance combien d'enregistrements (et donc d'en-têtes) seront nécessaires pour remplir une page. Nous pourrions séparer les en-têtes et les données sur différentes pages, mais je préfère une autre approche : à la fois les en-têtes et les données sont placés sur une seule page, cependant les en-têtes (de taille fixe) se trouvent au début de la page, tandis que les données (de longueur variable) commencent à l'arrière. Dès qu'ils "se rencontrent" (l'espace libre n'est pas suffisant pour un nouvel enregistrement) — nous considérons que cette page est pleine.
Option 3 :

Il n'est pas nécessaire de stocker la longueur ou d'autres informations sur la disposition des données dans l'en-tête, il suffit d'utiliser des marqueurs pour indiquer les frontières des enregistrements. Cependant, les données doivent être traitées lors de l'écriture/lecture.
Comme marqueur, j'utiliserais 0xff (qui remplit la page après une éradication), de cette façon, la zone libre ne sera définitivement pas interprétée comme des données.
Tableau comparatif :
Option 1
Option 2
Option 3
Résilience aux erreurs
—
+
+
Compacité
+
—
+
Complexité de mise en œuvre
*
**
**
L'option 1 a un défaut fatal : si l'un des en-têtes est endommagé, toute la chaîne suivante est détruite. Les autres options permettent de récupérer une partie des données même en cas de dommages massifs.
Mais il convient de rappeler que nous avons décidé de stocker les données de manière compressée, donc nous perdons toutes les données sur la page après une écriture « défectueuse », donc même si un moins est affiché dans le tableau, nous ne le prenons pas en compte.
Compacité :
- Dans le premier cas, nous devons stocker uniquement la longueur dans l'en-tête, en utilisant une variable de longueur entière, nous pouvons généralement nous contenter d'un octet ;
- Dans le deuxième cas, nous devons stocker l'adresse de départ et la longueur ; l'enregistrement doit avoir une taille fixe, j'estime cela à 4 octets par enregistrement (deux octets pour le décalage et deux octets pour la longueur) ;
- La troisième option nécessite seulement un caractère pour désigner le début de l'enregistrement, de plus, l'enregistrement lui-même augmentera de 1 à 2 % à cause de l'échappement. Dans l'ensemble, il y a une parité approximative avec la première option.
À l'origine, j'ai considéré la deuxième option comme principale (et même j'ai écrit une implémentation). Je ne m'en suis détouré qu'une fois que j'ai décidé d'utiliser la compression.
Peut-être qu'un jour j'utiliserai quand même une telle option. Par exemple, si je devais m'occuper de stocker des données pour un vaisseau circulant entre la Terre et Mars — des exigences de fiabilité complètement différentes, le rayonnement cosmique, …
Quant à la troisième option : je lui ai donné deux étoiles pour la complexité de mise en œuvre simplement parce que je n'aime pas me compliquer avec l'échappement, le changement de longueur en cours de traitement, etc. Oui, c'est peut-être biaisé, mais c'est moi qui vais devoir écrire le code — pourquoi me forcer à faire quelque chose que je n'aime pas.
Résumé : nous choisissons l'option de stockage sous la forme de chaînes « en-tête avec longueur — données de longueur variable » en raison de son efficacité et de sa simplicité de mise en œuvre.
Utilisation de champs de bits pour contrôler le succès des opérations d'écriture
Je ne me souviens déjà plus où j'ai vu l'idée, mais cela ressemble à peu près à ceci :
Pour chaque enregistrement, nous assignons quelques bits pour stocker des drapeaux.
Comme nous l'avons dit précédemment, après l'effacement, tous les bits sont remplis de 1, et nous pouvons changer le 1 en 0, mais pas l'inverse. Ainsi, pour « drapeau non défini », nous utilisons 1, pour « drapeau défini » — 0.
Voici à quoi pourrait ressembler l'enregistrement d'une variable de longueur dans la flash :
- Nous définissons le drapeau « l'enregistrement de la longueur a commencé » ;
- Nous enregistrons la longueur ;
- Nous définissons le drapeau « l'enregistrement des données a commencé » ;
- Nous enregistrons les données ;
- Nous définissons le drapeau « l'enregistrement est terminé ».
De plus, nous aurons un drapeau « une erreur s'est produite », soit 4 drapeaux de bits au total.
Dans ce cas, nous avons deux états stables « 1111 » — l'enregistrement n'a pas commencé et « 1000 » — l'enregistrement a réussi ; en cas d'interruption imprévue du processus d'enregistrement, nous obtiendrons des états intermédiaires que nous pourrons ensuite détecter et traiter.
L'approche est intéressante, mais elle ne protège que contre une coupure de courant soudaine et des pannes similaires, ce qui est bien sûr important, mais ce n'est pas la seule (et même pas la principale) cause possible de pannes.
Résumé : continuons à chercher une bonne solution.
Sommes de contrôle
Les sommes de contrôle permettent également de s'assurer (avec une probabilité suffisante) que nous lisons exactement ce qui devait être enregistré. Et, contrairement aux champs de bits mentionnés ci-dessus, elles fonctionnent toujours.
Si nous examinons la liste des sources potentielles de problèmes que nous avons discutées ci-dessus, la somme de contrôle peut détecter une erreur indépendamment de son origine (à l'exception peut-être des extraterrestres malveillants — ceux-ci peuvent falsifier la somme de contrôle également).
Ainsi, si notre objectif est de vérifier que les données sont intactes, les sommes de contrôle sont une excellente idée.
Le choix de l'algorithme de calcul de la somme de contrôle ne posait pas de questions — CRC. D'une part, les propriétés mathématiques permettent de détecter à 100 % certaines erreurs, d'autre part — sur des données aléatoires, cet algorithme montre généralement une probabilité de collisions pas beaucoup plus élevée que la limite théorique.  . Bien que ce ne soit pas l'algorithme le plus rapide et qu'il ne minimise pas toujours le nombre de collisions, il a une qualité très importante : dans les tests que j'ai rencontrés, il n'y avait pas de motifs sur lesquels il échouait clairement. La stabilité est la principale qualité dans ce cas.
Exemple d'une étude approfondie : , (liens vers narod.ru, désolé).
Cependant, la tâche de choisir une somme de contrôle n'est pas terminée, CRC est une famille entière de sommes de contrôle. Il faut se décider sur la longueur, puis choisir le polynôme.
Le choix de la longueur de la somme de contrôle n'est pas aussi simple qu'il y paraît au premier abord.
Je vais illustrer :
Supposons que nous avons une probabilité d'erreur pour chaque octet  et une somme de contrôle idéale, calculons le nombre moyen d'erreurs sur un million d'enregistrements :
Données, octet
Somme de contrôle, octet
Erreurs non détectées
Faux positifs
Total des fausses alertes
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Il semblerait que ce soit simple — choisissez la longueur de la somme de contrôle selon la longueur des données protégées avec un minimum de fausses alertes — et le tour est joué.
Cependant, avec des sommes de contrôle courtes, un problème se pose : bien qu'elles détectent bien les erreurs de bit uniques, elles peuvent, avec une probabilité assez élevée, accepter des données complètement aléatoires comme valides. Un article a déjà été publié sur Habr décrivant .
Ainsi, pour rendre une coïncidence de somme de contrôle pratiquement impossible, il faut utiliser des sommes de contrôle d'une longueur d'au moins 32 bits (pour des longueurs supérieures à 64 bits, on utilise généralement des fonctions de hachage cryptographiques).
Bien que j'aie précédemment écrit qu'il faut économiser de l'espace par tous les moyens, nous allons néanmoins utiliser une somme de contrôle de 32 bits (16 bits est insuffisant, la probabilité de collision dépasse 0,01 % ; et 24 bits, comme on dit, ne mène nulle part).
Une objection pourrait surgir : avons-nous vraiment économisé chaque octet lors du choix de la compression pour donner maintenant 4 octets d'un coup ? N'était-il pas mieux de ne pas compresser et de ne pas ajouter de somme de contrôle ? Bien sûr que non, l'absence de compression ne signifie pas, que la vérification d'intégrité n'est pas nécessaire.
Nous ne réinventerons pas la roue pour le choix du polynôme, et nous prendrons le populaire CRC-32C.
Ce code détecte 6 erreurs de bits sur des paquets jusqu'à 22 octets (peut-être le cas le plus fréquent pour nous), 4 erreurs de bits sur des paquets jusqu'à 655 octets (également un cas fréquent pour nous), 2 ou tout nombre impair d'erreurs de bits sur des paquets de toute longueur raisonnable.
Si cela intéresse quelqu'un
sur le CRC.
sur — peut-être le principal spécialiste du CRC sur la planète.
Dans Il existe , offrant des paramètres légèrement meilleurs pour les longueurs de paquets qui nous concernent, mais je n'ai pas jugé la différence significative, et je me sens suffisamment compétent pour choisir un code personnalisé plutôt que standard et bien étudié.
De plus, étant donné que nos données sont compressées, se pose la question : devrions-nous calculer la somme de contrôle à partir des données compressées ou non compressées ?
Arguments en faveur du calcul de la somme de contrôle sur les données non compressées :
- nous devons finalement vérifier l'intégrité des données stockées — c'est ce que nous vérifions directement (cela permettra également de vérifier les éventuelles erreurs dans l'implémentation de la compression/décompression, les corruptions causées par une mémoire défectueuse, etc.) ;
- l'algorithme deflate dans zlib a une implémentation suffisamment mature et ne devrait pas échouer avec des données d'entrée « corrompues », et de plus, il est souvent capable de détecter lui-même les erreurs dans le flux d'entrée, réduisant ainsi la probabilité globale de non-détection d'erreurs (j'ai effectué un test en inversant un seul bit dans une courte entrée, zlib a détecté l'erreur dans environ un tiers des cas).
Arguments contre le calcul de la somme de contrôle sur les données non compressées :
- Le CRC est précisément conçu pour un nombre limité d'erreurs de bits, caractéristiques de la mémoire flash (une erreur de bit dans un flux compressé peut entraîner un changement massif du flux de sortie, sur lequel, théoriquement, nous pourrions « attraper » une collision) ;
- je n'aime pas trop l'idée de transmettre des données potentiellement corrompues au décompresseur, , comment il réagira.
Dans ce projet, j'ai décidé de m'éloigner de la pratique courante de stockage de la somme de contrôle des données non compressées.
Résumé : nous utilisons CRC-32C, et nous calculons la somme de contrôle à partir des données tel qu'elles sont enregistrées dans la flash (après compression).
Redondance
L'utilisation de la redondance de code ne permet pas, bien sûr, d'éliminer complètement la perte de données, mais elle peut considérablement (souvent de plusieurs ordres de grandeur) réduire la probabilité de pertes de données irrécupérables.
Nous pouvons utiliser différents types de redondance pour corriger les erreurs.
Les codes de Hamming peuvent corriger des erreurs de bit uniques, les codes de Reed-Solomon sont symboliques, et plusieurs copies de données accompagnées de sommes de contrôle ou un codage tel que RAID-6 peuvent aider à récupérer des données même en cas de dommages massifs.
Au départ, j'étais en faveur d'une utilisation étendue du codage résistant aux erreurs, mais j'ai ensuite réalisé qu'il fallait d'abord comprendre contre quelles erreurs nous voulons nous protéger, puis choisir le codage.
Nous avons dit précédemment qu'il fallait détecter les erreurs le plus tôt possible. À quels moments pouvons-nous être confrontés à des erreurs ?
- Écriture inachevée (pour une raison quelconque, l'alimentation a été coupée au moment de l'écriture, Raspberry a planté, …)
Hélas, dans le cas d'une telle erreur, il ne reste qu'à ignorer les enregistrements invalides et à considérer les données comme perdues ; - Erreurs d'écriture (pour une raison quelconque, ce qui a été écrit dans la mémoire flash n'est pas ce qui a été demandé)
Nous pouvons immédiatement détecter de telles erreurs si nous effectuons une lecture de contrôle juste après l'écriture ; - Distorsion des données en mémoire au cours du stockage ;
- Erreurs de lecture
Pour la correction, il suffit, en cas de désaccord des sommes de contrôle, de répéter plusieurs fois la lecture.
Ainsi, seules les erreurs de troisième type (corruption spontanée des données au stockage) ne peuvent être corrigées sans codage résistant aux erreurs. Il semble que des erreurs de ce type soient néanmoins extrêmement peu probables.
Résumé : Il a été décidé d'abandonner le codage redondant, mais si l'exploitation montre que cette décision est erronée, alors il sera nécessaire de revenir sur la question (avec des statistiques accumulées sur les pannes, ce qui permettra de choisir le type de codage optimal).
Autre
Évidemment, le format de l'article ne permet pas de justifier chaque bit dans le format (et je suis déjà à court de forces), donc je vais brièvement couvrir certains points qui n'ont pas été abordés auparavant.
- Il a été décidé de rendre toutes les pages « égales »
Cela signifie qu'il n'y aura pas de pages spéciales avec des métadonnées, des flux distincts, etc., mais un flux unique qui réécrit toutes les pages à tour de rôle.
Cela garantit une usure uniforme des pages, l'absence d'un point de défaillance unique, et c'est tout simplement agréable. - Il est impératif de prévoir la version du format.
Un format sans numéro de version dans l'en-tête est une mauvaise idée !
Il suffit d'ajouter dans l'en-tête de la page un champ avec un Magic Number (signature), qui indiquera la version du format utilisé. (je ne pense pas qu'il y en ait même une dizaine en pratique); - Utilisez un en-tête de longueur variable pour les enregistrements (qui sont très nombreux), en essayant de le faire d'une longueur de 1 octet pour la plupart des cas.
- Pour coder la longueur de l'en-tête et la longueur de la partie tronquée de l'enregistrement compressé, utilisez des codes binaires de longueur variable.
A beaucoup aidé de codes de Huffman. En quelques minutes, j'ai pu trouver les codes de longueur variable nécessaires.
Description du format de stockage des données
Ordre des octets
Les champs dont la taille dépasse un octet sont stockés en format big-endian (ordre des octets réseau), c'est-à-dire que 0x1234 est enregistré sous la forme 0x12, 0x34.
Division en pages
Toute la mémoire flash est divisée en pages de taille égale.
La taille de la page par défaut est de 32 Ko, mais pas plus d'un quart de la taille totale de la puce de mémoire (pour une puce de 4 Mo, cela représente 128 pages).
Chaque page stocke des données indépendamment des autres (c'est-à-dire que les données d'une page ne référencent pas les données d'une autre page).
Toutes les pages sont numérotées dans un ordre naturel (dans l'ordre croissant des adresses), en commençant par le numéro 0 (la page zéro commence à l'adresse 0, la première à 32 Ko, la seconde à 64 Ko, etc.).
La puce de mémoire est utilisée comme un tampon circulaire (ring buffer), c'est-à-dire que l'enregistrement commence par la page numéro 0, puis va à la page numéro 1, …, lorsque nous remplissons la dernière page, un nouveau cycle commence et l'écriture continue à partir de la page zéro.
À l'intérieur de la page
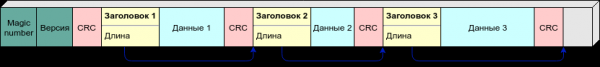
Au début de la page se trouve un en-tête de 4 octets, puis un contrôle de la somme de contrôle de l'en-tête (CRC-32C), ensuite les enregistrements sont stockés au format 'en-tête, données, somme de contrôle'.
L'en-tête de la page (en vert sale sur le schéma) se compose de :
- un champ de deux octets Magic Number (qui est la marque de version du format)
pour la version actuelle du format, il est considéré comme0xed00 ⊕ numéro de page; - compteur de deux octets « Version de la page » (numéro de cycle de réécriture mémoire).
Les enregistrements sur la page sont stockés sous forme compressée (l'algorithme deflate est utilisé). Tous les enregistrements sur une même page sont compressés dans un seul flux (un dictionnaire commun est utilisé), et à chaque nouvelle page, la compression recommence à zéro. Cela signifie que pour décompresser n'importe quel enregistrement, il faut tous les enregistrements précédents de cette page (et seulement de celle-ci).
Chaque enregistrement sera compressé avec le drapeau Z_SYNC_FLUSH, ce qui laisse à la fin du flux compressé 4 octets 0x00, 0x00, 0xff, 0xff, éventuellement précédés d'un ou deux octets nuls.
Cette séquence (d'une longueur de 4, 5 ou 6 octets) est écartée lors de l'écriture dans la mémoire flash.
L'en-tête de l'enregistrement se compose de 1, 2 ou 3 octets, stockant :
- un bit (T), indiquant le type d'enregistrement : 0 — contexte, 1 — journal ;
- un champ de longueur variable (S) de 1 à 7 bits, définissant la longueur de l'en-tête et le « reste » à ajouter à l'enregistrement pour le déballage ;
- la longueur de l'enregistrement (L).
Tableau des valeurs S :
S
Longueur de l'en-tête, octets
Écarté lors de l'écriture, octet
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
J'ai essayé d'illustrer, je ne sais pas à quel point c'est clair :
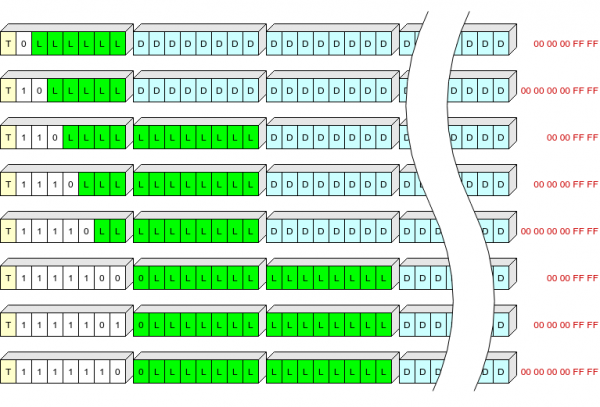
En jaune, le champ T, en blanc, le champ S, en vert L (longueur des données compressées en octets), en bleu, les données compressées, en rouge, les octets finaux des données compressées qui ne sont pas écrits dans la mémoire flash.
Ainsi, les en-têtes des enregistrements de longueur la plus courante (jusqu'à 63+5 octets en version compressée) peuvent être enregistrés en un seul octet.
Après chaque enregistrement se trouve un contrôle de somme CRC-32C, dont la valeur initiale (init) est l'inversion de la somme de contrôle précédente.
Le CRC possède la propriété de « continuité », il agit (plus ou moins l'inversion des bits en cours de processus) selon cette formule :  .
C'est-à-dire que nous calculons en fait le CRC de tous les octets précédents des en-têtes et des données sur cette page.
Juste après la somme de contrôle se trouve l'en-tête du prochain enregistrement.
L'en-tête est construit de manière à ce que son premier octet soit toujours différent de 0x00 et 0xff (si nous rencontrons 0xff à la place du premier octet de l'en-tête, cela signifie que c'est une zone inutilisée ; 0x00 signale une erreur).
Algorithmes approximatifs
Lecture à partir de la mémoire flash
Toute lecture se fait avec vérification de la somme de contrôle.
Si la somme de contrôle ne correspond pas, la lecture est répétée plusieurs fois dans l'espoir de lire des données correctes.
(cela a du sens, Linux ne met pas en cache la lecture de la mémoire Flash NOR, vérifié)
Écriture dans la mémoire Flash
Nous écrivons des données.
Nous les lisons.
Si les données lues ne correspondent pas à celles écrites, nous remplissons la zone de zéros et signalons une erreur.
Préparation d'une nouvelle puce à la fonction
Pour l'initialisation, un en-tête avec la version 1 est écrit sur la première (c'est-à-dire la zéro) page.
Après cela, le contexte initial (contient l'UUID de la machine et les paramètres par défaut) est écrit dans cette page.
C'est bon, la mémoire Flash est prête à l'emploi.
Chargement de la machine
Lors du chargement, les premiers 8 octets de chaque page (en-tête + CRC) sont lus, les pages avec un Magic Number inconnu ou un CRC incorrect sont ignorées.
Parmi les pages « correctes », celles avec la version maximale sont sélectionnées, et une page ayant le numéro le plus élevé est choisie.
La première entrée est lue, la validité du CRC et la présence du drapeau « contexte » sont vérifiées. Si tout est normal, cette page est considérée comme actuelle. Sinon, nous revenons à la précédente jusqu'à ce que nous trouvions une page « vivante ».
À la page trouvée, nous lisons toutes les entrées, et celles avec le drapeau « contexte » sont appliquées.
Nous sauvegardons le dictionnaire zlib (il sera nécessaire pour des écritures supplémentaires dans cette page).
C'est bon, le chargement est terminé, le contexte est restauré, nous pouvons travailler.
Ajout d'une entrée au journal
Nous compressons l'entrée avec le bon dictionnaire, en utilisant Z_SYNC_FLUSH. Nous vérifions si l'entrée compressée tient sur la page actuelle.
Si elle ne tient pas (ou s'il y a eu des erreurs de CRC sur la page), nous commençons une nouvelle page (voir ci-dessous).
Nous écrivons l'entrée et le CRC. En cas d'erreur, nous commençons une nouvelle page.
Nouvelle page
Nous choisissons une page libre avec le numéro minimal (nous considérons comme libre une page avec une somme de contrôle incorrecte dans l'en-tête ou une version inférieure à la version actuelle). S'il n'y a pas de telles pages, nous choisissons la page avec le numéro minimal ayant la version égale à la version actuelle.
Nous mettons la page sélectionnée en mode effacement. Nous comparons le contenu avec 0xff. Si quelque chose ne va pas, nous prenons la page libre suivante, etc.
Sur la page effacée, nous écrivons l'en-tête, la première entrée contient l'état actuel du contexte, la suivante l'entrée de journal non écrite (s'il y en a).
Applicabilité du format
À mon avis, c'est un bon format pour stocker tout flux d'informations compressibles (texte simple, JSON, MessagePack, CBOR, peut-être protobuf) dans de la NOR Flash.
Bien sûr, le format est « conçu » pour la NOR Flash SLC.
Il ne faut pas l'utiliser avec des supports ayant un BER élevé, comme NAND ou MLC NOR. (y a-t-il de la mémoire de ce type en vente ? Je n'ai vu que des références dans des travaux sur les codes de correction).
D'autant plus qu'il ne faut pas l'utiliser avec des dispositifs ayant leur propre FTL : USB flash, SD, MicroSD, etc. (pour ce type de mémoire, j'ai créé un format avec une taille de page de 512 octets, une signature au début de chaque page et des numéros d'enregistrement uniques — parfois, à partir d'une clé USB « défaillante », il était possible de récupérer toutes les données par une simple lecture séquentielle).
Selon les tâches, le format peut être utilisé sans modifications sur des clés USB de 128Kbit (16Ko) à 1Gbit (128Mo). Si désiré, il peut également être utilisé sur des puces de plus grande capacité, mais il faudra probablement ajuster la taille de la page. (Mais là se pose déjà la question de la rentabilité économique, le prix de la NOR Flash de grande capacité n'est pas réjouissant).
Si ce format semble intéressant à quelqu'un et qu'il souhaite l'utiliser dans un projet open source — écrivez-moi, je ferai de mon mieux pour trouver du temps, peaufiner le code et le publier sur github.
Conclusion
Comme nous le voyons, au final, le format s'est avéré simple. et même ennuyeux..
Dans l'article, il est difficile de refléter l'évolution de mon point de vue, mais croyez-moi : au départ, je voulais créer quelque chose de complexe, d'invulnérable, capable de survivre même après une explosion nucléaire à proximité. Cependant, la raison (j'espère) a finalement triomphé et mes priorités se sont progressivement déplacées vers la simplicité et la compacité.
Est-il possible que je me sois trompé ? Oui, bien sûr. Il se peut par exemple que nous ayons acheté un lot de puces de mauvaise qualité. Ou pour une autre raison, l'équipement ne répondra pas aux attentes en matière de fiabilité.
Ai-je un plan pour ce cas ? Je pense qu'après avoir lu l'article, vous ne doutez pas que j'ai un plan. Et même plusieurs.
Plus sérieusement, le format a été développé à la fois comme une option de travail et comme un « essai ».
À ce jour, tout fonctionne normalement sur la table, littéralement dans les jours à venir, la solution sera déployée. (environ) Sur des centaines d'appareils, voyons comment cela se comportera en « conditions réelles » (heureusement, j'espère que le format permet de détecter fiablement les pannes ; ainsi, je pourrai rassembler des statistiques complètes). Dans quelques mois, des conclusions pourront être tirées. (et si la chance ne sourit pas, alors même plus tôt).
Si à l'issue de l'utilisation des problèmes sérieux apparaissent et que des ajustements sont nécessaires, je n'hésiterai pas à en parler.
Littérature
Je n'avais pas envie de dresser une longue liste ennuyeuse de travaux utilisés, après tout, tout le monde a Google.
Ici, j'ai décidé de laisser une liste de découvertes que j'ai trouvées particulièrement intéressantes, mais progressivement, elles ont été intégrées directement dans le texte de l'article, et il ne reste qu'un seul élément dans la liste :
- Utilitaire de l'auteur zlib. Il peut afficher le contenu des archives deflate/zlib/gzip de manière compréhensible. Si vous devez vous pencher sur la structure interne du format deflate (ou gzip), je le recommande vivement.
Source : habr.com
