

Bonjour à tous ! Je m'appelle Nikolai Golov. Avant, je travaillais chez Avito et j'ai dirigé pendant six ans la Data Platform, c'est-à-dire que je m'occupais de toutes les bases : analytiques (Vertica, ClickHouse), de flux et OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Pendant ce temps, j'ai appris à connaître un grand nombre de bases de données — des plus variées et atypiques, avec des cas d'utilisation non standards.
Actuellement, je travaille chez ManyChat. C'est fondamentalement une startup — nouvelle, ambitieuse et en pleine croissance. Et quand je suis arrivé dans l'entreprise, la question classique s'est posée : « Qu'est-ce qu'un jeune startup devrait prendre sur le marché des SGBD et des bases de données ? ».
Dans cet article, qui est basé sur ma présentation à , je répondrai à cette question. La version vidéo de la présentation est disponible sur .
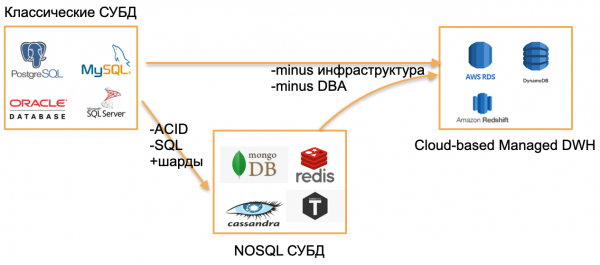
Les bases de données bien connues de l'année 2020
Nous sommes en 2020, j'ai regardé autour de moi et j'ai vu trois types de bases de données.
Le premier type — bases OLTP classiques: PostgreSQL, SQL Server, Oracle, MySQL. Elles ont été écrites il y a longtemps, mais restent pertinentes, car bien connues de la communauté des développeurs.
Le deuxième type — bases des années 2000. Elles ont essayé de s'éloigner des modèles classiques en renonçant au SQL, aux structures traditionnelles et à l'ACID, grâce à l'ajout de sharding intégré et d'autres fonctionnalités attractives. Par exemple, il s'agit de Cassandra, MongoDB, Redis ou Tarantool. Toutes ces solutions souhaitaient proposer quelque chose de vraiment nouveau et ont trouvé leur niche, car elles se sont révélées extrêmement pratiques pour certaines tâches. Je les désignerai par le terme générique NOSQL.
Les années 2000 sont terminées, les bases NOSQL sont devenues familières, et le monde, selon moi, a fait un pas suivant — vers les bases managed. Ces bases ont un noyau similaire à celui des bases OLTP classiques ou des nouvelles NoSQL. Mais elles n'ont pas besoin de DBA et DevOps et fonctionnent sur du matériel géré dans le cloud. Pour le développeur, c'est « juste une base », qui fonctionne quelque part, et comment elle est installée sur le serveur, qui a configuré le serveur et qui le met à jour, ça ne dérange personne.
Exemples de telles bases :
- AWS RDS — enveloppe gérée de PostgreSQL/MySQL.
- DynamoDB — équivalent AWS des bases de données de type document, similaire à Redis et MongoDB.
- Amazon Redshift — base analytique gérée.
À la base, ce sont d'anciennes bases, mais mises sur un environnement géré, sans nécessité de travailler avec le matériel.
Remarque. Les exemples proviennent de l'environnement AWS, mais leurs équivalents existent également dans Microsoft Azure, Google Cloud ou Yandex.Cloud.
Qu'est-ce qui est nouveau à ce sujet ? En 2020, rien de tout cela.
Concept Serverless
Une véritable nouveauté sur le marché en 2020 est le serverless ou les solutions sans serveur.
J'essaierai d'expliquer ce que cela signifie en prenant l'exemple d'un service ordinaire ou d'une application backend.
Pour déployer une application backend classique, nous achetons ou louons un serveur, copions notre code dessus, publions un endpoint à l'extérieur et payons régulièrement pour la location, l'électricité et les services du data center. C'est le schéma standard.
Y a-t-il une autre manière de procéder ? Avec les services sans serveur, c'est possible.
Quel est l'objectif de cette approche : pas de serveur, pas même de location d'une instance virtuelle dans le cloud. Pour déployer le service, nous copions le code (les fonctions) dans un répertoire et publions un endpoint à l'extérieur. Ensuite, nous payons simplement pour chaque appel de cette fonction, en ignorant complètement le matériel sur lequel elle s'exécute.
J'essaierai d'illustrer cette approche avec des images.
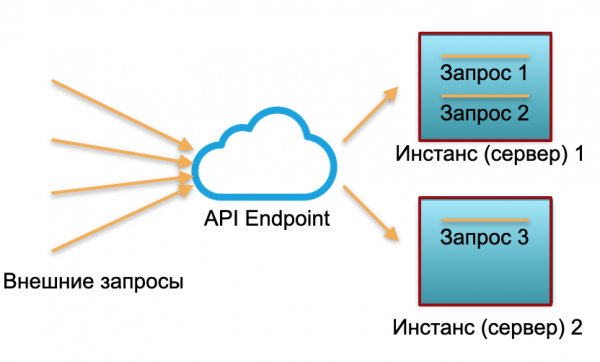
Déploiement classique. Nous avons un service avec une charge spécifique. Nous faisons tourner deux instances : des serveurs physiques ou des instances dans AWS. Les requêtes externes sont dirigées vers ces instances, où elles sont traitées.
Comme on peut le voir sur l'image, les serveurs ne sont pas utilisés de manière identique. Un est utilisé à 100 %, avec deux requêtes, tandis qu'un autre ne l'est qu'à 50 % — il est partiellement inactif. Si au lieu de trois requêtes, il y en a 30, alors tout le système ne pourra pas gérer la charge et commencera à ralentir.
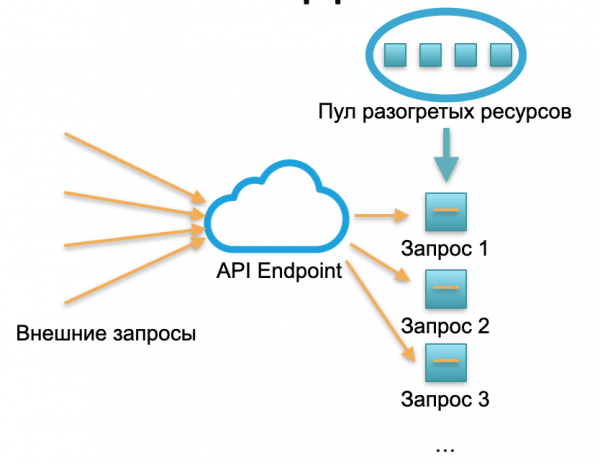
Déploiement sans serveur. Dans un environnement sans serveur, un tel service n'a pas d'instances ni de serveurs. Il y a un certain pool de ressources réchauffées — de petits conteneurs Docker préparés avec le code de la fonction déployée. Le système reçoit des requêtes externes et pour chacune d'elles, le framework sans serveur lance un petit conteneur avec le code : il traite exactement cette requête et détruit le conteneur.
Une requête — un conteneur lancé, 1000 requêtes — 1000 conteneurs. Et le déploiement sur des serveurs physiques — c'est déjà le travail du fournisseur de cloud. Il est complètement masqué par le framework sans serveur. Dans ce concept, nous payons pour chaque appel. Par exemple, si un appel arrive par jour — nous payons pour un appel, s'il y a un million par minute — nous payons pour un million. Ou par seconde, cela arrive aussi.
Le concept de publication de fonction sans serveur convient aux services sans état. Si vous avez besoin d'un service avec état, il faut alors ajouter une base de données au service. Dans ce cas, lorsqu'il s'agit de travailler avec l'état, chaque fonction avec état enregistre et lit simplement à partir de la base de données. De plus, il peut s'agir de l'un des trois types de bases de données décrits au début de l'article.
Quelle est la limitation générale de toutes ces bases ? Ce sont les coûts d'un serveur cloud ou physique (ou plusieurs serveurs) toujours en fonctionnement. Peu importe si nous utilisons une base classique ou gérée, qu'il y ait un DevOps et un administrateur ou non, nous payons toujours 24 heures sur 24 pour le matériel, l'électricité et la location du centre de données. Si nous avons une base classique, nous payons pour le serveur principal et l'esclave. Si nous avons une base shardée à forte charge, nous payons pour 10, 20 ou 30 serveurs, et cela de façon continue.
La présence de serveurs constamment réservés dans la structure des coûts était autrefois perçue comme un mal inévitable. Les bases de données classiques ont aussi d'autres défis, comme les limites sur le nombre de connexions, la réduction de l'évolutivité, le consensus géo-distribué — certaines de ces choses peuvent être résolues dans des bases spécifiques, mais pas toutes en même temps et pas parfaitement.
Base de données sans serveur — théorie
Question de 2020 : peut-on également rendre les bases de données sans serveur ? Tout le monde a entendu parler des backends sans serveur… et si nous essayions également de rendre la base de données sans serveur ?
Cela peut sembler étrange, car la base de données est un service avec état, peu adapté à une infrastructure sans serveur. De plus, l'état de la base de données est très important : des gigaoctets, des téraoctets, et même des pétas dans les bases de données analytiques. Il n'est pas si simple de les faire fonctionner dans des conteneurs Docker légers.
D'autre part, pratiquement toutes les bases de données modernes contiennent une énorme quantité de logique et de composants : transactions, validation de l'intégrité, procédures, dépendances relationnelles et bien plus de logique. Une partie assez importante de la logique de la base de données nécessite un petit état. Les gigaoctets et téraoctets sont directement utilisés seulement par une petite partie de la logique de la base de données liée à l'exécution immédiate des requêtes.
Par conséquent, l'idée est la suivante : si une partie de la logique peut être exécutée sans état, pourquoi ne pas séparer la base en parties avec état et sans état.
Sans serveur pour des solutions OLAP
Voyons comment la séparation d'une base de données en parties avec état et sans état peut se concrétiser par des exemples pratiques.
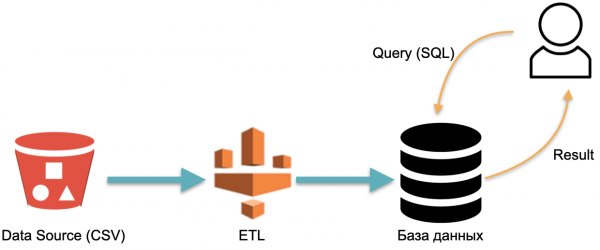
Par exemple, nous avons une base de données analytique: données externes (cylindre rouge à gauche), processus ETL qui charge les données dans la base, et un analyste qui envoie des requêtes SQL à la base. C'est le schéma classique de fonctionnement d'un entrepôt de données.
Dans ce schéma, l'ETL s'exécute, de manière conditionnelle, une fois. Par la suite, il faut toujours payer pour les serveurs sur lesquels fonctionne la base de données alimentée par l'ETL, afin d'avoir un support pour les requêtes.
Considérons une approche alternative, mise en œuvre dans la base AWS Athena Serverless. Ici, il n'y a pas de matériel dédié en permanence où les données chargées sont stockées. Au lieu de cela :
- L'utilisateur envoie une requête SQL à Athena. L'optimiseur Athena analyse la requête SQL et recherche dans le stockage des métadonnées (Metadata) les données spécifiques nécessaires à l'exécution de la requête.
- L'optimiseur, sur la base des données collectées, extrait les données nécessaires des sources externes vers un stockage temporaire (une base de données temporaire).
- Dans le stockage temporaire, la requête SQL de l'utilisateur est exécutée, et le résultat est renvoyé à l'utilisateur.
- Le stockage temporaire est nettoyé, les ressources sont libérées.
Dans cette architecture, nous ne payons que pour le traitement de la requête. Pas de requêtes = pas de frais.
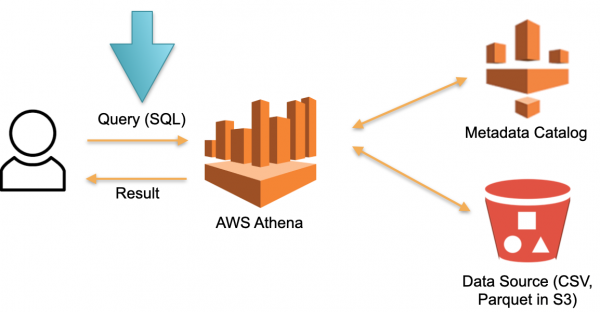
C'est une approche fonctionnelle qui est mise en œuvre non seulement dans Athena Serverless, mais aussi dans Redshift Spectrum (dans AWS).
L'exemple d'Athena montre que la base de données Serverless fonctionne sur de réelles requêtes avec des dizaines et des centaines de téraoctets de données. Pour des centaines de téraoctets, il en faudrait des centaines de serveurs, mais nous n'avons pas besoin de payer pour eux — nous payons pour les requêtes. La vitesse de chaque requête est (très) faible par rapport aux bases de données analytiques spécialisées comme Vertica, mais nous ne payons pas pour les périodes d'inactivité.
Une telle base de données est applicable pour des requêtes analytiques ad-hoc rares. Par exemple, lorsque nous décidons spontanément de tester une hypothèse sur un immense volume de données. Pour ces cas, Athena est parfaitement adaptée. Pour des requêtes régulières, un tel système devient coûteux. Dans ce cas, mettez en cache les données dans une solution spécialisée.
Serverless pour les solutions OLTP
Dans l'exemple précédent, nous avons examiné des tâches OLAP (analytiques). Maintenant, examinons des tâches OLTP.
Imaginons un PostgreSQL ou MySQL évolutif. Élevons une instance PostgreSQL ou MySQL gérée classique avec des ressources minimales. Lorsque l'instance subira plus de charge, nous connecterons des répliques supplémentaires pour répartir une partie de la charge de lecture. Si aucune requête n'est présente, nous désactiverons les répliques. La première instance est le maître, et les autres sont des répliques.
Cette idée est mise en œuvre dans une base nommée Aurora Serverless AWS. Le principe est simple : les requêtes des applications externes sont acceptées par une flotte de proxy. En observant une augmentation de la charge, elle alloue des ressources de calcul à partir d'instances minimales préchauffées — la connexion est effectuée le plus rapidement possible. La désactivation des instances se fait de la même manière.
Dans le cadre d'Aurora, il existe le concept d'Aurora Capacity Unit, ACU. Cela représente (conditionnellement) une instance (serveur). Chaque ACU spécifique peut être maître ou esclave. Chaque Capacity Unit dispose de sa propre mémoire vive, de son processeur et d'un disque minimal. Par conséquent, une instance est le maître, les autres sont des répliques en lecture seule.
Le nombre d'Aurora Capacity Units fonctionnels est un paramètre configurable. Le nombre minimum peut être un ou zéro (dans ce cas, la base ne fonctionne pas s'il n'y a pas de requêtes).
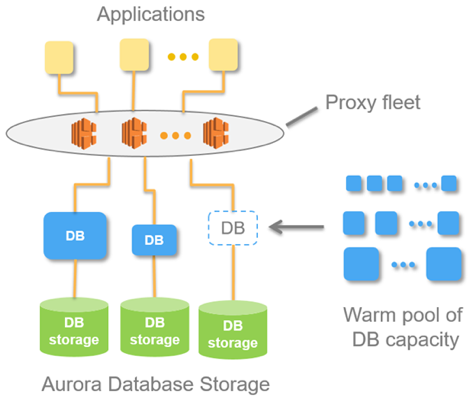
Lorsque la base reçoit des requêtes, la flotte de proxy élève les Aurora Capacity Units, augmentant les ressources productives du système. La possibilité d'augmenter et de diminuer les ressources permet au système de « jongler » avec les ressources : désactiver automatiquement des ACU (les remplaçant par de nouveaux) et appliquer toutes les mises à jour pertinentes aux ressources désactivées.
La base Aurora Serverless peut mettre à l'échelle la charge de lecture. Mais il n'est pas clairement mentionné dans la documentation. Il peut donner l'impression qu'ils peuvent élever un multi-maître. Mais il n'y a vraiment rien de magique.
Cette base est idéale pour éviter de dépenser d'énormes sommes sur des systèmes à accès imprévisible. Par exemple, lors de la création d'un MVP ou de sites web marketing, nous ne prévoyons généralement pas une charge stable. En conséquence, en l'absence d'accès, nous ne payons pas pour les instances. Lorsque la charge survient soudainement, par exemple après une conférence ou une campagne publicitaire, des foules de visiteurs accèdent au site et la charge augmente rapidement, Aurora Serverless gère automatiquement cette charge et connecte rapidement les ressources manquantes (ACU). Après la conférence, tout le monde oublie le prototype, les serveurs (ACU) se mettent en veille et les coûts tombent à zéro — pratique.
Cette solution n'est pas adaptée pour une haute charge stable, car elle ne sait pas gérer la montée en charge de l'écriture. Toutes ces connexions et déconnexions de ressources se produisent au moment appelé « scale point » — le moment où la base n'est pas maintenue par une transaction, ni par des tables temporaires. Par exemple, durant une semaine, il se peut qu'aucun scale point ne se produise, et la base fonctionne sur les mêmes ressources sans pouvoir ni s'étendre, ni se réduire.
Il n'y a pas de magie — c'est du PostgreSQL ordinaire. Mais le processus d'ajout et de suppression de machines est partiellement automatisé.
Serverless par conception
Aurora Serverless est une ancienne base réécrite pour le cloud, afin de tirer parti des avantages distincts du Serverless. Maintenant, parlons d'une base qui a été conçue dès le départ pour le cloud, sous l'approche serverless — Serverless-by-design. Elle a été développée sans aucune hypothèse sur son fonctionnement sur des serveurs physiques.
Cette base s'appelle Snowflake. Elle comprend trois blocs clés.
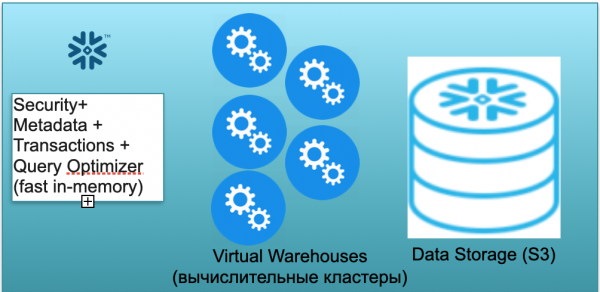
Le premier — c'est le bloc des métadonnées. C'est un service rapide en mémoire qui traite des questions de sécurité, de métadonnées, de transactions et d'optimisation des requêtes (sur l'illustration à gauche).
Le deuxième bloc — ce sont de nombreux clusters de calcul virtuels pour les calculs (sur l'illustration — un ensemble de cercles bleus).
Le troisième bloc — c'est le système de stockage de données basé sur S3. S3 est un stockage d'objets infini sur AWS, quelque chose de semblable à un Dropbox illimité pour les entreprises.
Voyons comment fonctionne Snowflake, en supposant un démarrage à froid. C'est-à-dire que la base est présente, les données sont chargées, mais il n'y a pas de requêtes en cours. En conséquence, s'il n'y a pas de requêtes vers la base, nous avons un service de métadonnées in-memory rapide (le premier bloc). Et nous avons un stockage S3, où se trouvent les données des tables, divisées en ce que l'on appelle des micropartitions. Pour simplifier : si la table contient des transactions, les micropartitions représentent des jours de transactions. Chaque jour est une micropartition distincte, un fichier distinct. Et lorsque la base fonctionne dans ce mode, vous ne payez que pour l'espace occupé par les données. De plus, le tarif pour l'espace est très bas (surtout compte tenu de la compression significative). Le service de métadonnées fonctionne également en permanence, mais pour optimiser les requêtes, il n'est pas nécessaire de disposer de nombreuses ressources, et le service peut être considéré comme conditionnellement gratuit.
Imaginons maintenant qu'un utilisateur essaie d'accéder à notre base et envoie une requête SQL. La requête SQL est immédiatement traitée par le service de métadonnées. En conséquence, après avoir reçu la requête, ce service analyse la requête, les données disponibles, les autorisations de l'utilisateur et, si tout va bien, élabore un plan de traitement de la requête.
Par la suite, le service initie le démarrage d'un cluster de calcul. Un cluster de calcul est un ensemble de serveurs qui effectuent des calculs. Cela signifie que ce cluster peut contenir 1 serveur, 2 serveurs, 4, 8, 16, 32 — autant que vous le souhaitez. Vous soumettez une requête et le démarrage de ce cluster commence immédiatement. Cela prend réellement quelques secondes.
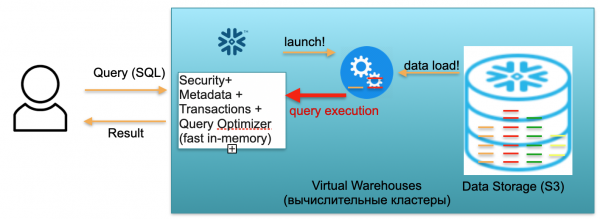
Ensuite, une fois que le cluster est lancé, les micro-partitions nécessaires pour traiter votre demande spécifique commencent à être copiées à partir de S3. Par exemple, considérons qu'il faut deux partitions d'une table et une d'une autre pour exécuter une requête SQL. Dans ce cas, seules les trois partitions nécessaires seront copiées dans le cluster, et non pas toutes les tables dans leur intégralité. C'est précisément pourquoi, et en raison du fait que tout se trouve dans le même centre de données et est connecté par des canaux très rapides, l'ensemble du processus de transfert se fait très rapidement : en quelques secondes, très rarement en quelques minutes, sauf en cas de requêtes particulièrement complexes. Ainsi, les micro-partitions sont copiées sur le cluster de calcul et, une fois ceci terminé, la requête SQL est exécutée sur ce cluster. Le résultat de cette requête peut être une ligne, plusieurs lignes ou une table — elles sont ensuite envoyées à l'utilisateur pour qu'il puisse les télécharger, les afficher dans son outil BI ou les utiliser de quelque manière que ce soit.
Chaque requête SQL peut non seulement lire des agrégats à partir des données déjà chargées, mais également charger/créer de nouvelles données dans la base. C'est-à-dire qu'il peut s'agir d'une requête qui, par exemple, insère de nouveaux enregistrements dans une autre table, ce qui conduit à l'apparition d'une nouvelle partition sur le cluster de calcul, qui, à son tour, est automatiquement sauvegardée dans le stockage S3 unique.
Le scénario décrit ci-dessus, depuis l'arrivée de l'utilisateur jusqu'au démarrage du cluster, le chargement des données, l'exécution des requêtes et la réception des résultats, est facturé au tarif par minute d'utilisation du cluster de calcul virtuel démarré, le warehouse virtuel. Le tarif varie en fonction de la zone AWS et de la taille du cluster, mais en moyenne, cela coûte plusieurs dollars par heure. Un cluster de quatre machines coûte deux fois plus cher qu'un cluster de deux machines, et un cluster de huit machines coûte encore deux fois plus cher. Des options sont disponibles avec 16, 32 machines, selon la complexité des requêtes. Mais vous ne payez que pour les minutes où le cluster est réellement en fonction, car lorsque les requêtes ne sont pas présentes, vous pouvez « retirer vos mains », et après 5 à 10 minutes d'attente (paramètre configurable), il s'éteindra automatiquement, libérera les ressources et deviendra gratuit.
Il est tout à fait réaliste de lancer une requête, un cluster se met en place, disons, en une minute, il calcule pendant une minute de plus, puis cinq minutes pour s'éteindre, et vous payez au final pour sept minutes de fonctionnement de ce cluster, et non pour des mois ou des années.
Le premier scénario décrivait l'utilisation de Snowflake dans un mode monopenreur. Imaginons maintenant qu'il y ait de nombreux utilisateurs, ce qui est plus proche du scénario réel.
Supposons que nous ayons de nombreux analystes et des rapports Tableau qui bombardent constamment notre base de données avec un grand volume de requêtes SQL analytiques simples.
De plus, supposons que nous ayons des Data Scientists ingénieux qui tentent de réaliser des choses incroyables avec les données, en manipulant des dizaines de téraoctets et en analysant des milliards et des trillions de lignes de données.
Pour les deux types de charge décrits ci-dessus, Snowflake permet de déployer plusieurs clusters de calcul indépendants de différentes tailles. Ces clusters fonctionnent de manière indépendante, mais avec des données cohérentes partagées.
Pour un grand nombre de requêtes légères, vous pouvez déployer 2 à 3 petits clusters, chacun occupant, disons, 2 machines. Ce comportement est réalisable, y compris grâce à des réglages automatiques. Vous pouvez dire : « Snowflake, déploie un petit cluster. Si la charge dépasse un certain seuil, déploie un deuxième ou troisième similaire. Lorsque la charge commence à diminuer, éteins les superflus. » Ainsi, peu importe combien d'analystes se présentent et commencent à consulter les rapports, il y a toujours suffisamment de ressources.
De plus, si les analystes dorment et que personne ne consulte les rapports, les clusters peuvent être complètement éteints, et vous ne payez plus pour eux.
En outre, pour les requêtes lourdes (celles des Data Scientists), vous pouvez déployer un très grand cluster de 32 machines, par exemple. Ce cluster sera également facturé uniquement pour les minutes et heures pendant lesquelles votre énorme requête y est exécutée.
La capacité décrite ci-dessus permet de séparer les charges en clusters, non seulement pour 2, mais également pour davantage de types de charges (ETL, monitoring, matérialisation de rapports,…).
Résumons notre propos sur Snowflake. La base combine une belle idée avec une réalisation fonctionnelle. Chez ManyChat, nous utilisons Snowflake pour analyser toutes nos données. Nous avons non pas trois clusters comme dans l'exemple, mais entre 5 et 9, de tailles différentes. Nous disposons de clusters dits de 16 machines, de 2 machines et même de très petits clusters de 1 machine pour certaines tâches. Ils répartissent la charge avec succès et nous permettent d'économiser considérablement.
La base gère avec succès la charge de lecture et d'écriture. C'est une grande différence et un énorme progrès par rapport à l'Aurora, qui ne supportait que la charge de lecture. Snowflake permet de scalabiliser cette charge d'écriture avec ces clusters de calcul. Ainsi, comme je l'ai mentionné, plusieurs clusters sont utilisés chez ManyChat, les petits et super petits clusters étant principalement destinés à l'ETL pour le chargement des données. Les analystes utilisent déjà des clusters de taille moyenne, qui ne sont absolument pas affectés par la charge ETL, ce qui leur permet de fonctionner très rapidement.
Par conséquent, la base est bien adaptée aux tâches OLAP. Malheureusement, elle n'est pas encore applicable aux charges OLTP. Premièrement, cette base est colonne, avec toutes les conséquences qui en découlent. Deuxièmement, le principe même selon lequel vous levez un cluster de calcul pour chaque requête selon les besoins et versez des données dessus n'est malheureusement pas encore assez rapide pour les charges OLTP. Des secondes d'attente pour les tâches OLAP sont normales, mais inacceptables pour les charges OLTP, il vaudrait mieux avoir 100 ms, et encore mieux — 10 ms.
Conclusion
Une base de données sans serveur est possible grâce à la division de la base de données en parties Stateless et Stateful. Vous avez dû remarquer que dans tous les exemples donnés, la partie Stateful est, pour le dire simplement, le stockage des micropartitions dans S3, tandis que la partie Stateless concerne l'optimiseur, le travail avec les métadonnées, le traitement des questions de sécurité, qui peuvent être activées en tant que services Stateless légers et indépendants.
L'exécution des requêtes SQL peut également être perçue comme des services avec un état léger, qui peuvent surgir en mode sans serveur, comme les clusters de calcul Snowflake, télécharger uniquement les données nécessaires, exécuter la requête et "s'éteindre".
Des bases de données serverless de niveau production sont déjà disponibles et fonctionnent. Ces bases serverless sont prêtes à gérer des tâches OLAP. Malheureusement, pour les tâches OLTP, elles sont utilisées... avec des nuances, car il existe des limitations. D'un côté, c'est un inconvénient. Mais d'un autre côté, c'est une opportunité. Peut-être que certains lecteurs trouveront une façon de rendre une base de données OLTP complètement serverless, sans les limitations d'Aurora.
J'espère que vous avez trouvé cela intéressant. Vers un avenir serverless 🙂
Source : habr.com
