

Note de traduction.: l'adaptation de Kubernetes dans GitLab est considérée comme l'un des deux principaux facteurs contribuant à la croissance de l'entreprise. Cependant, jusqu'à récemment, l'infrastructure du service en ligne GitLab.com était construite sur des machines virtuelles, et seulement il y a environ un an a commencé sa migration vers K8s, qui n'est toujours pas terminée. Nous sommes heureux de présenter la traduction d'un récent article d'un ingénieur SRE de GitLab sur la manière dont cela se déroule et les conclusions tirées par les ingénieurs participant au projet.
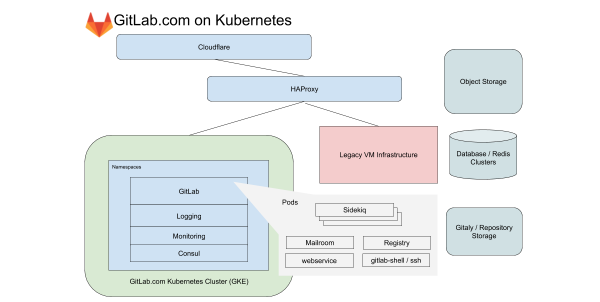
Depuis près d'un an, notre département infrastructure travaille à la migration de tous les services fonctionnant sur GitLab.com vers Kubernetes. Pendant ce temps, nous avons rencontré des problèmes liés non seulement au déplacement des services vers Kubernetes, mais aussi à la gestion du déploiement hybride pendant la transition. Cet article traitera des leçons précieuses que nous avons apprises.
Depuis le début, GitLab.com a fonctionné sur le cloud avec des machines virtuelles. Ces machines virtuelles sont gérées par Chef, et leur installation se fait via notre . au cas où il serait nécessaire de mettre à jour l'application, consiste à mettre à jour le parc de serveurs de manière coordonnée et séquentielle à l'aide d'un pipeline CI. Cette méthode - bien qu'elle soit lente et un peu - garantit que GitLab.com applique les mêmes méthodes d'installation et de configuration que les utilisateurs des installations (autonomes) de GitLab, qui utilisent nos paquets Linux.
Nous utilisons cette méthode car il est d'une importance cruciale de ressentir toutes les joies et les peines que rencontrent les membres de la communauté lorsqu'ils installent et configurent leurs propres copies de GitLab. Cette approche a bien fonctionné pendant un certain temps, mais lorsque le nombre de projets sur GitLab a dépassé les 10 millions, nous avons réalisé qu'elle ne répondait plus à nos besoins en matière de mise à l'échelle et de déploiement.
Premiers pas vers Kubernetes et GitLab cloud-native
En 2017, le projet a été créé pour préparer GitLab à être déployé dans le cloud, ainsi que pour donner aux utilisateurs la possibilité d'installer GitLab dans des clusters Kubernetes. À l'époque, nous savions que le transfert de GitLab vers Kubernetes augmenterait la capacité de mise à l'échelle de la plateforme SaaS, simplifierait les déploiements et améliorerait l'efficacité de l'utilisation des ressources informatiques. En même temps, de nombreuses fonctions de notre application dépendaient de sections NFS montées, ce qui ralentissait la transition depuis des machines virtuelles.
L'aspiration à une approche cloud native et à Kubernetes a permis à nos ingénieurs de planifier une transition progressive, au cours de laquelle nous avons abandonné certaines dépendances de l'application vis-à-vis des stockages en réseau, tout en continuant à développer de nouvelles fonctionnalités. Depuis que nous avons commencé à planifier la migration à l'été 2019, de nombreuses restrictions ont été levées, et le processus de transfert de GitLab.com vers Kubernetes est maintenant en cours !
Caractéristiques de GitLab.com dans Kubernetes
Pour GitLab.com, nous utilisons un cluster GKE régional unique qui gère tout le trafic de l'application. Pour minimiser la complexité déjà assez complexe de la migration, nous nous concentrons sur les services qui ne dépendent pas de stockages locaux ou de NFS. GitLab.com utilise principalement une base de code monolithique sur Rails, et nous orientons le trafic en fonction des caractéristiques de la charge de travail vers différents points de terminaison, isolés dans leurs propres pools de nœuds.
Dans le cas du front-end, ces types se divisent en requêtes web, API, Git SSH/HTTPS et Registry. Pour le back-end, nous découpons les travaux dans les files d'attente selon diverses caractéristiques en fonction de , ce qui nous permet d'établir des objectifs de niveau de service (Service-Level Objectives, SLOs) pour différentes charges.
Tous ces services GitLab.com sont configurés à l'aide du Helm chart GitLab non modifié. La configuration se fait dans des sous-charts qui peuvent être activés sélectivement au fur et à mesure que nous transférons progressivement des services dans le cluster. Même si nous avons décidé de ne pas inclure dans la migration certains de nos services état, tels que Redis, Postgres, GitLab Pages et Gitaly, l'utilisation de Kubernetes permet de réduire radicalement le nombre de VM actuellement gérées par Chef.
Transparence et gestion des configurations Kubernetes
Tous les paramètres sont gérés par GitLab lui-même. Pour cela, trois projets de configuration basés sur Terraform et Helm sont utilisés. Nous essayons d'utiliser GitLab pour déployer GitLab autant que possible, mais pour les tâches opérationnelles, nous avons une installation séparée de GitLab. Cela est nécessaire pour ne pas dépendre de la disponibilité de GitLab.com lors des déploiements et mises à jour de GitLab.com.
Bien que nos pipelines pour le cluster Kubernetes fonctionnent sur une installation séparée de GitLab, les dépôts de code ont des miroirs, accessibles publiquement aux adresses suivantes :
- — enveloppe de configuration GitLab.com pour le Helm chart de GitLab ;
- — contient des configurations pour des services qui ne sont pas liés directement à l'application GitLab. Cela inclut des configurations pour la gestion des logs et la surveillance du cluster, ainsi que pour des outils intégrés comme PlantUML ;
- — configuration Terraform pour Kubernetes et l'ancienne infrastructure VM (legacy). Ici, toutes les ressources nécessaires au déploiement du cluster sont configurées, y compris le cluster lui-même, les pools de nœuds, les comptes de service, et la réservation d'adresses IP.

Lors de modifications, un résumé public est affiché Pour les SRE, le lien mène à un diff détaillé dans l'installation de GitLab, qui est utilisée pour les opérations et à laquelle l'accès est restreint. Cela permet aux employés et à la communauté sans accès au projet opérationnel (qui n'est ouvert qu'aux SRE) de consulter les modifications proposées dans la configuration. En combinant une instance publique de GitLab pour le code avec une instance fermée pour les pipelines CI, nous préservons un flux de travail unique tout en garantissant une indépendance par rapport à GitLab.com lors des mises à jour de configuration.
Ce que nous avons appris pendant la migration
Au cours de la migration, de l'expérience a été acquise, que nous appliquons aux nouvelles migrations et déploiements dans Kubernetes.
1. Augmentation des coûts en raison du trafic entre les zones de disponibilité
Statistiques quotidiennes de l'egress (octets par jour) pour la flotte de dépôts Git sur GitLab.com
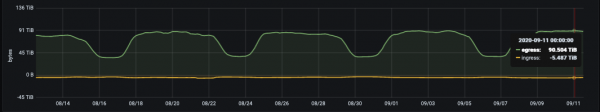
Statistiques quotidiennes d'egress (octets par jour) pour le parc de dépôts Git sur GitLab.com
Google divise son réseau en régions. Celles-ci sont ensuite subdivisées en zones de disponibilité (AZ). L'hébergement Git est associé à de grands volumes de données, il est donc crucial de maîtriser l'egress réseau. En ce qui concerne le trafic interne, l'egress est gratuit uniquement s'il reste à l'intérieur d'une même zone de disponibilité. Au moment de la rédaction de cet article, nous transférons environ 100 To de données en journée normale (et cela ne concerne que les dépôts Git). Les services qui, dans notre ancienne topologie basée sur des VM, étaient sur les mêmes machines virtuelles, fonctionnent désormais dans différents pods Kubernetes. Cela signifie qu'une partie du trafic, qui auparavant était locale aux VM, peut potentiellement sortir des zones de disponibilité.
Les clusters régionaux GKE permettent de couvrir plusieurs zones de disponibilité pour la redondance. Nous envisageons la possibilité pour les services générant de gros volumes de trafic. Cela permettra de réduire les coûts d'egress tout en maintenant la redondance au niveau du cluster.
2. Limites, requêtes de ressources et mise à l'échelle
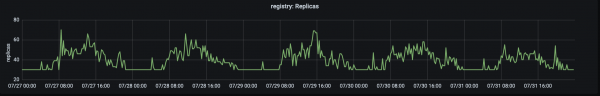
Nombre de répliques traitant le trafic de production sur registry.gitlab.com. Le trafic atteint son pic vers ~15h00 UTC.
Notre histoire de migration a commencé en août 2019, lorsque nous avons déplacé notre premier service — le registre de conteneurs GitLab (GitLab Container Registry) — vers Kubernetes. Ce service critique, soumis à un trafic élevé, était bien adapté pour cette première migration, car il s'agit d'une application sans état avec peu de dépendances externes. Le premier problème auquel nous avons été confrontés a été le grand nombre de pods expulsés en raison d'un manque de mémoire sur les nœuds. Cela nous a contraints à modifier les requêtes et les limites.
Il a été découvert que, pour une application dont la consommation de mémoire augmente avec le temps, des valeurs faibles pour les requêtes (réservant de la mémoire pour chaque pod) combinées à une limite « généreuse » sur l'utilisation entraînaient une saturation (saturation) des nœuds et un taux élevé d'expulsions. Pour remédier à ce problème, il a été . Cela a réduit la pression sur les nœuds et a assuré un cycle de vie des pods qui n'exerçait pas une pression trop élevée sur le nœud. Nous commençons maintenant les migrations avec des valeurs de demandes et de limites généreuses (et presque identiques), que nous ajustons si nécessaire.
3. Métriques et journaux
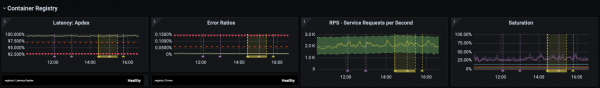
Le département des infrastructures se concentre sur les latences, le taux d'erreurs et la saturation par rapport aux (SLO), liés à .
Au cours de l'année écoulée, l'un des événements clés dans le département des infrastructures a été des améliorations dans le suivi et la gestion des SLO. Les SLO nous ont permis de définir des objectifs pour des services spécifiques, que nous avons surveillés de près pendant la migration. Mais même avec une visibilité améliorée, il n'est pas toujours possible de voir immédiatement les problèmes en utilisant les métriques et les alertes. Par exemple, en nous concentrant sur les latences et le taux d'erreurs, nous ne couvrons pas complètement tous les scénarios d'utilisation du service en migration.
Ce problème a été détecté presque immédiatement après le transfert d'une partie des charges de travail vers le cluster. Il s'est particulièrement manifesté lors de la vérification de fonctionnalités dont le nombre de requêtes est faible, mais qui ont des dépendances de configuration très spécifiques. L'une des leçons clés tirées de la migration a été la nécessité de prendre en compte non seulement les métriques lors de la surveillance, mais également les journaux et le « long tail » (il s'agit de sur le graphique - note du trad.) d'erreurs. Maintenant, pour chaque migration, nous incluons une liste détaillée des requêtes aux journaux (log queries) et prévoyons des procédures de rollback claires, pouvant être transmises d'une équipe à l'autre en cas de problèmes.
Le service parallèle des mêmes requêtes sur l'ancienne infrastructure VM et la nouvelle, basée sur Kubernetes, représentait un défi unique. Contrairement à la migration de type lift-and-shift (transfert rapide d'applications « telles quelles » vers la nouvelle infrastructure ; pour en savoir plus, par exemple, — n.d.t.), le travail parallèle sur les « anciennes » VM et Kubernetes nécessite que les outils de surveillance soient compatibles avec les deux environnements et puissent agréger les métriques en une seule vue. Il est important que nous utilisions les mêmes tableaux de bord et les mêmes requêtes de journaux afin d'obtenir une observabilité cohérente pendant la période de transition.
4. Changement de trafic vers le nouveau cluster
Pour GitLab.com, une partie des serveurs est dédiée à . Le parc canari sert nos projets internes, mais peut également . Mais il est avant tout destiné à tester les modifications apportées à l'infrastructure et à l'application. Le premier service migré a commencé par recevoir un volume limité de trafic interne, et nous continuons d'utiliser cette méthode pour assurer le respect des SLO avant de diriger tout le trafic vers le cluster.
Dans le cas de la migration, cela signifie que les requêtes pour les projets internes sont d'abord dirigées vers Kubernetes, puis nous transférons progressivement le reste du trafic vers le cluster en ajustant le poids pour le backend via HAProxy. Au cours de la transition des VM vers Kubernetes, il est devenu évident qu'il est très avantageux d'avoir une méthode simple pour rediriger le trafic entre l'ancienne et la nouvelle infrastructure et, par conséquent, de garder l'ancienne infrastructure prête à être réactivée dans les premiers jours après la migration.
5. Capacités de secours des pods et leur utilisation
Presque immédiatement, le problème suivant a été identifié : les pods pour le service Registry démaraient rapidement, mais le démarrage des pods pour Sidekiq prenait jusqu'à . Le démarrage prolongé des pods pour Sidekiq est devenu un problème lorsque nous avons commencé la migration des charges de travail vers Kubernetes pour les workers qui doivent traiter rapidement les jobs et se mettre à l'échelle rapidement.
Dans ce cas, la leçon était que, bien que le Horizontal Pod Autoscaler (HPA) dans Kubernetes gère bien l'augmentation du trafic, il est important de prendre en compte les caractéristiques des charges de travail et de prévoir des capacités de secours pour les pods (surtout en cas de demande inégale). Dans notre cas, nous avons observé une brusque augmentation des jobs, entraînant une mise à l'échelle rapide, ce qui a conduit à saturer les ressources CPU avant que nous puissions redimensionner le pool de nœuds.
Il y a toujours la tentation de maximiser l'utilisation du cluster, mais après avoir rencontré des problèmes de performance, nous commençons avec un budget pod généreux et le réduisons ensuite, surveillant de près le SLO. Le lancement des pods pour le service Sidekiq s'est considérablement accéléré et prend désormais en moyenne environ 40 secondes. en ont bénéficié tant GitLab.com que nos utilisateurs des installations self-managed utilisant le chart Helm officiel de GitLab.
Conclusion
Après avoir migré chaque service, nous avons apprécié les avantages de l'utilisation de Kubernetes en production : un déploiement d'application plus rapide et plus sûr, une scalabilité accrue et une répartition des ressources plus efficace. Les avantages de la migration vont même au-delà du service GitLab.com. Chaque amélioration du chart Helm officiel en bénéficie également à ses utilisateurs.
J'espère que vous avez aimé l'histoire de nos aventures dans la migration vers Kubernetes. Nous continuons à transférer de nouveaux services dans le cluster. Vous pouvez trouver plus d'informations dans les publications suivantes :
- «»;
- «»;
- .
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish