

Les jours où l'on pouvait ignorer l'optimisation des performances des bases de données sont révolus. Le temps ne s'arrête pas. Chaque nouvel entrepreneur du secteur technologique souhaite créer le prochain Facebook, cherchant à collecter toutes les données à sa portée. Ces données sont nécessaires aux entreprises pour former des modèles de meilleure qualité, qui aident à générer des revenus. Dans de telles conditions, les programmeurs doivent créer des API qui permettent de travailler rapidement et efficacement avec d'énormes volumes d'informations.
Si vous concevez des parties serveur d'applications ou des bases de données depuis un certain temps, vous avez probablement écrit du code pour exécuter des requêtes avec pagination. Par exemple, comme ceci :
SELECT * FROM table_name LIMIT 10 OFFSET 40
Est-ce bien le cas ?
Mais si vous avez effectué la pagination de cette manière, je dois vous signaler avec regret que vous ne l'avez pas fait de manière très efficace.
Voulez-vous me contredire ? . , et applique déjà des techniques que je souhaite vous présenter aujourd'hui.
Nommez un développeur de backend qui n'a jamais utilisé OFFSET et LIMIT pour exécuter des requêtes avec pagination. Dans un MVP (produit minimum viable) et dans des projets où de petites quantités de données sont utilisées, cette approche est tout à fait applicable. Elle fonctionne, pour ainsi dire, simplement.
Mais si vous devez créer des systèmes fiables et efficaces à partir de zéro, il est nécessaire de se soucier de l'efficacité des requêtes aux bases de données utilisées dans ces systèmes.
Aujourd'hui, nous allons parler des problèmes liés aux implémentations largement utilisées (dommage que ce soit le cas) des mécanismes d'exécution des requêtes avec pagination, et de la manière d'atteindre de hautes performances lors de l'exécution de telles requêtes.
Qu'est-ce qui ne va pas avec OFFSET et LIMIT ?
Comme déjà mentionné, OFFSET et LIMIT ils fonctionnent bien dans des projets où il n'est pas nécessaire de traiter de gros volumes de données.
Le problème survient lorsque la base de données s'agrandit au point de ne plus tenir en mémoire serveur. Cependant, il est nécessaire d'utiliser des requêtes avec pagination lors du travail avec cette base de données.
Pour que ce problème se manifeste, il faut qu'il y ait une situation où la SGBD recourt à une opération inefficace de scan complet de la table (Full Table Scan) lors de l'exécution de chaque requête avec pagination (pendant ce temps, des opérations d'insertion et de suppression de données peuvent se produire, et nous n'avons pas besoin des données obsolètes !).
Qu'est-ce qu'un "scan complet de table" (ou "scan séquentiel de table", Sequential Scan) ? C'est une opération au cours de laquelle la SGBD lit séquentiellement chaque ligne de la table, c'est-à-dire les données qu'elle contient, et vérifie leur conformité à la condition donnée. On sait que ce type de scan de tables est le plus lent. En effet, lors de son exécution, il y a beaucoup d'opérations d'entrée/sortie impliquant le système de disque du serveur. La situation est aggravée par les temps d'attente liés à la manipulation des données stockées sur les disques, et le fait que le transfert de données du disque vers la mémoire est une opération gourmande en ressources.
Par exemple, vous avez des enregistrements sur 100000000 d'utilisateurs, et vous exécutez une requête avec la structure OFFSET 50000000. Cela signifie que la SGBD devra charger tous ces enregistrements (qui ne nous sont même pas nécessaires !), les placer en mémoire, et ensuite prendre, supposons, 20 résultats, comme mentionné dans LIMIT.
Disons que cela pourrait ressembler à ceci : "sélectionner les lignes de 50000 à 50020 sur 100000". Autrement dit, le système pour exécuter la requête devra d'abord charger 50000 lignes. Vous voyez combien de travail inutile il devra faire ?
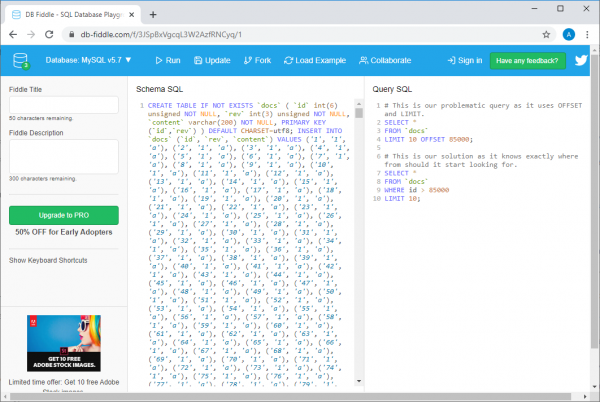
Si vous ne me croyez pas, regardez l'exemple que j'ai créé en utilisant les capacités de .
Exemple sur db-fiddle.com
Là, à gauche, dans le champ Schéma SQL, il y a un code qui insère 100000 lignes dans la base de données, et à droite, dans le champ Requête SQL, deux requêtes sont montrées. La première, lente, ressemble à ceci :
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
Et la seconde, qui représente une solution efficace au même problème, est :
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Pour exécuter ces requêtes, il suffit d'appuyer sur le bouton Exécution en haut de la page. En faisant cela, nous comparerons les informations sur le temps d'exécution des requêtes. Il s'avère qu'une requête inefficace nécessite au minimum 30 fois plus de temps qu'une autre (d'un exécution à l'autre, ce temps varie, par exemple, le système peut indiquer que la première requête a pris 37 ms, alors que la seconde a pris 1 ms).
Et si les données augmentent, cela ne fera qu'empirer (pour vous en convaincre, regardez mon avec 10 millions de lignes).
Ce que nous venons de discuter devrait vous donner une certaine compréhension de la manière dont les requêtes sont réellement traitées dans les bases de données.
Gardez à l'esprit que plus la valeur est élevée, OFFSET plus le temps d'exécution de la requête sera long.
Que vaut-il mieux utiliser à la place de la combinaison OFFSET et LIMIT?
Au lieu de la combinaison, OFFSET et LIMIT il vaut mieux utiliser une structure construite comme suit :
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Ceci est l'exécution d'une requête paginée basée sur le curseur.
Au lieu de stocker localement les courants OFFSET et LIMIT et de les transmettre avec chaque requête, il faut conserver la dernière clé primaire obtenue (généralement, c'est IDDeep Speech LIMIT, ce qui aboutira à des requêtes ressemblant à celle ci-dessus.
Pourquoi? La raison est que, en indiquant explicitement l'identifiant de la dernière ligne lue, vous indiquez à votre SGBD où commencer la recherche des données nécessaires. De plus, la recherche sera effectuée efficacement grâce à l'utilisation de la clé, le système n'aura pas à se concentrer sur les lignes en dehors de la plage spécifiée.
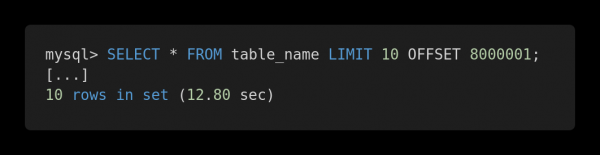
Jetons un œil à la comparaison suivante des performances de différentes requêtes. Voici une requête inefficace.
Requête lente
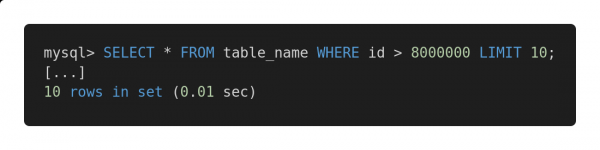
Et voici la version optimisée de cette requête.
Requête rapide
Les deux requêtes renvoient exactement le même volume de données. Mais la première prend 12,80 secondes, alors que la seconde ne prend que 0,01 seconde. Ressentez-vous la différence?
Problèmes possibles
Pour assurer le bon fonctionnement de la méthode de requête proposée, il est nécessaire que la table contienne une colonne (ou des colonnes) avec des index uniques et séquentiels, tels qu'un identifiant numérique. Dans certains cas spécifiques, cela peut déterminer le succès de l'utilisation de telles requêtes pour améliorer la rapidité de l'accès à la base de données.
Évidemment, lors de la construction des requêtes, il faut tenir compte des spécificités de l'architecture des tables et choisir les mécanismes qui fonctionneront le mieux avec les tables existantes. Par exemple, si vous devez traiter de grandes quantités de données liées dans les requêtes, vous pourriez trouver cet article intéressant. article.
Si nous faisons face à l'absence de clé primaire, par exemple si nous avons une table avec une relation « plusieurs-à-plusieurs », alors une approche traditionnelle impliquant l'utilisation OFFSET et LIMIT, nous conviendra certainement. Cependant, son utilisation peut entraîner l'exécution de requêtes potentiellement lentes. Dans de tels cas, je recommanderais d'utiliser une clé primaire avec auto-incrément, même si elle est nécessaire uniquement pour organiser l'exécution de requêtes paginées.
Si ce sujet vous intéresse — , et — quelques ressources utiles.
Résultats
La principale conclusion que nous pouvons tirer est que, quelle que soit la taille des bases de données, il est toujours nécessaire d'analyser la vitesse d'exécution des requêtes. De nos jours, l'évolutivité des solutions est extrêmement importante, et si, dès le début du développement d'un système, tout est bien conçu, cela peut à l'avenir éviter à un développeur de nombreux problèmes.
Comment analysez-vous et optimisez-vous les requêtes aux bases de données?
Source : habr.com
