

Salut, Habr !
Nous rappelons qu'après le livre sur nous avons publié un ouvrage tout aussi intéressant sur la bibliothèque .
Alors que la communauté commence à explorer les limites de cette puissante outil. Récemment, un article est paru, dont nous souhaitons vous présenter la traduction. L'auteur partage son expérience sur la manière de transformer Kafka Streams en un stockage de données distribué. Bonne lecture !
La bibliothèque Apache est utilisée dans le monde entier dans les entreprises pour le traitement de flux distribué au-dessus d'Apache Kafka. Un des aspects souvent sous-estimés de ce cadre est qu'il permet de conserver un état local généré à partir du traitement de flux.
Dans cet article, je vais expliquer comment notre entreprise a pu tirer parti de cette fonctionnalité lors du développement d'un produit pour la sécurité des applications en cloud. Grâce à Kafka Streams, nous avons créé des microservices avec état partagé, chacun d'eux servant de source d'informations fiable sur l'état des objets dans le système. Pour nous, c'est un pas en avant tant en termes de fiabilité que de facilité de support.
Si vous êtes intéressé par une approche alternative, permettant d'utiliser une base de données centrale pour gérer l'état formel de vos objets – lisez, cela vaudra le détour…
Pourquoi avons-nous jugé qu'il était temps de changer nos méthodes de travail avec l'état partagé
Nous devions maintenir l'état de divers objets, en nous appuyant sur les rapports des agents (par exemple : le site a-t-il été attaqué ?). Avant notre passage à Kafka Streams, nous comptions souvent sur une seule base de données centrale (+ API de service) pour gérer l'état. Cette approche a ses inconvénients : dans le maintien de la cohérence et de la synchronisation devient un véritable défi. La base de données peut devenir un goulet d'étranglement, ou se retrouver dans un et souffrir de l'imprévisibilité.
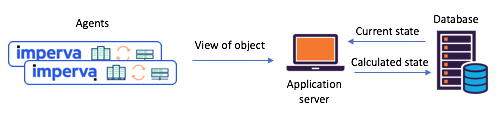
Illustration 1 : un scénario typique de séparation d'état, rencontré avant le passage à
Kafka et Kafka Streams : les agents communiquent leurs représentations via l'API, l'état mis à jour est calculé à partir de la base de données centrale.
Faites connaissance avec Kafka Streams – il est désormais facile de créer des microservices avec un état partagé.
Il y a environ un an, nous avons décidé de revoir en profondeur nos scénarios de travail avec l'état partagé afin de résoudre certains problèmes. Nous avons immédiatement décidé d'essayer Kafka Streams - il est bien connu pour sa scalabilité, sa haute disponibilité et sa résilience, ainsi que pour la richesse de ses fonctionnalités de streaming (y compris les transformations avec conservation de l'état). C'était exactement ce dont nous avions besoin, sans parler de la maturité et de la fiabilité du système de messagerie développé autour de Kafka.
Chacun des microservices que nous avons créé avec conservation de l'état était basé sur une instance de Kafka Streams avec une topologie assez simple. Elle se composait de 1) une source 2) un processeur avec un stockage persistant de clés et de valeurs 3) un flux :
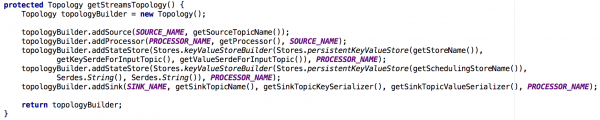
Illustration 2 : la topologie par défaut de nos instances de streaming pour des microservices avec conservation de l'état. Notez qu'il y a également un stockage contenant des métadonnées sur la planification.
Avec cette nouvelle approche, les agents composent des messages envoyés dans le topic source, tandis que les consommateurs - disons, le service d'avis par e-mail - reçoivent l'état partagé calculé via le flux (topic de sortie).
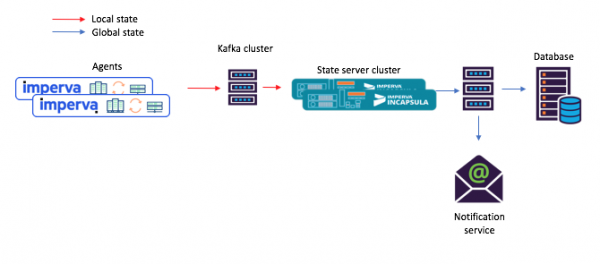
Illustration 3 : un nouvel exemple de flux de tâches pour un scénario avec des microservices partagés : 1) un agent génère un message qui entre dans le topic Kafka source ; 2) le microservice avec état partagé (utilisant Kafka Streams) le traite et enregistre l'état calculé dans le topic Kafka de sortie ; ensuite 3) les consommateurs reçoivent le nouvel état.
Eh bien, ce stockage intégré de clés et de valeurs est vraiment très utile !
Comme mentionné précédemment, notre topologie avec état partagé contient un stockage de clés et de valeurs. Nous avons trouvé plusieurs façons de l'utiliser, et deux d'entre elles sont décrites ci-dessous.
Option #1 : utilisation du stockage de clés et de valeurs lors de calculs.
Notre premier entrepôt de clés et de valeurs contenait des données auxiliaires nécessaires à nos calculs. Par exemple, dans certains cas, l'état partagé était déterminé selon le principe de la « majorité des voix ». Dans l'entrepôt, nous pouvions conserver tous les derniers rapports des agents concernant l'état d'un certain objet. Ensuite, en recevant un nouveau rapport d'un agent, nous pouvions le sauvegarder, extraire de l'entrepôt les rapports de tous les autres agents sur le même objet et répéter le calcul.
L'illustration 4 ci-dessous montre comment nous avons ouvert l'accès à l'entrepôt de clés et de valeurs pour la méthode de traitement du processeur, afin de pouvoir ensuite traiter un nouveau message.
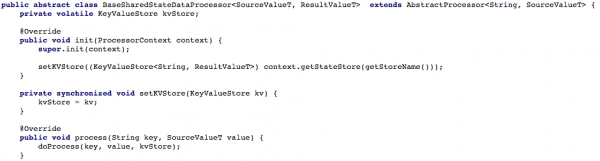
Illustration 4 : ouverture de l'accès à l'entrepôt de clés et de valeurs pour la méthode de traitement du processeur (après cela, dans chaque scénario travaillant avec un état partagé, il est nécessaire d'implémenter la méthode doProcess)
Option #2 : création d'une API CRUD au-dessus de Kafka Streams
Après avoir configuré notre flux de tâches de base, nous avons essayé d'écrire une API RESTful CRUD pour nos microservices avec un état partagé. Nous souhaitions pouvoir extraire l'état de certains ou de tous les objets, ainsi que définir ou supprimer l'état d'un objet (ce qui est utile pour le support côté serveur).
Pour supporter toutes les API de récupération d'état, chaque fois que nous devions recalculer l'état lors du traitement, nous le stockions durablement dans l'entrepôt de clés et de valeurs intégré. Dans ce cas, il est assez simple d'implémenter une telle API à l'aide d'une seule instance de Kafka Streams, comme montré dans le listing ci-dessous :
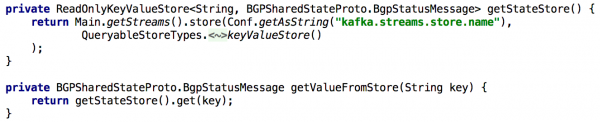
Illustration 5 : utilisation de l'entrepôt de clés et de valeurs intégré pour obtenir l'état pré-calculé d'un objet
La mise à jour de l'état d'un objet via l'API est également facile à réaliser. En principe, il suffit de créer un producteur Kafka, puis d'effectuer une écriture contenant le nouvel état. Cela garantit que tous les messages générés via l'API seront traités exactement de la même manière que ceux provenant d'autres producteurs (par exemple, des agents).
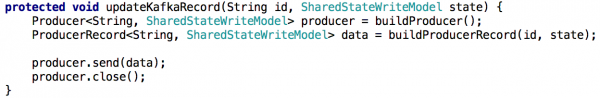
Illustration 6 : l'état d'un objet peut être défini à l'aide d'un producteur Kafka
Une petite complication : Kafka a de nombreuses partitions
Ensuite, nous souhaitions répartir la charge liée au traitement et améliorer la disponibilité en fournissant un cluster de microservices avec un état partagé pour chaque scénario. La configuration s'est avérée très simple : après avoir configuré toutes les instances pour qu'elles fonctionnent avec le même ID d'application (et avec les mêmes serveurs de démarrage), presque tout le reste s'est fait automatiquement. Nous avons également défini que chaque topic source serait composé de plusieurs partitions, afin qu'à chaque instance puisse être attribué un sous-ensemble de ces partitions.
Je mentionnerai également qu'il est courant ici de faire une sauvegarde de l'état, afin que, par exemple, en cas de restauration après une panne, cette sauvegarde puisse être transférée vers une autre instance. Pour chaque stockage d'état dans Kafka Streams, un topic réplicable avec un journal des modifications est créé (dans lequel les mises à jour locales sont suivies). Ainsi, Kafka préserve constamment le stockage d'état. Par conséquent, en cas de défaillance d'une instance, le stockage d'état de Kafka Streams peut être rapidement restauré sur une autre instance, où les partitions correspondantes seront transférées. Nos tests ont montré que cela se fait en quelques secondes, même si des millions d'enregistrements se trouvent dans le stockage.
Passer d'un microservice avec un état partagé à un cluster de microservices rend la mise en œuvre de l'API Get State moins triviale. Dans cette nouvelle situation, le stockage d'état de chaque microservice ne contient qu'une partie du tableau global (les objets dont les clés correspondaient à une partition spécifique). Il a donc fallu déterminer sur quelle instance se trouvait l'état de l'objet dont nous avions besoin, et nous avons fait cela sur la base des métadonnées des flux, comme indiqué ci-dessous :
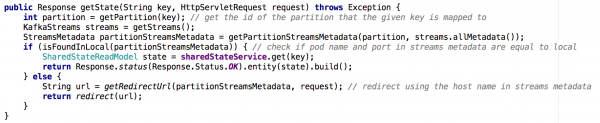
Illustration 7 : Grâce aux métadonnées des flux, nous déterminons de quelle instance demander l'état de l'objet requis ; une approche similaire a été appliquée avec l'API GET ALL.
Principales conclusions
Les stockages d'état dans Kafka Streams peuvent de fait servir de base de données distribuée,
- constamment répliquée dans Kafka.
- Au-dessus de ce système, il est facile de mettre en place une API CRUD.
- Le traitement de plusieurs partitions devient un peu plus complexe.
- Il est également possible d'ajouter un ou plusieurs magasins d'état à la topologie de flux pour stocker des données auxiliaires. Cette option peut être utilisée pour :
- Un stockage à long terme des données nécessaires pour les calculs lors du traitement en continu
- Un stockage à long terme des données qui peuvent être utiles lors de la prochaine initialisation d'une instance de flux
- bien d'autres…
Grâce à ces avantages et d'autres, Kafka Streams est parfaitement adapté au support de l'état global dans un système distribué tel que le nôtre. Kafka Streams s'est révélé très fiable en production (depuis son déploiement, nous avons pratiquement perdu aucun message), et nous sommes convaincus que ses capacités ne s'arrêtent pas là !
Source : habr.com
