

Préface
Il est assez fréquent que les utilisateurs, les développeurs et les administrateurs de bases de données MS SQL Server rencontrent des problèmes de performance des bases de données ou du SGBD dans son ensemble, d'où l'importance du suivi de MS SQL Server.
Cet article complète l'article et examinera certains aspects du suivi de MS SQL Server, en particulier : comment identifier rapidement les ressources manquantes, ainsi que des recommandations pour la configuration des flags de traçage.
Pour faire fonctionner les scripts suivants, il est nécessaire de créer le schéma inf dans la base de données cible comme suit :
Création du schéma inf
use ;
go
create schema inf;
Méthode pour identifier le manque de mémoire vive
Le premier indicateur du manque de mémoire vive est lorsque l'instance de MS SQL Server utilise toute la RAM qui lui a été allouée.
Pour cela, créons la vue suivante inf.vRAM :
Création de la vue inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						-- combien de RAM est disponible sur le serveur en Mo
		 , a.[RAM_Avail_Percent]					-- pourcentage de RAM disponible sur le serveur
		 , a.[Server_physical_memory_Mb]				-- combien de RAM totale sur le serveur en Mo
		 , a.[SQL_server_committed_target_Mb]			-- combien de RAM est allouée à MS SQL Server en Mo
		 , a.[SQL_server_physical_memory_in_use_Mb] 		-- combien de RAM est actuellement utilisée par MS SQL Server en Mo
		 , a.[SQL_RAM_Avail_Percent]				-- pourcentage de RAM libre pour MS SQL Server par rapport à la RAM totale allouée pour MS SQL Server
		 , a.[StateMemorySQL]						-- est-ce qu'il y a suffisamment de RAM pour MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				-- pourcentage de RAM réservée pour MS SQL Server par rapport à la RAM totale du serveur
		 -- est-ce qu'il y a suffisamment de RAM pour le serveur
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Warning' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Danger' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Warning' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Alors, pour déterminer que l'instance de MS SQL Server consomme toute la mémoire qui lui est allouée, vous pouvez utiliser la requête suivante :
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Si la valeur de SQL_server_physical_memory_in_use_Mb est constamment inférieure ou égale à SQL_server_committed_target_Mb, il est nécessaire de vérifier les statistiques d'attente.
Pour déterminer le manque de mémoire vive à l'aide des statistiques d'attente, nous allons créer la vue inf.vWaits :
Création de la vue inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], -- nom du type d'attente
        [wait_time_ms] / 1000.0 AS [WaitS], -- Temps total d'attente pour ce type en millisecondes. Ce temps inclut signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS], -- Temps total d'attente pour ce type en millisecondes sans signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS], -- Différence entre le temps de signalisation du thread en attente et le temps de début de son exécution
        [waiting_tasks_count] AS [WaitCount], -- Nombre d'attentes pour ce type. Ce compteur s'incrémente chaque fois qu'une attente commence
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S], -- Temps total d'attente pour ce type en millisecondes. Ce temps inclut signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S], -- Temps total d'attente pour ce type en millisecondes sans signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S], -- Différence entre le temps de signalisation du thread en attente et le temps de début de son exécution
	    [W1].[WaitCount] AS [WaitCount], -- Nombre d'attentes pour ce type. Ce compteur s'incrémente chaque fois qu'une attente commence
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- seuil de pourcentage
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
Dans ce cas, il est possible de déterminer le manque de mémoire vive avec la requête suivante :
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  WHERE [WaitType] IN (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Il convient de prêter attention aux indicateurs Percentage et AvgWait_S. S'ils sont significatifs dans leur ensemble, il y a de fortes chances que la mémoire vive soit insuffisante pour l'instance de MS SQL Server. Les valeurs significatives sont déterminées individuellement pour chaque système. Cependant, on peut commencer avec le critère suivant : Percentage >= 1 et AvgWait_S >= 0.005.
Pour transmettre les indicateurs dans le système de surveillance (par exemple, Zabbix), on peut créer les deux requêtes suivantes :
- quel pourcentage occupent les types d'attente liés à la mémoire vive (somme de tous ces types d'attente) :
SELECT COALESCE(SUM([Percentage]), 0.00) AS [Percentage] FROM [inf].[vWaits] WHERE [WaitType] IN ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - quel montant en millisecondes occupent les types d'attente liés à la mémoire vive (valeur maximale de toutes les moyennes de latence pour tous ces types d'attente) :
SELECT COALESCE(MAX([AvgWait_S])*1000, 0.00) AS [AvgWait_MS]
FROM [inf].[vWaits]
       WHERE [WaitType] IN (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
En se basant sur la dynamique des valeurs obtenues pour ces deux indicateurs, on peut conclure si la mémoire vive est suffisante pour l'instance de MS SQL Server.
Méthode de détection d'une surcharge excessive sur le CPU
Pour identifier un manque de temps processeur, il suffit d'utiliser la vue système sys.dm_os_schedulers. Ici, si l'indicateur runnable_tasks_count est constamment supérieur à 1, il est très probable que le nombre de cœurs soit insuffisant pour l'instance de MS SQL Server.
Pour transmettre l'indicateur dans le système de surveillance (par exemple, Zabbix), on peut créer la requête suivante :
SELECT MAX([runnable_tasks_count]) AS [runnable_tasks_count]
FROM sys.dm_os_schedulers
WHERE scheduler_id < 255;
En se basant sur la dynamique des valeurs obtenues pour cet indicateur, on peut conclure si le temps processeur (nombre de cœurs du CPU) est suffisant pour l'instance de MS SQL Server.
Cependant, il est important de se rappeler que les requêtes peuvent demander plusieurs threads à la fois. Parfois, l'optimiseur ne parvient pas à évaluer correctement la complexité de la requête elle-même. Dans ce cas, trop de threads peuvent être alloués à la requête, ce qui ne peut pas être traité simultanément à ce moment-là. Cela provoque également un type d'attente lié au manque de temps processeur et à l'accroissement de la file d'attente des planificateurs utilisant des cœurs de CPU spécifiques, donc le nombre de runnable_tasks_count dans de telles conditions augmentera.
Dans ce cas, avant d'augmenter le nombre de cœurs CPU, il est nécessaire de configurer correctement les propriétés de parallélisme de l'instance MS SQL Server, et depuis la version 2016, il faut configurer correctement les propriétés de parallélisme des bases de données nécessaires :
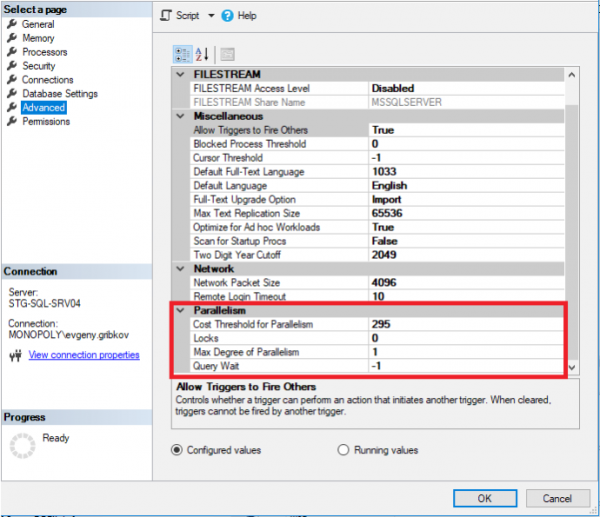
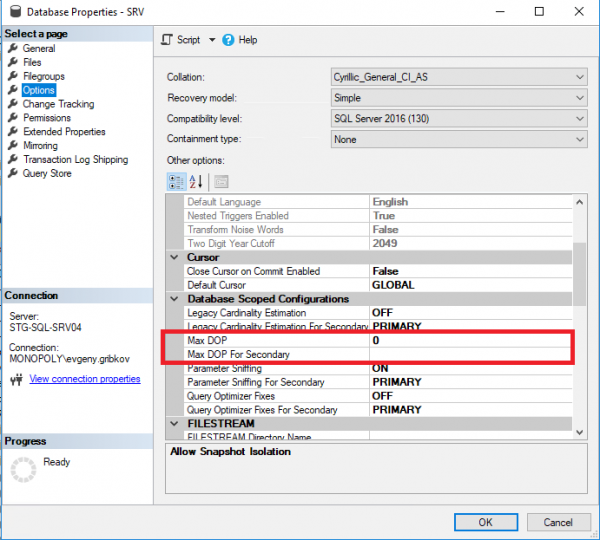
Il convient de prêter attention aux paramètres suivants :
- Max Degree of Parallelism - définit le nombre maximal de threads pouvant être alloués à chaque requête (par défaut, il est de 0 - la seule limite est celle du système d'exploitation et de l'édition de MS SQL Server)
- Cost Threshold for Parallelism - coût estimé pour le parallélisme (par défaut, il est de 5)
- Max DOP - définit le nombre maximal de threads pouvant être alloués à chaque requête au niveau de la base de données (mais pas plus que la valeur de la propriété « Max Degree of Parallelism ») (par défaut, il est de 0 - la seule limite est celle du système d'exploitation et de l'édition de MS SQL Server ainsi que la limite de la propriété « Max Degree of Parallelism » pour toute l'instance de MS SQL Server)
Il est impossible de donner une recette universelle pour tous les cas, c'est-à-dire qu'il faut analyser les requêtes lourdes.
D'après mon expérience, je recommande le processus suivant pour les systèmes OLTP pour configurer les propriétés de parallélisme :
- d'abord, interdire le parallélisme en définissant le Max Degree of Parallelism à 1 au niveau de toute l'instance
- analyser les requêtes les plus lourdes et choisir un nombre de threads optimal pour elles
- définir le Max Degree of Parallelism à la quantité optimale de threads obtenue à partir du point 2, ainsi que pour des bases de données spécifiques, définir la valeur Max DOP obtenue du point 2 pour chaque base de données
- analyser les requêtes les plus lourdes et identifier les effets négatifs du multi-threading. S'il y en a, augmenter le Cost Threshold for Parallelism.
Pour des systèmes comme 1C, Microsoft CRM et Microsoft NAV, il est dans la plupart des cas approprié d'interdire le multi-threading.
Si vous utilisez l'édition Standard, dans la plupart des cas, il est approprié d'interdire le parallélisme en raison du fait que cette édition est limitée en nombre de cœurs CPU.
L'algorithme décrit ci-dessus n'est pas adapté pour les systèmes OLAP.
D'après ma propre expérience, je recommande le suivi de l'algorithme suivant pour les systèmes OLAP en ce qui concerne les paramètres de parallélisme :
- analyser les requêtes les plus lourdes et choisir un nombre de threads optimal pour elles
- définir le Max Degree of Parallelism à un nombre optimal de threads, obtenu au point 1, et pour des bases de données spécifiques, définir une valeur Max DOP, également tirée du point 1 pour chaque base de données
- analyser les requêtes les plus lourdes et identifier l'effet négatif d'une limitation du parallélisme. S'il y en a, alors soit réduire la valeur du Cost Threshold for Parallelism, soit répéter les étapes 1-2 de cet algorithme
Ainsi, pour les systèmes OLTP, nous allons d'un traitement monothread à un traitement multithread, et pour les systèmes OLAP, nous faisons le contraire : nous allons d'un traitement multithread à un traitement monothread. Cela permet d'ajuster les paramètres de parallélisme tant pour une base de données spécifique que pour l'ensemble de l'instance MS SQL Server.
Il est également important de comprendre que les paramètres de parallélisme doivent être modifiés avec le temps, en fonction des résultats de la surveillance des performances de MS SQL Server.
Recommandations pour la configuration des drapeaux de traçage
D'après mon expérience et celle de mes collègues, pour un fonctionnement optimal, je recommande de définir au niveau du lancement du service MS SQL Server pour les versions 2008-2016 les drapeaux de traçage suivants :
- 610 — Réduction de la journalisation des insertions dans les tables indexées. Cela peut aider pour les insertions dans des tables avec un grand nombre d'enregistrements et de nombreuses transactions, lors d'attentes WRITELOG prolongées dues aux modifications des index.
- 1117 — Si un fichier dans un groupe de fichiers satisfait aux exigences de seuil d'augmentation automatique, tous les fichiers dans le groupe de fichiers sont augmentés.
- 1118 — Force tous les objets à être placés dans des extents différents (interdiction des extents mixtes), ce qui minimise la nécessité de parcourir la page SGAM, qui est utilisée pour suivre les extents mixtes.
- 1224 — Désactive l'agrégation des verrous sur la base du nombre de verrous. Toutefois, une utilisation de mémoire trop intensive peut entraîner l'activation de l'agrégation des verrous.
- 2371 — Change the fixed automatic statistics update threshold to the dynamic automatic statistics update threshold. Important for updating query plans regarding large tables, where an incorrect estimate of the number of rows leads to erroneous execution plans.
- 3226 — Suppresses successful backup execution messages in the error log.
- 4199 — Enables changes in the query optimizer released in cumulative updates and SQL Server update packages.
- 6532-6534 — Enables performance improvements for query operations with spatial data types.
- 8048 — Converts memory objects partitioned by NUMA to be partitioned by CPUs.
- 8780 — Provides additional time allocation for query plan compilation. Some queries without this flag may be rejected as they lack a query plan (very rare error).
- 8780 — 9389 — Enables additional dynamically allocated memory buffer for batch operators, allowing the batch operator to request extra memory and avoid spilling data to tempdb, if additional memory is available.
It is also useful to enable tracing flag 2301, which enhances optimization for advanced decision-making support and thus assists in selecting more accurate query plans. However, starting from version 2016, it often negatively impacts the overall execution time of queries.
For systems with many indexes (for example, for 1C databases), I also recommend enabling tracing flag 2330, which disables index usage statistics collection, positively impacting the overall system performance.
More detailed information about tracing flags can be found
At the link above, it is also important to consider the versions and builds of MS SQL Server, as for newer versions, some tracing flags are enabled by default or have no effect.
Tracing flags can be enabled and disabled using the DBCC TRACEON and DBCC TRACEOFF commands, respectively. For more details, see
The status of tracing flags can be retrieved using the DBCC TRACESTATUS command:
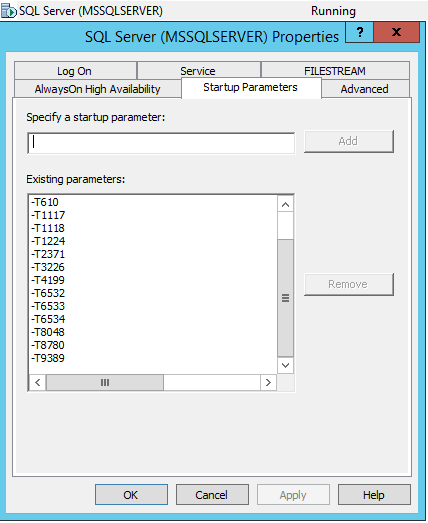
Pour que les indicateurs de suivi soient activés au démarrage du service MS SQL Server, il est nécessaire d'ouvrir le Gestionnaire de configuration SQL Server et d'ajouter ces indicateurs de suivi dans les propriétés du service via -T:
Résultats
Cet article examine certains aspects de la surveillance de MS SQL Server, qui permettent de détecter rapidement un manque de RAM et de temps CPU libre, ainsi qu'une série d'autres problèmes moins évidents. Les indicateurs de suivi les plus couramment utilisés ont été abordés.
Sources :
»
»
»
»
»
»
»
Source : habr.com
