

LINQ a été intégré à .NET comme un nouveau langage puissant de manipulation des données. LINQ to SQL, en tant que partie de celui-ci, permet une interaction relativement facile avec les bases de données en utilisant, par exemple, Entity Framework. Cependant, en l'utilisant fréquemment, les développeurs oublient souvent de vérifier quelle requête SQL le fournisseur queryable générera, dans votre cas — Entity Framework.
Examinons deux points principaux à l'aide d'un exemple.
Pour cela, dans SQL Server, créons une base de données Test, et dans celle-ci, créons deux tables avec la requête suivante :
Création des tables
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Nous allons maintenant remplir la table Ref en exécutant le script suivant :
Remplissage de la table Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
De la même manière, remplissons la table Customer avec le script suivant :
Remplissage de la table Customer
UTILISER [TEST]
GO

DÉCLARER @ind INT=1;
DÉCLARER @ind_ref INT=1;

ALORS(@ind<=12000000)
DÉBUT
	SI(@ind%3=0) SET @ind_ref=1;
	SINON SI (@ind%5=0) SET @ind_ref=2;
	SINON SI (@ind%7=0) SET @ind_ref=3;
	SINON SI (@ind=0) SET @ind_ref=4;
	SINON SI (@ind=0) SET @ind_ref=5;
	SINON SI (@ind=0) SET @ind_ref=6;
	SINON SI (@ind=0) SET @ind_ref=7;
	SINON SI (@ind=0) SET @ind_ref=8;
	SINON SI (@ind=0) SET @ind_ref=9;
	SINON SI (@ind=0) SET @ind_ref=10;
	SINON SI (@ind=0) SET @ind_ref=11;
	SINON SET @ind_ref=@ind90000;

	INSÉRER DANS [dbo].[Client]
	 ([ID]
	 ,[Nom]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SÉLECTIONNER
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	RÉGLER @ind=@ind+1;
FIN
GO
Ainsi, nous avons obtenu deux tables, dont l'une contient plus d'un million de lignes de données, et l'autre plus de 10 millions de lignes de données.
Maintenant, dans Visual Studio, il est nécessaire de créer un projet de test Visual C# Console App (.NET Framework) :
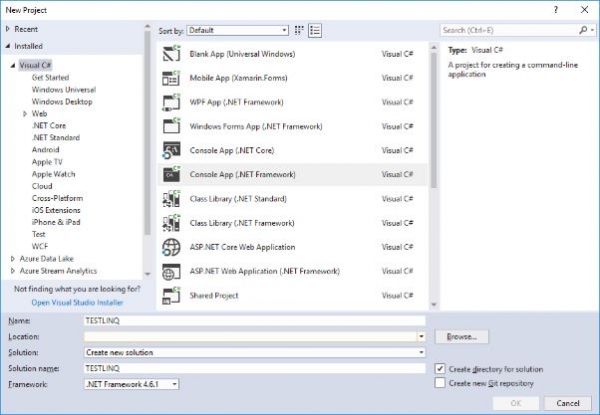
Ensuite, il est nécessaire d'ajouter une bibliothèque pour Entity Framework afin d'interagir avec la base de données.
Pour l'ajouter, faisons un clic droit sur le projet et sélectionnons "Gérer les packages NuGet" dans le menu contextuel :
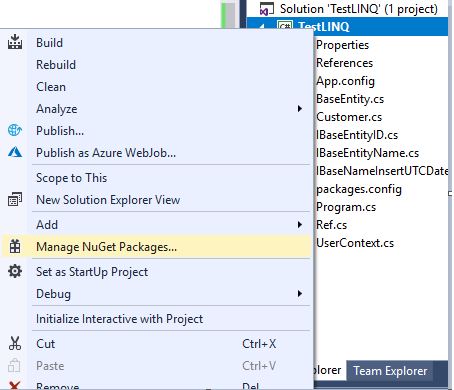
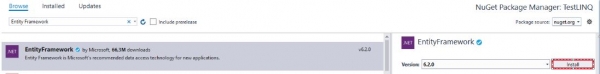
Ensuite, dans la fenêtre de gestion des packages NuGet qui apparaît, saisissons le mot « Entity Framework » dans la barre de recherche, choisissons le paquet Entity Framework et installons-le :
Puis, dans le fichier App.config, après la fermeture de l'élément configSections, nous devons ajouter le bloc suivant :
Dans le connectionString, il faut écrire la chaîne de connexion.
Maintenant créons 3 interfaces dans des fichiers séparés :
- Implémentation de l'interface IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implémentation de l'interface IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implémentation de l'interface IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Et dans un fichier séparé, nous créerons la classe de base BaseEntity pour nos deux entités, qui contiendra des champs communs :
Implémentation de la classe de base BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Ensuite, dans des fichiers séparés, créons nos deux entités :
- Implémentation de la classe Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implémentation de la classe Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Maintenant, créons un fichier séparé pour le contexte UserContext :
Implémentation de la classe UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
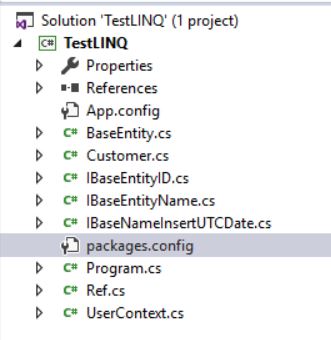
Nous avons obtenu une solution prête à être testée pour l'optimisation avec LINQ to SQL via EF pour MS SQL Server :
Maintenant, dans le fichier Program.cs, écrivons le code suivant :
Fichier Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Ensuite, nous allons lancer notre projet.
À la fin de l'exécution, la console affichera :
Requête SQL générée
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
C'est-à-dire, dans l'ensemble, la requête LINQ a généré une requête SQL pour la base de données MS SQL Server qui est plutôt bonne.
Maintenant, changeons la condition ET en OU dans la requête LINQ :
requête LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Et relançons notre application.
L'exécution échouera avec une erreur liée au dépassement du temps d'exécution de la commande de 30 secondes :
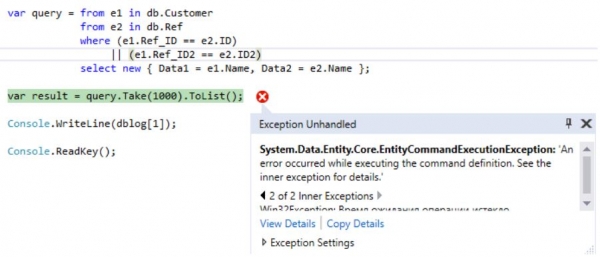
Si nous regardons quelle requête a été générée par LINQ,
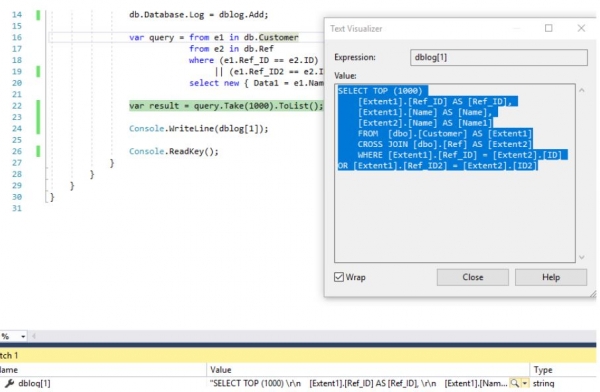
, nous pouvons constater que la sélection se fait par produit cartésien de deux ensembles (tables) :
Requête SQL générée
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Réécrivons la requête LINQ comme suit :
Requête LINQ optimisée
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Nous obtiendrons alors la requête SQL suivante :
requête SQL
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Malheureusement, dans les requêtes LINQ, il ne peut y avoir qu'une seule condition de jointure, c'est pourquoi il est possible de faire une requête équivalente à travers deux requêtes pour chaque condition, suivie d'une union pour éliminer les doublons parmi les lignes.
Oui, les requêtes seront en général non équivalentes, étant donné que des doublons complets de lignes peuvent être retournés. Cependant, dans la réalité, les doublons complets ne sont pas nécessaires et on essaie de s'en débarrasser.
Comparons maintenant les plans d'exécution de ces deux requêtes :
- pour le CROSS JOIN, le temps d'exécution moyen est de 195 secondes :

- pour l'INNER JOIN-UNION, le temps d'exécution moyen est inférieur à 24 secondes :

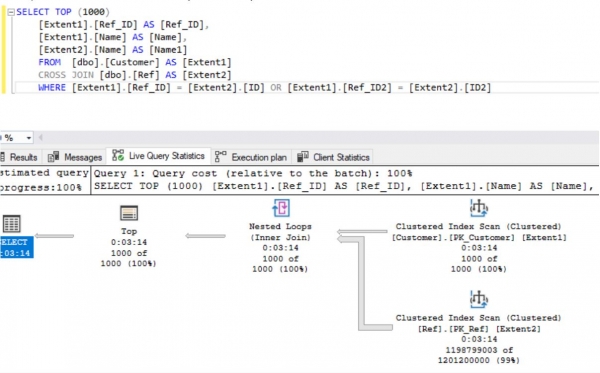
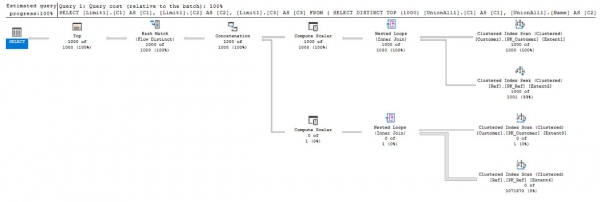
Comme on peut le voir dans les résultats, pour deux tables contenant des millions d'enregistrements, la requête LINQ optimisée fonctionne de manière beaucoup plus rapide que la version non optimisée.
Pour le cas avec des conditions 'ET' dans une requête LINQ de type :
requête LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
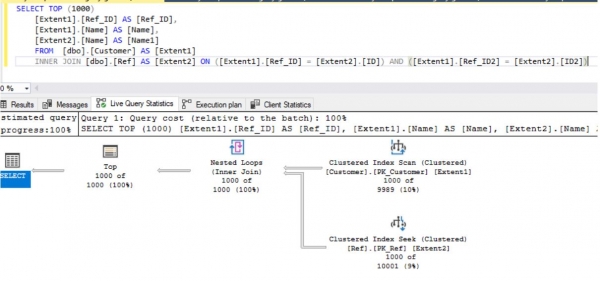
presque toujours une requête SQL correcte sera générée, qui s'exécutera en moyenne en environ 1 seconde :
Également, pour les manipulations LINQ to Objects au lieu d'une requête de type :
Requête LINQ (première variante)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
on peut utiliser une requête de type :
Requête LINQ (deuxième variante)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
où :
Définition de deux tableaux
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, et le type Para est défini comme suit :
Définition du type Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Ainsi, nous avons abordé certains aspects de l'optimisation des requêtes LINQ sur MS SQL Server.
Malheureusement, même les développeurs .NET expérimentés et de premier plan oublient qu'il est nécessaire de comprendre ce que les instructions qu'ils utilisent font en coulisses. Sinon, ils deviennent des configureurs et peuvent poser une bombe à retardement pour l'avenir, tant lors de la scalabilité de la solution logicielle que lors de changements mineurs des conditions environnementales.
Une petite revue a également été réalisée et .
Les sources pour le test - le projet lui-même, la création de tables dans la base de données TEST, ainsi que le remplissage de ces tables avec des données se trouvent .
Dans ce dépôt, le dossier Plans contient des plans d'exécution de requêtes avec des conditions OU.
Source : habr.com
