

Dans le processus de transition d'une application monolithique vers une architecture microservices, nous faisons face à de nouveaux défis.
Dans une application monolithique, il est généralement suffisamment simple de déterminer quelle partie du système a rencontré une erreur. Il est probable que le problème provienne du code du monolithe lui-même ou de la base de données. Mais quand nous commençons à rechercher un problème dans une architecture microservices, ce n’est plus aussi évident. Il faut retrouver tout le chemin que la requête a parcouru du début à la fin, en le distinguant parmi des centaines de microservices. De plus, beaucoup d'entre eux disposent de leurs propres stockages, où des erreurs logiques, ainsi que des problèmes de performance et de résilience, peuvent également survenir.
J'ai longtemps cherché un outil qui pourrait aider à résoudre ces problèmes (j'en ai parlé sur Habr : , ), mais j'ai finalement développé ma propre solution open-source. Dans cet article, je parle des avantages de l'approche service mesh et je partage un nouvel outil pour sa mise en œuvre.
Le tracing distribué est une solution courante au problème de recherche d'erreurs dans les systèmes distribués. Mais que se passe-t-il si cette approche pour collecter des informations sur les interactions réseau n'est pas encore mise en œuvre dans le système, ou, ce qui est pire, qu'elle fonctionne correctement dans une partie du système mais pas dans l'autre, car elle n'a pas été ajoutée aux anciens services ? Pour déterminer la véritable cause profonde du problème, il est essentiel d'avoir une vue d'ensemble de ce qui se passe dans le système. Il est particulièrement important de comprendre quels microservices participent aux parcours critiques pour l'entreprise.
Ici, l'approche service mesh peut nous être utile, car elle s'occupe de toute la machinerie de collecte d'informations réseau à un niveau inférieur à celui où fonctionnent les services eux-mêmes. Cette approche nous permet d'intercepter tout le trafic et de l'analyser à la volée. De plus, les applications n'ont même pas besoin d'en être conscientes.
Approche service mesh
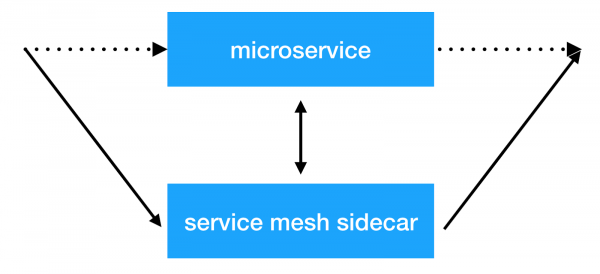
L'idée principale de l'approche du service mesh est d'ajouter une couche d'infrastructure supplémentaire au-dessus du réseau, ce qui nous permettra d'effectuer diverses opérations sur l'interaction entre services. La plupart des implémentations fonctionnent de la manière suivante : à chaque microservice, on ajoute un conteneur sidecar supplémentaire avec un proxy transparent, par lequel tout le trafic entrant et sortant du service transite. C'est à cet endroit précis que nous pouvons effectuer l'équilibrage des clients, appliquer des politiques de sécurité, imposer des limites sur le nombre de requêtes, et collecter des informations importantes sur les interactions entre services en production.
Solutions
Il existe déjà plusieurs implémentations de cette approche : et . Elles offrent de nombreuses fonctionnalités prêtes à l'emploi. Mais en même temps, cela entraîne également un important overhead en termes de ressources. En effet, plus le cluster dans lequel cette système fonctionne est grand, plus les ressources nécessaires pour maintenir la nouvelle infrastructure seront élevées. Chez Avito, nous exploitons des clusters Kubernetes qui contiennent des milliers d'instances de services (et leur nombre continue de croître rapidement). Dans l'implémentation actuelle, Istio consomme environ 300 Mo de mémoire vive par instance de service. En raison de la multitude de fonctionnalités, l'équilibrage transparent influence également le temps de réponse global des services (jusqu'à 10 ms).
En fin de compte, nous avons examiné les fonctionnalités dont nous avons besoin immédiatement et avons décidé que la principale raison pour laquelle nous avons commencé à introduire de telles solutions était la capacité de collecter des informations de tracing de manière transparente à travers l'ensemble du système. Nous voulions également avoir le contrôle sur les interactions entre services et effectuer différentes manipulations des en-têtes échangés entre les services.
Finalement, nous sommes arrivés à notre solution : .
Netramesh
— c'est une solution service mesh légère avec une capacité de mise à l'échelle infinie, peu importe le nombre de services dans le système.
Les principaux objectifs de cette nouvelle solution étaient un faible overhead en ressources et une haute performance. Parmi les fonctionnalités principales, nous voulions immédiatement avoir la possibilité d'envoyer de manière transparente les spans de tracing dans notre système Jaeger.
Aujourd'hui, la plupart des solutions cloud sont mises en œuvre en Golang. Et, bien sûr, il y a de bonnes raisons à cela. Écrire des applications réseau en Golang, qui fonctionnent de manière asynchrone avec des entrées-sorties et qui se mettent à l'échelle en fonction des besoins, est pratique et relativement simple. Et ce qui est également très important, c'est que les performances sont suffisantes pour accomplir cette tâche. C'est pourquoi nous avons également choisi Golang.
Performance
Nous avons concentré nos efforts sur l'atteinte d'une performance maximale. Pour une solution déployée à proximité de chaque instance de service, une faible consommation de mémoire vive et de temps processeur est nécessaire. Et, bien sûr, la latence de réponse doit également être minimale.
Voyons quels résultats nous avons obtenus.
RAM
Netramesh consomme environ 10 Mo sans trafic et jusqu'à 50 Mo avec une charge allant jusqu'à 10 000 RPS sur une seule instance.
Le proxy Istio envoy consomme toujours environ 300 Mo dans nos clusters avec des milliers d'instances. Cela empêche de le redimensionner à l'échelle du cluster.
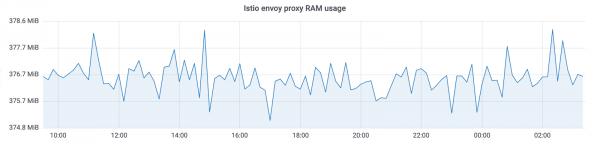
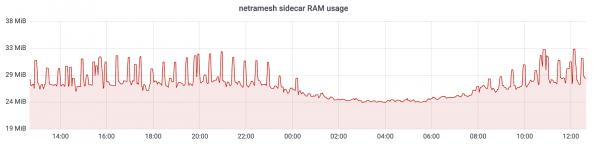
Avec Netramesh, nous avons réussi à réduire la consommation de mémoire d'environ 10 fois.
CPU
L'utilisation du CPU est relativement égale sous charge. Elle dépend du nombre de requêtes par unité de temps au sidecar. Les valeurs au pic de 3000 requêtes par seconde sont :
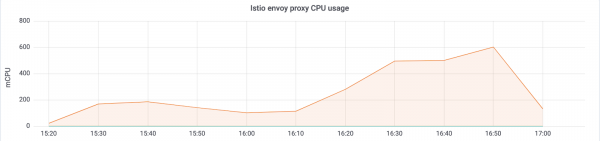
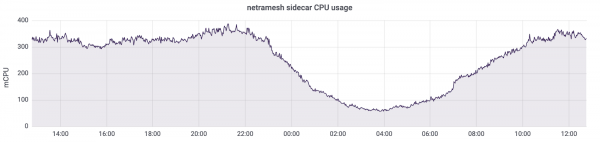
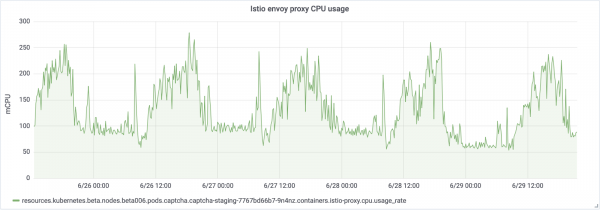
Il y a un autre point important : Netramesh est une solution sans plan de contrôle et ne consomme pas de temps processeur en l'absence de charge. Avec Istio, les sidecars mettent toujours à jour les endpoints des services. En fin de compte, nous pouvons voir une telle image sans charge :
Nous utilisons HTTP/1 pour l'interaction entre les services. L'augmentation du temps de réponse avec Istio lors du proxying via envoy était de 5 à 10 ms, ce qui est assez élevé pour des services qui sont prêts à répondre en millisecondes. Avec Netramesh, ce temps a été réduit à 0,5-2 ms.
Scalabilité
Le faible nombre de ressources utilisées par chaque proxy permet de le placer à côté de chaque service. Netramesh a été délibérément conçu sans composant de plan de contrôle pour maintenir la légèreté de chaque sidecar. Dans les solutions de service mesh, le plan de contrôle diffuse souvent les informations de découverte de services dans chaque sidecar. Avec cela arrivent également des informations sur les délais d'attente et les réglages d'équilibrage. Tout cela permet de faire beaucoup de choses utiles, mais, malheureusement, gonfle la taille des sidecars.
Découverte de services

Netramesh n'ajoute aucun mécanisme supplémentaire pour la découverte de services. Tout le trafic est transparent via le sidecar netra.
Netramesh prend en charge le protocole applicatif HTTP/1. Pour sa définition, une liste de ports configurables est utilisée. En général, il existe plusieurs ports dans le système qui permettent l'interaction via HTTP. Par exemple, pour l'interaction entre services et requêtes externes, nous utilisons les ports 80, 8890, 8080. Dans ce cas, ils peuvent être spécifiés à l'aide d'une variable d'environnement. NETRA_HTTP_PORTS.
Si vous utilisez Kubernetes comme orchestrateur et son mécanisme Service pour l'interaction intra-cluster entre services, le mécanisme reste exactement le même. Le micro-service obtient d'abord l'adresse IP du service via kube-dns et ouvre une nouvelle connexion vers celle-ci. Cette connexion est établie d'abord avec le netra-sidecar local et tous les paquets TCP arrivent initialement dans netra. Ensuite, netra-sidecar établit la connexion avec le point de destination initial. Le NAT sur l'adresse IP du pod sur le nœud reste le même que sans netra.
Traçage distribué et transmission de contexte
Netramesh fournit la fonctionnalité nécessaire pour envoyer des spans de traçage concernant les interactions HTTP. Netra-sidecar analyse le protocole HTTP, mesure les latences des requêtes et extrait les informations nécessaires des en-têtes HTTP. Nous obtenons finalement tous les traçages dans un système Jaeger unique. Pour une configuration fine, il est également possible d'utiliser les variables d'environnement fournies par la bibliothèque officielle. .
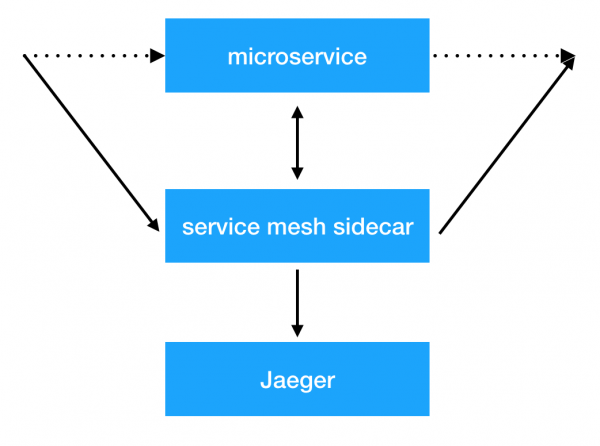
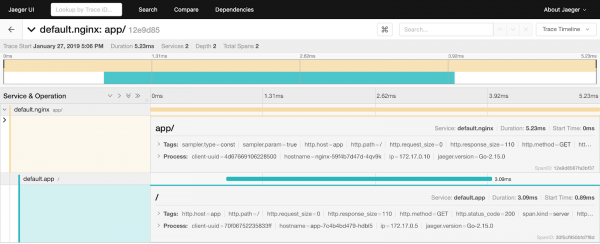
Cependant, il existe un problème. Tant que les services ne génèrent pas et ne transmettent pas un en-tête uber spécial, nous ne verrons pas les spans de traçage connectés dans le système. Et c'est ce qui est nécessaire pour identifier rapidement les causes des problèmes. Ici, Netramesh a à nouveau une solution. Les proxies lisent les en-têtes HTTP et, en l'absence de l'uber trace id, le génèrent. Netramesh conserve également des informations sur les requêtes entrantes et sortantes dans le sidecar et les associe en enrichissant les nécessités des en-têtes des requêtes sortantes. Tout ce que les services doivent faire est de transmettre un seul en-tête. X-Request-Id, qui peut être configuré à l'aide d'une variable d'environnement. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Pour gérer la taille du contexte dans Netramesh, vous pouvez spécifier les variables d'environnement suivantes : NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (le temps pendant lequel le contexte sera conservé) et NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (la fréquence de nettoyage du contexte).
Il est également possible de combiner plusieurs chemins dans votre système en les marquant avec un marqueur de session spécial. Netra permet de définir HTTP_HEADER_TAG_MAP pour transformer les en-têtes HTTP en balises de tracing span correspondantes. Cela peut être particulièrement utile pour les tests. Après avoir effectué un test fonctionnel, vous pouvez voir quelle partie du système a été affectée en filtrant par la clé de session correspondante.
Définition de la source de la demande
Pour déterminer d'où provient la demande, vous pouvez utiliser la fonctionnalité d'ajout automatique d'en-tête avec la source. Grâce à la variable d'environnement NETRA_HTTP_X_SOURCE_HEADER_NAME vous pouvez définir le nom de l'en-tête qui sera automatiquement ajouté. Avec NETRA_HTTP_X_SOURCE_VALUE vous pouvez définir la valeur qui sera attribuée à l'en-tête X-Source pour toutes les demandes sortantes.
Cela permet d'uniformiser la diffusion de cet en-tête utile à travers le réseau. Ensuite, vous pouvez l'utiliser dans les services et l'ajouter aux journaux, aux métriques.
Routage du trafic et entrailles de Netramesh
Netramesh est composé de deux principaux composants. Le premier, netra-init, définit les règles de réseau pour intercepter le trafic. Il utilise pour intercepter tout ou partie du trafic vers le sidecar, qui est le deuxième composant principal de Netramesh. Vous pouvez configurer les ports à intercepter pour les sessions TCP entrantes et sortantes : INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
L'outil dispose également d'une fonctionnalité intéressante — le routage probabiliste. Si vous utilisez Netramesh uniquement pour collecter des tracing spans, vous pouvez économiser des ressources en production en activant le routage probabiliste à l'aide des variables NETRA_INBOUND_PROBABILITY et NETRA_OUTBOUND_PROBABILITY (de 0 à 1). La valeur par défaut est 1 (tout le trafic est intercepté).
Après une interception réussie, le sidecar netra accepte une nouvelle connexion et utilise SO_ORIGINAL_DST l'option de socket pour obtenir le point de destination d'origine. Ensuite, Netra ouvre une nouvelle connexion à l'adresse IP d'origine et établit une communication TCP bidirectionnelle entre les parties, écoutant tout le trafic passant. Si le port est défini comme HTTP, Netra tente de l'analyser et de le tracer. Si l'analyse HTTP échoue, Netra effectue un fallback sur TCP et proxy les octets de manière transparente.
Construction d'un graphique de dépendances
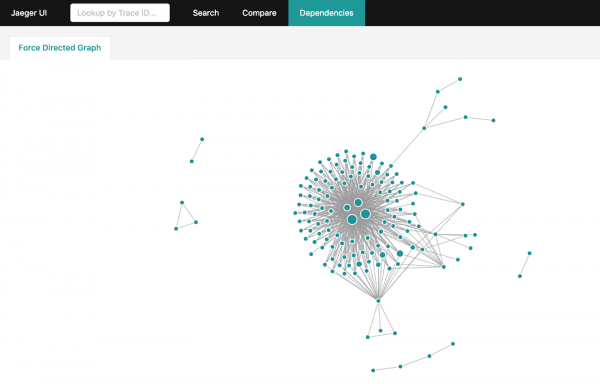
Après avoir obtenu une grande quantité d'informations de tracing dans Jaeger, on souhaite obtenir un graphique complet des interactions dans le système. Mais si votre système est suffisamment chargé et qu'au cours de la journée des milliards de spans de tracing s'accumulent, leur agrégation devient une tâche compliquée. Il existe une méthode officielle pour cela : . Cependant, cela prendra des heures pour construire le graphique complet et nécessitera de télécharger l'ensemble du dataset de Jaeger pour les dernières 24 heures.
Si vous utilisez Elasticsearch pour stocker les spans de tracing, vous pouvez utiliser , qui construira un graphique similaire en quelques minutes, en exploitant les caractéristiques et les fonctionnalités d'Elasticsearch.
Comment utiliser Netramesh
Netra peut être facilement ajouté à n'importe quel service exécuté sous un orchestrateur quelconque. Vous pouvez consulter un exemple .
Actuellement, Netra ne dispose pas de possibilité d'injection automatique du sidecar dans les services, mais des plans pour sa mise en œuvre sont en cours.
L'avenir de Netramesh
L'objectif principal est d'atteindre des coûts minimaux en ressources et de fournir des performances élevées, en offrant des fonctionnalités clés pour l'observabilité et le contrôle des interactions interservices.
À l'avenir, Netramesh prendra en charge d'autres protocoles de niveau application en plus de HTTP. Bientôt, une fonction de routage L7 sera disponible.
Utilisez Netramesh si vous êtes confronté à des problèmes similaires, et écrivez-nous vos questions et suggestions.
Source : habr.com
