

Jusqu'à récemment, Odnoklassniki avait environ 50 To de données traitées en temps réel stockées dans SQL Server. Pour un tel volume, assurer un accès rapide, fiable et résilient aux pannes via un datacenter en utilisant une base de données SQL est pratiquement impossible. Dans de tels cas, l'une des solutions NoSQL est généralement utilisée, mais tout ne peut pas être transféré vers NoSQL : certaines entités nécessitent des garanties de transactions ACID.
Cela nous a amenés à utiliser un stockage NewSQL, c'est-à-dire une base de données offrant la résilience, la scalabilité et la rapidité des systèmes NoSQL, tout en conservant les garanties ACID familières des systèmes classiques. Les systèmes industriels en fonctionnement de cette nouvelle classe sont peu nombreux, c'est pourquoi nous en avons réalisé un nous-mêmes et l'avons mis en production.
Comment cela fonctionne et quel en a été le résultat — lis la suite.
Aujourd'hui, l'audience mensuelle d'Odnoklassniki dépasse 70 millions de visiteurs uniques. Nous des plus grands réseaux sociaux du monde, et parmi les vingt sites sur lesquels les utilisateurs passent le plus de temps. L'infrastructure d'OK gère des charges très élevées : plus d'un million de requêtes HTTP/seconde en front-end. Des parties du parc de serveurs, comptant plus de 8000 unités, sont situées à proximité les unes des autres — dans quatre centres de données à Moscou, ce qui permet d'assurer une latence réseau inférieure à 1 ms entre eux.
Nous utilisons Cassandra depuis 2010, à partir de la version 0.6. Aujourd'hui, plusieurs dizaines de clusters sont en exploitation. Le cluster le plus rapide traite plus de 4 millions d'opérations par seconde, tandis que le plus important stocke 260 To.
Cependant, tout cela représente des clusters NoSQL ordinaires, utilisés pour stocker Nous souhaitions remplacer le stockage principal cohérent, Microsoft SQL Server, utilisé depuis le lancement d'Odnoklassniki. Le stockage était composé de plus de 300 machines SQL Server Standard Edition, contenant 50 To de données — des entités commerciales. Ces données sont modifiées dans le cadre de transactions ACID et nécessitent .
Pour la répartition des données sur les nœuds SQL Server, nous avons utilisé tant du partitionnement vertical qu'horizontal. (sharding). Historiquement, nous avons utilisé un schéma de sharding des données simple : chaque entité se voit attribuer un jeton — une fonction de l'ID de l'entité. Les entités partageant le même jeton étaient placées sur un seul serveur SQL. La relation de type master-detail était mise en œuvre de manière à ce que les jetons de l'enregistrement principal et de l'enregistrement dérivé coïncident toujours et soient présents sur un seul serveur. Dans un réseau social, presque tous les enregistrements sont générés au nom d'un utilisateur — ce qui signifie que toutes les données de l'utilisateur, au sein d'un même sous-système fonctionnel, sont stockées sur un seul serveur. Ainsi, dans une transaction commerciale, presque toutes les tables appartenaient à un seul serveur SQL, ce qui permettait d'assurer la cohérence des données grâce à des transactions ACID locales, sans nécessité d'utiliser . Grâce au sharding et pour améliorer les performances SQL :
Nous n'utilisons pas de contraintes de clé étrangère, car, lors du sharding, l'ID de l'entité peut se trouver sur un autre serveur.
- Nous n'utilisons pas de procédures stockées ou de déclencheurs en raison de la charge supplémentaire sur le CPU du SGBD.
- Nous n'utilisons pas de JOINs en raison de tout ce qui précède et de la multitude de lectures aléatoires depuis le disque.
- En dehors des transactions, pour réduire les blocages, nous utilisons le niveau d'isolation Read Uncommitted.
- Nous effectuons uniquement des transactions courtes (en moyenne moins de 100 ms).
- Nous n'utilisons pas de mises à jour et de suppressions multi-lignes en raison du grand nombre de blocages — nous mettons à jour un seul enregistrement à la fois.
- Les requêtes sont toujours exécutées uniquement par index — une requête avec un plan de lecture complète de la table pour nous signifie une surcharge de la base de données et son échec.
- Ces étapes ont permis de tirer presque le maximum de performance des serveurs SQL. Cependant, les problèmes augmentaient de plus en plus. Examinons-les.
Problèmes avec SQL
Étant donné que nous utilisions un sharding fait maison, l'ajout de nouveaux shards était effectué manuellement par les administrateurs. Pendant tout ce temps, les répliques de données évolutives ne traitaient pas de requêtes.
- À mesure que le nombre d'enregistrements dans une table augmente, la vitesse d'insertion et de modification diminue, et l'ajout d'index à une table existante provoque une chute exponentielle de la vitesse, la création et la recréation d'index se fait avec des temps d'arrêt.
- La présence en production d'un petit nombre de Windows pour SQL Server complique la gestion de l'infrastructure.
- Mais le principal problème —
Mais le principal problème est —
Résilience
Un serveur SQL classique présente une mauvaise résilience. Supposons que vous n'ayez qu'un seul serveur de base de données, et qu'il tombe en panne une fois tous les trois ans. Pendant ce temps, le site ne fonctionne pas pendant 20 minutes, ce qui est acceptable. Si vous avez 64 serveurs, le site est hors service une fois toutes les trois semaines. Et si vous avez 200 serveurs, le site ne fonctionne pas chaque semaine. C'est un problème.
Que peut-on faire pour améliorer la résilience des serveurs SQL ? Wikipédia nous suggère de construire un : où, en cas de défaillance de l'un des composants, il y a un duplicata.
Cela nécessite un parc de matériel coûteux : de nombreuses redondances, de la fibre optique, des systèmes de stockage partagés, et de plus, l'activation de la redondance fonctionne de manière peu fiable : environ 10 % des activations se terminent par l'échec de la nœud de secours, entraînant le nœud principal.
Mais le principal inconvénient d'un tel cluster à haute disponibilité est l'absence totale de disponibilité en cas de défaillance du centre de données où il se trouve. Odnoklassniki dispose de quatre centres de données, et nous devons assurer le fonctionnement en cas de sinistre total dans l'un d'eux.
Pour cela, on pourrait appliquer une intégrée à SQL Server. Cette solution est beaucoup plus coûteuse en raison des frais logiciels et souffre de problèmes de réplication bien connus - des délais de transactions imprévisibles lors de la réplication synchrone et des délais dans l'application des réplications (et, par conséquent, des modifications perdues) en mode asynchrone. La nécessité de rend cette option complètement inapplicable pour nous.
Tous ces problèmes nécessitaient une solution radicale, et nous avons commencé à les analyser en détail. Ici, nous devons nous familiariser avec ce que fait principalement SQL Server : les transactions.
Une transaction simple
Prenons la transaction la plus simple du point de vue d'un programmeur SQL appliqué : l'ajout d'une photo à un album. Les albums et les photos sont stockés dans différentes tables. Un album a un compteur de photos publiques. Ainsi, cette transaction se décompose en plusieurs étapes :
- Nous verrouillons l'album par clé.
- Nous créons un enregistrement dans la table des photos.
- Si la photo est publique, nous incrémentons le compteur de photos publiques dans l'album, mettons à jour l'enregistrement, et validons la transaction.
Ou sous forme de pseudocode :
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Nous voyons que le scénario de transaction d'entreprise le plus courant consiste à lire les données de la base de données en mémoire du serveur d'applications, à modifier quelque chose et à enregistrer les nouvelles valeurs dans la base de données. En général, dans une telle transaction, nous mettons à jour plusieurs entités, plusieurs tables.
Lors de l'exécution d'une transaction, une modification concurrente des mêmes données par un autre système peut se produire. Par exemple, un anti-spam peut décider qu'un utilisateur est suspect et que toutes les photos de cet utilisateur ne doivent plus être publiques, qu'elles doivent être soumises à modération, ce qui signifie que photo.status doit être changé en une autre valeur et que les compteurs correspondants doivent être ajustés. Il est évident que si cette opération se produit sans garanties d'atome d'application et d'isolation des modifications concurrentes, comme dans , le résultat ne sera pas celui attendu — soit le compteur de photos affichera une valeur incorrecte, soit toutes les photos ne seront pas soumises à modération.
Un tel code, manipulant différentes entités commerciales dans le cadre d'une seule transaction, a été écrit en très grand nombre au fil des ans depuis l'existence de Odnoklassniki. De notre expérience en migrations vers NoSQL avec , nous savons que les plus grandes difficultés (et les délais associés) sont liées à la nécessité de développer du code destiné à maintenir la cohérence des données. Par conséquent, la principale exigence pour le nouveau stockage était d'assurer des transactions ACID réelles pour la logique appliquée.
D'autres exigences tout aussi importantes étaient :
- En cas d'échec du centre de données, à la fois la lecture et l'écriture doivent être disponibles dans le nouveau stockage.
- Maintien de la vitesse actuelle de développement. Cela signifie qu'en travaillant avec le nouveau stockage, le volume de code doit rester à peu près le même, sans qu'il soit nécessaire d'ajouter quoi que ce soit au stockage, de développer des algorithmes de résolution de conflits, de maintenir des index secondaires, etc.
- La rapidité de fonctionnement du nouveau stockage doit être suffisamment élevée, tant pour la lecture des données que pour le traitement des transactions, ce qui signifiait en effet l'inapplicabilité de solutions académiquement strictes, universelles, mais lentes, comme par exemple .
- Mise à l'échelle automatique à la volée.
- Utilisation de serveurs ordinaires à bas prix, sans avoir besoin d'acheter du matériel exotique.
- Possibilité de développement du stockage par les développeurs de l'entreprise. En d'autres termes, la priorité était donnée aux solutions propriétaires ou open source, de préférence en Java.
Solutions, solutions
En analysant les solutions possibles, nous sommes arrivés à deux choix possibles d'architecture :
Le premier consiste à prendre n'importe quel serveur SQL et à mettre en œuvre la redondance nécessaire, le mécanisme de mise à l'échelle, le cluster tolérant aux pannes, la résolution des conflits et des transactions ACID distribuées, fiables et rapides. Nous avons évalué cette option comme étant plutôt non triviale et laborieuse.
La deuxième option consiste à prendre un stockage NoSQL prêt à l'emploi avec mise à l'échelle intégrée, un cluster tolérant aux pannes, la résolution des conflits et à implémenter nous-mêmes les transactions et SQL. À première vue, même la tâche de mise en œuvre de SQL, sans parler des transactions ACID, semble une tâche de plusieurs années. Mais ensuite, nous avons réalisé que l'ensemble des fonctionnalités SQL que nous utilisons en pratique s'éloigne autant de l'ANSI SQL que s'éloigne de l'ANSI SQL. Après un examen plus attentif, nous avons compris qu'il est suffisamment proche de ce dont nous avons besoin.
Cassandra et CQL
Alors, qu'est-ce qui rend Cassandra intéressante, quelles sont ses capacités ?
Tout d'abord, il est possible de créer des tables prenant en charge différents types de données, et l'on peut effectuer des opérations SELECT ou UPDATE sur la clé primaire.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Pour garantir la cohérence des données des répliques, Cassandra utilise . Dans le cas le plus simple, cela signifie que lorsqu'on déploie trois répliques d'une même ligne sur différentes nœuds du cluster, l'écriture est considérée comme réussie si la majorité des nœuds (c'est-à-dire deux sur trois) ont confirmé le succès de cette opération d'écriture. Les données de la ligne sont considérées comme cohérentes si, lors de la lecture, la majorité des nœuds ont été interrogés et ont confirmé leur état. Ainsi, en ayant trois répliques, on garantit une cohérence des données complète et instantanée en cas de défaillance d'un nœud. Cette approche nous a permis de mettre en place un schéma encore plus fiable : toujours envoyer des requêtes aux trois répliques, en attendant la réponse des deux plus rapides. La réponse tardive de la troisième réplique est alors rejetée. Le nœud dont la réponse est en retard peut rencontrer de graves problèmes : ralentissements, collecte de déchets dans la JVM, récupération de mémoire directe dans le noyau linux, défaillance matérielle, coupure réseau. Cependant, cela n'affecte en rien les opérations du client ni les données.
L'approche où nous contactons trois nœuds et recevons la réponse de deux est appelée : la demande d'extras répliques est envoyée avant même qu'elle ne « tombe ».
Un autre des avantages de Cassandra est le Batchlog - un mécanisme garantissant soit l'application complète, soit le rejet complet d'un lot de modifications que vous apportez. Cela nous permet de résoudre A dans ACID - l'atomicité prête à l'emploi.
Ce qui se rapproche le plus des transactions dans Cassandra, ce sont les so-called «». Mais elles sont loin des « véritables » transactions ACID : en réalité, il s'agit de la possibilité de faire sur les données d'un seul enregistrement, en utilisant le consensus par le protocole lourd Paxos. Par conséquent, la vitesse de telles transactions est faible.
Ce qui nous a manqué dans Cassandra
Ainsi, nous devions implémenter de véritables transactions ACID dans Cassandra. Avec lesquelles nous pourrions facilement réaliser deux autres capacités pratiques des SGBD classiques : des index rapides et cohérents, ce qui nous permettrait d'effectuer des sélections de données non seulement par clé primaire et un générateur de ID auto-incrémentaux monotones normal.
C*One
Ainsi est née une nouvelle base de données C*One, composée de trois types de nœuds serveurs :
- Stockage - (presque) serveurs standard Cassandra, responsables du stockage des données sur les disques locaux. À mesure que la charge et le volume des données augmentent, leur nombre peut facilement être évolué en dizaines et centaines.
- Les coordinateurs de transactions garantissent l'exécution des transactions.
- Les clients sont des serveurs d'applications qui réalisent des opérations commerciales et initient des transactions. Il peut y avoir des milliers de tels clients.
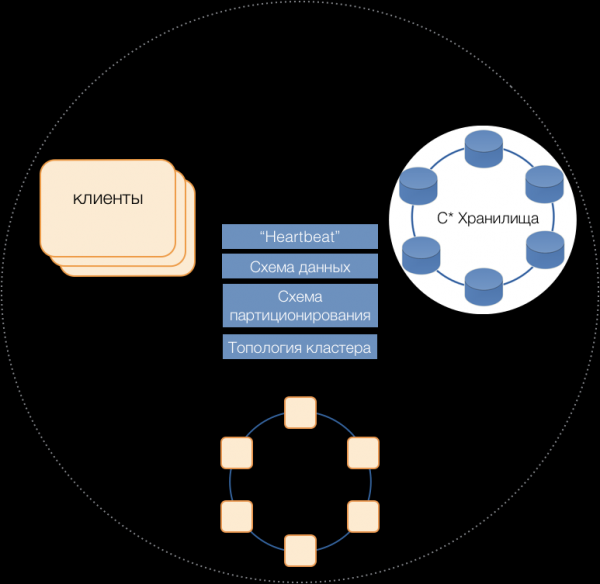
Tous les serveurs de tous types font partie d'un cluster commun, utilisant un protocole interne de messagerie Cassandra pour communiquer entre eux et échanger des informations de cluster. Grâce à Heartbeat, les serveurs prennent connaissance des pannes mutuelles, maintiennent un schéma de données cohérent — tables, leur structure et réplication ; schéma de partitionnement, topologie du cluster, etc.
Clients
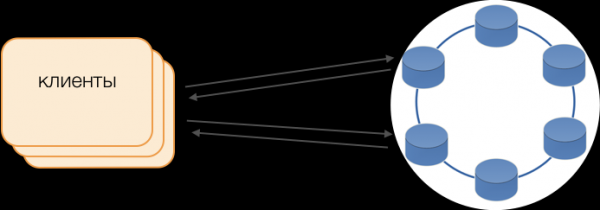
Au lieu des pilotes standard, un mode Fat Client est utilisé. Ce nœud ne stocke pas de données, mais peut jouer le rôle de coordinateur d'exécution des requêtes, c'est-à-dire que le client exécute lui-même la fonction de coordinateur de ses requêtes : il interroge les répliques du stockage et résout les conflits. Cela est non seulement plus fiable et plus rapide que le pilote standard, qui nécessite une communication avec un coordinateur distant, mais permet également de gérer le transfert des requêtes. En dehors d'une transaction ouverte sur le client, les requêtes sont dirigées vers les stockages. Si le client a ouvert une transaction, toutes les requêtes dans le cadre de celle-ci sont envoyées au coordinateur de transactions.
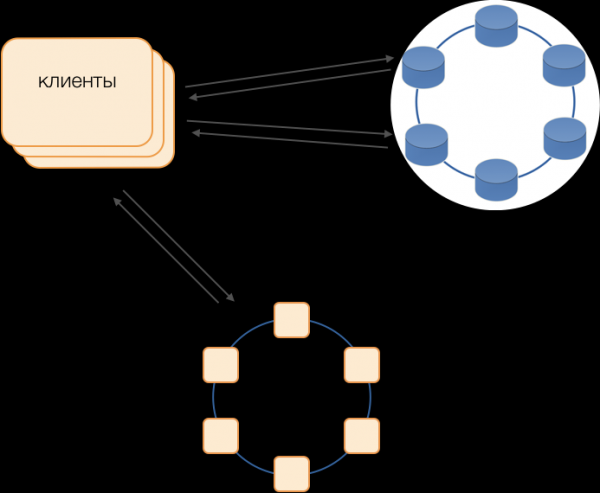
Coordinateur de transactions C*One
Le coordinateur est ce que nous avons mis en œuvre pour C*One depuis le début. Il est responsable de la gestion des transactions, des verrous et de l'ordre d'application des transactions.
Pour chaque transaction traitée, le coordinateur génère un horodatage : chaque horodatage suivant est supérieur à celui de la transaction précédente. Comme dans Cassandra, le système de résolution des conflits est basé sur les horodatages (parmi deux enregistrements conflictuels, celui avec l'horodatage le plus récent est considéré comme valide), le conflit sera toujours résolu en faveur de la transaction suivante. Ainsi, nous avons réalisé — une manière peu coûteuse de résoudre les conflits dans un système réparti.
Verrous
Pour garantir l'isolation, nous avons décidé d'utiliser la méthode la plus simple — les verrous pessimistes basés sur la clé primaire de l'enregistrement. En d'autres termes, dans la transaction, l'enregistrement doit d'abord être verrouillé, puis lu, modifié et enregistré. Ce n'est qu'après une validation réussie que l'enregistrement peut être déverrouillé, afin que les transactions concurrentes puissent l'utiliser.
La mise en œuvre d'un tel verrouillage est simple dans un environnement non distribué. Dans un système distribué, il existe deux approches principales : soit mettre en œuvre un verrouillage distribué sur le cluster, soit répartir les transactions de manière à ce que les transactions impliquant un même enregistrement soient toujours traitées par le même coordinateur.
Étant donné que, dans notre cas, les données sont déjà réparties en groupes de transactions locales dans SQL, il a été décidé d'attribuer des coordinateurs aux groupes de transactions locales : un coordinateur gère toutes les transactions avec un jeton de 0 à 9, le second avec un jeton de 10 à 19, et ainsi de suite. En conséquence, chaque instance de coordinateur devient le maître du groupe de transactions.
Ainsi, les verrouillages peuvent être réalisés sous forme de simple HashMap dans la mémoire du coordinateur.
Pannes des coordinateurs
Étant donné qu'un coordinateur ne gère qu'un groupe de transactions, il est très important de détecter rapidement toute défaillance pour que la nouvelle tentative d'exécuter une transaction soit réalisée dans le délai imparti. Pour cela, nous avons appliqué un protocole de heartbeat en quorum entièrement connecté :
Dans chaque centre de données, au moins deux nœuds coordinateurs sont placés. Périodiquement, chaque coordinateur envoie un message heartbeat aux autres coordinateurs, leur rapportant son bon fonctionnement ainsi que les messages heartbeat qu'il a reçus des autres coordinateurs du cluster.
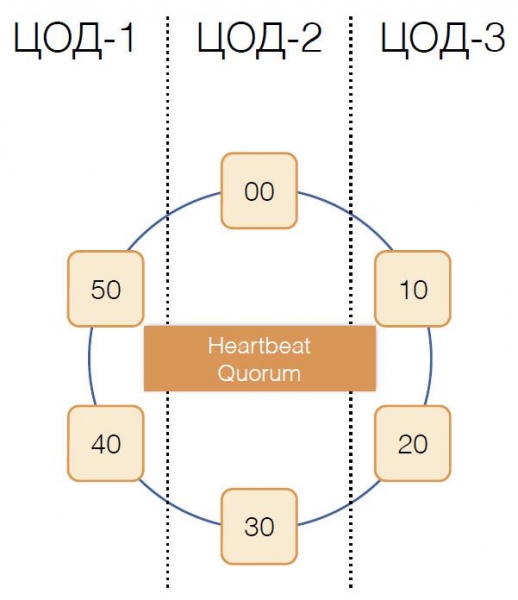
En recevant des informations similaires des autres dans leurs messages heartbeat, chaque coordinateur détermine quelles nœuds du cluster fonctionnent et lesquelles ne le font pas, en suivant le principe du quorum : si le nœud X a reçu la confirmation de la plupart des nœuds du cluster concernant la bonne réception des messages du nœud Y, cela signifie que Y est opérationnel. Et inversement, dès que la plupart rapportent la perte de messages du nœud Y, cela signifie que Y a échoué. Fait intéressant, si le quorum informe le nœud X qu'il ne reçoit plus de messages de celui-ci, le nœud X se considérera alors comme défaillant.
Les messages de cœur battant sont envoyés à une fréquence élevée, environ 20 fois par seconde, avec une période de 50 ms. En Java, il est difficile de garantir la réponse de l'application dans les 50 ms en raison de la durée comparable des pauses causées par le ramasse-miettes. Nous avons réussi à atteindre ce temps de réponse en utilisant le ramasse-miettes G1, qui permet de définir un objectif pour la durée des pauses GC. Cependant, parfois, assez rarement, les pauses du ramasse-miettes dépassent les 50 ms, ce qui peut entraîner une détection erronée de défaillance. Pour éviter cela, le coordinateur ne signale pas la défaillance d'un nœud distant après la perte du premier message de cœur battant, seulement si plusieurs sont perdus consécutivement. Ainsi, nous avons réussi à détecter la défaillance d'un nœud coordinateur en 200 ms.
Mais il ne suffit pas de comprendre rapidement quel nœud a cessé de fonctionner. Il faut agir.
Redondance
Le schéma classique prévoit qu'en cas de défaillance du maître, de nouvelles élections soient lancées à l'aide de l'un des Cependant, de tels algorithmes ont des problèmes bien connus de convergence dans le temps et de durée du processus électoral lui-même. Nous avons réussi à éviter ces délais supplémentaires grâce à un schéma de remplacement des coordinateurs dans un réseau complètement connecté :
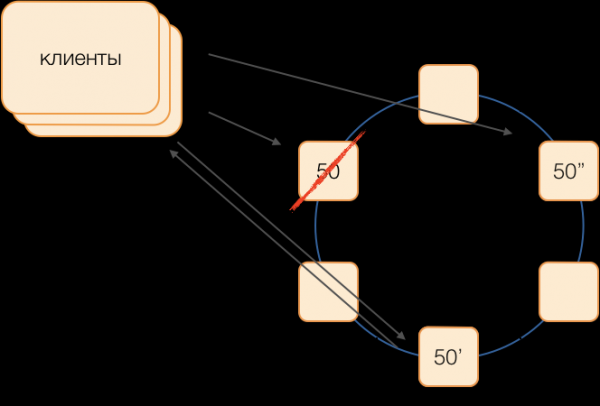
Supposons que nous souhaitons effectuer une transaction dans le groupe 50. Déterminons à l'avance le schéma de remplacement, c'est-à-dire quels nœuds exécuteront les transactions du groupe 50 en cas de défaillance du coordinateur principal. Notre but est de maintenir le fonctionnement du système en cas de défaillance d'un centre de données. Nous allons décider que le premier remplacement sera un nœud d'un autre centre de données, et le deuxième remplacement sera un nœud d'un troisième. Ce schéma est choisi une fois et ne change pas tant que la topologie du cluster ne change pas, c'est-à-dire tant que de nouveaux nœuds ne rejoignent pas (ce qui se produit très rarement). L'ordre de sélection d'un nouveau maître actif en cas de défaillance de l'ancien sera toujours le suivant : le premier remplacement deviendra le maître actif, et s'il cesse également de fonctionner, le deuxième remplacement prendra le relais.
Ce schéma est plus fiable qu'un algorithme universel, car pour activer un nouveau maître, il suffit de déterminer le fait de la défaillance de l'ancien.
Mais comment les clients sauront-ils quel maître est actif en ce moment ? Il est impossible d'envoyer des informations à des milliers de clients en 50 ms. Il peut arriver qu'un client envoie une demande d'ouverture de transaction sans savoir que ce maître n'est plus actif, et la demande pourrait se bloquer à cause d'un timeout. Pour éviter cela, les clients envoient spéculativement une demande d'ouverture de transaction simultanément au maître du groupe et à ses deux réserves, mais seule la réponse du maître actif sera traitée. Toute communication ultérieure dans le cadre de la transaction sera uniquement avec le maître actif.
Les maîtres de réserve placent les demandes reçues pour des transactions qui ne leur appartiennent pas dans une file d'attente de transactions non réalisées, où elles restent pendant un certain temps. Si le maître actif meurt, un nouveau maître traite les demandes d'ouverture de transactions de sa file d'attente et répond au client. Si le client a déjà réussi à ouvrir une transaction avec l'ancien maître, la seconde réponse est ignorée (et, de toute évidence, cette transaction ne sera pas finalisée et devra être répétée par le client).
Comment fonctionne une transaction
Supposons qu'un client a envoyé une demande d'ouverture de transaction au coordinateur pour une certaine entité avec une certaine clé primaire. Le coordinateur bloque cette entité et l'ajoute à la table des verrouillages en mémoire. Si nécessaire, le coordinateur lit cette entité depuis le stockage et sauvegarde les données obtenues dans l'état de la transaction en mémoire du coordinateur.
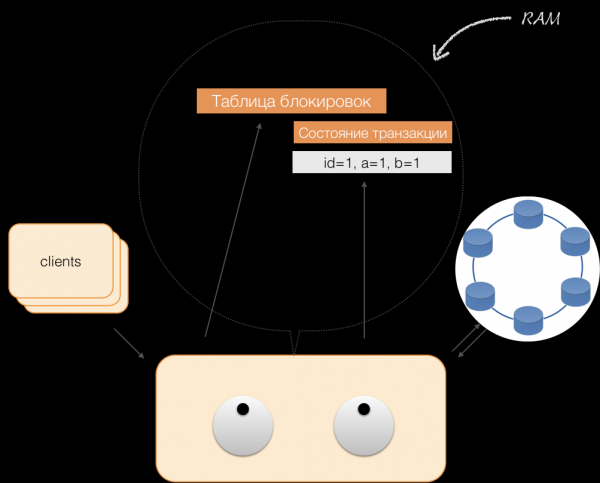
Lorsque le client souhaite modifier des données dans la transaction, il envoie une demande de modification d'entité au coordinateur, qui place les nouvelles données dans la table d'état des transactions en mémoire. À ce stade, l'enregistrement est terminé — aucune écriture dans le stockage n'est effectuée.
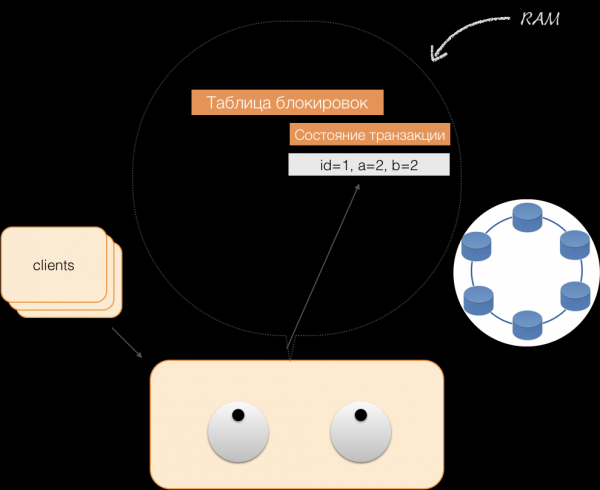
Lorsque le client demande ses propres données modifiées dans le cadre d'une transaction active, le coordinateur agit comme suit :
- si l'ID est déjà présent dans la transaction, les données sont prises de la mémoire ;
- si l'ID est absent en mémoire, les données manquantes sont lues des nœuds de stockage, combinées avec celles déjà présentes en mémoire, et le résultat est renvoyé au client.
Ainsi, le client peut lire ses propres modifications, tandis que les autres clients ne voient pas ces modifications, car elles ne sont stockées que dans la mémoire du coordinateur, elles ne sont pas encore présentes dans les nœuds Cassandra.
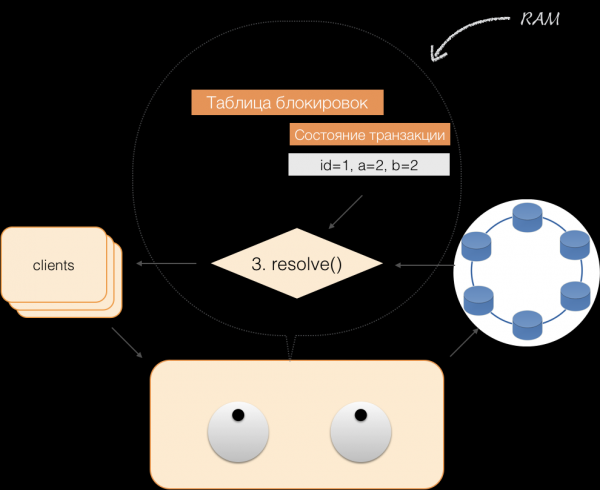
Lorsque le client envoie un commit, l'état en mémoire du service est enregistré par le coordinateur dans un batch enregistré, qui est ensuite envoyé aux systèmes de stockage Cassandra sous forme de batch enregistré. Les systèmes de stockage effectuent tout le nécessaire pour que ce batch soit appliqué de manière atomique (entièrement) et renvoient une réponse au coordinateur, qui libère alors les verrous et confirme le succès de la transaction au client.
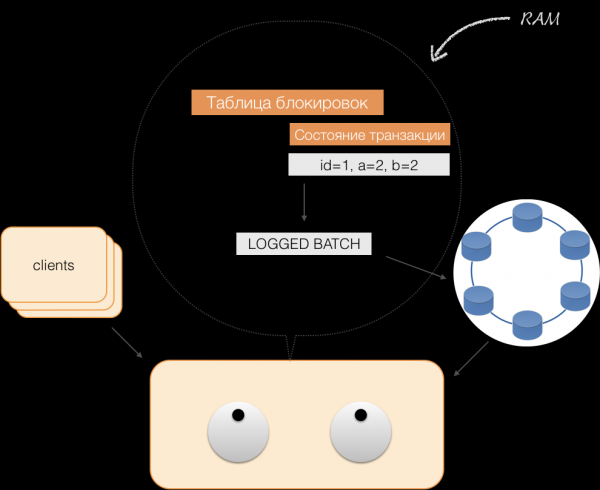
Et pour annuler, il suffit au coordinateur de libérer la mémoire occupée par l'état de la transaction.
À la suite des améliorations décrites ci-dessus, nous avons mis en œuvre les principes ACID :
- Atomicité. Cela garantit qu'aucune transaction ne sera enregistrée partiellement dans le système, soit toutes ses sous-opérations seront exécutées, soit aucune d'entre elles ne le sera. Ce principe est respecté chez nous grâce au batch enregistré dans Cassandra.
- Cohérence. Chaque transaction réussie enregistre par définition uniquement des résultats valides. Si, après l'ouverture de la transaction et l'exécution d'une partie des opérations, il est constaté que le résultat est invalide, un rollback est effectué.
- Isolation. Lors de l'exécution de la transaction, les transactions parallèles ne doivent pas affecter son résultat. Les transactions concurrentes sont isolées par le biais de verrous pessimistes sur le coordinateur. Pour les lectures en dehors de la transaction, le principe d'isolation est respecté au niveau Read Committed.
- Résilience. Indépendamment des problèmes sur les niveaux inférieurs — coupure de courant, défaillance matérielle — les modifications apportées par une transaction ayant été correctement finalisée doivent rester enregistrées après la reprise des opérations.
Lecture par index
Prenons une table simple :
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Elle a un ID (clé primaire), un propriétaire et une date de modification. Nous devons exécuter une requête très simple — sélectionner des données par propriétaire avec une date de modification « au cours des dernières 24 heures ».
SELECT *
WHERE owner=?
AND modified>?
Pour que ce type de requête soit exécuté rapidement, dans une base de données SQL classique, il est nécessaire de créer un index sur les colonnes (owner, modified). Nous pouvons faire cela assez facilement, car nous avons maintenant des garanties ACID !
Index dans C*One
Il existe une table source avec des photos, où l'ID de l'enregistrement est la clé primaire.
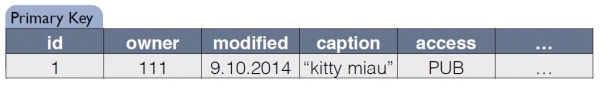
Pour l'index, C*One crée une nouvelle table qui est une copie de la table d'origine. La clé coïncide avec l'expression indexée, tout en incluant également la clé primaire de l'enregistrement de la table d'origine :
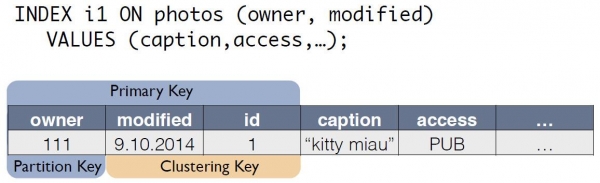
Désormais, la requête « propriétaire pour les dernières 24 heures » peut être réécrite comme un select d'une autre table :
SELECT * FROM i1_test
WHERE owner=?
AND modified > ?
La cohérence des données de la table d'origine photos et de l'index i1 est automatiquement maintenue par le coordonnateur. Sur la base du seul schéma de données, lors de la réception d'une modification, le coordonnateur génère et mémorise la modification non seulement de la table principale, mais aussi des modifications des copies. Aucune action supplémentaire sur la table d'index n'est effectuée, les journaux ne sont pas lus, les verrous ne sont pas utilisés. En d'autres termes, l'ajout d'index consomme presque aucun ressource et n'a pratiquement aucun impact sur la vitesse d'application des modifications.
Avec ACID, nous avons réussi à mettre en œuvre des index « comme en SQL ». Ils offrent la cohérence, peuvent évoluer, fonctionnent rapidement, peuvent être composés et intégrés dans le langage de requêtes CQL. Aucun changement dans le code applicatif n'est nécessaire pour soutenir les index. C'est aussi simple qu'en SQL. Et surtout, les index n'affectent pas la vitesse d'exécution des modifications de la table de transactions d'origine.
Ce qui a été réalisé
Nous avons développé C*One il y a trois ans et l'avons mis en service.
Qu'avons-nous obtenu en fin de compte ? Évaluons cela à travers le sous-système de traitement et de stockage des photographies, l'un des types de données les plus importants dans le réseau social. Il ne s'agit pas des fichiers photos eux-mêmes, mais de toutes sortes de métadonnées. Actuellement, il y a environ 20 milliards de ces enregistrements dans « Odnoklassniki », le système traite 80 000 requêtes de lecture par seconde, jusqu'à 8 000 transactions ACID par seconde, liées à la modification des données.
Lorsque nous utilisions SQL avec un facteur de réplication = 1 (mais en RAID 10), les métadonnées des photos étaient stockées sur un cluster hautement disponible de 32 machines avec Microsoft SQL Server (plus 11 de sauvegarde). De plus, 10 serveurs étaient réservés pour le stockage des sauvegardes. Au total, 50 machines coûteuses. Pendant ce temps, le système fonctionnait à charge nominale, sans marge.
Après la migration vers le nouveau système, nous avons obtenu un facteur de réplication = 3 — une copie dans chaque centre de données. Le système se compose de 63 nœuds de stockage Cassandra et de 6 machines de coordonnateurs, soit 69 serveurs au total. Mais ces machines sont beaucoup moins chères, leur coût total représente environ 30 % du coût du système SQL. Pendant ce temps, la charge reste à un niveau de 30 %.
Avec l'introduction de C*One, les latences ont également diminué : dans SQL, l'opération d'écriture prenait environ 4,5 ms. Avec C*One, cela prend environ 1,6 ms. La durée des transactions est en moyenne inférieure à 40 ms, le commit s'effectue en 2 ms, et la durée de lecture et d'écriture est en moyenne de 2 ms. Le 99ème percentile est à seulement 3-3,1 ms, et le nombre de timeouts a diminué de 100 fois, tout cela grâce à l'utilisation généralisée de spéculations.
À ce jour, la plupart des nœuds SQL Server ont été retirés de l'exploitation, et les nouveaux produits sont développés uniquement avec C*One. Nous avons adapté C*One pour qu'il fonctionne dans notre cloud. , ce qui a permis d'accélérer le déploiement de nouveaux clusters, de simplifier la configuration et d'automatiser l'exploitation. Sans le code source, cela aurait été beaucoup plus compliqué et bricolé.
Nous travaillons actuellement à la migration de nos autres entrepôts vers le cloud - mais c'est une toute autre histoire.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish