

En entrant dans un produit qui évolue depuis plus d'une décennie, il n'est pas surprenant de rencontrer des technologies obsolètes. Mais que se passe-t-il si, dans six mois, vous devez gérer une charge dix fois supérieure, et que le coût des pannes augmente de centaines de fois ? Dans ce cas, vous avez besoin d'un ingénieur Highload compétent. Mais en l'absence d'une telle personne, j'ai été chargé de résoudre le problème. Dans la première partie de cet article, je vais expliquer comment nous avons migré de Redis vers Redis-cluster, et dans la deuxième partie, je donnerai des conseils sur la façon de commencer à utiliser le cluster et sur quoi faire attention lors de son exploitation.
Choix de la technologie
Est-ce si mauvais un Redis séparé (redis autonome) dans une configuration de 1 maître et N esclaves ? Pourquoi est-ce que je l'appelle une technologie obsolète ?
Non, Redis n'est pas si mauvais... Cependant, il y a certains défauts qu'il ne faut pas ignorer.
D'abord, Redis ne prend pas en charge les mécanismes de reprise après une panne du maître. Pour résoudre ce problème, nous avons utilisé une configuration avec basculement automatique des VIP vers un nouveau maître, changement de rôle d'un des esclaves et basculement des autres. Ce mécanisme fonctionnait, mais il ne pouvait pas être qualifié de solution fiable. Premièrement, il y avait des déclenchements intempestifs, et deuxièmement, il était temporaire, et après un déclenchement, des actions manuelles étaient nécessaires pour réinitialiser le système.
Deuxièmement, avoir uniquement un maître posait un problème de sharding. Il fallait créer plusieurs clusters indépendants « 1 maître et N esclaves », puis distribuer manuellement les bases de données sur ces machines et espérer qu'une des bases ne gonfle pas au point qu'il faille la déplacer sur une instance séparée.
Quelles sont les options ?
- La solution la plus coûteuse et la plus riche est Redis-Enterprise. C'est une solution prête à l'emploi avec un support technique complet. Bien qu'elle semble idéale d'un point de vue technique, elle ne nous convenait pas sur le plan idéologique.
- Redis-cluster. Prise en charge intégrée de basculement de maître et de sharding. L'interface ne diffère presque pas de la version classique. Cela semble prometteur ; nous discuterons des pièges plus loin.
- Tarantool, Memcache, Aerospike et d'autres. Tous ces outils remplissent à peu près la même fonction. Mais chacun présente ses propres inconvénients. Nous avons décidé de ne pas mettre tous nos œufs dans le même panier. Nous utilisons Memcache et Tarantool pour d'autres tâches, et permettez-moi de dire qu'en pratique, nous avons rencontré plus de problèmes avec eux.
Spécificités de l'utilisation
Regardons les tâches que nous avons historiquement résolues avec Redis et quelles fonctionnalités nous avons utilisées :
- Mise en cache avant les requêtes vers des services externes tels que 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Mise en cache avant MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Magasin principal pour le service de gestion des sessions et des coordonnées des conducteurs | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Comme vous pouvez le voir, il n'y a pas de mathématiques avancées. Quelle est donc la complexité ? Analysons chaque méthode séparément.
Méthode
Description
Caractéristiques de Redis-cluster
Solution
GET SET
Écrire / lire une clé
MGET MSET
Écrire / lire plusieurs clés
Les clés seront stockées sur différents nœuds. Les bibliothèques prêtes à l'emploi sont capables d'exécuter des opérations multiples uniquement au sein d'un même nœud.
Remplacer MGET par un pipeline de N opérations GET
SELECT DB
Sélectionner la base de données avec laquelle nous travaillerons
Ne prend pas en charge plusieurs bases de données
Tout stocker dans une seule base. Ajouter des préfixes aux clés.
SCAN
Parcourir toutes les clés dans la base
Puisque nous avons une seule base, parcourir toutes les clés dans le cluster est trop coûteux.
Maintenir un invariant au sein d'une seule clé et effectuer un HSCAN sur cette clé. Ou abandonner complètement.
GEO
Opérations avec la clé géographique
La clé géographique n'est pas shardée.
KEY BY PATTERN
Recherche de clé par motif
Puisque nous avons une seule base, nous allons chercher parmi toutes les clés dans le cluster. Cela est trop coûteux.
Abandonner ou maintenir l'invariant, comme dans le cas de SCAN.
Redis vs Redis-cluster
Qu'est-ce que nous perdons et qu'est-ce que nous gagnons en passant au cluster ?
- Inconvénients : nous perdons la fonctionnalité de plusieurs bases.
- Si nous voulons stocker des données logiquement non liées dans un même cluster, nous devrons créer des solutions de contournement comme des préfixes.
- Nous perdons toutes les opérations "par base", telles que SCAN, DBSIZE, CLEAR DB, etc.
- Les opérations multiples sont devenues beaucoup plus compliquées à implémenter, car il peut être nécessaire d'accéder à plusieurs nœuds.
- Avantages :
- Tolérance aux pannes grâce au basculement automatique du maître.
- Sharding du côté de Redis.
- Transfert des données entre les nœuds de manière atomique et sans arrêts.
- Ajout et redistribution des ressources et des charges sans temps d'arrêt.
Je conclurais que si vous n'avez pas besoin d'assurer un niveau élevé de tolérance aux pannes, alors migrer vers un cluster n'en vaut pas la peine, car cela peut être une tâche non triviale. Mais si l'option entre une version autonome et un cluster est envisageable, il est préférable de choisir le cluster, car il n'est pas moins performant et vous soulagera d'une partie des tracas.
Préparation à la migration
Commençons par les exigences de la migration :
- Elle doit être transparente. Un arrêt complet du service pendant 5 minutes ne nous convient pas.
- Elle doit être aussi sécurisée que progressive. Nous souhaitons avoir un certain contrôle sur la situation. Nous ne souhaitons pas tout basculer d'un coup et prier pour ne pas avoir à utiliser le bouton de retour.
- Minimisation des pertes de données lors de la migration. Nous comprenons qu'il sera très difficile d'effectuer une migration atomique, c'est pourquoi nous tolérons une certaine désynchronisation entre les données sur Redis normal et cluster.
Maintenance du cluster
Avant la migration proprement dite, il convient de se demander si nous pouvons maintenir le cluster :
- Graphiques. Nous utilisons Prometheus et Grafana pour les graphiques de charge des processeurs, de mémoire utilisée, du nombre de clients, du nombre d'opérations GET, SET, AUTH, etc.
- Expertise. Imaginez que demain vous aurez la responsabilité d'un énorme cluster. Si cela tombe en panne, personne d'autre que vous ne pourra le réparer. Si cela commence à être lent, tout le monde viendra vers vous. Si des ressources doivent être ajoutées ou si la charge doit être redistribuée, encore vers vous. Pour ne pas blanchir en un jour, il est souhaitable de prévoir ces cas et de tester à l'avance comment la technologie se comportera lors de ces actions. Nous en parlerons plus en détail dans la section « Expertise ».
- Surveillance et alertes. Lorsque le cluster tombe en panne, nous voulons en être informés en premier. Pour cela, nous nous sommes limités à une alerte indiquant que tous les nœuds renvoient la même information sur l'état du cluster (oui, il arrive que ce soit différent). Les autres problèmes sont plus facilement remarqués grâce aux alertes des services clients Redis.
Migration
Comment allons-nous migrer :
- Tout d'abord, il est nécessaire de préparer la bibliothèque pour travailler avec le cluster. Pour la version en Go, nous avons pris go-redis et l'avons légèrement modifiée pour nos besoins. Nous avons implémenté des méthodes Multi via des pipelines, et ajusté les règles de répétition des requêtes. La version PHP a posé plus de problèmes, mais finalement, nous nous sommes arrêtés sur php-redis. Récemment, ils ont introduit le support des clusters, et à notre avis, cela semble bon.
- Ensuite, il faut déployer le cluster lui-même. Cela se fait littéralement en deux commandes sur la base d'un fichier de configuration. Nous discuterons plus en détail des réglages ci-dessous.
- Pour une migration progressive, nous utilisons le mode dry. Comme nous avons deux versions de la bibliothèque avec la même interface (une pour la version standard, l'autre pour le cluster), il est simple de créer un wrapper qui fonctionnera avec la version séparée tout en dupliquant toutes les requêtes dans le cluster, comparant les réponses et enregistrant les écarts dans des logs (dans notre cas, dans NewRelic). Ainsi, même si la version du cluster échoue lors du déploiement, notre production ne sera pas affectée.
- En déployant le cluster en mode dry, nous pouvons tranquillement observer le graphique des écarts de réponses. Si la part d'erreurs tend lentement mais sûrement vers une petite constante, cela signifie que tout va bien. Pourquoi y a-t-il quand même des écarts ? Parce que l'enregistrement dans la version séparée se produit un peu plus tôt que dans le cluster, et à cause du micro-délai, les données peuvent diverger. Il suffit maintenant de vérifier les logs des écarts, et si tous sont explicables par la non-atomicité de l'enregistrement, nous pouvons aller de l'avant.
- Nous pouvons maintenant inverser le mode dry. Nous allons écrire et lire depuis le cluster, tout en dupliquant dans la version séparée. Pourquoi ? Au cours de la prochaine semaine, nous souhaitons observer le fonctionnement du cluster. Si jamais on constate qu'il y a des problèmes en période de charge, ou si nous avons omis quelque chose, nous avons toujours la possibilité de revenir à l'ancien code et aux données actuelles grâce au mode dry.
- Il ne reste plus qu'à désactiver le mode dry et à démonter la version séparée.
Expertise
Commençons par un aperçu du fonctionnement du cluster.
Tout d'abord, Redis est un magasin de données clé-valeur. Les clés sont des chaînes de caractères arbitraires. Les valeurs peuvent être des nombres, des chaînes de caractères, et des structures entières. Il existe une multitude de ces dernières, mais pour comprendre le fonctionnement général, cela n'est pas essentiel.
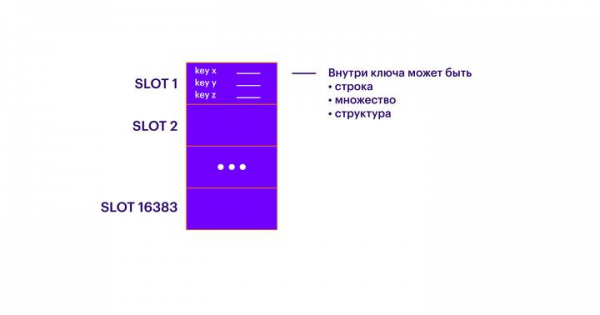
Le niveau d'abstraction suivant après les clés est celui des slots (SLOTS). Chaque clé appartient à l'un des 16 383 slots. À l'intérieur de chaque slot, il peut y avoir autant de clés que nécessaire. Ainsi, toutes les clés se décomposent en 16 383 ensembles non chevauchants.
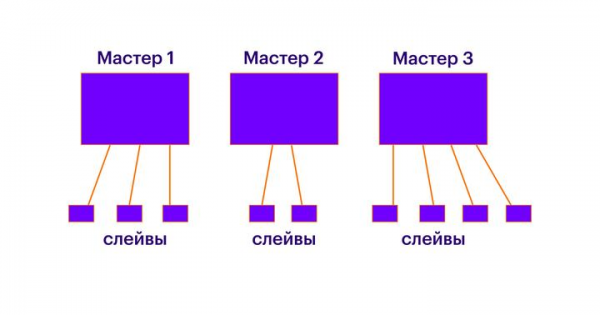
De plus, il doit y avoir N nœuds maîtres dans le cluster. Chaque nœud peut être représenté comme une instance Redis distincte, qui connaît tout sur les autres nœuds à l'intérieur du cluster. Chaque nœud maître contient un certain nombre de slots. Chaque slot appartient uniquement à un nœud maître. Tous les slots doivent être répartis entre les nœuds. Si certains slots ne sont pas répartis, les clés qui y sont stockées ne seront pas accessibles. Chaque nœud maître a intérêt à être exécuté sur une machine logique ou physique distincte. Il convient également de noter que chaque nœud fonctionne uniquement sur un cœur, et si vous souhaitez faire fonctionner plusieurs instances Redis sur une même machine logique, assurez-vous qu'elles fonctionneront sur des cœurs différents (nous n'avons pas essayé cela, mais théoriquement, tout devrait fonctionner). En essence, les nœuds maîtres assurent un sharding classique, et un plus grand nombre de nœuds maîtres permet de mettre à l'échelle les requêtes de lecture et d'écriture.
Après avoir distribué toutes les clés sur les slots et que les slots sont répartis entre les nœuds maîtres, vous pouvez ajouter un nombre arbitraire de nœuds esclaves à chaque nœud maître. À l'intérieur de chaque paire « maître-esclave », une réplication normale sera mise en œuvre. Les esclaves sont nécessaires pour mettre à l'échelle les requêtes de lecture et pour la commutation de secours en cas de défaillance du maître.
Maintenant, parlons des opérations que nous devrions être capables d'effectuer.
Nous allons interagir avec le système via Redis-CLI. Étant donné qu'il n'y a pas de point d'entrée unique dans Redis, les opérations suivantes peuvent être exécutées sur n'importe quel nœud. Je souligne séparément dans chaque point la possibilité d'exécuter l'opération sous charge.
- La première et la plus importante chose dont nous aurons besoin : l'opération cluster nodes. Elle retourne l'état du cluster, montre la liste des nœuds, leurs rôles, la répartition des slots, etc. Des informations supplémentaires peuvent être obtenues avec cluster info et cluster slots.
- Il serait bon de pouvoir ajouter et supprimer des nœuds. Pour cela, il existe les opérations cluster meet et cluster forget. Notez que cluster forget doit être appliqué à CHAQUE nœud, tant pour les maîtres que pour les réplicas. En revanche, cluster meet doit simplement être appelé sur un seul nœud. Cette différence peut être déconcertante, donc il vaut mieux en être conscient avant de mettre le cluster en production. L'ajout d'un nœud peut être réalisé en toute sécurité en cours d'exécution et n'affecte en rien le fonctionnement du cluster (ce qui est logique). En revanche, si vous prévoyez de supprimer un nœud du cluster, assurez-vous qu'il ne reste plus de slots dessus, sinon vous risquez de perdre l'accès à toutes les clés sur ce nœud. Ne supprimez pas un maître qui a des esclaves, sinon un vote inutile pour un nouveau maître sera effectué. S'il n'y a déjà plus de slots sur les nœuds, ce n'est pas un gros problème, mais pourquoi ajouter une complexité supplémentaire si l'on peut d'abord supprimer les esclaves.
- Si vous devez forcer l'échange de maître et d'esclave, la commande cluster failover convient. Lorsque vous l'appelez en cours d'exécution, il faut comprendre qu'au cours de l'opération, le maître sera inaccessible. En général, le basculement se produit en moins d'une seconde, mais ce n'est pas atomique. Attendez-vous à ce qu'une partie des requêtes au maître échoue pendant ce temps.
- Avant de supprimer un nœud du cluster, il ne doit rester aucun slot. Il est préférable de les redistribuer à l'aide de la commande cluster reshard. Les slots seront transférés d'un maître à un autre. Toute l'opération peut prendre plusieurs minutes, cela dépend du volume des données transférées, mais le processus de transfert est sécurisé et n'affecte pas le fonctionnement du cluster. Ainsi, toutes les données peuvent être transférées d'un nœud à un autre sous charge, sans se soucier de leur disponibilité. Cependant, il y a des subtilités. Premièrement, le transfert de données entraîne une certaine charge sur le nœud récepteur et l'expéditeur. Si le nœud récepteur est déjà fortement chargé en CPU, il ne faut pas le surcharger en acceptant de nouvelles données. Deuxièmement, dès qu'il ne reste plus aucun slot sur le maître expéditeur, tous ses esclaves iront immédiatement vers le maître vers lequel ces slots ont été transférés. Et le problème, c'est que tous ces esclaves souhaiteront se synchroniser en même temps. Et vous aurez de la chance si c'est une synchronisation partielle et non complète. Prenez cela en compte, et combinez les opérations de transfert de slots et de déconnexion/transfert des esclaves. Ou espérez simplement que vous disposez d'une réserve de résistance suffisante.
- Que faire si lors du transfert, vous constatez que vous avez perdu des slots quelque part ? J'espère que vous ne rencontrerez pas ce problème, mais si c'est le cas, il existe l'opération cluster fix. Elle répartira tant bien que mal les slots entre les nœuds de manière aléatoire. Je recommande de vérifier son fonctionnement après avoir retiré du cluster un nœud avec des slots répartis. Puisque les données dans les slots non répartis ne sont de toute façon pas accessibles, il est trop tard pour s'inquiéter des problèmes de disponibilité de ces slots. En revanche, l'opération n'affectera pas les slots répartis.
- Une autre opération utile est monitor. Elle permet de voir en temps réel toute la liste des requêtes envoyées au nœud. De plus, vous pouvez effectuer un grep sur cette liste pour savoir s'il y a du trafic pertinent.
Il convient également de mentionner la procédure de basculement d'un maître. Pour faire court, elle existe et, de mon point de vue, fonctionne très bien. Cependant, ne pensez pas que débrancher la machine sur le nœud maître entraînera immédiatement un basculement de Redis sans que les clients ne remarquent de perte. D'après mon expérience, le basculement prend plusieurs secondes. Pendant ce temps, certaines données seront inaccessibles : l'indisponibilité du maître est détectée, les nœuds votent pour un nouveau, les esclaves se basculent, et les données se synchronisent. Le meilleur moyen de vous assurer que le schéma fonctionne est de mener des exercices locaux. Configurez un cluster sur votre ordinateur portable, appliquez une charge minimale, simulez une défaillance (par exemple, en bloquant les ports), et évaluez la vitesse de basculement. À mon avis, seuls quelques jours d'expérimentation de cette manière peuvent garantir que la technologie fonctionne. Ou, espérons simplement que le logiciel utilisé par la moitié d'Internet fonctionne certainement.
Configuration
Souvent, la configuration est la première chose nécessaire pour commencer à travailler avec l'outil. Et une fois que tout est en marche, on n'a pas envie de toucher à la configuration. Il faut des efforts pour se forcer à revenir aux paramètres et les examiner soigneusement. D'après mes souvenirs, nous avons eu au moins deux échecs sérieux à cause d'un manque d'attention à la configuration. Portez une attention particulière aux points suivants :
- timeout 0
Le temps après lequel les connexions inactives sont fermées (en secondes). 0 — ne sont pas fermées
Pas toutes nos bibliothèques savaient fermer correctement les connexions. En désactivant ce paramètre, nous risquons d'atteindre la limite du nombre de clients. D'autre part, si ce problème existe, la coupure automatique des connexions perdues va le masquer et nous pourrions ne pas le remarquer. De plus, il ne faut pas activer ce paramètre lors de l'utilisation de connexions persistantes. - Save x y & appendonly yes
Sauvegarde d'un instantané RDB.
Nous discuterons des problèmes RDB/AOF en détail ci-dessous. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Si activé, en cas de défaillance de l'instantané RDB, le maître cessera d'accepter les requêtes de modification. Si la connexion avec le maître est perdue, l'esclave peut continuer à répondre aux requêtes (oui). Ou arrêter de répondre (non).
Nous ne voulons pas que Redis se transforme en citrouille. - repl-ping-slave-period 5
Après cette période, nous commencerons à nous inquiéter du fait que le maître est en panne et qu'il est temps d'effectuer la procédure de basculement.
Il faudra trouver manuellement un équilibre entre les fausses alertes et le déclenchement du basculement. Dans notre expérience, cela prend 5 secondes. - repl-backlog-size 1024mb & epl-backlog-ttl 0
C'est la quantité de données que nous pouvons stocker dans le tampon pour une réplique qui a échoué. Si le tampon est épuisé, il faudra se synchroniser complètement.
L'expérience montre qu'il vaut mieux mettre une valeur plus élevée. Les raisons pour lesquelles une réplique peut commencer à avoir du retard sont nombreuses. Si elle a du retard, c'est probablement que votre maître a déjà du mal à suivre, et la synchronisation complète sera la goutte d'eau. - maxclients 10000
Le nombre maximum de clients simultanés.
D'après notre expérience, il est préférable de mettre une valeur plus élevée. Redis gère très bien 10 000 connexions. Assurez-vous juste qu'il y a suffisamment de sockets dans le système. - maxmemory-policy volatile-ttl
La règle selon laquelle les clés sont supprimées lorsqu'une limite de mémoire disponible est atteinte.
Ici, il est important non pas la règle elle-même, mais la compréhension de la manière dont cela se déroulera. Redis mérite des éloges pour sa capacité à fonctionner normalement lorsqu'il atteint la limite de mémoire.
Problèmes RDB et AOF
Bien que Redis conserve toutes les informations en mémoire vive, il existe aussi un mécanisme de sauvegarde des données sur disque. Plus précisément, trois mécanismes :
- RDB-snapshot — un instantané complet de toutes les données. Se configure avec l'instruction SAVE X Y et se lit comme « Sauvegarder un instantané complet de toutes les données toutes les X secondes, si au moins Y clés ont été modifiées ».
- Fichier append-only — liste des opérations dans l'ordre de leur exécution. Ajoute les nouvelles opérations dans le fichier toutes les X secondes ou toutes les Y opérations.
- RDB et AOF — combinaison des deux précédents.
Chaque méthode a ses avantages et ses inconvénients. Je ne vais pas tous les énumérer, mais je voudrais souligner certains points qui ne sont pas évidents, à mon avis.
Tout d'abord, pour enregistrer un instantané RDB, il est nécessaire d'appeler FORK. Si les données sont nombreuses, cela peut suspendre tout Redis pendant une période allant de quelques millisecondes à une seconde. De plus, le système a besoin de mémoire pour cet instantané, ce qui signifie qu'il faut maintenir sur la machine logique un double apport de mémoire vive : si 8 Go sont alloués à Redis, il doit y avoir 16 Go disponibles sur la machine virtuelle.
Deuxièmement, il y a des problèmes de synchronisation partielle. En mode AOF, lors de la reconnexion d'un esclave, une synchronisation complète peut se produire au lieu d'une synchronisation partielle. Je n'ai pas réussi à comprendre pourquoi cela se produit. Mais il est important de s'en souvenir.
Ces deux points amènent déjà à réfléchir à la nécessité de conserver ces données sur disque, si tout est déjà dupliqué par les esclaves. La perte de données ne peut survenir qu'en cas de défaillance de tous les esclaves, et c'est un problème de niveau « incendie dans le centre de données ». Comme compromis, on peut envisager de conserver les données uniquement sur les esclaves, mais dans ce cas, il faut s'assurer que ces esclaves ne deviennent jamais maîtres lors d'une récupération d'urgence (il existe un paramètre de priorité des esclaves dans leur configuration). Pour nous, dans chaque cas particulier, nous réfléchissons à la nécessité de conserver les données sur disque, et la plupart du temps, nous répondons « non ».
Conclusion
En conclusion, j'espère avoir pu donner une vue d'ensemble du fonctionnement de redis-cluster à ceux qui n'en ont jamais entendu parler, et également attirer l'attention sur certains points peu évidents pour ceux qui l'utilisent depuis longtemps.
Merci pour votre temps, et comme d'habitude, les commentaires sur le sujet sont les bienvenus.
Source : habr.com
