

Un autre utilisateur souhaite enregistrer de nouvelles données sur son disque dur, mais il manque d'espace libre pour cela. Il ne veut rien supprimer non plus, car « tout est très important et nécessaire ». Que faire alors ?
Ce problème ne se pose pas qu'à lui. Nos disques durs contiennent des téraoctets d'informations, et cette quantité ne semble pas diminuer. Mais dans quelle mesure est-elle unique ? Après tout, tous les fichiers ne sont que des ensembles de bits de longueur déterminée et, très probablement, le nouveau ne diffère pas beaucoup de celui déjà stocké.
Il est évident que rechercher les morceaux d'informations déjà stockées sur le disque dur est une tâche, si ce n'est vouée à l'échec, du moins peu efficace. D'un autre côté, si la différence est minime, on peut peut-être ajuster légèrement...
TL;DR — deuxième tentative de parler d'une méthode étrange d'optimisation des données à l'aide de fichiers JPEG, maintenant dans une forme plus compréhensible.
À propos des bits et de la différence
Si l'on prend deux morceaux de données complètement aléatoires, en moyenne, la moitié des bits qu'ils contiennent coïncide. En effet, parmi les arrangements possibles pour chaque paire ('00, 01, 10, 11'), exactement la moitié a des valeurs correspondantes, c'est simple.
Mais bien sûr, si nous prenons simplement deux fichiers et ajustons l'un à l'autre, nous perdrons l'un d'eux. Si nous enregistrons les changements, nous reinventerons simplement , qui existe très bien sans nous, même s'il n'est généralement pas utilisé à de telles fins. On peut essayer d'intégrer une séquence plus petite dans une plus grande, mais même ainsi, nous risquons de perdre des segments critiques de données en utilisant sans réfléchir.
Entre quoi et quoi peut-on alors éliminer la différence ? En d'autres termes, le nouveau fichier enregistré par l'utilisateur est simplement une séquence de bits, et avec cela, nous ne pouvons rien faire. Il faut alors simplement trouver sur le disque dur des bits que l'on peut modifier sans avoir à stocker la différence, afin de pouvoir survivre à leur perte sans conséquences graves. Et il est utile de modifier non seulement le fichier lui-même sur le FS, mais une information à l'intérieur de celui-ci qui est moins sensible. Mais laquelle et comment ?
Méthodes d'ajustement
Les fichiers compressés avec perte viennent à la rescousse. Tous ces jpeg, mp3 et autres, bien qu'ils soient compressés avec perte, contiennent une panoplie de bits disponibles pour une modification sécurisée. On peut utiliser des techniques avancées, modifiant discrètement leurs composants à divers endroits du codage. Attendez. Techniques avancées… modification discrète… transformer certains bits en d'autres… c'est presque !
Et c'est vrai, intégrer une information dans une autre rappelle de manière frappante ces méthodes. Ce qui est impressionnant, c'est aussi la discrétion des modifications effectuées, qui échappent aux sens humains. Là où les chemins se séparent — c'est au niveau de la confidentialité : notre objectif est d'incorporer des informations supplémentaires sur le disque dur de l'utilisateur, ce qui ne peut que lui nuire. Il l'oubliera encore.
Ainsi, même si nous pouvons les utiliser, il est nécessaire de procéder à certaines modifications. Je vais en parler et montrer cela en prenant l'un des méthodes existantes et un format de fichier courant comme exemple.
Sur les chacals
S'il faut compresser, il faut compresser ce qui se compresse le mieux au monde. Il s'agit bien sûr des fichiers JPEG. Non seulement il existe une tonne d'outils et de méthodes pour intégrer des données à l'intérieur, mais c'est aussi le format graphique le plus populaire sur cette planète.
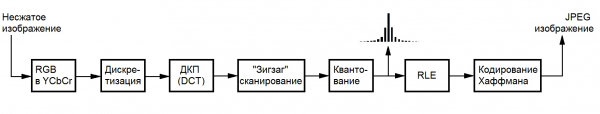
Cependant, pour éviter de jouer au chien de chasse, il faut limiter son champ d'action aux fichiers de ce format. Personne n'aime les carrés monochromes qui apparaissent à cause d'une compression excessive, donc il faut se limiter à travailler avec un fichier déjà compressé, en évitant le recodage. Plus précisément — avec des coefficients entiers, qui restent après les opérations responsables des pertes de données — DCT et quantification, ce qui est parfaitement illustré dans le schéma de codage (merci à la wiki de la bibliothèque nationale Bauman) :
Il existe de nombreuses méthodes possibles pour optimiser les fichiers JPEG. Il y a l'optimisation sans perte (jpegtran), il y a l'optimisation «« qui en introduisent en réalité bien plus, mais ce ne sont pas nos préoccupations. En effet, si l'utilisateur est prêt à intégrer une information dans une autre pour augmenter l'espace libre sur son disque, alors il a soit déjà optimisé ses images, soit ne veut pas le faire de peur de perdre en qualité.
F5
Sous ces conditions, toute une famille d'algorithmes est adaptée, avec laquelle on peut se familiariser . Le plus avancé d'entre eux est l'algorithme d'Andreas Westfeld, qui travaille avec les coefficients de la composante de luminosité, car l'œil humain est le moins sensible à ses variations. De plus, il utilise une méthode d'insertion basée sur le codage de matrix, ce qui permet de réduire d'autant plus leurs modifications lors de l'insertion d'une même quantité d'informations que plus la taille du conteneur utilisé est grande.
Les modifications elles-mêmes se limitent à réduire la valeur absolue des coefficients d'unité dans certaines conditions (c'est-à-dire, pas toujours), ce qui permet d'utiliser F5 pour optimiser le stockage des données sur le disque dur. En effet, le coefficient après un tel changement occupera probablement moins de bits après le codage de Huffman en raison de la distribution statistique des valeurs dans JPEG, et les nouveaux zéros bénéficieront du codage par RLE.
Les modifications nécessaires se concentrent sur l'élimination de la partie responsable de la confidentialité (la permutation par mot de passe), ce qui permet d'économiser des ressources et du temps d'exécution, et d'ajouter un mécanisme de fonctionnement avec plusieurs fichiers au lieu d'un seul à la fois. Un détail sur le processus de changement ne sera probablement pas intéressant pour le lecteur, donc passons à la description de l'implémentation.
Technologies de pointe
Pour démontrer le fonctionnement de cette approche, j'ai mis en œuvre une méthode en C pur et réalisé plusieurs optimisations concernant la vitesse d'exécution et la mémoire (vous n'imaginez pas combien ces images pèsent sans compression même jusqu'à DCT). La portabilité est assurée grâce à l'utilisation d'une combinaison de bibliothèques , et , ce qui leur vaut des remerciements. Le tout se compile avec ‘make’, donc les utilisateurs de Windows souhaitant évaluer cela devront installer Cygwin ou gérer Visual Studio et les bibliothèques eux-mêmes.
L'implémentation est disponible sous la forme d'un utilitaire en ligne de commande et d'une bibliothèque. Ceux qui souhaitent en savoir plus sur l'utilisation de la dernière peuvent consulter le README dans le référentiel GitHub, dont je fournirai le lien à la fin du post.
Comment utiliser?
Avec prudence. Les images utilisées pour l'emballage sont sélectionnées par recherche d'expressions régulières dans le répertoire racine spécifié. Une fois le processus terminé, les fichiers peuvent être déplacés, renommés et copiés à loisir à l'intérieur de celui-ci, changer de système de fichiers ou d'exploitation, etc. Cependant, il est crucial de rester extrêmement prudent et de ne pas modifier le contenu immédiat. La perte de valeur d'un seul bit peut entraîner l'impossibilité de récupérer les informations.
À la fin du processus, l'utilitaire laisse un fichier spécial d'archive contenant toutes les informations nécessaires à la décompression, y compris les données sur les images utilisées. En soi, il pèse environ quelques kilobytes et n'a pas d'impact significatif sur l'espace disque occupé.
Il est possible d'analyser la capacité potentielle à l'aide de l'option '-a' : './f5ar -a [dossier de recherche] [expression régulière compatible avec Perl]'. L'emballage se fait avec la commande './f5ar -p [dossier de recherche] [expression régulière compatible avec Perl] [fichier à emballer] [nom de l'archive]', et la décompression se fait avec './f5ar -u [fichier d'archive] [nom du fichier restauré]'.
Démonstration de fonctionnement
Pour montrer l'efficacité de la méthode, j'ai téléchargé une collection de 225 photos de chiens totalement gratuites depuis le service et j'ai trouvé dans les documents un gros fichier pdf de 45 Mo du second tome de Knuth.
La séquence est assez simple :
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Lecture du fichier compressé... ok
Initialisation de l'archive... ok
Analyse de la capacité de la bibliothèque... terminé en 17,0s
Capacité garantie détectée de 48439359 octets
Capacité possible détectée jusqu'à 102618787 octets
Compression... terminé en 39,4s
Sauvegarde de l'archive... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Initialisation de l'archive... ok
Lecture du fichier d'archive... ok
Remplissage de l'archive avec des fichiers... terminé en 1,4s
Décompression... terminé en 21,0s
Écriture des données extraites... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Captures d'écran pour les amateurs
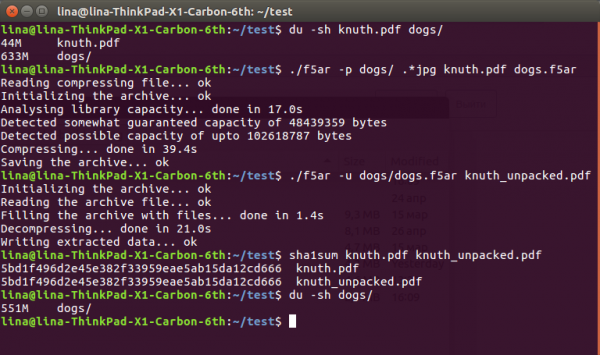
Le fichier décompressé peut encore être lu et doit être lu :
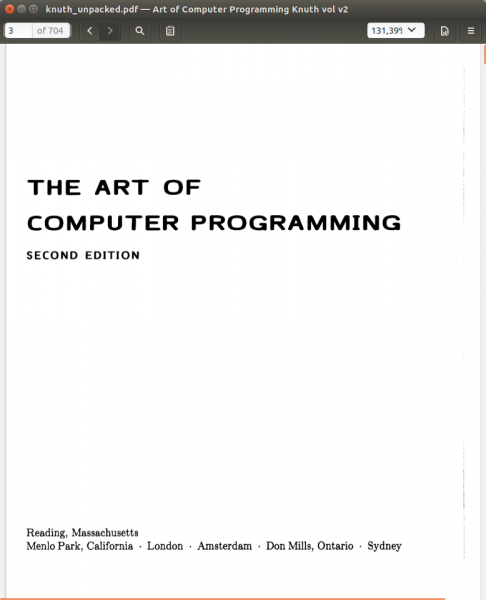
Comme on peut le voir, à partir des 633 + 36 == 669 mégaoctets de données sur le disque dur, nous sommes arrivés à un chiffre plus agréable de 551. Cette différence radicale s'explique par la réduction des coefficients qui affectent leur compression sans perte ultérieure : une simple diminution d'un point peut aisément « couper » quelques octets du fichier final. Néanmoins, cela reste des pertes de données, même si elles sont extrêmement petites, avec lesquelles il faudra composer.
Heureusement, pour l'œil, elles ne sont absolument pas perceptibles. Sous le spoiler (puisque habrastorage ne gère pas les gros fichiers), le lecteur peut apprécier la différence tant visuellement qu'en termes d'intensité, obtenue en soustrayant les valeurs de la composante modifiée de l'original : , , (plus la couleur est terne, moins il y a de différence dans le bloc).
En conclusion
Face à toutes ces complexités, acheter un disque dur ou tout mettre dans le cloud peut sembler une solution bien plus simple au problème. Mais même si nous vivons à une époque si merveilleuse, il n'y a aucune garantie qu'il sera encore possible demain de se connecter à Internet et de télécharger toutes ses données superflues. Ou d'aller dans un magasin et d'acheter un nouveau disque dur de mille téraoctets. Mais utiliser ceux qui traînent déjà à la maison est toujours une option.
->
Source : habr.com
