

Le processus de mise à jour de votre cluster Kubernetes
À un moment donné, lors de l'utilisation d'un cluster Kubernetes, il devient nécessaire de mettre à jour les nœuds en fonctionnement. Cela peut inclure des mises à jour de paquets, une mise à jour du noyau ou le déploiement de nouvelles images de machines virtuelles. Dans la terminologie de Kubernetes, cela s'appelle .
Ce post fait partie d'un cycle de 4 articles :
- Cet article.
- Arrêt correct des pods dans un cluster Kubernetes
- Arrêt différé d'un pod lors de sa suppression
- Comment éviter les temps d'arrêt dans un cluster Kubernetes à l'aide des PodDisruptionBudgets
(trad. : attendez-vous aux traductions des autres articles du cycle dans un proche avenir)
Dans cet article, nous allons décrire tous les outils que Kubernetes fournit pour atteindre un temps d'arrêt nul pour les nœuds fonctionnant dans votre cluster.
Définir le problème
Dans un premier temps, nous allons adopter une approche naïve, identifier des problèmes et évaluer les risques potentiels de cette approche tout en accumulant des connaissances pour résoudre chaque problème que nous rencontrerons au cours de ce cycle. À la fin, nous disposerons d'une configuration utilisant des lifecycle hooks, des readiness probes et des budgets de perturbation de pods pour atteindre notre objectif de temps d'arrêt nul.
Pour commencer notre chemin, prenons un exemple concret. Supposons que nous ayons un cluster Kubernetes composé de deux nœuds, dans lequel une application avec deux pods est en cours d'exécution, derrière Service:
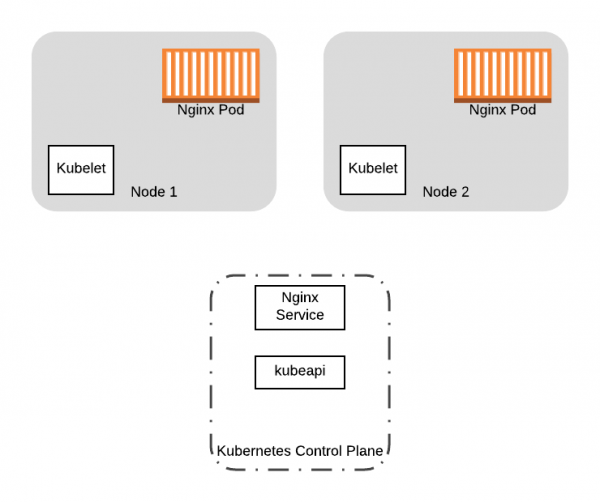
Commençons avec deux pods Nginx et un service exécutés sur nos deux nœuds du cluster Kubernetes.
Nous souhaitons mettre à jour la version du noyau des deux nœuds de travail dans notre cluster. Comment allons-nous procéder ? Une solution simple serait de démarrer de nouveaux nœuds avec une configuration mise à jour, puis d'éteindre les anciens nœuds tout en démarrant les nouveaux. Bien que cela fonctionne, il y aura plusieurs problèmes avec cette approche :
- Lorsque vous éteignez les anciens nœuds, les pods qui y sont exécutés seront également éteints. Que se passe-t-il si les pods doivent être nettoyés pour un arrêt correct ? Le système de virtualisation que vous utilisez peut ne pas attendre la fin du processus de nettoyage.
- Que se passe-t-il si vous éteignez tous les nœuds en même temps ? Vous aurez un arrêt significatif pendant que les pods se déplacent vers les nouveaux nœuds.
Nous avons besoin d'un moyen correct pour migrer les pods des anciens nœuds tout en nous assurant qu'aucun de nos processus de travail n'est en cours pendant que nous apportons des modifications aux nœuds. Ou lorsque nous effectuons un remplacement complet du cluster, comme dans l'exemple (c'est-à-dire que nous remplaçons les images des machines virtuelles), nous voulons transférer les applications en cours des anciens nœuds vers les nouveaux. Dans les deux cas, nous voulons empêcher la planification de nouveaux pods sur les anciens nœuds, puis évacuer tous les pods en cours de ceux-ci. Pour atteindre ces objectifs, nous pouvons utiliser la commande kubectl drain.
Redistribution de tous les pods depuis le nœud
L'opération drain permet de redistribuer tous les pods depuis le nœud. Au cours de l'exécution du drain, le nœud est marqué comme non planifiable (indicateur NoSchedule). Cela empêche l'apparition de nouveaux pods sur celui-ci. Ensuite, le drain commence à évacuer les pods du nœud, terminant les conteneurs qui sont actuellement en cours d'exécution sur le nœud en envoyant le signal TERM aux conteneurs dans le pod.
Bien que kubectl drain Bien que cela fonctionne parfaitement pour évacuer les pods, il y a encore deux facteurs qui peuvent causer un échec lors de l'exécution de l'opération de drainage :
- Votre application doit pouvoir se terminer correctement lors de la réception
TERMdu signal. Lorsque les pods sont évacués, Kubernetes envoie un signal aux conteneurs et attend leur arrêt pendant un certain temps, après quoi, s'ils ne se sont pas arrêtés, les termine de force. Dans tous les cas, si votre conteneur ne réagit pas correctement au signal, vous risquez de fermer les pods de manière incorrecte s'ils sont actuellement actifs (par exemple, s'il y a une transaction en cours dans la base de données).TERMVous perdez tous les pods contenant votre application. Elle peut être inaccessible au moment du démarrage de nouveaux conteneurs sur les nouveaux nœuds ou, si vos pods sont déployés sans contrôleurs, ils peuvent ne pas redémarrer du tout. - Éviter les temps d'arrêt
Pour minimiser le temps d'arrêt causé par une interruption volontaire, comme lors de l'opération de drainage d'un nœud, Kubernetes propose les options suivantes pour gérer les pannes :
Résiliation en douceur
Dans les autres parties du cycle, nous utiliserons les données de cette fonction Kubernetes pour atténuer les conséquences du déplacement des pods. Pour faciliter la compréhension de l'idée principale, nous prendrons comme exemple la configuration des ressources suivante :
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Cette configuration est un exemple minimal. Déploiement, qui gère les pods nginx dans le cluster. De plus, la configuration décrit une ressource Service, qui peut être utilisée pour accéder aux pods nginx dans le cluster.
Tout au long du cycle, nous allons itérativement étendre cette configuration pour qu'à la fin, elle comprenne toutes les fonctionnalités offertes par Kubernetes afin de réduire le temps d'arrêt.
Pour obtenir une version entièrement déployée et testée des mises à jour de clustere Kubernetes sans temps d'arrêt sur AWS et d'autres ressources, visitez .
Lisez aussi d'autres articles sur notre blog :
Source : habr.com
