

Introduction
Bonjour !
Dans cet article, je vais partager mon expérience dans la construction d'une architecture microservices pour un projet utilisant des réseaux neuronaux.
Nous aborderons les exigences de l'architecture, examinerons divers diagrammes structurels, détaillerons chacun des composants de l'architecture achevée, et évaluerons les métriques techniques de la solution.
Bonne lecture !
Quelques mots sur la tâche et sa solution
L'idée principale est d'évaluer l'attrait d'une personne sur la base d'une photo sur une échelle de dix points.
Dans cet article, nous allons nous éloigner de la description des réseaux neuronaux utilisés ainsi que du processus de préparation des données et d'apprentissage. Cependant, dans l'une de nos prochaines publications, nous reviendrons certainement sur l'analyse du pipeline d'évaluation à un niveau approfondi.
Nous allons maintenant parcourir le pipeline d'évaluation à un niveau supérieur, en mettant l'accent sur l'interaction des microservices dans le contexte de l'architecture générale du projet.
Lors du travail sur le pipeline d'évaluation de l'attrait, la tâche a été décomposée en les éléments suivants :
- Détection des visages sur la photo
- Évaluation de chacun des visages
- Rendu du résultat
Le premier est résolu par une . Pour le second, un réseau neuronal convolutif a été entraîné sur PyTorch, avec comme backbone – en équilibrant « qualité / vitesse d'inférence sur CPU »
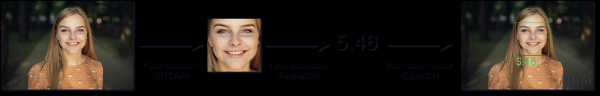
Diagramme fonctionnel du pipeline d'évaluation
Analyse des exigences de l'architecture du projet
Dans le cycle de vie du projet, les étapes de travail sur l'architecture et l'automatisation du déploiement du modèle sont souvent les plus coûteuses en temps et en ressources.
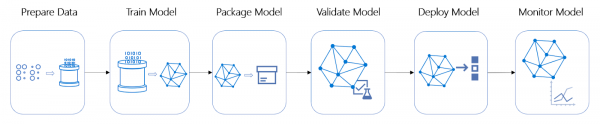
Cycle de vie d'un projet ML
Ce projet n'est pas une exception – il a été décidé d'enrouler le pipeline d'évaluation dans un service en ligne, pour cela il a été nécessaire de plonger dans l'architecture. Les exigences de base suivantes ont été formulées :
- Un stockage central de logs – tous les services doivent écrire leurs logs au même endroit, pour qu'ils soient faciles à analyser
- Possibilité de mise à l'échelle horizontale du service d'évaluation – comme le goulet d'étranglement le plus probable
- Une quantité égale de ressources processeur doit être allouée à l'évaluation de chaque image – pour éviter les écarts dans la distribution du temps d'inférence
- Déploiement rapide (ou redeploiement) à la fois de services spécifiques et de l'ensemble de la pile
- Possibilité, si nécessaire, d'utiliser des objets communs dans différents services
Architecture
Après une analyse des exigences, il est devenu évident que l'architecture microservices s'intègre presque parfaitement.
Pour éviter des maux de tête inutiles, le Telegram API a été choisi comme front-end.
Pour commencer, examinons le diagramme structurel de l'architecture prête, puis nous passerons à la description de chacun des composants et formaliserons le processus de traitement réussi de l'image.
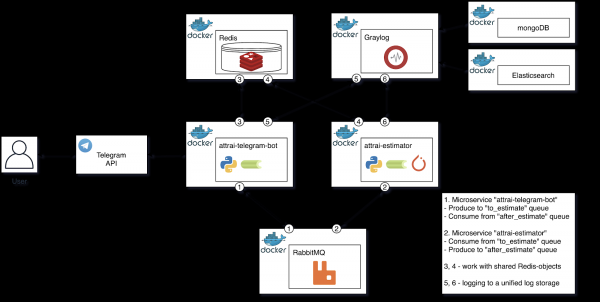
Diagramme structurel de l'architecture prête
Parlons plus en détail de chacun des composants du diagramme, en précisant leur responsabilité unique dans le processus d'évaluation de l'image.
Microservice «attrai-telegram-bot»
Ce microservice encapsule toutes les interactions avec le Telegram API. On peut identifier 2 scénarios principaux - traitement de l'image de l'utilisateur et traitement du résultat du pipeline d'évaluation. Examinons les deux scénarios de manière générale.
Lors de la réception d'un message utilisateur avec une image :
- Une filtration est effectuée, composée des vérifications suivantes :
- Présence d'une taille d'image optimale
- Nombre d'images de l'utilisateur déjà en attente
- Lors du passage de la filtration initiale, l'image est enregistrée dans un volume docker
- Une tâche est produite dans la file d'attente "to_estimate", dans laquelle figure notamment le chemin vers l'image située dans notre volume
- Si les étapes ci-dessus sont réussies, l'utilisateur recevra un message avec le temps approximatif de traitement de l'image, calculé sur la base du nombre de tâches dans la file d'attente. En cas d'erreur, l'utilisateur sera clairement informé par un message indiquant ce qui a pu mal se passer.
De plus, ce microservice, en tant que worker celery, écoute la file d'attente "after_estimate", qui est destinée aux tâches ayant passé le pipeline d'évaluation.
À la réception d'une nouvelle tâche de "after_estimate" :
- Si l'image a été traitée avec succès, nous envoyons le résultat à l'utilisateur, sinon nous le notifions de l'erreur
- Nous supprimons l'image qui est le résultat du pipeline d'évaluation
Microservice d'évaluation «attrai-estimator»
Ce microservice est un worker celery et encapsule tout ce qui est lié au pipeline d'évaluation de l'image. L'algorithme de fonctionnement est unique - analysons-le.
À la réception d'une nouvelle tâche de "to_estimate" :
- Nous faisons passer l'image à travers le pipeline d'évaluation :
- Nous chargeons l'image en mémoire
- Nous ajustons l'image à la taille requise
- Nous détectons tous les visages (MTCNN)
- Nous évaluons tous les visages (en regroupant les visages détectés dans la section précédente et en les inférant avec ResNet34)
- Nous rendons l'image finale
- Nous dessinons les bounding boxes
- Nous dessinons les évaluations
- Nous supprimons l'image utilisateur (d'origine)
- Nous sauvegardons la sortie du pipeline d'évaluation
- Nous plaçons la tâche dans la file d'attente «after_estimate», écoutée par le microservice «attrai-telegram-bot» mentionné précédemment
Graylog (+ mongoDB + Elasticsearch)
— est une solution pour la gestion centralisée des logs. Dans ce projet, il a été utilisé selon sa fonction principale.
Le choix s'est porté sur lui plutôt que sur le traditionnel stack, en raison de la facilité d'utilisation avec Python. Tout ce que vous devez faire pour le logging dans Graylog est d'ajouter GELFTCPHandler du package aux autres gestionnaires de logs racine de notre microservice Python.
En tant que personne ayant précédemment travaillé uniquement avec le stack ELK, j'ai dans l'ensemble eu une expérience positive de travail avec Graylog. La seule chose qui déroute – l'avantage fonctionnel de Kibana sur l'interface web de Graylog.
RabbitMQ
— est un courtier de messages basé sur le protocole AMQP.
Dans ce projet, il a été utilisé comme pour Celery et fonctionnait en mode durable.
Redis
— est une base de données NoSQL qui fonctionne avec des structures de données de type «clé – valeur»
Il arrive parfois qu'il soit nécessaire d'utiliser des objets communs dans différents microservices Python, implémentant certaines structures de données.
Par exemple, dans Redis, on stocke une hashmap de type «telegram_user_id => nombre de tâches actives dans la file d'attente», ce qui permet de limiter le nombre de requêtes d'un utilisateur à une certaine valeur et, ce faisant, d'éviter les attaques par déni de service.
Nous formalisons le processus de traitement réussi de l'image
- L'utilisateur envoie une image au bot Telegram
- «attrai-telegram-bot» reçoit le message de l'API Telegram et l'analyse
- La tâche avec l'image est ajoutée à la file d'attente asynchrone «to_estimate»
- L'utilisateur reçoit un message avec le temps estimé pour l'évaluation
- «attrai-estimator» prend la tâche de la file d'attente «to_estimate», la fait passer par le pipeline d'évaluation et produit la tâche dans la file d'attente «after_estimate»
- «attrai-telegram-bot», qui écoute la file d'attente «after_estimate», envoie le résultat à l'utilisateur
DevOps
Enfin, après avoir examiné l'architecture, nous pouvons passer à une autre partie tout aussi intéressante — DevOps
Mais cela signifie-t-il que vous pouvez utiliser le même fichier docker-compose dans
— un système de clustering dont les fonctionnalités sont intégrées dans Docker Engine et accessibles par défaut.
Avec l'« essaim », toutes les nœuds de notre cluster peuvent être réparties en 2 types – worker et manager. Sur les machines du premier type, des groupes de conteneurs (stacks) sont déployés, les machines du second type s'occupent du scaling, de l'équilibrage et . Les managers sont par défaut aussi des workers.
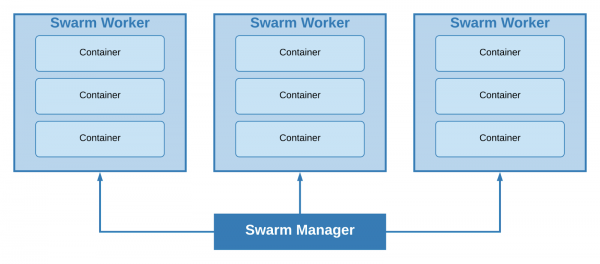
Un cluster avec un leader manager et trois workers
La taille minimale possible du cluster est de 1 nœud, la seule machine jouera simultanément le rôle de leader manager et de worker. En fonction de la taille du projet et des exigences minimales en matière de résilience, il a été décidé d'adopter cette approche.
Pour anticiper, je dirai qu'à partir de la première livraison en production, qui a eu lieu à la mi-juin, il n'y a eu aucun problème lié à cette organisation du cluster (mais cela ne signifie pas qu'une telle organisation soit en aucune façon admissible dans des projets de taille moyenne à grande soumis à des exigences de résilience).
Docker Stack
En mode « essaim », le déploiement des stacks (ensembles de services Docker) est géré par
Il prend en charge les configurations docker-compose, permettant d'utiliser des paramètres de déploiement supplémentaires.
Par exemple, grâce à ces paramètres, les ressources de chaque instance du microservice d'estimation ont été limitées (nous allouons N cœurs pour N instances, et dans le microservice, nous limitons le nombre de cœurs utilisés par PyTorch à un seul)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Il est important de noter que Redis, RabbitMQ et Graylog sont des services stateful et qu'il n'est pas aussi simple de les scaler que l'« attrai-estimator ».
Pour anticiper la question – pourquoi pas Kubernetes ?
Il semble que l'utilisation de Kubernetes dans des projets de petite et moyenne taille soit un surcoût, toute la fonctionnalité nécessaire peut être obtenue avec Docker Swarm, qui est assez convivial en tant qu'orchestrateur de conteneurs et qui a également un faible seuil d'entrée.
Infrastructure
Tout cela a été déployé sur un VDS avec les caractéristiques suivantes :
- CPU: 4 cœurs Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 Go
- SSD: 160 Go
Après des tests de charge locaux, il semblait qu'avec une forte afflux d'utilisateurs, cette machine serait juste à la limite.
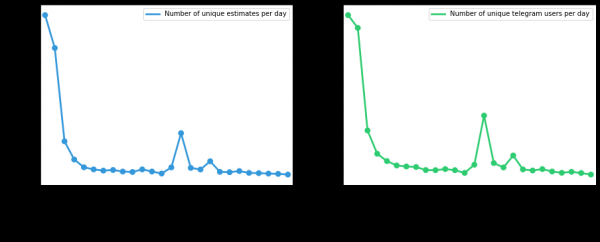
Cependant, juste après le déploiement, j'ai posté un lien vers l'une des images les plus populaires dans les pays de la CEI (oui, celle-là), ce qui a suscité l'intérêt des gens et, en quelques heures, le service a traité avec succès des dizaines de milliers d'images. Pendant ce temps, aux moments les plus critiques, les ressources CPU et RAM n'étaient même pas utilisées à moitié.
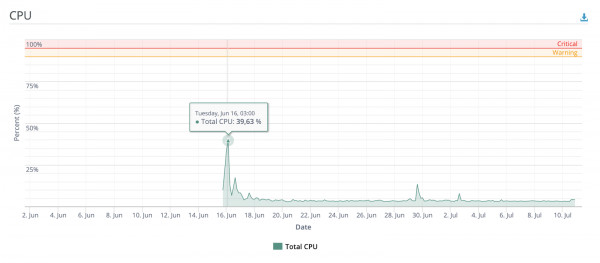
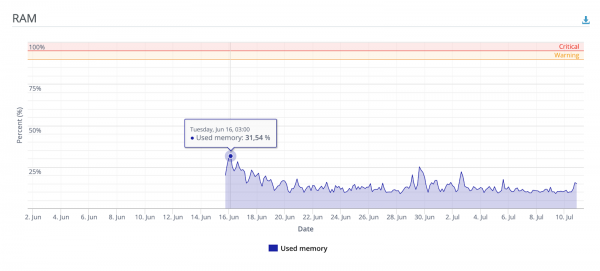
Encore un peu de graphismes
Nombre d'utilisateurs uniques et demandes d'évaluation depuis le déploiement, selon les jours
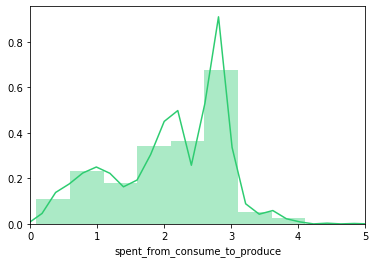
Distribution du temps d'inférence du pipeline d'évaluation
Conclusions
En résumé, je peux dire que l'architecture et l'approche d'orchestration des conteneurs ont pleinement porté leurs fruits : même aux moments de pointe, il n'y a pas eu de pannes ni de ralentissements dans le temps de traitement.
Je pense que les projets de petite et moyenne taille qui utilisent l'inférence en temps réel des réseaux neuronaux sur CPU peuvent adopter avec succès les pratiques décrites dans cet article.
Je tiens à ajouter qu'à l'origine, l'article était plus long, mais afin de ne pas poster un long texte, j'ai décidé d'omettre certains points dans cet article - nous y reviendrons dans les prochaines publications.
Vous pouvez essayer le bot sur Telegram - @AttraiBot, il fonctionnera au moins jusqu'à la fin de l'automne 2020. Je rappelle - aucune donnée utilisateur n'est stockée - ni les images originales, ni les résultats du pipeline d'évaluation - tout est effacé après traitement.
Source : habr.com
