

Aloha, tout le monde ! Je m'appelle Oleg Anastasyev, je travaille chez Odnoklassniki dans l'équipe de la Plateforme. En plus de moi, il y a une multitude de matériel chez Odnoklassniki. Nous avons quatre centres de données, avec environ 500 racks contenant plus de 8 000 serveurs. À un certain moment, nous avons réalisé que l'implémentation d'un nouveau système de gestion nous permettrait de mieux exploiter la technologie, de faciliter la gestion des accès, d'automatiser la (re)répartition des ressources calculatoires, d'accélérer le lancement de nouveaux services et d'améliorer les réactions lors de pannes majeures.
Alors, qu'est-ce que cela a donné ?
En plus de moi et du matériel, il y a aussi des gens qui travaillent avec cet équipement : des ingénieurs qui se trouvent directement dans les centres de données ; des réseaux qui configurent l'infrastructure réseau ; des admins, ou SRE, qui assurent la résilience de l'infrastructure ; et des équipes de développeurs, chacune responsable d'une partie des fonctionnalités du portail. Les logiciels qu'ils créent fonctionnent comme ceci :
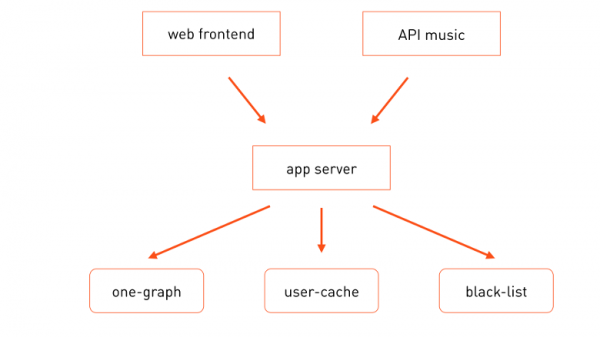
Les requêtes des utilisateurs arrivent à la fois sur les frontaux du portail principal , mais aussi sur d'autres, comme les frontaux de l'API musicale. Pour traiter la logique métier, ils appellent un serveur d'applications qui, en traitant la requête, appelle les microservices spécialisés nécessaires : one-graph (graph des relations sociales), user-cache (cache des profils utilisateurs), etc.
Chacun de ces services est déployé sur de nombreuses machines, et chacun d'eux a des développeurs responsables qui s'occupent du fonctionnement des modules, de leur exploitation et de leur développement technologique. Tous ces services sont déployés sur des serveurs physiques, et jusqu'à récemment, nous lancions exactement une tâche sur un serveur, c'est-à-dire qu'il était spécialisé pour une tâche spécifique.
Pourquoi cette approche ? Elle avait plusieurs avantages :
- Elle facilite la gestion de masse. Supposons qu'une tâche nécessite certaines bibliothèques, certaines configurations. Dans ce cas, le serveur est attribué à un groupe spécifique, une politique cfengine est décrite pour ce groupe (ou elle est déjà décrite), et cette configuration est déployée de manière centralisée et automatique sur tous les serveurs de ce groupe.
- Elle simplifie le diagnosticSupposons que vous observiez une charge accrue sur le CPU et que vous réalisiez que cette charge ne pourrait avoir été générée que par la tâche fonctionnant sur ce processeur physique. La recherche des responsables se termine très rapidement.
- Elle simplifie surveillanceSi quelque chose ne va pas avec le serveur, le moniteur en informe et vous savez exactement qui est à blâmer.
Un service composé de plusieurs réplicas se voit attribuer plusieurs serveurs — un pour chacun. Ainsi, la ressource de calcul pour le service est répartie très simplement : autant de serveurs que le service possède, autant il peut consommer de ressources au maximum. « Simple » ici ne signifie pas que c'est facile à utiliser, mais que la répartition des ressources se fait manuellement.
Cette méthode nous a également permis de réaliser des configurations matérielles spécialisées pour la tâche exécutée sur ce serveur. Si la tâche stocke de grands volumes de données, nous utilisons un serveur 4U avec un châssis de 38 disques. Si la tâche est purement computationnelle, nous pouvons acheter un serveur 1U moins cher. Cela est efficace en termes de ressources de calcul. De plus, cette méthode nous permet d'utiliser quatre fois moins de machines pour une charge comparable à celle d'un réseau social qui nous est amical.
Une telle efficacité dans l'utilisation des ressources de calcul devrait également garantir une efficacité économique, partant du principe que ce qui coûte le plus cher, ce sont les serveurs. Pendant longtemps, le matériel a été le plus coûteux, et nous avons investi beaucoup d'efforts pour réduire le prix du matériel en concevant des algorithmes de tolérance aux pannes afin de réduire les exigences en matière de fiabilité du matériel. Aujourd'hui, nous sommes arrivés à un stade où le prix du serveur ne constitue plus un facteur déterminant. Si l'on ne prend pas en compte les dernières excentricités, la configuration spécifique des serveurs dans le rack n'a pas d'importance. Nous avons désormais un autre problème — le coût de l'espace occupé par le serveur dans le datacenter, c'est-à-dire l'espace dans le rack.
Ayant réalisé cela, nous avons décidé de calculer à quel point nous utilisons efficacement les racks.
Nous avons pris le prix du serveur le plus puissant parmi ceux économiquement viables, calculé combien de ces serveurs nous pouvions placer dans les racks, combien de tâches nous pourrions y exécuter selon l'ancien modèle « un serveur = une tâche » et dans quelle mesure ces tâches pourraient utiliser le matériel. Les calculs ont été déchirants. Il s'est avéré que l'efficacité de l'utilisation des racks chez nous est d'environ 11 %. Le constat est clair : il faut améliorer l'efficacité d'utilisation des centres de données. À première vue, la solution paraît évidente : il faut exécuter plusieurs tâches sur un même serveur. Mais c'est là que commencent les complications.
La configuration de masse devient soudainement beaucoup plus complexe — il devient impossible d'attribuer un groupe unique à un serveur. En effet, plusieurs tâches de différentes équipes peuvent maintenant être exécutées sur un même serveur. De plus, la configuration peut être conflictuelle pour différentes applications. Le diagnostic devient également plus complexe : si vous constatez une utilisation accrue des processeurs ou des disques sur le serveur, vous ne savez pas quelle tâche pose problème.
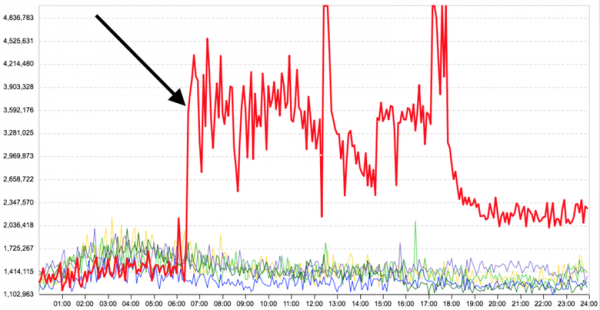
Mais le plus important, c'est qu'il n'y a pas d'isolation entre les tâches exécutées sur une même machine. Par exemple, voici le graphique du temps de réponse moyen d'une tâche serveur avant et après le lancement d'une autre application de calcul non liée sur le même serveur — le temps de réponse de la tâche principale a considérablement augmenté.
Il est évident qu'il faut exécuter les tâches soit dans des conteneurs, soit dans des machines virtuelles. Comme la plupart des tâches que nous exécutons fonctionnent sous un seul système d'exploitation (Linux) ou sont adaptées à celui-ci, il n'est pas nécessaire de gérer plusieurs systèmes d'exploitation différents. En conséquence, la virtualisation n'est pas nécessaire, car en raison des coûts supplémentaires, elle sera moins efficace que la conteneurisation.
En tant qu'implémentation de conteneurs pour exécuter des tâches directement sur les serveurs, Docker est un excellent candidat : les images des systèmes de fichiers résolvent efficacement les problèmes de configurations conflictuelles. Le fait que les images puissent être constituées de plusieurs couches nous permet de réduire considérablement le volume de données nécessaires à leur déploiement sur l'infrastructure, en isolant les parties communes dans des couches de base distinctes. Ainsi, les couches de base (et les plus volumineuses) seront rapidement mises en cache sur l'ensemble de l'infrastructure, et pour la livraison de divers types d'applications et versions, seules de petites couches devront être transmises.
De plus, le registre et le marquage des images dans Docker nous fournissent des primitives prêtes à l'emploi pour la version et la livraison de code en production.
Docker, comme toute autre technologie similaire, nous offre un certain niveau d'isolation des conteneurs par défaut. Par exemple, l'isolation par mémoire : chaque conteneur se voit attribuer une limite d'utilisation de la mémoire de la machine, au-delà de laquelle il ne pourra pas consommer. Il est également possible d'isoler les conteneurs en fonction de l'utilisation du CPU. Cependant, pour nous, l'isolation standard était insuffisante. Mais nous y reviendrons plus bas.
L'exécution directe des conteneurs sur les serveurs n'est qu'une partie des problèmes. L'autre partie concerne le placement des conteneurs sur les serveurs. Il faut comprendre quel conteneur peut être placé sur quel serveur. Ce n'est pas une tâche facile, car il faut disposer les conteneurs sur les serveurs aussi densément que possible, sans compromettre leur performance. Ce placement peut également être complexe en termes de résilience. Souvent, nous souhaitons placer des répliques du même service dans différents racks ou même dans différentes salles de données afin qu'en cas de défaillance d'un rack ou d'une salle, nous ne perdions pas toutes les répliques du service.
Distribuer des conteneurs manuellement n'est pas une option quand on a 8000 serveurs et 8000 à 16000 conteneurs.
De plus, nous voulions donner plus d'autonomie aux développeurs dans la distribution des ressources, afin qu'ils puissent déployer eux-mêmes leurs services en production, sans l'aide d'un administrateur. Tout en maintenant un contrôle, afin qu'un service secondaire ne consomme pas toutes les ressources de nos centres de données.
Il est évident qu'un niveau de gestion est nécessaire pour s'en occuper automatiquement.
Nous voilà arrivés à une image simple et claire, que tous les architectes adorent : trois carrés.
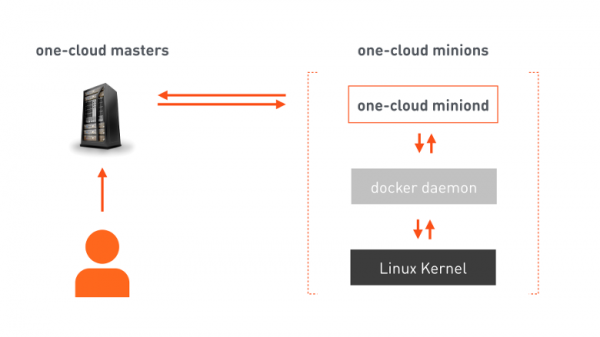
one-cloud masters — un cluster tolérant aux pannes, chargé de l'orchestration du cloud. Le développeur envoie au master un manifeste contenant toutes les informations nécessaires au déploiement du service. Sur cette base, le master donne des ordres aux minions sélectionnés (machines destinées à exécuter des conteneurs). Sur les minions, il y a notre agent, qui reçoit l'ordre, délivre ses propres commandes à Docker, et Docker configure le noyau Linux pour exécuter le conteneur correspondant. En plus d'exécuter les commandes, l'agent informe en continu le master des modifications d'état tant de la machine minion que des conteneurs qui y sont exécutés.
Distribution des ressources
Voyons maintenant une tâche plus complexe de distribution des ressources pour plusieurs minions.
Une ressource de calcul dans one-cloud est :
- La puissance de calcul du processeur utilisée par une tâche spécifique.
- La quantité de mémoire disponible pour la tâche.
- Le trafic réseau. Chacun des minions possède une interface réseau spécifique avec une bande passante limitée, il est donc impossible de distribuer des tâches sans tenir compte du volume de données qu'ils transmettent par le réseau.
- Disques. En plus, bien sûr, de l'espace pour les données de la tâche, nous spécifions également le type de disque : HDD ou SSD. Les disques peuvent servir un nombre final de requêtes par seconde — IOPS. Ainsi, pour les tâches qui génèrent plus d'IOPS que ce qu'un seul disque peut gérer, nous réservons également des « spindles » — c'est-à-dire des dispositifs de stockage qui doivent être exclusivement réservés pour la tâche.
Ainsi, pour un service comme user-cache, nous pouvons enregistrer les ressources consommées de cette manière : 400 cœurs de processeur, 2,5 To de mémoire, 50 Gb/s de trafic aller-retour, 6 To d'espace sur HDD, réparti sur 100 spindles. Ou de manière plus familière comme ceci :
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Les ressources du service user-cache ne consomment qu'une partie de toutes les ressources disponibles dans l'infrastructure de production. Il est donc souhaitable de s'assurer que, soudainement, à cause d'une erreur d'opérateur ou non, user-cache ne consomme pas plus de ressources que celles qui lui sont allouées. Nous devons donc limiter les ressources. Mais sur quoi pourrions-nous baser la quota ?
Retournons à notre schéma très simplifié d'interaction entre les composants et redessinons-le avec plus de détails — comme ceci :
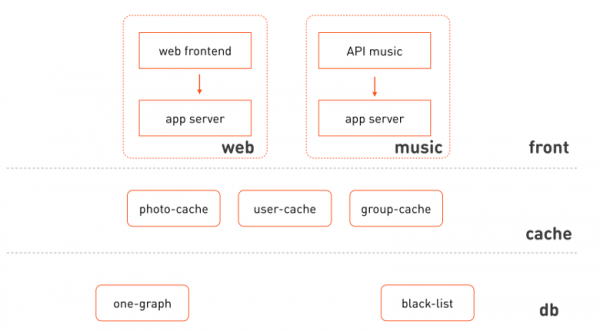
Ce qui frappe immédiatement :
- Le front-end web et la musique utilisent des clusters isolés du même serveur d'applications.
- On peut distinguer des couches logiques, auxquelles appartiennent ces clusters : les frontaux, les caches, la couche de stockage et de gestion des données.
- Le front-end est hétérogène, ce sont différents sous-systèmes fonctionnels.
- Les caches peuvent également être répartis selon le sous-système, dont ils mettent en cache les données.
Redessinons une fois de plus l'image :
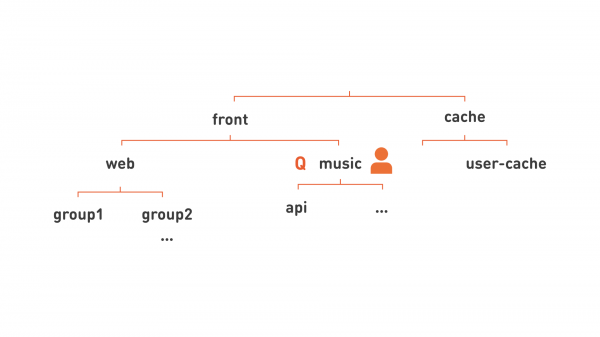
Oh ! Nous voyons une hiérarchie ! Cela signifie que nous pouvons distribuer les ressources par blocs plus importants : désigner un développeur responsable d’un nœud de cette hiérarchie, correspondant au sous-système fonctionnel (comme « musique » sur l'image), et lier une quota à ce même niveau hiérarchique. Une telle hiérarchie nous permet également d'organiser les services de manière plus flexible pour une meilleure gestion. Par exemple, tout le web, puisque c'est un très grand regroupement de serveurs, nous le divisons en plusieurs groupes plus petits, montrés sur l'image comme group1, group2.
En supprimant les lignes superflues, nous pouvons écrire chaque nœud de notre image de manière plus plate : group1.web.front, api.music.front, user-cache.cache.
Ainsi, nous arrivons au concept de « file d'attente hiérarchique ». Elle a un nom, comme « group1.web.front ». Une quota de ressources et des droits d'utilisateur y sont attribués. Une personne du DevOps recevra le droit de soumettre un service à la file d'attente, et cette personne pourra lancer quelque chose dans la file d'attente, alors qu'une personne de l'OpsDev — avec des droits d'administration — pourra gérer la file d'attente, y attribuer des personnes, donner des droits à ces personnes, etc. Les services lancés dans cette file d'attente seront exécutés dans le cadre de la quota de la file d'attente. Si la quota de calcul de la file d'attente est insuffisante pour exécuter simultanément tous les services, ils seront exécutés successivement, formant ainsi la file d'attente proprement dite.
Examinons les services de plus près. Un service a un nom complet, qui inclut toujours le nom de la file d'attente. Ainsi, le service du front web aura le nom ok-web.group1.web.front. Tandis que le service du serveur d'applications auquel il fait appel s'appellera ok-app.group1.web.front. Chaque service a un manifeste, qui contient toutes les informations nécessaires pour le déploiement sur des machines spécifiques : combien de ressources cette tâche consomme, quelle configuration elle nécessite, combien de répliques doivent exister, les propriétés pour la gestion des pannes de ce service. Après le déploiement du service sur les machines, ses instances apparaissent également. Elles sont aussi nommées de manière unique - par le numéro de l'instance et le nom du service : 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
C'est très pratique : en regardant uniquement le nom du conteneur en cours d'exécution, nous pouvons immédiatement en apprendre beaucoup.
Jetons maintenant un regard plus attentif à ce que ces instances effectuent réellement : les tâches.
Classes d'isolation des tâches
Toutes les tâches dans OK (et probablement ailleurs) peuvent être divisées en groupes :
- Tâches à faible latence - prod. Pour ces tâches et services, la latence de réponse est très importante, c'est-à-dire combien de temps chaque requête sera traitée par le système. Exemples de tâches : interfaces web, caches, serveurs d'applications, bases de données OLTP, etc.
- Tâches de calcul - batch. Ici, la vitesse de traitement de chaque requête individuelle n'est pas importante. Ce qui compte, c'est combien de calculs au total cette tâche effectuera sur une période donnée (grande). Cela inclura toutes les tâches MapReduce, Hadoop, apprentissage automatique, statistiques.
- Tâches en arrière-plan - idle. Pour ces tâches, ni la latence ni le débit ne sont très importants. Cela inclut divers tests, migrations, recalcule, conversions de données d'un format à un autre. D'une part, elles ressemblent aux tâches de calcul, mais d'autre part, nous nous soucions moins de la rapidité avec laquelle elles se termineront.
Voyons comment ces tâches consomment des ressources, par exemple, le processeur central.
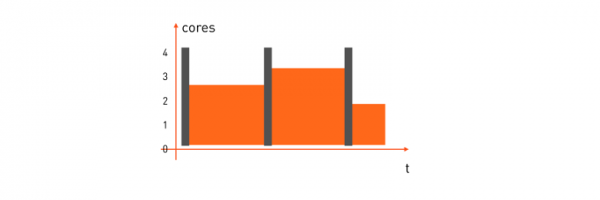
Tâches à faible latence. Pour une telle tâche, le modèle de consommation du CPU ressemblera à ceci :
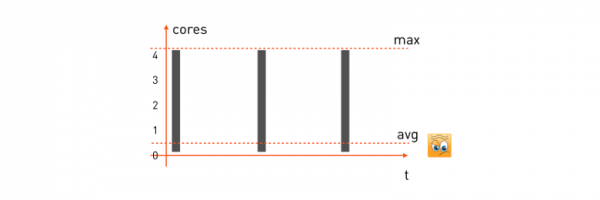
Une requête est reçue de l'utilisateur, la tâche commence à utiliser tous les cœurs de CPU disponibles, traite la requête, renvoie une réponse, attend la prochaine requête et reste inactive. Une nouvelle requête est reçue - encore une fois, elle utilise tout ce qui est disponible, traite, attend la suivante.
Pour garantir une latence minimale pour une telle tâche, nous devons prendre le maximum de ressources qu'elle consomme et réserver le nombre nécessaire de cœurs sur un minion (machine qui exécutera la tâche). La formule de réservation pour notre tâche sera donc :
alloc: cpu = 4 (max)Et si nous avons une machine-minion avec 16 cœurs, nous pouvons exécuter exactement quatre de ces tâches dessus. Il est particulièrement notable que la consommation moyenne du processeur pour ces tâches est souvent très faible — ce qui est évident, car une grande partie du temps, la tâche est en attente d'une requête et ne fait rien.
Tâches de calcul. Elles auront un motif quelque peu différent :
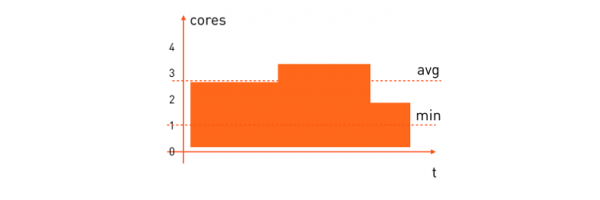
La consommation moyenne des ressources processeur pour ces tâches est assez élevée. Fréquemment, nous souhaitons que la tâche de calcul soit réalisée dans un certain délai, il est donc nécessaire de réserver un minimum de cœurs de processeur nécessaires pour que tout le calcul se termine dans un délai acceptable. Sa formule de réservation ressemblera alors à :
alloc: cpu = [1,*)«Veuillez allouer sur le minion où il y a au moins un cœur libre, et ensuite, tout ce qu'il y a — ça prendra tout».
Ici, l'efficacité d'utilisation est déjà significativement meilleure que pour les tâches à court délai. Mais le gain sera bien plus important si nous combinons les deux types de tâches sur une seule machine-minion et répartissons ses ressources à la volée. Quand une tâche à court délai nécessite un processeur — elle l'obtient immédiatement, et lorsque les ressources ne sont plus nécessaires — elles sont transférées à la tâche de calcul, c'est-à-dire un peu comme ça :
Mais comment faire cela ?
Pour commencer, examinons prod et son alloc: cpu = 4. Nous devons réserver quatre cœurs. Dans Docker run, cela peut être fait de deux manières :
- Avec l'option
--cpuset=1-4, c'est-à-dire allouer à la tâche quatre cœurs spécifiques sur la machine. - Utiliser
--cpuquota=400_000 --cpuperiod=100_000, assigner un quota de temps processeur, c'est-à-dire spécifier que pour chaque 100 ms de temps réel, la tâche consomme pas plus de 400 ms de temps processeur. Cela revient aux mêmes quatre cœurs.
Mais lequel de ces moyens conviendra ?
Le cpuset a une apparence plutôt attrayante. La tâche dispose de quatre cœurs dédiés, ce qui signifie que les caches du processeur fonctionneront de manière optimale. Cependant, cela a un revers : nous devrions nous charger de la répartition des calculs sur les cœurs de la machine qui ne sont pas sollicités au lieu de le faire par l'OS, ce qui est une tâche assez non triviale, surtout si nous essayons de placer des tâches batch sur cette machine. Les tests ont montré que l'option avec quota est plus adaptée ici : cela donne à l'opérateur du système d'exploitation plus de liberté pour choisir le cœur à utiliser pour la tâche à ce moment précis, et le temps processeur est réparti plus efficacement.
Voyons comment faire une réservation de cœur minimum dans docker. Le quota pour les tâches batch n'est plus applicable, car limiter un maximum n'est pas nécessaire, il suffit de garantir un minimum. Et à cet égard, l'option convient bien docker run --cpushares.
Nous avons convenu que si un batch nécessite une garantie minimum sur un cœur, nous spécifions --cpushares=1024, et si c'est un minimum sur deux cœurs, nous indiquons --cpushares=2048. Les cpu shares n'interfèrent pas avec la répartition du temps processeur tant qu'il est suffisant. Ainsi, si le prod n'utilise pas tous ses quatre cœurs à ce moment-là, rien ne limite les tâches batch, et elles peuvent utiliser du temps processeur supplémentaire. En revanche, en cas de pénurie de processeur, si le prod a consommé tous ses quatre cœurs et atteint le quota, le temps processeur restant sera réparti proportionnellement aux cpu shares, c'est-à-dire que dans le cas de trois cœurs libres, une tâche avec 1024 cpu shares obtiendra un cœur, tandis que les deux autres iront à une tâche avec 2048 cpu shares.
Mais l'utilisation des quotas et des shares n'est pas suffisante. Nous devons veiller à ce qu'une tâche à latence courte soit priorisée par rapport à une tâche batch lors de la répartition du temps processeur. Sans cette priorisation, la tâche batch prendra tout le temps processeur au moment où il est nécessaire pour le prod. Dans Docker run, il n'y a aucune option de priorisation des conteneurs, mais les politiques de planification du processeur dans Linux viennent à la rescousse. Vous pouvez lire en détail à leur sujet , et dans cet article, nous les parcourrons brièvement :
- SCHED_OTHER
Par défaut, tous les processus utilisateurs normaux sur la machine Linux reçoivent cela. - SCHED_BATCH
Destinée aux processus gourmands en ressources. Lorsqu'une tâche est placée dans le processeur, il y a ce qu'on appelle une pénalité d'activation : une telle tâche a moins de chances d'obtenir les ressources du processeur si, à ce moment, une tâche avec SCHED_OTHER utilise le processeur. - SCHED_IDLE
Un processus en arrière-plan avec une priorité très basse, même inférieure à nice –19. Nous utilisons notre bibliothèque open source , pour définir la politique nécessaire lors du lancement d'un conteneur via l'appel
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Mais même si vous ne programmez pas en Java, vous pouvez faire la même chose en utilisant la commande chrt :
chrt -i 0 $pidRassemblons tous nos niveaux d'isolation dans un tableau pour plus de clarté :
Classe d'isolation
Exemple alloc
Options Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Si vous faites chrt depuis l'intérieur du conteneur, la capacité sys_nice peut être nécessaire, car par défaut Docker retire cette capacité lors du lancement du conteneur.
Mais les tâches consomment non seulement du processeur, mais aussi du trafic, ce qui impacte encore plus la latence des tâches réseau que la répartition incorrecte des ressources CPU. Par conséquent, nous voulons naturellement obtenir la même visualisation pour le trafic. C'est-à-dire, lorsque la tâche prod envoie des paquets sur le réseau, nous quotaillons la vitesse maximale (formule alloc: lan=[*,500mbps) ), avec laquelle prod peut le faire. Pour batch, nous garantissons uniquement une capacité minimale, sans limiter le maximum (formule alloc: lan=[10Mbps,* ) ) En même temps, le trafic prod doit avoir la priorité sur les tâches batch.
Ici, Docker n'a pas de primitives que nous pourrions utiliser. Mais nous avons l'aide de . Nous avons pu obtenir le résultat souhaité grâce à la discipline . Grâce à cela, nous mettons en avant deux classes de trafic : prod à haute priorité et batch/idle à basse priorité. Au final, la configuration pour le trafic sortant est la suivante :
ici 1:0 — «qdisc racine» de la discipline hsfc ; 1:1 — classe fille hsfc avec une limite de bande passante globale de 8 Gbit/s, sous laquelle se trouvent les classes filles de tous les conteneurs ; 1:2 — classe fille hsfc commune à toutes les tâches batch et idle avec une limite « dynamique », comme expliqué ci-dessous. Les autres classes filles hsfc sont des classes dédiées pour les conteneurs prod actifs avec des limites correspondant à leurs manifestes, — 450 et 400 Mbit/s. Chaque classe hsfc se voit attribuer une queue qdisc fq ou fq_codel, selon la version du noyau linux, afin d'éviter les pertes de paquets lors des pics de trafic.
En général, les disciplines tc servent à prioriser uniquement le trafic sortant. Mais nous voulons également prioriser le trafic entrant — car une tâche batch peut facilement utiliser toute la bande passante entrante, par exemple en recevant un gros paquet de données d'entrée pour map&reduce. Pour cela, nous utilisons le module , qui crée une interface virtuelle ifbX pour chaque interface réseau et redirige le trafic entrant de l'interface vers le sortant sur ifbX. Ensuite, pour ifbX, toutes les mêmes disciplines de contrôle du trafic sortant s'appliquent, pour lesquelles la configuration hsfc sera très similaire :
Au cours des expériences, nous avons constaté que les meilleurs résultats de hsfc sont obtenus lorsque la classe 1:2 pour le trafic batch/idle non prioritaire est limitée sur les machines-minions à une certaine bande passante disponible. Sinon, le trafic non prioritaire influence trop la latence des tâches prod. La valeur actuelle de la bande passante disponible est déterminée par miniond chaque seconde, en mesurant la consommation moyenne de trafic de toutes les tâches prod de ce minion  et en la soustrayant de la bande passante de l'interface réseau
 avec une légère marge, c'est-à-dire.

Les bandes sont définies de manière indépendante pour le trafic entrant et sortant. Et en fonction des nouvelles valeurs, miniond reconfigure la limite de la classe 1:2 non prioritaire.
Ainsi, nous avons mis en œuvre les trois classes d'isolation : prod, batch et idle. Ces classes ont un impact important sur les performances des tâches. Par conséquent, nous avons décidé de placer ce critère en haut de la hiérarchie, afin qu'en regardant le nom de la queue hiérarchique, on puisse immédiatement comprendre de quoi il s'agit :
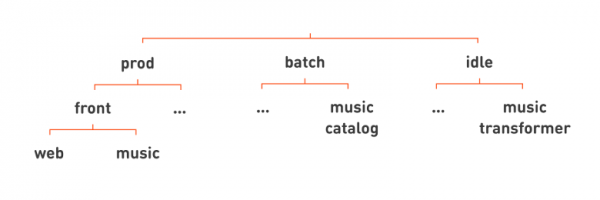
Tous nos fronts familiers web et music sont alors placés dans la hiérarchie sous prod. Par exemple, plaçons le service sous batch music catalog, qui établit périodiquement un catalogue de titres à partir de la collection de fichiers mp3 téléchargés sur « Odnoklassniki ». Un exemple de service idle pourrait être transformateur de musique, normalisant le niveau de volume de la musique.
Encore une fois, en supprimant les lignes superflues, nous pouvons écrire les noms de nos services de manière plus plate, en ajoutant la classe d'isolation de la tâche à la fin du nom complet du service : web.front.prod, catalog.music.batch, transformer.music.idle.
Et maintenant, en regardant le nom du service, nous comprenons non seulement la fonction qu'il remplit, mais aussi sa classe d'isolation, ce qui signifie sa criticité, etc.
Tout est formidable, mais il y a une dure vérité. Il est impossible d'isoler complètement les tâches fonctionnant sur une seule machine.
Ce que nous avons réussi à accomplir : si le batch consomme intensivement uniquement des ressources processeur, le planificateur de CPU de Linux gère très bien sa tâche, et l'impact sur la tâche prod est presque nul. Mais si cette tâche batch commence à travailler activement avec la mémoire, alors l'influence mutuelle se manifeste déjà. Cela se produit parce que la tâche prod a ses caches processeur « vidés » — en fin de compte, le nombre de défauts dans le cache augmente, et le processeur traite la tâche prod plus lentement. Une telle tâche batch peut augmenter les latences de notre conteneur prod typique de 10 %.
Isoler le trafic est encore plus difficile à cause du fait que les cartes réseau modernes possèdent une file d'attente interne de paquets. Si un paquet d'une tâche batch est le premier à y entrer, alors il sera le premier à être envoyé par câble, et il n'y a rien à faire.
De plus, nous avons pour l'instant uniquement réussi à résoudre le problème de priorisation du trafic TCP : pour UDP, l'approche avec hsfc ne fonctionne pas. Et même dans le cas du trafic TCP, si la tâche batch génère beaucoup de trafic, cela entraîne également une augmentation d'environ 10 % de la latence de la tâche prod.
Résilience
L'un des objectifs lors du développement de one-cloud était d'améliorer la résistance aux pannes d'Odnoklassniki. Par conséquent, j'aimerais examiner plus en détail les scénarios possibles de pannes et d'incidents. Commençons par un scénario simple — la panne d'un conteneur.
Un conteneur peut échouer de plusieurs manières. Cela peut être dû à une expérience, un bug ou une erreur dans le manifeste, ce qui fait que la tâche prod commence à consommer plus de ressources que celles spécifiées dans le manifeste. Nous avons eu un cas : un développeur a mis en œuvre un algorithme complexe, l'a plusieurs fois modifié, s'est perdu dans ses propres optimisations et, en fin de compte, la tâche s'est retrouvée à s'exécuter en boucle de manière assez non triviale. Et puisque la tâche prod est prioritaire par rapport à toutes les autres sur les mêmes minions, elle a commencé à consommer toutes les ressources processeur disponibles. Dans cette situation, l'isolation a sauvé la mise, ou plutôt le quota de temps processeur. Si un quota est attribué à la tâche, celle-ci ne consommera pas plus. Ainsi, les tâches batch et autres tâches prod qui fonctionnaient sur la même machine n'ont rien remarqué.
Le deuxième problème possible est l'arrêt du conteneur. Et ici, nous sommes sauvés par les politiques de redémarrage, que tout le monde connaît, Docker gère cela très bien. Pratiquement toutes les tâches prod ont une politique de redémarrage toujours. Parfois, nous utilisons on_failure pour les tâches batch ou pour le débogage des conteneurs prod.
Que peut-on faire en cas d'indisponibilité d'un minion entier ?
Évidemment, lancer le conteneur sur une autre machine. L'aspect intéressant ici est ce qui se passe avec l'adresse IP (les adresses) assignées au conteneur.
Nous pouvons attribuer aux conteneurs les mêmes adresses IP que celles des machines-minions sur lesquelles ces conteneurs sont lancés. Donc, lors du lancement du conteneur sur une autre machine, son adresse IP change, et tous les clients doivent comprendre que le conteneur a déménagé, il faut maintenant se rendre à une autre adresse, ce qui nécessite un service de découverte de services.
La découverte de services est pratique. Il existe sur le marché de nombreuses solutions de différents niveaux de tolérance aux pannes pour l'organisation d'un registre de services. Souvent, ces solutions intègrent la logique d'un équilibreur de charge, le stockage de configurations supplémentaires sous forme de KV-store, etc.
Cependant, nous aimerions éviter la nécessité d'implémenter un registre séparé, car cela impliquerait l'introduction d'un système critique utilisé par tous les services en production. Cela signifie donc un potentiel point de défaillance, et nous devons choisir ou développer une solution très résiliente, ce qui est évidemment très difficile, long et coûteux.
Un autre inconvénient majeur : pour que notre ancienne infrastructure fonctionne avec la nouvelle, il aurait fallu réécrire toutes les tâches pour utiliser un système de découverte de services. Cela représente un travail ENORME, et parfois quasiment impossible, surtout lorsqu'il s'agit de dispositifs bas-niveau fonctionnant au niveau du noyau OS ou directement avec le matériel. La mise en œuvre de cette fonctionnalité à l'aide de modèles de solutions établis, tels que signifierait parfois une charge supplémentaire, parfois une complexité accrue et des scénarios d'échec supplémentaires. Nous ne voulions pas complexifier les choses, donc nous avons décidé de rendre l'utilisation de la découverte de services optionnelle.
Dans one-cloud, l'IP suit le conteneur, c'est-à-dire que chaque instance de tâche a sa propre adresse IP. Cette adresse est "statique" : elle est attribuée à chaque instance au moment de la première mise en service dans le cloud. Si, au cours de sa vie, le service a eu un nombre variable d'instances, alors à la fin, autant d'adresses IP seront attribuées qu'il y a eu d'instances au maximum.
Par la suite, ces adresses ne changent pas : elles sont attribuées une fois et restent valides pendant toute la durée de vie du service en production. Les adresses IP suivent les conteneurs sur le réseau. Si un conteneur est déplacé vers un autre minion, l'adresse le suivra.
Ainsi, l'association entre le nom du service et la liste de ses adresses IP change très rarement. Si l'on regarde à nouveau les noms des instances de service que nous avons mentionnés au début de l'article (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), nous pouvons remarquer qu'ils ressemblent à des FQDN utilisés dans le DNS. C'est en effet le cas, nous utilisons le protocole DNS pour afficher les noms des instances de services dans leurs adresses IP. De plus, ce DNS renvoie toutes les adresses IP réservées de tous les conteneurs, qu’ils soient en cours d’exécution ou arrêtés (par exemple, si trois répliques sont utilisées et que cinq adresses sont réservées, toutes les cinq seront renvoyées). Les clients, après avoir reçu cette information, essaieront de se connecter à toutes les cinq répliques, déterminant ainsi celles qui sont opérationnelles. Cette méthode de détermination de la disponibilité est beaucoup plus fiable, car elle n'implique ni DNS ni Service Discovery, ce qui élimine les problèmes complexes d’actualisation des informations et de résilience de ces systèmes. De plus, pour les services critiques dont dépend le fonctionnement de l'ensemble du portail, nous pouvons ne pas utiliser le DNS du tout et simplement inscrire les adresses IP dans la configuration.
La mise en œuvre d'un tel transfert d'IP derrière des conteneurs peut être non triviale — et nous nous baserons sur un exemple pour expliquer comment cela fonctionne :
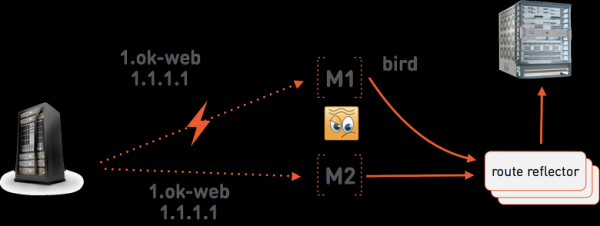
Supposons que le maître one-cloud donne l'ordre au minion M1 de lancer 1.ok-web.group1.web.front.prod avec l'adresse 1.1.1.1. Sur le minion, il fonctionne , qui annonce cette adresse sur des serveurs spéciaux . Ces derniers ont une session BGP avec le matériel réseau, à laquelle le chemin de l'adresse 1.1.1.1 sur M1 est diffusé. M1, quant à lui, achemine les paquets vers l'intérieur du conteneur en utilisant les outils Linux. Il y a trois serveurs route reflector, car cet élément de l'infrastructure one-cloud est très critique — sans eux, le réseau dans one-cloud ne fonctionnera pas. Nous les plaçons dans différentes baies, idéalement situées dans des salles différentes du centre de données, afin de réduire la probabilité d'une panne simultanée des trois.
Supposons maintenant que la connexion entre le maître one-cloud et le minion M1 ait été perdue. Le maître one-cloud agira désormais en supposant que M1 a complètement échoué. En d'autres termes, il donnera l'ordre au minion M2 de lancer web.group1.web.front.prod avec la même adresse 1.1.1.1. Nous avons maintenant deux routes conflictuelles dans le réseau pour 1.1.1.1 : sur M1 et sur M2. Pour résoudre de tels conflits, nous utilisons le Multi Exit Discriminator, qui est spécifié dans l'annonce BGP. C'est un nombre qui indique le poids de la route annoncée. Parmi les routes conflictuelles, celle avec la valeur MED la plus basse sera choisie. Le maître one-cloud prend en charge le MED comme partie intégrante des adresses IP des conteneurs. La première fois, l'adresse est annoncée avec un MED suffisamment élevé = 1 000 000. Dans une situation de migration d'urgence du conteneur, le maître réduit le MED, et M2 reçoit déjà l'ordre d'annoncer l'adresse 1.1.1.1 avec MED = 999 999. L'instance fonctionnant sur M1 restera sans connexion, et son sort ne nous intéresse guère jusqu'à ce que la connexion avec le maître soit rétablie, moment où elle sera arrêtée en tant qu'ancien doublon.
Pannes
Tous les systèmes de gestion des data centers gèrent toujours de manière acceptable les petites pannes. La défaillance d'un conteneur est une norme presque partout.
Examinons comment nous gérons une panne, par exemple, une coupure de courant dans une ou plusieurs salles de data center.
Que signifie une panne pour le système de gestion des data centers ? Avant tout, cela représente une défaillance massive et simultanée de nombreux ordinateurs, et le système de gestion doit simultanément migrer un grand nombre de conteneurs. Cependant, si la panne est très vaste, il se peut que toutes les tâches ne puissent pas être relocalisées sur d'autres minions, car la capacité des ressources du data center tombe en dessous de 100 % de charge.
Souvent, les pannes s'accompagnent d'une défaillance de la couche de gestion. Cela peut se produire en raison de la défaillance de son matériel, mais plus souvent parce que les pannes ne sont pas testées, et la couche de gestion s'effondre elle-même sous la charge accrue.
Que peut-on faire avec tout cela ?
Les migrations massives signifient qu'un grand nombre d'actions, de migrations et de placements ont lieu dans l'infrastructure. Chacune des migrations peut nécessiter du temps pour livrer et déballer les images des conteneurs aux minions, démarrer et initialiser les conteneurs, etc. Il est donc souhaitable que les tâches les plus importantes soient lancées avant celles qui le sont moins.
Revenons à notre hiérarchie familière des services et essayons de décider quelles tâches nous souhaitons lancer en premier.
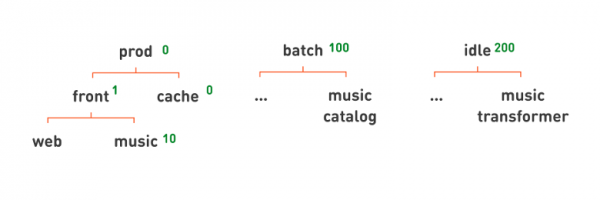
Bien sûr, ce sont les processus qui participent directement au traitement des demandes des utilisateurs, c'est-à-dire le prod. Nous le signalons par priorité de placement — un nombre qui peut être attribué à la file d'attente. Si une file a une priorité plus élevée, ses services sont placés en premier.
Dans le prod, nous attribuons des priorités plus élevées, 0 ; dans le batch — un peu plus bas, 100 ; dans l’idle — encore plus bas, 200. Les priorités s'appliquent de manière hiérarchique. Toutes les tâches inférieures dans la hiérarchie auront la priorité correspondante. Si nous voulons que les caches se lancent avant les frontends dans le prod, nous attribuons des priorités sur le cache = 0 et sur le front en sous-file = 1. Si nous voulons que, par exemple, le portail principal se lance avant le frontend musical, nous pouvons attribuer une priorité plus basse à ce dernier — 10.
Le problème suivant est le manque de ressources. Ainsi, nous avons subi une panne d'un grand nombre de serveurs, des salles entières dans le data center, et nous avons lancé tant de services qu'il n'y a plus de ressources pour tous. Il faut décider quelles tâches sacrifier pour faire fonctionner les principales services critiques.
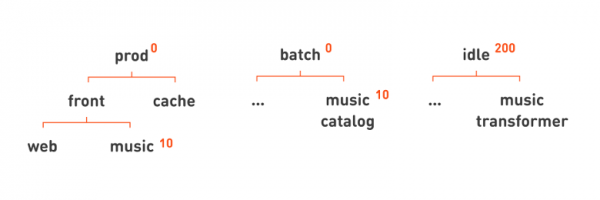
Contrairement à la priorité de placement, nous ne pouvons pas sacrifier toutes les tâches batch sans distinction, certaines d'entre elles sont importantes pour le fonctionnement du portail. C'est pourquoi nous avons mis en place une priorité distincte d'éviction des tâches. Lors de l'attribution, une tâche avec une priorité plus élevée peut évincer, c'est-à-dire arrêter une tâche avec une priorité plus basse, s'il n'y a plus de minions disponibles. Dans ce cas, la tâche avec une priorité inférieure restera probablement non allouée, c'est-à-dire qu'il n'y aura plus de minion adapté avec suffisamment de ressources libres.
Dans notre hiérarchie, il est très simple d'indiquer une telle priorité d'éviction, pour que les tâches prod et batch évincient ou arrêtent les tâches idle, mais pas entre elles, en attribuant une priorité de 200 à idle. Tout comme dans le cas de la priorité de placement, nous pouvons utiliser notre hiérarchie pour décrire des règles plus complexes. Par exemple, spécifions que nous sacrifierons la fonction de musique si nous manquons de ressources pour le portail web principal, en fixant une priorité plus basse pour les nœuds correspondants : 10.
Pannes de data center en entier
Pourquoi un data center entier peut-il tomber en panne ? Événements naturels. Il y avait un bon post sur la façon dont . On peut considérer que la communauté des sans-abris a brûlé un câble en fibre optique dans un collecteur, ce qui a entraîné une perte totale de connexion entre le centre de données et les autres sites. Une défaillance peut également être causée par le facteur humain : un opérateur peut donner une commande qui fera tomber tout le centre de données. Cela peut se produire à cause d'un bug majeur. En somme, les centres de données tombent en panne — ce n'est pas rare. Cela se produit chez nous environ tous les quelques mois.
Et voici ce que nous faisons pour que personne #окживи ne publie sur Twitter.
La première stratégie est l'isolation. Chaque instance one-cloud est isolée et ne peut gérer que des machines d'un seul centre de données. Par conséquent, la perte d'un cloud à cause de bugs ou d'une mauvaise commande de l'opérateur ne concerne qu'un seul centre de données. Nous sommes prêts pour cela : nous avons une politique de sauvegarde qui place les répliques d'applications et de données dans tous les centres de données. Nous utilisons des bases de données tolérantes aux pannes et testons périodiquement les défaillances.
Puisque nous avons aujourd'hui quatre centres de données, cela signifie également quatre instances one-cloud séparées et entièrement isolées.
Cette approche non seulement protège contre les pannes physiques, mais peut également protéger contre les erreurs de l'opérateur.
Que peut-on d'autre faire face au facteur humain ? Lorsque l'opérateur donne au cloud une commande étrange ou potentiellement dangereuse, il peut soudainement être invité à résoudre une petite tâche pour vérifier à quel point il a bien réfléchi. Par exemple, s'il s'agit d'un arrêt massif de nombreuses répliques ou d'une simple commande étrange — réduire le nombre de répliques ou changer le nom de l'image, et non simplement le numéro de version dans le nouveau manifeste.
Résultats
Les caractéristiques distinctives de one-cloud :
- Un schéma hiérarchique et clair de nommage des services et des conteneurs, qui permet de savoir très rapidement de quelle tâche il s'agit, à quoi elle se rapporte, comment cela fonctionne et qui en est responsable.
- Nous appliquons notre technique de combinaison des tâches prod- et batch-sur les minions pour améliorer l'efficacité du partage des ressources. Au lieu de cpuset, nous utilisons des quotas CPU, des parts, des politiques de planification CPU et Linux QoS.
- Nous n'avons pas réussi à isoler complètement les conteneurs fonctionnant sur une seule machine, mais leur influence mutuelle reste dans une limite de 20 %.
- L'organisation des services en hiérarchie aide lors de l'élimination automatique des pannes grâce aux priorités de placement et d'éviction..
FAQ
Pourquoi nous n'avons pas choisi une solution prête à l'emploi.
- Différents classes d'isolation des tâches nécessitent une logique différente lors de leur placement sur des machines virtuelles. Alors que les tâches de production peuvent être placées par simple réservation des ressources, les tâches batch et idle doivent être placées en surveillant l'utilisation réelle des ressources sur les machines.
- La nécessité de prendre en compte les ressources consommées par ces tâches, telles que :
- la bande passante réseau;
- les types et les "spindles" des disques.
- La nécessité d'indiquer les priorités des services lors de l'élimination des pannes, ainsi que les droits et quotas des équipes sur les ressources, ce qui se résout grâce à des files d'attente hiérarchiques dans one-cloud.
- La nécessité d'avoir une nomenclature humaine pour faciliter le temps de réaction aux pannes et incidents.
- L'impossibilité de déployer simultanément Service Discovery à grande échelle ; la nécessité de coexister longtemps avec des tâches exécutées sur des serveurs physiques — cela se résout par des adresses IP "statiques" suivant les conteneurs, et par conséquent, la nécessité d'une intégration unique avec une grande infrastructure réseau.
Toutes ces fonctions nécessiteraient d'importantes modifications des solutions existantes, et après avoir évalué la charge de travail, nous avons réalisé que nous pourrions développer notre propre solution avec des efforts similaires. Cependant, notre solution serait beaucoup plus simple à exploiter et à développer — elle ne contient pas d'abstractions inutiles soutenant des fonctionnalités dont nous n'avons pas besoin.
À ceux qui lisent ces dernières lignes, merci pour votre patience et votre attention !
Source : habr.com
