

 Nous publions à nouveau la transcription de la présentation lors de la conférence de 2016, qui s'est tenue à Skolkovo, près de Moscou, les 7 et 8 novembre de l'année dernière. explique comment étendre les fonctionnalités de NGINX avec OpenResty et Lua.
Bonjour à tous, je m'appelle Vladimir Protasov, je travaille chez Parallels. Permettez-moi de me présenter. J'ai passé les trois quarts de ma vie à écrire du code. Je suis devenu programmeur dans tous les sens du terme : parfois, je vois du code même dans mes rêves. Le quart de ma vie est dédié au développement industriel, l'écriture de code qui va directement en production. Le code que certains d'entre vous utilisent sans même s'en rendre compte.
Pour que vous compreniez à quel point c'était difficile. Quand j'étais un jeune junior, je suis arrivé, et on m'a donné des bases de données de deux téraoctets. Maintenant, tout le monde ici a des charges élevées. J'allais aux conférences, demandant : « Les gars, parlez-moi de votre big data, c'est génial ? Quelle taille ont vos bases ? » Ils répondaient : « Nous avons 100 gigaoctets ! » Je disais : « Super, 100 gigaoctets ! » Et en pensant pour moi-même, comment garder un visage impassible. Vous vous dites, oui, ces gars-là sont impressionnants, puis vous revenez et vous luttez avec ces bases de données multi-téraoctets. Et c'était quand j'étais junior. Vous imaginez quel coup c'était ?
Je connais plus de 20 langages de programmation. C'est ce avec quoi j'ai dû m'attaquer au travail. On vous donne du code en Erlang, en C, en C++, en Lua, en Python, en Ruby, et vous devez tout traiter. En gros, il a fallu s'en occuper. Je n'ai jamais pu compter avec précision, mais j'ai perdu le compte autour de 20.
Puisque tout le monde ici sait ce qu'est Parallels et ce que nous faisons, je ne vais pas parler de notre génialité et de nos activités. Je vais simplement dire que nous avons 13 bureaux dans le monde, plus de 300 employés, avec le développement à Moscou, à Tallinn et à Malte. Si vous souhaitez, vous pouvez déménager à Malte, si l'hiver est trop froid et que vous voulez vous réchauffer.
Notre département écrit spécifiquement en Python 2. Nous sommes en affaires et nous n'avons pas le temps d'implémenter des technologies à la mode, donc nous en souffrons. Nous avons Django, car il a tout ce dont nous avons besoin, et nous avons simplement écarté l'excès. Également MySQL, Redis et NGINX. Nous avons aussi beaucoup d'autres outils intéressants. Nous avons MongoDB, des lapins qui courent, nous avons de tout — mais ce n'est pas moi qui m'en occupe.
OpenResty
J'ai parlé de moi. Voyons maintenant de quoi je vais parler aujourd'hui :
- Qu'est-ce qu'OpenResty et à quoi ça sert ?
- Pourquoi réinventer la roue alors que nous avons Python, NodeJS, PHP, Go et d'autres outils formidables dont tout le monde est satisfait ?
- Et un petit exemple de la vie réelle. J'ai dû réduire considérablement ma présentation car elle durait 3,5 heures, donc il y aura peu d'exemples.
OpenResty est NGINX. Grâce à lui, nous avons un serveur web complet, bien écrit et rapide. Je pense que la plupart d'entre nous utilisent NGINX en production. Vous savez tous qu'il est rapide et formidable. Il inclut une entrée/sortie synchronisée de qualité, donc nous n'avons pas besoin de réinventer la roue comme ce fut le cas avec gevent en Python. Gevent est super, génial, mais si vous écrivez du code en C et que quelque chose ne va pas, vous aurez du mal à le déboguer avec gevent. J'ai eu cette expérience : il m'a fallu deux jours pour comprendre ce qui n'allait pas. Si quelqu'un n'avait pas fouillé pendant plusieurs semaines pour trouver le problème, ne l'avait pas publié sur Internet et que Google ne l'ait pas trouvé, nous aurions complètement perdu les pédales.
NGINX gère déjà le cache et le contenu statique. Vous n'avez pas besoin de vous casser la tête sur la manière de le faire correctement, afin qu'il n'y ait pas de ralentissements ou que vous ne perdiez pas de descripteurs. Nginx est très pratique à déployer, vous ne devez pas vous soucier de quel outil utiliser — WSGI, PHP-FPM, Gunicorn, Unicorn. Nginx est installé, remis aux administrateurs, qui savent comment travailler avec. Nginx traite les requêtes de manière structurée. J'en parlerai un peu plus tard. En résumé, il y a une phase lorsque la requête est reçue, une autre lorsque elle est traitée, et enfin lorsque le contenu est envoyé à l'utilisateur.
Nginx est génial, mais il a un petit problème : il n'est pas assez flexible, même avec toutes les fonctionnalités impressionnantes que les développeurs ont intégrées dans la configuration, malgré les possibilités de personnalisation. Cette puissance manque. C'est pourquoi les développeurs de Taobao ont intégré Lua il y a longtemps, il me semble il y a huit ans. Que permet-il ?
- Taille. Il est léger. LuaJIT ajoute environ 100-200 Ko de surcharge mémoire et une surcharge minimale en termes de performance.
- Vitesse. L'interpréteur LuaJIT est proche de C dans de nombreuses situations, dans certains cas, il est moins performant que Java, et dans d'autres, il la devance. Pendant un certain temps, il était considéré comme le meilleur, un compilateur JIT exceptionnel. Actuellement, il existe des compilateurs plus performants, mais ils sont très lourds, comme V8. Certains interprètes JavaScript et le HotSpot de Java sont plus rapides dans certains cas, mais restent encore lents dans d'autres.
- Simplicité d'apprentissage. Si par exemple, vous avez une base de code en Perl et que vous n'êtes pas Booking, vous ne trouverez pas de programmeurs Perl. Parce qu'ils n'existent pas, tous ont été récupérés et il est long et difficile de les former. Si vous recherchez des programmeurs dans un autre langage, il se peut que vous deviez également les requalifier ou les trouver. Pour Lua, c'est simple. Un développeur junior peut apprendre Lua en trois jours. Il m'a fallu environ deux heures pour le comprendre. Après deux heures, j'écrivais déjà du code en production. Environ une semaine plus tard, il a été mis en production.
En conséquence, cela ressemble à ceci :
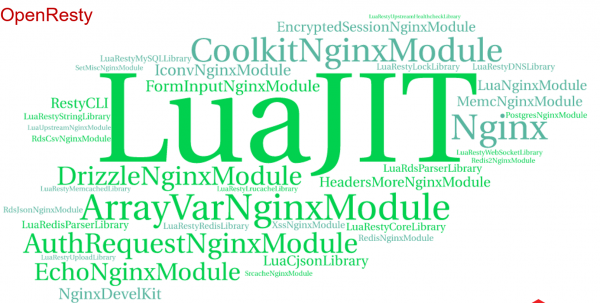
Il y a beaucoup de choses ici. OpenResty a regroupé des modules, à la fois Lua et Engine. Et tout est prêt - déployé et ça fonctionne.
Exemples
Assez de lyrisme, passons au code. Voici un petit Hello World :
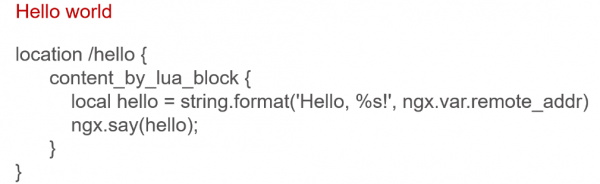
Qu'y a-t-il ici ? C'est un location d'Engine. Nous ne nous compliquons pas la vie, nous n'écrivons pas notre propre routage, nous n'utilisons pas un routage déjà existant - nous avons déjà ça dans NGINX, nous vivons bien et paresseusement.
content_by_lua_block – c'est un bloc qui indique que nous livrons le contenu à l'aide d'un script Lua. Nous prenons la variable d'Engine remote_addr et nous l'insérons dans string.format. C'est la même chose que sprintf, mais en Lua, seulement correcte. Et nous le fournissons au client.
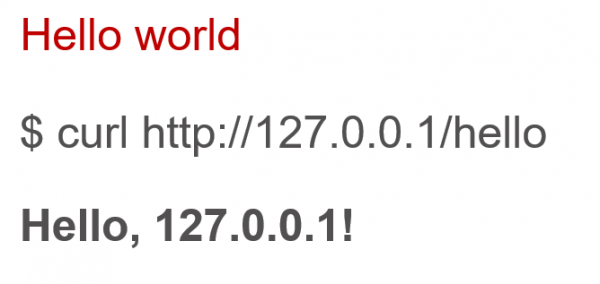
En conséquence, cela apparaîtra comme ceci :
Mais revenons au monde réel. En production, personne ne déploie Hello World. Nos applications vont généralement se connecter à une base de données ou à un autre service et passent la plupart du temps à attendre une réponse.
Elles attendent simplement. Ce n'est pas très efficace. Lorsque 100 000 utilisateurs arrivent, c'est très difficile pour nous. Donc, prenons comme exemple une application simple. Nous allons chercher des images, par exemple, de chats. Mais nous ne allons pas simplement chercher, nous allons élargir les mots-clés et, si un utilisateur recherche "chatons", nous lui trouverons des chats, des peluches, etc. Pour commencer, nous devons obtenir les données de la requête sur le backend. Voici à quoi cela ressemble :
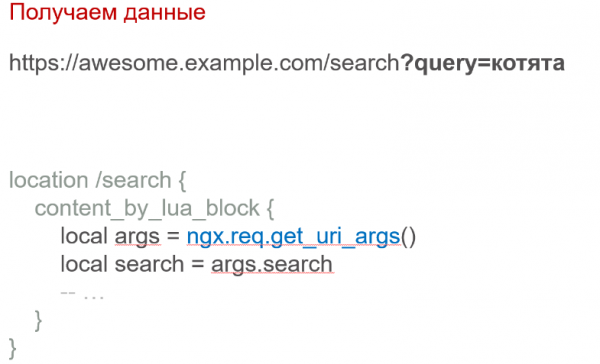
Deux lignes vous permettent de récupérer les paramètres GET, rien de compliqué. Ensuite, nous allons, par exemple, nous connecter à la base de données avec une table pour les mots-clés et les extensions en effectuant une simple requête SQL pour obtenir ces informations. C'est facile. Voici à quoi cela ressemble :
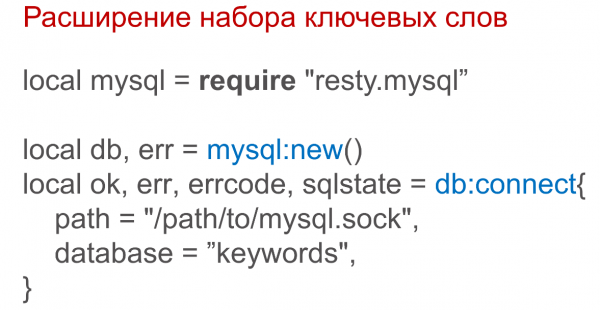
Nous connectons la bibliothèque resty.mysql, qui est déjà incluse dans notre ensemble. Nous n'avons rien à installer, tout est prêt. Nous spécifions comment nous connecter et faisons la requête SQL :
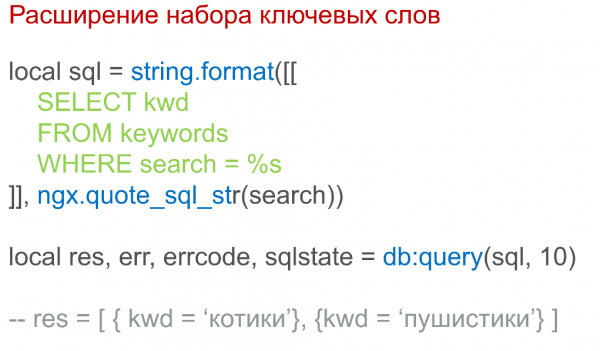
C'est un peu effrayant ici, mais tout fonctionne. Ici, 10 - c'est la limite. Nous extrayons 10 enregistrements, nous sommes paresseux, nous ne voulons pas en montrer plus. J'ai oublié de parler de la limite en SQL.
Ensuite, nous trouvons des images pour toutes les requêtes. Nous collectons un ensemble de requêtes et remplissons une table Lua qui s'appelle reqs, et faisons ngx.location.capture_multi.
Toutes ces requêtes sont envoyées en parallèle, et nous recevons des réponses. Le temps d'exécution est égal au temps de réponse du plus lent. Si nous avons toutes les réponses en 50 millisecondes, et que nous avons envoyé une centaine de requêtes, la réponse nous parviendra en 50 millisecondes.
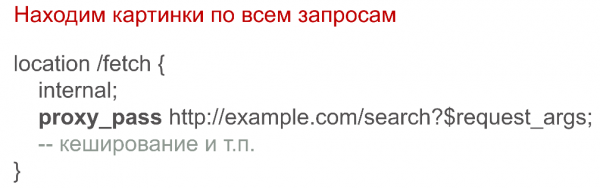
Puisque nous sommes paresseux et que nous ne voulons pas écrire de traitement HTTP et de mise en cache, nous allons faire en sorte que NGINX fasse tout pour nous. Comme vous l'avez vu, il y avait une requête pour url/fetch, la voici :
Nous faisons un simple proxy_pass, en indiquant où mettre en cache, comment le faire, et tout fonctionne.
Mais cela ne suffit pas, nous devons aussi remettre les données à l'utilisateur. L'idée la plus simple est de tout sérialiser en JSON, facilement, en deux lignes. On donne le Content-Type, on renvoie le JSON.
Mais il y a une difficulté : l'utilisateur ne veut pas lire le JSON. Il faut attirer les front-enders. Parfois, nous ne voulons pas vraiment faire cela au départ. Et puis les SEO diront que s'ils cherchent des images, cela leur est égal. Mais s'ils reçoivent un contenu quelconque, ils diront que nos moteurs de recherche n'indexent rien.
Que faire avec ça ? Naturellement, nous allons envoyer HTML à l'utilisateur. Générer manuellement - ce n'est pas idéal, donc nous voulons utiliser des modèles. Pour cela, il y a une bibliothèque lua-resty-template.
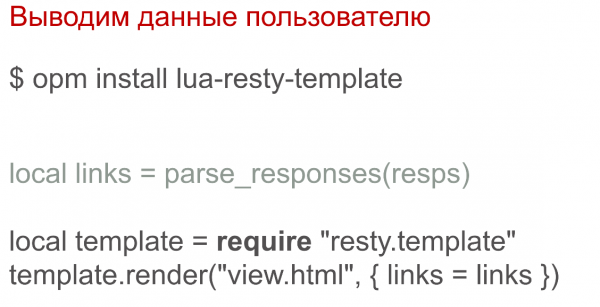
Vous avez probablement vu les trois lettres effrayantes OPM. OpenResty vient avec son propre gestionnaire de paquets, à travers lequel on peut installer une foule d'autres modules, notamment lua-resty-template. C'est un moteur de modèles simple, proche des modèles Django. On peut écrire du code et substitution de variables.
En fin de compte, tout ressemblera à ceci :
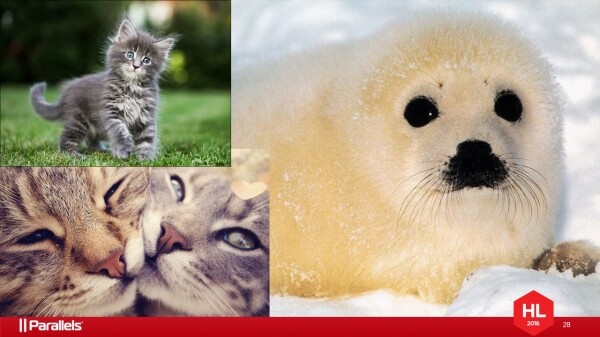
Nous avons pris les données et rendu le modèle en deux lignes. L'utilisateur est heureux, il a reçu des chatons. Comme nous avons élargi la requête, il a aussi reçu un veau de mer. Qui sait, peut-être qu'il le cherchait mais ne pouvait pas formuler correctement sa demande.
C'est génial, mais nous sommes en développement, et nous ne voulons pas encore montrer cela aux utilisateurs. Faisons une autorisation. Pour ce faire, voyons comment NGINX traite la requête en termes d'OpenResty :
- La première phase - un access, quand l'utilisateur vient juste d'arriver, et que nous l'avons regardé à travers les en-têtes, l'adresse IP, et d'autres données. Nous pouvons immédiatement le couper s'il ne nous plaît pas. Cela peut être utilisé pour l'autorisation, ou si nous recevons trop de requêtes, nous pouvons facilement les couper à cette phase.
- rewrite. Nous réécrivons certaines données de la requête.
- contenu. Nous donnons le contenu à l'utilisateur.
- filtre des en-têtes. Nous modifions les en-têtes de la réponse. Si nous avons utilisé
proxy_pass, nous pouvons réécrire certains en-têtes avant de les donner à l'utilisateur. - filtre du corps. Nous pouvons modifier le corps.
- log — journalisation. Il est possible d'écrire des journaux dans elasticsearch sans couche supplémentaire.
Notre autorisation ressemblera à peu près à cela :
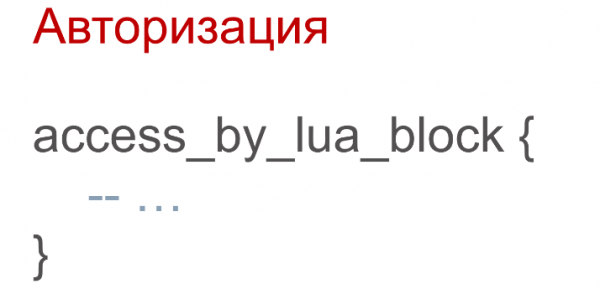
Nous allons l'ajouter à celui location, que nous avons décrit auparavant, et y insérer ce code :
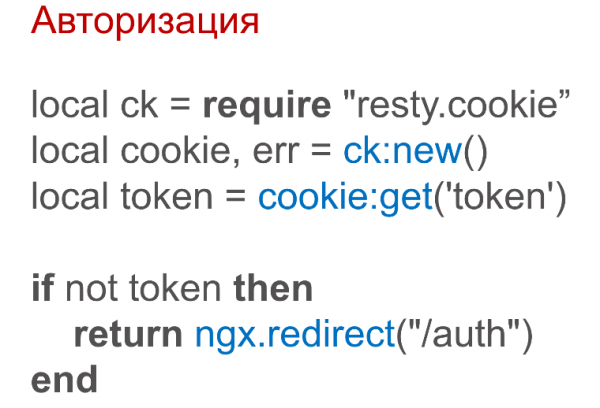
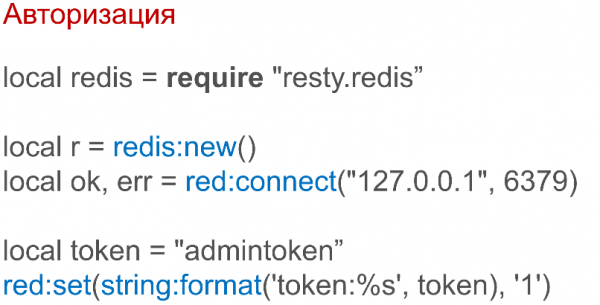
Nous vérifions si nous avons un cookie token. S'il n'y en a pas, nous dirigeons vers l'autorisation. Les utilisateurs sont futés et peuvent deviner qu'il faut mettre un cookie token. Donc, nous allons aussi le placer dans Redis :
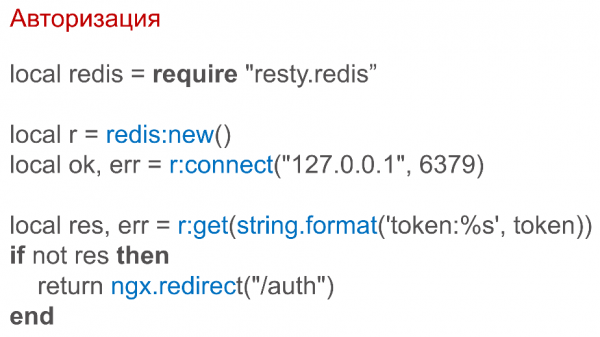
Le code de travail avec Redis est très simple et ne diffère en rien des autres langages. De plus, toutes les entrées/sorties là-bas comme ici sont non-bloquantes. Si vous écrivez du code synchrone, cela fonctionne de manière asynchrone. Un peu comme avec gevent, mais fait correctement.
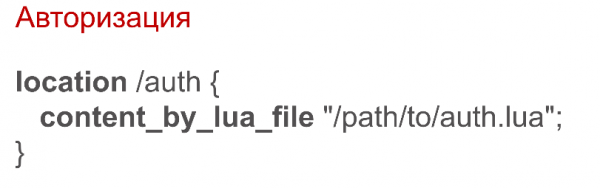
Faisons l'autorisation elle-même :
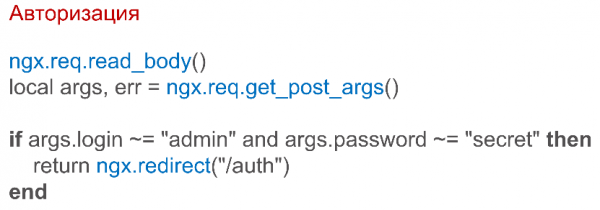
Nous disons que nous devons lire le corps de la requête. Nous obtenons les arguments POST, vérifions que le login et le mot de passe sont corrects. S'ils ne le sont pas, nous dirigeons vers l'autorisation. Mais s'ils sont corrects, nous écrivons le token dans Redis :
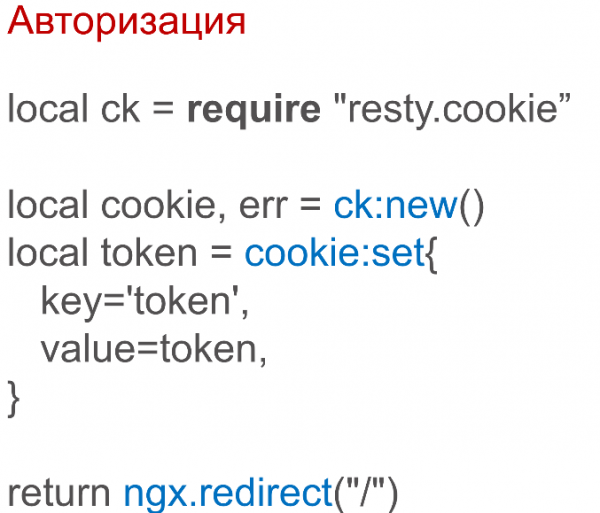
N'oublions pas de placer un cookie, cela se fait également en deux lignes :
C'est un exemple simple, théorique. Bien sûr, nous ne ferons pas un service qui montre des chatons aux gens. Bien que qui sait. Donc, parcourons ce qui peut être fait en production.
- Backend minimaliste. Parfois, il nous faut fournir très peu de données au backend : parfois, il faut juste insérer une date, afficher une liste quelconque, dire combien d'utilisateurs sont sur le site, ajouter un compteur ou des statistiques. Quelque chose de petit. Des morceaux minimaux peuvent être très facilement réalisés. Cela permettra d'aller vite, facilement et efficacement.
- Prétraitement des données. Parfois, nous voulons intégrer de la publicité dans notre page, et nous obtenons cette publicité via des requêtes API. C'est très facile à faire ici. Nous ne surchargeons pas notre backend, qui travaille déjà dur. Nous pouvons le prendre et le collecter ici. Nous pouvons créer des JS ou, au contraire, les décomposer, pré-traiter quelque chose avant de le remettre à l'utilisateur.
- Facade pour microservice. C'est aussi un très bon cas d'utilisation, que j'ai réalisé. Auparavant, je travaillais dans une entreprise nommée Tenzor, qui s'occupe de la déclaration électronique, fournissant des rapports pour environ la moitié des personnes morales dans le pays. Nous avons développé un service, où beaucoup de choses ont été réalisées grâce à ce même mécanisme : routage, autorisation et autres.
OpenResty peut être utilisé comme un lien pour vos microservices, qui offrira un accès unifié à tout et une interface unique. Étant donné que les microservices peuvent être écrits dans différents langages — ici vous avez Node.js, là vous avez PHP, ici Python, et une chose en Erlang — nous comprenons que nous ne voulons pas réécrire le même code partout. C'est pourquoi vous pouvez mettre OpenResty à l'avant. - Statistiques et analyses. En général, NGINX se trouve à l'entrée, et toutes les requêtes le traversent. C'est ici qu'il est très pratique de rassembler. Vous pouvez immédiatement calculer quelque chose et l'envoyer quelque part, par exemple vers Elasticsearch, Logstash ou simplement l'enregistrer dans un journal et ensuite l'envoyer ailleurs.
- Systèmes multijoueurs. Par exemple, les jeux en ligne sont également très adaptés. Aujourd'hui à Cape Town, Alexandre Gladych parlera de la manière de prototyper rapidement un jeu multijoueur à l'aide d'OpenResty.
- Filtrage des requêtes (WAF). Actuellement, il est à la mode de créer divers pare-feux d'application web, il existe de nombreux services qui les fournissent. Avec OpenResty, vous pouvez créer un pare-feu d'application web qui filtrera facilement et simplement les requêtes selon vos exigences. Si vous utilisez Python, vous savez que PHP ne pourra pas être injecté, à moins que vous ne le lançiez depuis la console quelque part. Vous savez que vous avez MySQL et Python. Peut-être que certaines personnes pourraient tenter de réaliser un chemin de répertoire et d'injecter quelque chose dans la base. Donc, vous pouvez filtrer rapidement et à moindre coût les requêtes suspectes directement à l'avant.
- Communauté. Étant donné qu'OpenResty est basé sur NGINX, il a un avantage : c'est la communauté NGINX. C'est très vaste, et une bonne partie des questions que vous pourriez avoir au début a déjà été résolue par la communauté NGINX.
Développeurs Lua. Hier, j'ai discuté avec des gars qui étaient venus pour la journée de formation HighLoad++ et j'ai entendu dire que Tarantool était le seul projet écrit en Lua. Ce n'est pas vrai, beaucoup de choses sont écrites en Lua. Exemples : OpenResty, le serveur XMPP Prosody, le moteur de jeu Love2D, Lua est scripté dans Warcraft et ailleurs. Il y a beaucoup de développeurs Lua, ils ont une grande communauté réactive. Toutes mes questions sur Lua ont été résolues en quelques heures. Lorsque l'on écrit sur la liste de diffusion, littéralement quelques minutes plus tard, on reçoit déjà de nombreuses réponses avec des explications sur comment et pourquoi. C'est vraiment super. Malheureusement, cette communauté bienveillante n'est pas présente partout.
Il y a un GitHub pour OpenResty, où vous pouvez créer une issue si quelque chose ne fonctionne pas. Il existe une liste de diffusion sur Google Groups pour discuter des questions générales, ainsi qu'une mailing list en chinois - au cas où vous ne maîtriseriez pas l'anglais mais que vous parliez chinois.
Résultats
- J'espère avoir pu exprimer que OpenResty est un framework extrêmement pratique, conçu pour le web.
- Il a une faible barrière à l'entrée, car le code ressemble à ce sur quoi nous écrivons, le langage est assez simple et minimaliste.
- Il offre une entrée/sortie asynchrone sans callbacks, nous n'aurons pas de spaghetti comme cela peut parfois arriver dans Node.js.
- Son déploiement est facile, car nous avons juste besoin de NGINX avec le module requis et de notre code, et tout fonctionne immédiatement.
- Une grande et réactive communauté.
Je n'ai pas expliqué en détail comment fonctionne le routage, cela aurait été très long.
Merci de votre attention !
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish