

La virtualisation OpenShift (projet en amont – Kubernetes : KubeVirt) était autrefois connue sous le nom de Virtualisation native des conteneurs. Elle a été introduite comme une fonctionnalité de la plateforme OpenShift, conçue pour déployer et gérer des machines virtuelles (VM) comme entités de base de Kubernetes. Cette tâche est techniquement complexe en raison des différences fondamentales entre les technologies. Pour atteindre cet objectif, nous avons utilisé des technologies bien connues basées sur Red Hat Enterprise Linux et KVM, qui sont avec nous depuis de nombreuses années et ont fait leurs preuves. et Dans cet article, nous examinerons les aspects techniques de la virtualisation OpenShift qui permettent la coexistence des VM et des conteneurs au sein d'une même plateforme, qui les gère comme un tout.
Tâches de calcul
Les conteneurs exploitent les mécanismes du noyau Linux, comme les namespaces et les cgroups, pour isoler les processus et gérer les ressources. En général, les processus peuvent être des applications Python, Java ou des fichiers exécutables, mais en réalité, il peut s'agir de n'importe quels processus, comme bash, Emacs ou vim.
Qu'est-ce qu'une machine virtuelle ? Du point de vue de l'hyperviseur, c'est aussi un processus. Mais il ne s'agit pas d'un processus d'application, mais d'un processus KVM, responsable de l'exécution d'une VM précise.
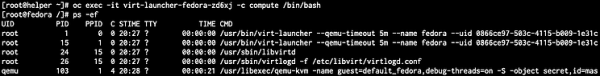
Une image de conteneur contient tous les outils, bibliothèques et fichiers nécessaires à la machine virtuelle KVM. Si nous inspectons un pod de VM en cours d'exécution, nous y verrons des helpers et des processus qemu-kvm. De plus, nous avons accès aux outils KVM pour gérer les machines virtuelles, tels que qemu-img, qemu-nbd et virsh.
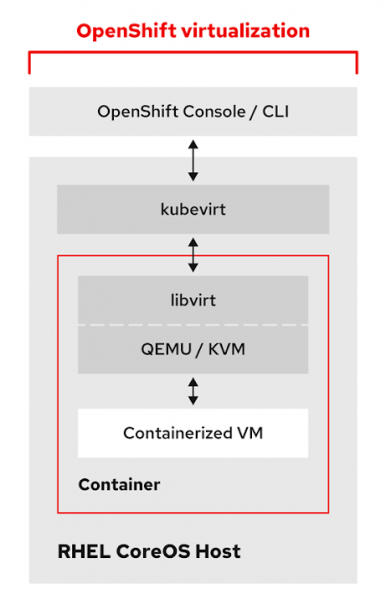
Puisque la machine virtuelle est un pod, elle hérite automatiquement de toutes les fonctionnalités d'un pod au sein de Kubernetes. Les pods VM, tout comme les pods normaux, sont soumis à des schémas et à des critères de planification tels que les taints, les tolerations, l'affinité et l'anti-affinité. Vous bénéficiez également d'avantages tels qu'une haute disponibilité, etc. Cependant, il y a une différence importante : les pods normaux ne migrent pas d'hôte à hôte dans le sens habituel. Si un nœud se déconnecte, le pod qui s'y trouve s'interrompt et est réaffecté à un autre nœud du cluster. En revanche, pour une machine virtuelle, nous nous attendons à une migration à chaud.
Pour combler cette lacune, une définition de ressource personnalisée (CDR) a été créée, décrivant le mécanisme de migration à chaud, qui est responsable de l'initialisation, du suivi et de la gestion des migrations à chaud des VM entre les nœuds de travail.
Pour remédier à ce problème, une définition de ressource personnalisée (CDR) a été développée, décrivant le mécanisme de migration à chaud, chargé de l'initialisation, de la surveillance et de la gestion des migrations à chaud des VM entre les nœuds de travail.
apiVersion: kubevirt.io/v1alpha3
kind: VirtualMachineInstanceMigration
metadata:
  name: migration-job
spec:
  vmiName: fedora
Lors de la désactivation d'un nœud pour les machines virtuelles qui ont la stratégie d'éviction définie sur la migration en direct, des tâches de migration sont automatiquement créées. Cela permet de contrôler le comportement des machines virtuelles lors des déplacements entre les nœuds du cluster. Vous pouvez configurer la migration en direct et gérer les VM comme d'autres pods.
Réseau
Tout système Kubernetes assure la communication entre les nœuds et les pods via des réseaux SDN logiciels. OpenShift ne fait pas exception et, à partir de la version 3, utilise par défaut OpenShiftSDN pour cela. De plus, avec OpenShift 4, une nouvelle fonctionnalité appelée Multus est apparue, permettant d'accéder à plusieurs réseaux et de connecter des pods à ceux-ci simultanément.
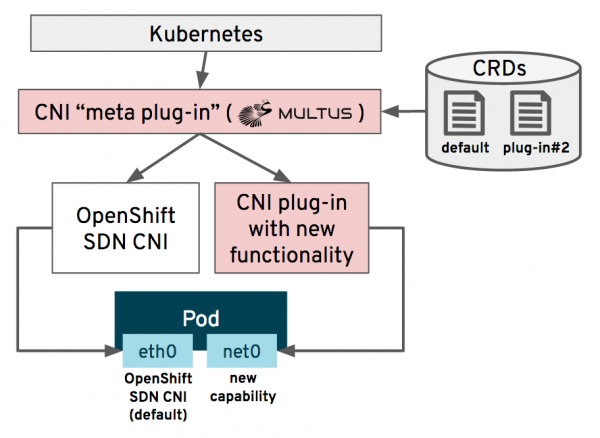
Avec Multus, l'administrateur peut définir des réseaux CNI supplémentaires qui seront ensuite déployés et configurés dans le cluster par un opérateur spécial Cluster Network Operator. Les pods se connectent ensuite à un ou plusieurs de ces réseaux, généralement au standard OpenShiftSDN et à une interface supplémentaire. Les appareils SR-IOV, les ponts Linux standards, les appareils MACVLAN et IPVLAN peuvent également être utilisés si nécessaire pour votre VM. L'illustration ci-dessous montre comment définir Multus CNI pour un réseau de pont sur l'interface eth1 :
apiVersion: operator.openshift.io/v1
kind: Network
metadata:
  name: cluster
spec:
  additionalNetworks:
  - name: multus1
rawCNIConfig: '{ "cniVersion": "0.3.1", "type": "bridge", "master": "eth1", "ipam":
   { "type": "static", "addresses": [ { "address": "191.168.1.1/24" } ] } }'
   type: Raw
En ce qui concerne la virtualisation OpenShift, cela signifie que les VM peuvent se connecter directement à un réseau externe, contournant le SDN. Cela est important pour les machines virtuelles migrées vers OpenShift depuis Red Hat Virtualization ou VMware vSphere, car avec un accès au deuxième niveau OSI, il n'y aura pas de changement dans les paramètres réseau. Cela signifie également que la VM peut avoir une adresse réseau, les accès contournant le SDN. Ainsi, nous pouvons utiliser efficacement des adaptateurs réseau spécialisés ou nous connecter directement au stockage en réseau…
Pour en savoir plus sur la création et la connexion de machines virtuelles OpenShift virtualization au réseau, vous pouvez . De plus, , déployé dans le cadre de l'OpenShift virtualization, offre une autre façon bien connue de créer et de gérer des configurations réseau sur les nœuds physiques utilisés par les hyperviseurs.
Stockage
La connexion et la gestion des disques des machines virtuelles dans OpenShift virtualization s'effectue à l'aide de concepts Kubernetes tels que les StorageClasses, les PersistentVolumeClaims (PVC) et les PersistentVolume (PV), ainsi que des protocoles de stockage standards pour l'environnement Kubernetes. Ainsi, les administrateurs Kubernetes et les équipes responsables des applications disposent d'un mécanisme de gestion unifié et familier pour les conteneurs et les machines virtuelles. Pour de nombreux administrateurs d'environnements de virtualisation, ce concept peut sembler familier, car il utilise le même principe de séparation des fichiers de configuration des VM et des disques, qui est appliqué dans OpenStack et sur de nombreuses autres plateformes cloud.
Cependant, il n'est pas possible de créer un nouveau disque pour chaque VM, car lors de la migration d'un hyperviseur vers OpenShift, nous devons conserver les données. Même lorsque nous déployons une nouvelle VM, il est toujours plus rapide de le faire à partir d'un modèle que de le créer de zéro. Ainsi, nous avons besoin de la fonctionnalité d'importation des disques existants.
Pour simplifier cette tâche, OpenShift virtualization déploie le projet Containerized Data Importer (CDI), qui réduit l'importation des images de disque provenant de plusieurs sources à la création d'une entrée dans le PVC.
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: "fedora-disk0"
  labels:
    app: containerized-data-importer
  annotations:
    cdi.kubevirt.io/storage.import.endpoint: "http://10.0.0.1/images/Fedora-Cloud-Base-31-1.9.x86_64.qcow2"
spec:
  storageClassName: ocs-gold
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi
C'est cette entrée qui active le CDI, déclenchant la séquence d'actions illustrées ci-dessous :
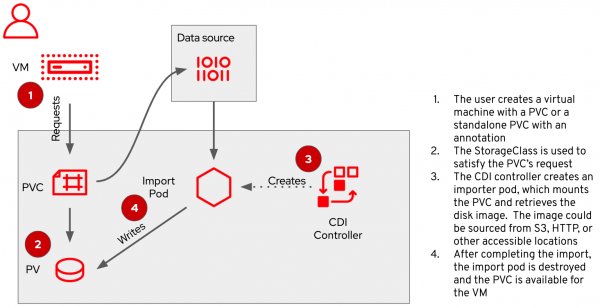
Une fois le CDI terminé, le PVC contiendra un disque de machine virtuelle prêt à l'emploi et converti au format standard d'OpenShift...
Lorsque vous travaillez avec OpenShift virtualization, OpenShift Container Storage (OCS) peut également être utile. C'est une solution Red Hat basée sur le système de fichiers Ceph, qui met en œuvre des fonctionnalités de stockage persistant pour les conteneurs. En plus des méthodes d'accès PVC standard - RWO (bloc) et RWX (fichier) - OCS fournit RWX pour les périphériques de bloc brut, ce qui est très utile pour organiser un accès bloc partagé pour des applications à fortes exigences de performance. De plus, OCS prend en charge le nouveau standard de demande de groupe d'objets, l'Object Bucket Claim, permettant aux applications d'utiliser directement le stockage d'objets.
Machines virtuelles dans des conteneurs
Si vous souhaitez vérifier comment cela fonctionne, sachez qu'OpenShift virtualization est déjà disponible en version Tech Preview dans OpenShift 3.11 et versions ultérieures. Les détenteurs d'un abonnement actif à OpenShift peuvent bénéficier d'OpenShift virtualization complètement gratuitement et sans démarches supplémentaires. Au moment de la publication de cet article, les versions actuelles sont OpenShift 4.4 et OpenShift virtualization 2.3 ; si vous utilisez des versions antérieures, il est conseillé de mettre à jour pour bénéficier des dernières fonctionnalités. La version pleinement prise en charge d'OpenShift virtualization devrait sortir dans la seconde moitié de 2020.
Pour plus d'informations, veuillez consulter pour les instructions d'installation, y compris , qui fournit des informations sur la configuration des réseaux externes.
Source : habr.com
