

Introduction aux systèmes d'exploitation
Bonjour, Habr ! Je souhaite vous présenter une série d'articles traduits d'une littérature que je trouve intéressante — OSTEP. Ce matériel explore en profondeur le fonctionnement des systèmes d'exploitation de type Unix, en particulier — le travail avec les processus, les différents planificateurs, la mémoire et d'autres composants similaires qui forment un système d'exploitation moderne. Vous pouvez voir l'original de tous ces matériaux ici . Je vous demande de prendre en compte que la traduction a été réalisée de manière non professionnelle (assez libre), mais j'espère que le sens général a été conservé.
Les travaux pratiques sur ce sujet peuvent être trouvés ici :
Autres parties :
Vous pouvez également visiter ma chaîne sur =)
Introduction au planificateur
Essence du problème : Comment élaborer une politique de planificateur
Comment les cadres de base des politiques du planificateur doivent-ils être élaborés ? Quelles devraient être les hypothèses clés ? Quelles métriques sont importantes ? Quelles techniques de base ont été utilisées dans les anciens systèmes informatiques ?
Hypothèses de charge de travail
Avant de discuter des politiques possibles, faisons quelques remarques simplificatrices sur les processus exécutés dans le système, qui sont ensemble appelés charge de travail. En définissant la charge de travail comme une partie critique de l'élaboration des politiques, plus vous en savez sur la charge, plus vous pourrez rédiger une politique de qualité.
Faisons les hypothèses suivantes sur les processus exécutés dans le système, parfois appelés jobs (tâches). Pratiquement toutes ces hypothèses ne sont pas réalistes, mais sont nécessaires pour le développement de la réflexion.
- Chaque tâche est exécutée pendant la même durée,
- Toutes les tâches sont lancées simultanément,
- Une tâche lancée fonctionne jusqu'à son achèvement,
- Toutes les tâches utilisent uniquement le CPU,
- Le temps d'exécution de chaque tâche est connu.
Métriques du Planificateur
En plus de certaines hypothèses sur la charge, un outil supplémentaire pour comparer différentes politiques de planification est nécessaire : les métriques du planificateur. Une métrique n'est rien d'autre qu'une mesure de quelque chose. Il existe un certain nombre de métriques qui peuvent être utilisées pour comparer les planificateurs.
À titre d'exemple, nous utiliserons la métrique appelée temps de rotation (turnaround time). Le temps de rotation d'une tâche est défini comme la différence entre le temps d'achèvement de la tâche et le moment où la tâche est arrivée dans le système.
Tturnaround=Tcompletion−Tarrival
Puisque nous avons supposé que toutes les tâches sont arrivées en même temps, alors Ta=0 et donc Tt=Tc. Cette valeur changera naturellement lorsque nous modifierons les hypothèses énoncées ci-dessus.
Une autre métrique est fairness (équité). La performance et l'équité sont souvent des caractéristiques opposées dans la planification. Par exemple, un planificateur peut optimiser la performance, mais au prix d'un temps d'attente pour d'autres tâches, ce qui réduit l'équité.
FIRST IN FIRST OUT (FIFO)
L'algorithme le plus basique que nous pouvons mettre en œuvre s'appelle FIFO ou premier arrivé, premier serviCet algorithme présente plusieurs avantages : il est très simple à mettre en œuvre et il convient à toutes nos hypothèses, en effectuant le travail de manière assez efficace.
Considérons un exemple simple. Supposons que 3 tâches soient lancées simultanément. Mais supposons que la tâche A arrive un peu avant les autres, donc elle figurera en tête de la liste d'exécution, tout comme B par rapport à V. Supposons que chacune d'elles sera exécutée pendant 10 secondes. Quel sera alors le temps moyen d'exécution de ces tâches ?
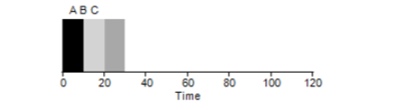
En additionnant les valeurs — 10+20+30 et en divisant par 3, nous obtenons un temps moyen d'exécution du programme égal à 20 secondes.
Essayons maintenant de modifier nos hypothèses. En particulier l'hypothèse 1 et donc nous ne supposerons plus que chaque tâche s'exécute un temps égal. Comment le FIFO se comportera-t-il cette fois ?
Il s'avère que différents temps d'exécution des tâches nuisent fortement à la productivité de l'algorithme FIFO. Supposons que la tâche A s'exécute pendant 100 secondes, tandis que B et V continuent à s'exécuter chacune pendant 10.
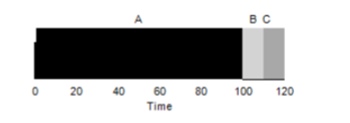
Comme on peut le voir sur le graphique, le temps moyen pour le système sera (100+110+120)/3=110. Cet effet est appelé l'effet de convoi, lorsque certains consommateurs de ressources à court terme se retrouvent en attente derrière un consommateur plus lourd. C'est comme faire la queue dans un magasin d'alimentation, lorsque devant vous se trouve un client avec un chariot plein. La meilleure solution au problème est d'essayer de changer de caisse ou de se détendre et de respirer profondément.
Shortest Job First
Peut-on résoudre une telle situation avec des processus lourds ? Bien sûr. Un autre type de planification s'appelleShortest Job First (SJF). Son algorithme est également assez primitif — comme le suggère son nom, les tâches les plus courtes seront exécutées les premières, les unes après les autres.
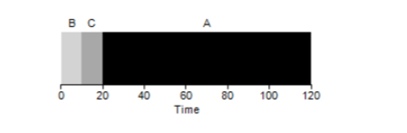
Dans cet exemple, le résultat de l'exécution des mêmes processus sera une amélioration du temps moyen de rotation des programmes et sera égal à 50 au lieu de 110, ce qui est pratiquement deux fois mieux.
Ainsi, pour l'hypothèse donnée selon laquelle toutes les tâches arrivent en même temps, l'algorithme SJF semble être le plus optimal. Cependant, nos hypothèses semblent encore irréalistes. Cette fois, nous allons modifier l'hypothèse 2 et supposer que les tâches peuvent arriver à tout moment, et non toutes en même temps. Quels problèmes cela pourrait-il entraîner ?
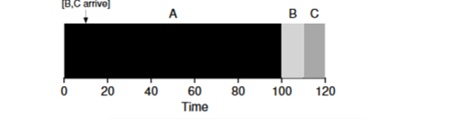
Supposons que la tâche A (100s) arrive en premier et commence à s'exécuter. Au moment t=10, les tâches B et C arrivent, chacune prenant 10 secondes. Ainsi, le temps moyen d'exécution est (100 + (110 - 10) + (120 - 10)) / 3 = 103. Que pourrait faire le planificateur pour améliorer la situation ?
Shortest Time-to-Completion First (STCF)
Pour améliorer la situation, nous allons abandonner l'hypothèse 3, selon laquelle le programme est lancé et fonctionne jusqu'à sa terminaison. De plus, nous aurons besoin de support matériel et comme vous l'avez peut-être deviné, nous allons utiliser un minuteur pour interrompre la tâche en cours et changer de contexte. Ainsi, le planificateur peut agir au moment de l'arrivée des tâches B et C : interrompre l'exécution de la tâche A et traiter les tâches B et C, puis continuer l'exécution du processus A après leur achèvement. Un tel planificateur est appelé STCFou Preemptive Job First.
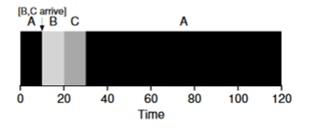
Le résultat du travail de ce planificateur sera le suivant : ((120 - 0) + (20 - 10) + (30 - 10)) / 3 = 50. Ainsi, un tel planificateur devient encore plus optimal pour nos tâches.
Métrique Temps de réponse (Response Time)
Donc, si nous connaissons le temps de fonctionnement des tâches et que ces tâches utilisent uniquement le CPU, le STCF sera la meilleure solution. Et, à une époque, ces algorithmes fonctionnaient assez bien. Cependant, désormais, l'utilisateur passe le plus clair de son temps devant le terminal et s'attend à une interaction interactive performante. C'est ainsi qu'une nouvelle métrique est née — le temps de réponse (response time).
Le temps de réponse se calcule comme suit :
Tresponse = Tfirstrun − Tarrival
Ainsi, pour l'exemple précédent, le temps de réponse sera le suivant : A = 0, B = 0, C = 10 (abg = 3,33).
Il s'avère que l'algorithme STCF n'est pas si performant dans une situation où trois tâches arrivent simultanément — il devra attendre que les petites tâches soient complètement terminées. Ainsi, l'algorithme est efficace pour la métrique du temps de rotation, mais peu adapté pour celle de l'interactivité. Imaginez que, assis devant un terminal, vous deviez attendre plus de 10 secondes pour taper des caractères dans un éditeur, car une autre tâche monopolise le processeur. Ce n'est pas très agréable.
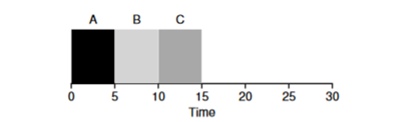
Nous sommes donc confrontés à un autre problème : comment pouvons-nous construire un ordonnanceur sensible au temps de réponse ?
Round Robin
Pour résoudre ce problème, un algorithme a été développé Round Robin (RR). L'idée principale est assez simple : au lieu d'exécuter les tâches jusqu'à leur complétion, nous exécuterons une tâche pendant un certain intervalle de temps (appelé quantum de temps) puis basculerons sur une autre tâche dans la file d'attente. L'algorithme continue son fonctionnement jusqu'à ce que toutes les tâches soient terminées. Le temps d'exécution du programme doit être un multiple du temps après lequel le minuteur interrompt le processus. Par exemple, si le minuteur interrompt le processus toutes les x=10 ms, la taille de la fenêtre d'exécution du processus doit être un multiple de 10 et être 10, 20 ou x*10.
Considérons un exemple : les tâches ABC arrivent simultanément dans le système et chacune d’elles souhaite fonctionner pendant 5 secondes. L'algorithme SJF exécutera chaque tâche jusqu'à la fin avant de lancer une autre. En revanche, l'algorithme RR avec une fenêtre d'exécution = 1s parcourra les tâches de la manière suivante (fig. 4.3) :
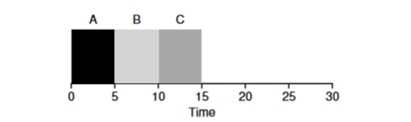
(SJF Again (Mauvais pour le Temps de Réponse)
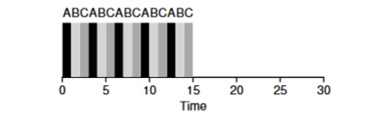
(Round Robin (Bon pour le Temps de Réponse)
Le temps de réponse moyen pour l'algorithme RR (0+1+2)/3=1, tandis que pour SJF (0+5+10)/3=5.
Il est logique de supposer que la fenêtre temporelle est un paramètre très important pour le RR ; plus elle est courte, plus le temps de réponse est élevé. Cependant, il ne faut pas la rendre trop petite, car le temps de commutation de contexte joue également un rôle dans la performance globale. Ainsi, le choix de la durée de la fenêtre d'exécution est fixé par l'architecte du système d'exploitation et dépend des tâches qui doivent y être exécutées. La commutation de contexte n'est pas la seule opération utilitaire qui consomme du temps : un programme en cours d'exécution interagit également avec divers caches, et à chaque commutation, il est nécessaire de sauvegarder et de restaurer cet environnement, ce qui peut également prendre beaucoup de temps.
Le RR est un excellent planificateur, si l'on considère uniquement la métrique du temps de réponse. Mais comment la métrique du temps de rotation des tâches se comportera-t-elle avec cet algorithme ? Prenons l'exemple précédent, où les temps d'exécution A, B, C = 5s et arrivent en même temps. La tâche A se terminera à 13s, B à 14s, C à 15s, et le temps de rotation moyen sera donc de 14s. Ainsi, le RR est le pire algorithme pour la métrique de rotation.
Pour le dire plus simplement, tout algorithme de type RR est équitable ; il répartit le temps de travail sur le CPU également entre tous les processus. Ainsi, ces métriques entrent constamment en conflit les unes avec les autres.
Ainsi, nous avons plusieurs algorithmes opposés et il reste encore quelques hypothèses — que le temps de la tâche est connu et que la tâche utilise uniquement le CPU.
Mélange avec l'I/O
Tout d'abord, éliminons l'hypothèse 4, selon laquelle le processus utilise uniquement le CPU ; ce n'est naturellement pas vrai, et les processus peuvent également accéder à d'autres équipements.
Au moment où un processus demande une opération d'entrée/sortie, le processus passe à un état bloqué, attendant que l'I/O se termine. Si l'I/O est adressée à un disque dur, cette opération peut prendre jusqu'à plusieurs ms ou plus, et le processeur sera inactif pendant ce temps. À ce stade, le planificateur peut utiliser le processeur pour un autre processus. La prochaine décision que le planificateur devra prendre est de déterminer quand le processus terminera son I/O. Lorsqu'un tel événement se produit, une interruption se produira et le système d'exploitation transférera le processus ayant demandé l'I/O à l'état prêt.
Considérons un exemple avec plusieurs tâches. Chacune nécessite 50 ms de temps processeur. Toutefois, la première va faire appel à l'I/O toutes les 10 ms (qui sera également exécuté toutes les 10 ms). Le processus B utilise simplement 50 ms de processeur sans I/O.
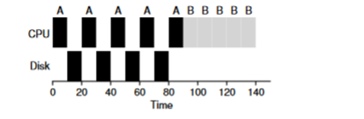
Dans cet exemple, nous allons utiliser le planificateur STCF. Comment se comportera le planificateur lorsque nous lancerons un processus tel que A ? Il agira de la manière suivante : il exécutera d'abord entièrement le processus A, puis le processus B.
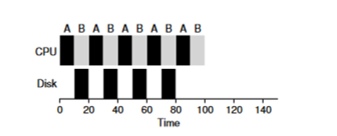
L'approche traditionnelle pour résoudre ce problème consiste à interpréter chaque sous-tâche de 10 ms du processus A comme une tâche distincte. Ainsi, en commençant avec l'algorithme STJF, le choix entre une tâche de 50 ms et une tâche de 10 ms est évident. Ensuite, lorsque la sous-tâche A sera terminée, le processus B et l'I/O seront lancés. Après la fin de l'I/O, il sera décidé de relancer le processus A de 10 ms au lieu du processus B. Cela permet de réaliser un chevauchement, où le CPU est utilisé par un autre processus pendant que le premier attend l'I/O. En fin de compte, le système est mieux utilisé : au moment où les processus interactifs attendent l'I/O, d'autres processus peuvent être exécutés sur le processeur.
L'oracle n'est plus là.
Essayons maintenant de nous débarrasser de l'hypothèse selon laquelle le temps d'exécution d'une tâche est connu. C'est de loin la pire et l'hypothèse la plus irréaliste de toute cette liste. En fait, dans les systèmes d'exploitation ordinaires, le système d'exploitation sait généralement très peu sur le temps d'exécution des tâches, alors comment construire un planificateur sans savoir combien de temps une tâche va s'exécuter ? Pourrait-on utiliser certains principes de RR pour résoudre ce problème ?
Conclusion
Nous avons examiné les idées de base sur la planification des tâches et étudié deux familles de planificateurs. Le premier exécute la tâche la plus courte en premier et augmente ainsi le temps de rotation, tandis que le second se divise également entre toutes les tâches, améliorant le temps de réponse. Les deux algorithmes sont mauvais là où les algorithmes de l'autre famille sont bons. Nous avons également examiné comment l'utilisation parallèle du CPU et de l'I/O peut améliorer les performances, mais nous n'avons pas résolu le problème de la clairvoyance de l'OS. Lors de la prochaine séance, nous étudierons un planificateur qui regarde le passé récent et essaie de prédire l'avenir. Il s'appelle la file d'attente à rétroaction multi-niveau.
Source : habr.com
