

L'architecture microservices, comme tout dans ce monde, a ses avantages et ses inconvénients. Certains processus deviennent plus simples avec elle, d'autres, plus compliqués. Et en faveur de la rapidité des changements et d'une meilleure scalabilité, il faut faire des sacrifices. L'un d'eux est la complexité de l'analyse. Alors que dans un monolithe, toute l'analyse opérationnelle peut être réduite à des requêtes SQL sur une réplique analytique, dans une architecture multi-services, chaque service possède sa propre base de données et il semble qu'une seule requête ne suffise pas (ou peut-être que si ?). Pour ceux qui s'intéressent à la manière dont nous avons résolu le problème de l'analyse opérationnelle dans notre entreprise et comment nous avons appris à vivre avec cette solution — bienvenue.
Je m'appelle Pavel Sivas, et chez DomClick, je fais partie d'une équipe qui est responsable de l'accompagnement de l'entrepôt de données analytiques. On peut qualifier notre activité de génie des données, mais en réalité, le champ de tâches est beaucoup plus large. Il y a des tâches normales de génie des données telles que l'ETL/ELT, le support et l'adaptation des outils pour l'analyse des données, ainsi que le développement de nos propres outils. En particulier, pour le reporting opérationnel, nous avons décidé de « faire semblant » d'avoir un monolithe et de donner aux analystes une base unique contenant toutes les données dont ils ont besoin.
En réalité, nous avons envisagé différentes options. Nous aurions pu construire un véritable entrepôt de données — nous avons même essayé, mais honnêtement, nous n'avons pas réussi à harmoniser les changements fréquents dans la logique avec le processus de construction de l'entrepôt et la mise à jour des données, qui est assez lent (si quelqu'un a réussi, n'hésitez pas à écrire dans les commentaires comment). Nous aurions pu dire aux analystes : « Écoutez, apprenez Python et utilisez des répliques analytiques », mais cela impliquerait une exigence supplémentaire en matière de recrutement, et il semblait préférable d'éviter cela si possible. Nous avons décidé d'essayer la technologie FDW (Foreign Data Wrapper) : c'est essentiellement un dblink standard qui figure dans la norme SQL, mais avec une interface beaucoup plus conviviale. Sur cette base, nous avons créé une solution qui a finalement été adoptée, et nous nous y sommes arrêtés. Les détails de cette solution seraient le sujet d'un article à part entière, ou peut-être même de plusieurs, car il y a beaucoup à dire : de la synchronisation des schémas des bases aux droits d'accès et à l'anonymisation des données personnelles. Il convient également de mentionner que cette solution ne remplace pas de véritables bases de données analytiques et d'entrepôts de données ; elle ne résout qu'un problème spécifique.
À un niveau élevé, cela se présente comme suit :
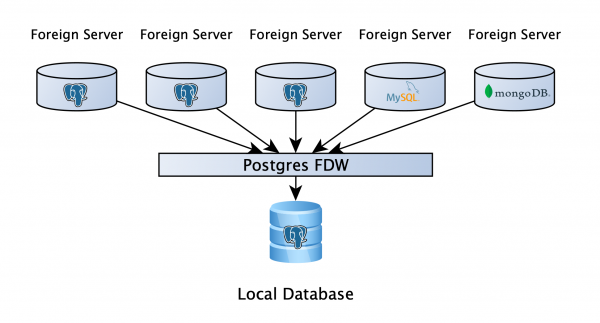
Il y a une base de données PostgreSQL où les utilisateurs peuvent stocker leurs données de travail, et le plus important — cette base est connectée via FDW aux répliques analytiques de tous les services. Cela permet d'écrire une requête vers plusieurs bases, peu importe qu'il s'agisse de PostgreSQL, MySQL, MongoDB ou autre chose (un fichier, une API, si aucun wrapper approprié n'existe, vous pouvez écrire votre propre). Eh bien, ça a l'air bien, non ? On se sépare ?
Si tout se terminait aussi rapidement et simplement, cet article n'existerait probablement pas.
Il est important de comprendre clairement comment Postgres traite les requêtes vers des serveurs distants. Cela semble logique, mais souvent, cela est négligé : Postgres divise la requête en parties qui sont exécutées sur les serveurs distants de manière indépendante, collecte ces données, puis effectue les calculs finaux lui-même. Par conséquent, la vitesse d'exécution de la requête dépendra fortement de sa rédaction. Il convient également de noter que lorsque les données proviennent d'un serveur distant, elles n'ont plus d'index, rien ne peut aider le planificateur ; par conséquent, nous sommes les seuls capables de l'aider et de le guider. Et c'est précisément ce dont j'aimerais parler plus en détail.
Requête simple et plan associé
Pour illustrer comment PostgreSQL exécute une requête sur une table de 6 millions de lignes à distance le serveur, examinons un plan simple.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
L'utilisation de l'instruction VERBOSE permet de voir la requête qui sera envoyée au serveur distant et les résultats que nous recevrons pour un traitement ultérieur (ligne RemoteSQL).
Allons un peu plus loin et ajoutons quelques filtres à notre requête : un sur boolean le champ, un sur la présence timestamp dans l'intervalle et un sur jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
C'est précisément ici que se situe le point sur lequel il faut porter attention lors de l'écriture de requêtes. Les filtres n'ont pas été transmis au serveur distant, ce qui signifie que pour son exécution, PostgreSQL extrait les 6 millions de lignes pour ensuite les filtrer localement (ligne Filter) et effectuer l'agrégation. La clé du succès est d'écrire la requête de sorte que les filtres soient transférés à la machine distante, et que nous recevions et agrégions uniquement les lignes nécessaires.
C'est du boolean.
Avec les champs boolean, tout est simple. Dans la requête d'origine, le problème provenait de l'opérateur is. Si nous le remplaçons par =, nous obtiendrons le résultat suivant :
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=508010.14..508010.15 rows=1 width=8) (actual time=19064.314..19064.314 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (actual time=33.035..18951.278 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: ((("table".meta->>'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 3567989
        Remote SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Planning time: 0.834 ms
Execution time: 19064.534 ms
Comme vous pouvez le voir, le filtre a été envoyé sur le serveur distant, et le temps d'exécution a été réduit de 27 à 19 secondes.
Il convient de noter que l'opérateur is diffère de l'opérateur = en ce sens qu'il peut travailler avec la valeur Null. Cela signifie que is not True dans le filtre conservera les valeurs False et Null, tandis que != True ne conservera que les valeurs False. Par conséquent, lors du remplacement de l'opérateur is not il convient de transmettre au filtre deux conditions avec l'opérateur OR, par exemple, WHERE (col != True) OR (col is null).
Nous avons compris le boolean, passons à autre chose. Mais d'abord, revenons au filtre de valeur booléenne dans son état original pour examiner indépendamment l'effet des autres changements.
timestamptz? hz
En général, il est souvent nécessaire d'expérimenter pour savoir comment écrire correctement une requête qui implique des serveurs distants, puis de chercher une explication sur pourquoi cela se produit. Très peu d'informations à ce sujet peuvent être trouvées sur Internet. Ainsi, dans nos expériences, nous avons découvert que le filtre par date fixe est facilement envoyé sur le serveur distant, mais que lorsque nous voulons définir la date dynamiquement, par exemple, now() ou CURRENT_DATE, cela ne se produit pas. Dans notre exemple, nous avons ajouté ce filtre pour que la colonne created_at contienne des données exactement d'un mois en arrière (BETWEEN CURRENT_DATE - INTERVAL '7 month' AND CURRENT_DATE - INTERVAL '6 month'). Que avons-nous fait dans ce cas?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
Nous avons suggéré au planificateur de calculer à l'avance la date dans la sous-requête et de déjà transmettre la variable prête dans le filtre. Et ce conseil nous a donné un excellent résultat, la requête est devenue presque six fois plus rapide !
Encore une fois, il est important d'être attentif : le type de données dans la sous-requête doit correspondre à celui du champ sur lequel nous filtrons, sinon le planificateur décidera que les types étant différents, il faut d'abord récupérer toutes les données puis filtrer localement.
Ramenons le filtre par date à sa valeur initiale.
Freddy vs. Jsonb
En fait, les champs booléens et les dates ont déjà suffisamment accéléré notre requête, cependant, il restait encore un type de données. La bataille pour le filtrage sur celui-ci, honnêtement, n'est pas encore terminée, bien qu'il y ait eu des succès ici aussi. Alors, voici comment nous avons réussi à faire passer le filtre par jsonb le champ vers le serveur distant.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
Au lieu des opérateurs de filtrage, il est nécessaire d'utiliser l'opérateur de présence d'un jsonb dans l'autre. 7 secondes au lieu des 29 initiales. Pour l'instant, c'est la seule option réussie pour le transfert des filtres par jsonb vers un serveur distant, mais il est important de prendre en compte une contrainte : nous utilisons la version 9.6 de la base, cependant nous prévoyons de terminer les derniers tests et de passer à la version 12 d'ici la fin avril. Une fois que nous serons à jour, nous vous informerons sur l'impact, car il y a de nombreux changements sur lesquels nous avons beaucoup d'espoirs : json_path, nouveau comportement CTE, push down (présent depuis la version 10). Nous avons hâte d'essayer cela.
Finish him
Nous avons vérifié comment chaque changement affecte la vitesse de la requête individuellement. Voyons maintenant ce qui se passe lorsque les trois filtres sont correctement écrits.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Oui, la requête semble plus complexe, c'est un coût forcé, mais le temps d'exécution est de 2 secondes, ce qui est plus de 10 fois plus rapide ! Et nous parlons ici d'une simple requête sur un ensemble de données relativement petit. Sur des requêtes réelles, nous avons obtenu des gains allant jusqu'à plusieurs centaines de fois.
En résumé : si vous utilisez PostgreSQL avec FDW, vérifiez toujours si tous les filtres sont envoyés sur le serveur distant, et vous serez heureux... Du moins jusqu'à ce que vous rencontriez des jointures entre des tables venant de différentes serveurs. Mais c'est déjà l'histoire d'un autre article.
Merci de votre attention ! Je serais heureux de lire vos questions, commentaires, ainsi que des histoires sur votre expérience dans les commentaires.
Source : habr.com
