

Le rapport traite des questions pratiques du développement d'un opérateur sous Kubernetes, de la conception de son architecture et des principes fondamentaux de son fonctionnement.
Dans la première partie du rapport, nous examinerons :
- ce qu'est un opérateur dans Kubernetes et à quoi il sert ;
- comment un opérateur simplifie la gestion des systèmes complexes ;
- ce que l'opérateur peut faire, et ce qu'il ne peut pas faire.
Ensuite, nous aborderons la structure interne de l'opérateur. Nous examinerons l'architecture et le fonctionnement de l'opérateur étape par étape. Nous analyserons en détail :
- l'interaction entre l'opérateur et Kubernetes ;
- quelles fonctions l'opérateur assume, et ce qu'il délègue à Kubernetes.
Nous examinerons la gestion des shards et des répliques de bases de données sous Kubernetes.
Ensuite, nous discuterons des questions de stockage des données :
- comment travailler avec le stockage persistant du point de vue de l'opérateur ;
- les pièges de l'utilisation du stockage local.
Dans la partie finale du rapport, nous examinerons des exemples pratiques d'application avec Amazon ou Google Cloud Service. Le rapport se fonde sur l'exemple du développement et de l'exploitation de l'opérateur pour ClickHouse.
Vidéo :
Je m'appelle Vladislav Klimenko. Aujourd'hui, je voudrais parler de notre expérience dans le développement et l'exploitation d'un opérateur, en particulier d'un opérateur spécialisé pour la gestion des clusters de bases de données. À titre d'exemple, pour gérer le cluster ClickHouse.
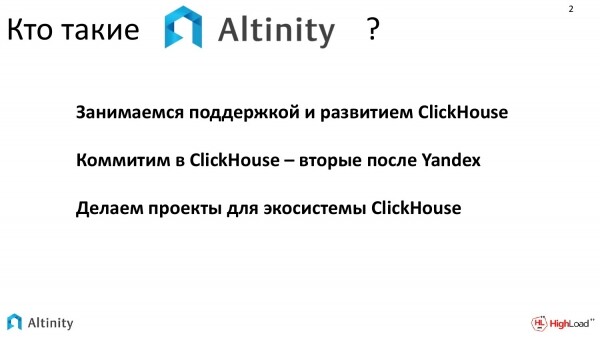
Pourquoi avons-nous la possibilité de parler de l'opérateur et de ClickHouse ?
- Nous soutenons et développons ClickHouse.
- Actuellement, nous essayons d'apporter notre contribution au développement de ClickHouse. Et nous sommes les deuxièmes après Yandex en termes de volume de changements apportés à ClickHouse.
- Nous essayons de créer des projets supplémentaires pour l'écosystème ClickHouse.
Je voudrais parler de l'un de ces projets. Il s'agit du ClickHouse-operator pour Kubernetes.
Dans mon rapport, je voudrais aborder deux sujets :
- Le premier sujet est de savoir comment notre opérateur gère les bases de données ClickHouse sous Kubernetes.
- Le deuxième sujet est de savoir comment fonctionnent les opérateurs en général, c'est-à-dire comment ils interagissent avec Kubernetes.
Ces deux questions seront entrecroisées tout au long de mon rapport.
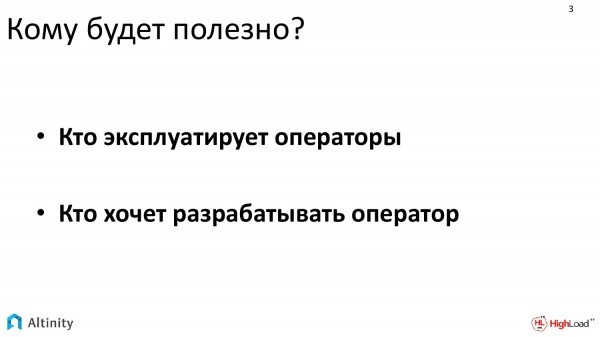
Qui pourrait être intéressé par ce que j'essaie de raconter ?
- Cela intéressera surtout ceux qui exploitent des opérateurs.
- Ou ceux qui veulent créer le leur, afin de comprendre comment cela fonctionne en interne, comment l'opérateur interagit avec Kubernetes et quels pièges peuvent surgir.
Pour bien comprendre ce dont nous allons discuter aujourd'hui, il serait bon de savoir comment fonctionne Kubernetes et d'avoir une formation de base sur les technologies cloud.
Qu'est-ce que ClickHouse ? C'est une base de données en colonnes spécialisée dans le traitement en ligne des requêtes analytiques. Et elle est entièrement open source.
Et nous devons connaître seulement deux choses. Il faut savoir que c'est une base de données, donc ce que je vais décrire sera applicable à pratiquement n'importe quelle base de données. Et que le SGBD ClickHouse se scalabilité très bien, offrant pratiquement une scalabilité linéaire. Par conséquent, l'état du cluster est un état naturel pour ClickHouse. Nous sommes donc particulièrement intéressés à discuter de la manière de gérer un cluster ClickHouse dans Kubernetes.
Pourquoi est-il nécessaire dans ce contexte ? Pourquoi ne pouvons-nous pas continuer à l'exploiter de façon autonome ? Les réponses sont en partie techniques et en partie organisationnelles.
- Dans la pratique, nous rencontrons de plus en plus souvent cette situation où, dans les grandes entreprises, presque tous les composants sont déjà dans Kubernetes. Les bases de données restent à l'extérieur.
- Et de plus en plus, la question est posée : « Peut-on les intégrer à l'intérieur ? ». Par conséquent, les grandes entreprises tentent de maximiser l'unification de la gestion afin de pouvoir gérer rapidement leurs entrepôts de données.
- Cela est particulièrement utile s'il est nécessaire de reproduire au maximum la même chose à un nouvel endroit, c'est-à-dire une portabilité maximale.
À quel point cela est-il simple ou difficile ? Bien sûr, cela peut être fait manuellement. Mais ce n'est pas si simple, car nous avons à gérer la complexité de Kubernetes lui-même, et cela s'ajoute à la spécificité de ClickHouse. C'est donc une agrégation.
Et tout cela ensemble constitue un ensemble de technologies assez vaste, dont la gestion devient déjà assez complexe, car Kubernetes apporte ses propres questions quotidiennes d'exploitation, tandis que ClickHouse amène ses questions d'exploitation quotidienne. Surtout si nous avons plusieurs instances de ClickHouse, et que nous devons constamment intervenir.
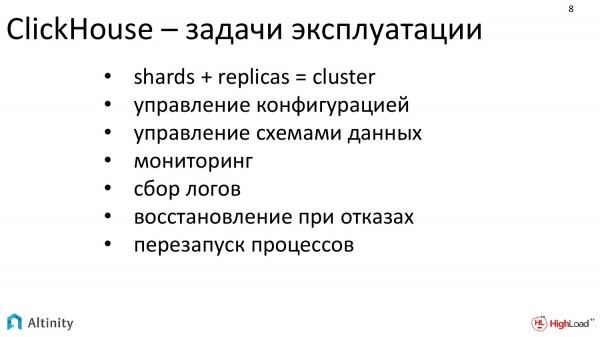
ClickHouse, avec une configuration dynamique, pose un certain nombre de questions qui créent une charge constante sur le DevOps :
- Lorsque nous souhaitons modifier quelque chose dans ClickHouse, par exemple, ajouter une réplique ou un shard, nous devons gérer la configuration.
- Ensuite, il faut changer le schéma de données, car ClickHouse a une méthode spécifique de sharding. Il faut organiser le schéma de données et configurer les paramètres.
- Il faut configurer la surveillance.
- Collecte des journaux pour les nouveaux shards, pour les nouvelles répliques.
- Il faut s'occuper de la restauration.
- Et du redémarrage.
Ce sont des tâches routinières qu'il serait souhaitable d'alléger dans l'exploitation.
Kubernetes aide bien à l'exploitation, mais dans les tâches système de base.
Kubernetes facilite et automatise des activités telles que :
- Restauration.
- Redémarrage.
- Gestion du système de stockage.
C'est bien, c'est la bonne direction, mais il n'a pas une compréhension complète de l'exploitation d'un cluster de bases de données.
On espère obtenir davantage, on souhaite faire fonctionner l'ensemble de la base de données sous Kubernetes.
On aimerait avoir quelque chose comme un grand bouton rouge magique, sur lequel vous appuyez et cela déploie et maintient un cluster tout au long de son cycle de vie, avec les tâches quotidiennes à résoudre. Un cluster ClickHouse sur Kubernetes.
Nous avons tenté de créer une solution qui aiderait à faciliter le travail. C'est l'opérateur ClickHouse pour Kubernetes de la société Altinity.
Un opérateur est un programme dont la tâche principale est de gérer d'autres programmes, c'est-à-dire un gestionnaire.
Il contient des modèles de comportement. On peut appeler cela des connaissances codifiées sur le domaine.
Sa tâche principale est d'alléger la vie des DevOps et de réduire le micromanagement, permettant ainsi au DevOps de penser en termes de haut niveau, c'est-à-dire qu'il ne s'occupe pas du micromanagement et ne configure pas tous les détails manuellement.
L'opérateur est justement un robot assistant qui lutte contre les micro-tâches et aide les DevOps.
Pourquoi avoir besoin d'un opérateur ? Il se montre particulièrement efficace sur deux points :
- Lorsque le spécialiste qui s'occupe de ClickHouse manque d'expérience, mais qu'il faut déjà exploiter ClickHouse, l'opérateur facilite l'exploitation et permet de gérer un cluster ClickHouse avec une configuration relativement complexe, sans vraiment se soucier des détails du fonctionnement interne. Il reçoit simplement des tâches de haut niveau, et cela fonctionne.
- La deuxième tâche dans laquelle il excelle particulièrement est celle de l'automatisation d'un grand nombre de tâches répétitives. Il soulage les administrateurs système des micro-tâches.
Cela est surtout nécessaire pour ceux qui commencent leur parcours ou pour ceux qui doivent se concentrer sur l'automatisation.
Quelle est donc la différence entre une approche basée sur des opérateurs et d'autres systèmes ? Il y a aussi Helm, qui aide à installer ClickHouse et qui permet de dessiner des chartes Helm qui peuvent même déployer un cluster entier de ClickHouse. Quelle est donc la différence entre un opérateur et Helm par exemple ?
La principale différence fondamentale est que Helm gère des paquets, tandis que l'opérateur va plus loin. Cela implique le suivi de tout le cycle de vie. Ce n'est pas juste une installation, mais des tâches quotidiennes qui incluent le dimensionnement, le sharding, c'est-à-dire tout ce qui doit être fait dans le cycle de vie (y compris la suppression si nécessaire) – tout cela est géré par l'opérateur. Il tente d'automatiser et de maintenir l'ensemble du cycle de vie des logiciels. C'est cela sa différence fondamentale par rapport aux autres solutions disponibles.
C'était la partie d'introduction, passons à la suite.
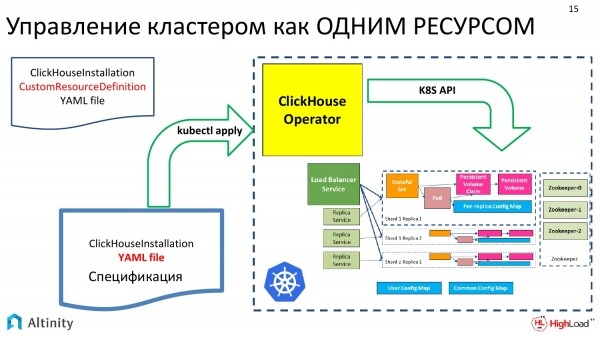
Comment construisons-nous notre opérateur ? Nous essayons d'aborder la question en gérant le cluster ClickHouse comme une seule ressource.
Ici, à gauche, nous avons les données d'entrée. C'est un YAML avec la spécification du cluster, qui est traditionnellement transmis à Kubernetes via kubectl. L'opérateur le capte, fait sa magie et à la sortie nous obtenons un schéma comme celui-ci. C'est l'implémentation de ClickHouse dans Kubernetes.
Nous allons ensuite examiner progressivement comment fonctionne l'opérateur, quelles tâches typiques peuvent être résolues. Nous ne traiterons que les tâches typiques, car notre temps est limité. Nous ne parlerons pas de tout ce que l'opérateur peut résoudre.
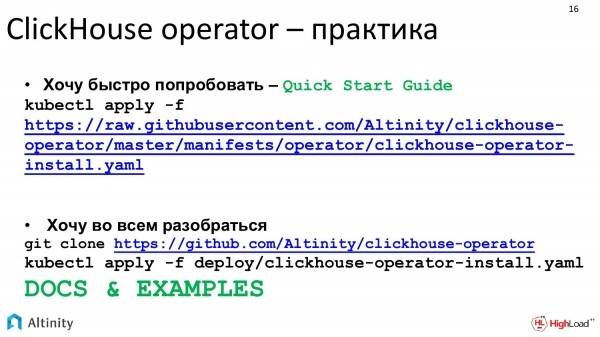
Partons de la pratique. Notre projet est entièrement open source, donc vous pouvez voir sur GitHub comment il fonctionne. Si vous voulez simplement lancer, vous pouvez commencer avec le Quick Start Guide.
Si vous souhaitez vous plonger dans les détails, nous essayons de maintenir la documentation dans un état raisonnablement correct.
Commençons par un exercice pratique. Le premier défi, par lequel nous voulons tous commencer, est de lancer le premier exemple d'une manière ou d'une autre. Comment lancer ClickHouse à l'aide d'un opérateur, même sans vraiment savoir comment il fonctionne ? Nous rédigeons un manifeste, car toute communication avec k8s se fait via des manfestes.
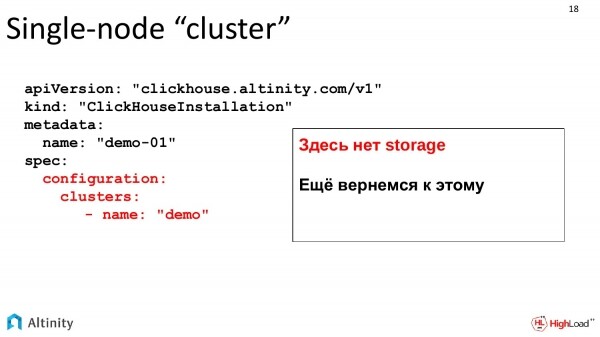
Voici un manifeste assez complexe. Ce que nous avons surligné en rouge est ce sur quoi il faut mettre l'accent. Nous demandons à l'opérateur de créer un cluster nommé demo.
Pour l'instant, ce sont des exemples de base. Le stockage n'est pas encore décrit, mais nous reviendrons au stockage un peu plus tard. Pour l'instant, nous allons observer le développement du cluster en dynamique.
Nous avons créé ce manifeste. Nous le donnons à notre opérateur. Il a travaillé, fait sa magie.
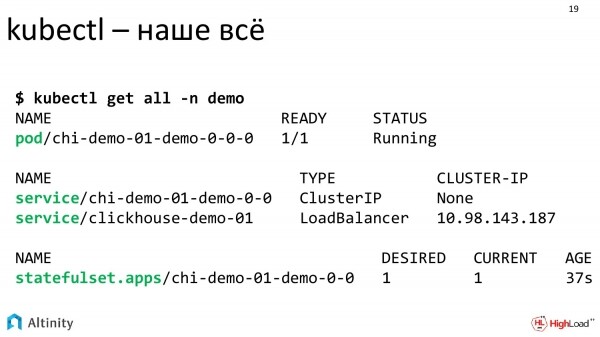
Nous regardons dans la console. Trois composants suscitent notre intérêt : le Pod, deux Services, et le StatefulSet.
L'opérateur a fonctionné, et nous pouvons voir ce qu'il a créé.
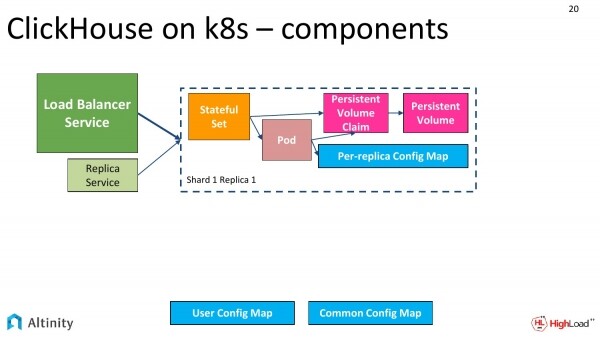
Il crée à peu près ce schéma. Nous avons un StatefulSet, un Pod, un ConfigMap pour chaque réplique, un ConfigMap pour l'ensemble du cluster. Des services sont indispensables comme points d'entrée dans le cluster.
Les services sont le Load Balancer Service central et éventuellement un pour chaque réplique, pour chaque shard.
Voici à quoi ressemble un cluster de base. Il est constitué d'un seul nœud.
Allons plus loin, compliquons les choses. Il faut sharder le cluster.
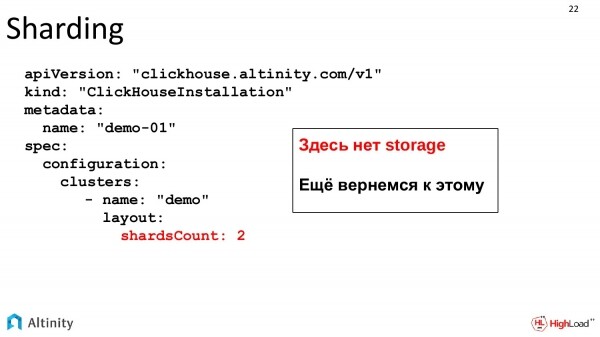
Nos tâches augmentent, et la dynamique commence. Nous voulons ajouter un shard. Nous suivons le développement. Nous changeons notre spécification. Nous indiquons que nous voulons deux shards.
C'est le même fichier qui se développe dynamiquement avec la croissance du système. Il n'y a pas de stockage, le stockage sera abordé plus tard, c'est un sujet distinct.
Nous donnons le YAML à l'opérateur et voyons ce que cela donne.
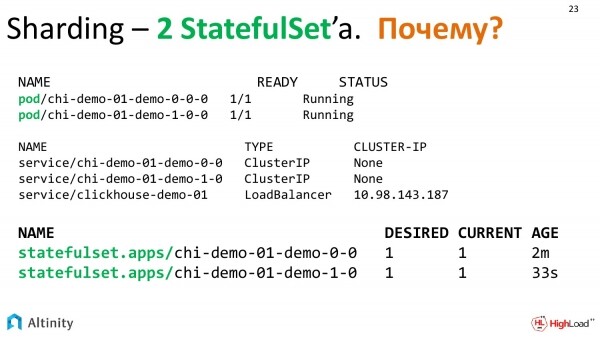
L'opérateur a réfléchi et a créé les entités suivantes. Nous avons déjà deux Pods, trois Services, et, soudainement, 2 StatefulSets. Pourquoi 2 StatefulSets ?
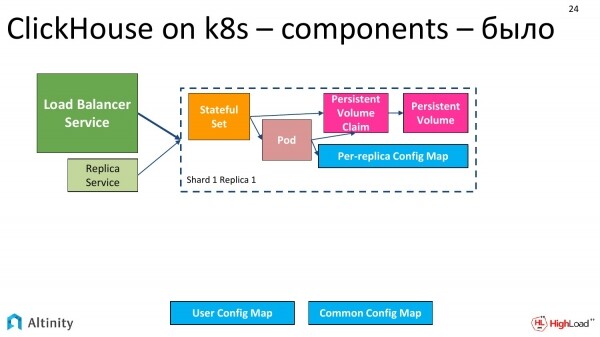
Sur le schéma, c'était comme ça – c'est notre état initial, lorsque nous avions un pod.
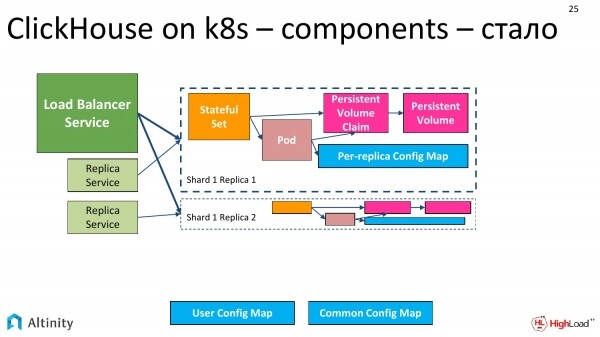
Cela devient ainsi. Pour l'instant, tout est simple, cela a été dupliqué.
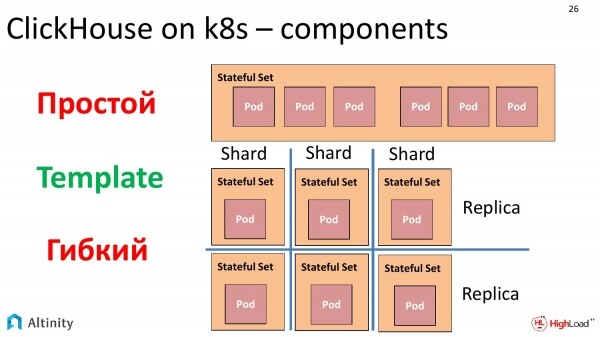
Et pourquoi y a-t-il deux StatefulSets ? Il faut s'arrêter un moment et discuter de la manière dont Kubernetes gère les Pods.
Il existe un objet appelé StatefulSet, qui permet de créer un ensemble de Pods à partir d'un modèle. Le facteur clé ici est le modèle. Et il est possible de lancer plusieurs Pods à partir d'un même modèle dans un StatefulSet. La phrase clé ici est « plusieurs Pods à partir d'un même modèle ».
Il y avait une grande tentation de faire tout le cluster en l' empaquetant dans un seul StatefulSet. Cela fonctionnerait, il n'y a aucun problème à cela. Mais il y a un détail. Si nous voulons créer un cluster hétérogène, c'est-à-dire avec plusieurs versions de ClickHouse, alors nous commençons à avoir des questions. Oui, StatefulSet peut effectuer une mise à jour progressive, et il est possible d'appliquer une nouvelle version, en précisant qu'il ne faut pas essayer d'avoir plus de cette quantité de nœuds à la fois.
Mais si nous extrapolons la tâche et disons que nous voulons créer un cluster complètement hétérogène et que nous ne souhaitons pas remplacer une ancienne version par une nouvelle à l'aide de la mise à jour progressive, mais que nous voulons simplement créer un cluster hétérogène tant en termes de différentes versions de ClickHouse que de différents types de stockage. Nous souhaitons, par exemple, que certaines répliques soient sur des disques séparés, sur des disques lents, en gros construire complètement un cluster hétérogène. Et à cause du fait que StatefulSet propose une solution standardisée à partir d'un seul modèle, il n'est donc pas possible de faire cela.
Après réflexion, il a été décidé de procéder comme suit. Chaque réplique a son propre StatefulSet. Cette solution présente certains inconvénients, mais pratiquement, elle encapsule complètement l'opérateur. Et il y a de nombreux avantages. Nous pouvons construire complètement le type de cluster que nous voulons, par exemple complètement hétérogène. Ainsi, dans le cluster où nous avons deux shards avec une réplique chacun, nous aurons 2 StatefulSets et 2 Pods précisément parce que nous avons choisi cette approche en raison des raisons mentionnées précédemment pour la possibilité de construire un cluster hétérogène.
Revenons à des tâches pratiques. Dans notre cluster, il est nécessaire de configurer les utilisateurs, c'est-à-dire qu'il faut produire une certaine configuration de ClickHouse dans Kubernetes. L'opérateur fournit toutes les possibilités à cet égard.
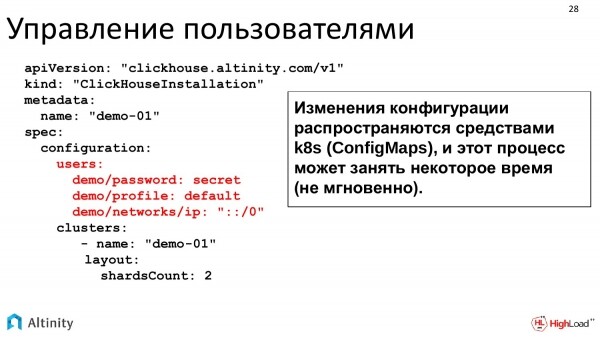
Nous pouvons directement écrire dans le YAML ce que nous voulons. Toutes les options de configuration se mappent directement depuis ce YAML vers les configs ClickHouse, qui sont ensuite réparties dans tout le cluster.
Nous pouvons aussi écrire de cette manière. C'est juste un exemple. Le mot de passe peut être chiffré. Toutes les options de configuration de ClickHouse sont absolument supportées. C'est seulement un exemple.
La configuration du cluster est diffusée sous forme de ConfigMap. En pratique, la mise à jour de ConfigMap ne se fait pas instantanément, donc si le cluster est grand, le processus de propagation de la configuration prend un certain temps. Mais tout cela est très pratique à utiliser.
Nous compliquons la tâche. Le cluster se développe. Nous voulons répliquer des données. Autrement dit, nous avons déjà deux shards, avec une réplique chacun, et les utilisateurs sont configurés. Nous grandissons et souhaitons nous consacrer à la réplication.
Que nous faut-il pour la réplication?
Nous avons besoin de ZooKeeper. Dans ClickHouse, la réplication est construite en utilisant ZooKeeper. ZooKeeper est nécessaire pour que différentes répliques de ClickHouse aient un consensus sur les blocs de données présents dans chaque ClickHouse.
Vous pouvez utiliser n'importe quel ZooKeeper. Si l'entreprise dispose d'un ZooKeeper externe, il peut être utilisé. Sinon, vous pouvez l'installer à partir de notre référentiel. Il existe un installateur qui facilite tout cela.
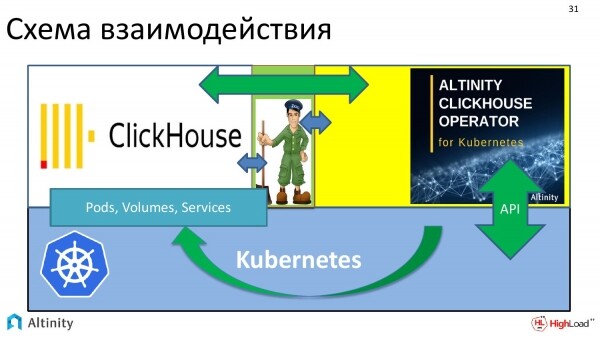
Et le schéma d'interaction de l'ensemble du système est le suivant. Nous avons Kubernetes comme plateforme. Sur celui-ci s'exécute l'opérateur ClickHouse. J'ai représenté ZooKeeper ici. Et l'opérateur interagit à la fois avec ClickHouse et avec ZooKeeper. Cela signifie qu'il y a interaction.
Et tout cela est nécessaire pour que ClickHouse puisse répliquer des données avec succès dans k8s.
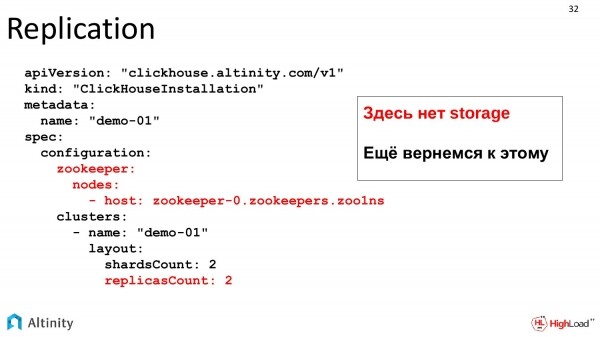
Voyons maintenant la tâche elle-même, la façon dont le manifeste de réplication sera présenté.
Nous ajoutons deux sections à notre manifeste. La première concerne la source de ZooKeeper, qui peut être à la fois interne à Kubernetes ou externe. C'est juste une description. Et nous commandons des répliques. Autrement dit, nous voulons deux répliques. Au total, nous devrions avoir 4 pod. Nous nous souvenons que le stockage sera abordé un peu plus tard. Le stockage est une histoire à part.
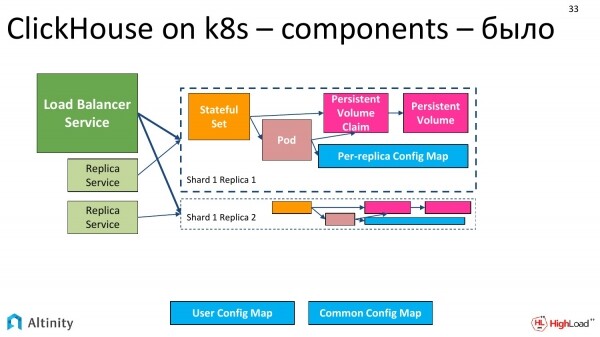
C'était comme ça.
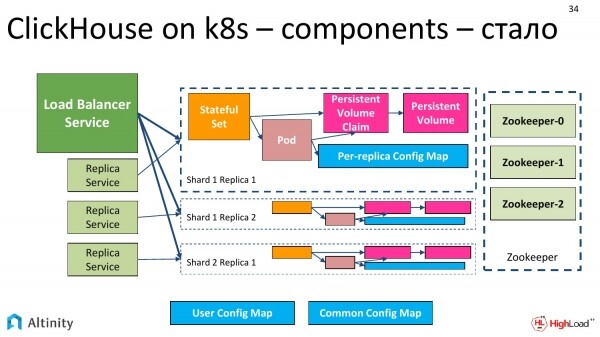
Cela devient ainsi. Des répliques sont ajoutées. La quatrième ne rentrait pas, nous croyons qu'il peut y en avoir beaucoup. Et sur le côté, ZooKeeper est ajouté. Les schémas se complexifient.
Il est temps d'ajouter la tâche suivante. Nous allons ajouter un stockage persistant.
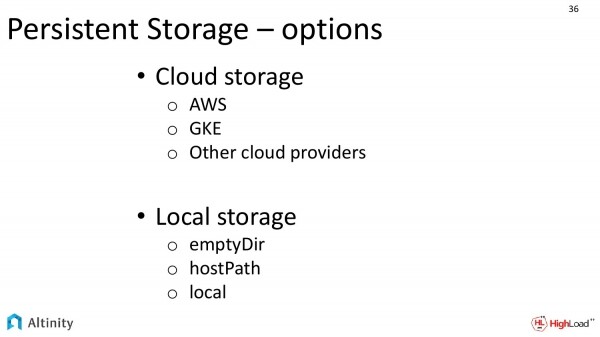 Pour le stockage persistant, nous avons différentes options d'implémentation.
Dans le cas où nous nous exécutons chez un fournisseur cloud, par exemple, en utilisant Amazon, Google, il y a une grande tentation d'utiliser un stockage cloud. C'est très pratique, c'est bon.
Et il y a une deuxième option. C'est pour le stockage local, lorsque nous avons des disques locaux sur chaque nœud. Cette option est beaucoup plus complexe à exécuter, mais elle est plus performante.
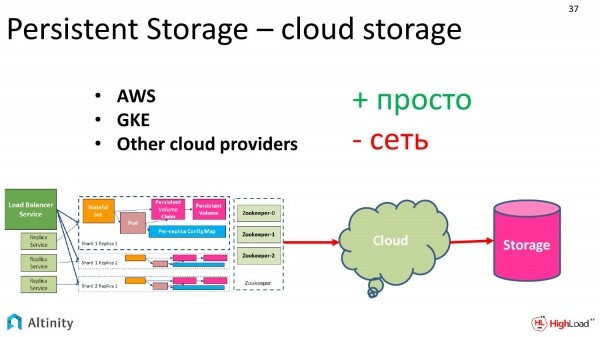
Voyons ce que nous avons concernant le stockage cloud.
Il y a des avantages. C'est très simple à configurer. Nous commandons simplement à notre fournisseur cloud de nous donner, s'il vous plaît, un stockage de telle capacité, de telle classe. Les classes sont définies par les fournisseurs eux-mêmes.
Il y a un inconvénient. Pour certains, cela n'est pas critique. Bien sûr, il y aura des problèmes de performance. C'est très pratique au travail, fiable, mais il existe certaines baisses de performance potentielles.
Et comme ClickHouse met l'accent sur la performance, on peut même dire qu'il extrait le maximum possible, c'est pourquoi de nombreux clients essaient d'optimiser leurs performances.
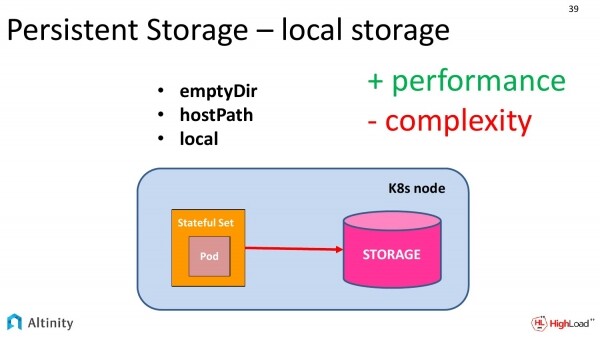
Pour tirer le meilleur parti, nous avons besoin d'un stockage local.
Kubernetes fournit trois abstractions pour utiliser le stockage local. Ce sont :
- EmptyDir
- HostPath.
- Local
Considérons comment ils diffèrent et se ressemblent.
Tout d'abord, dans les trois approches, le stockage est constitué de disques locaux situés sur le même nœud physique Kubernetes. Mais ils ont certaines différences.
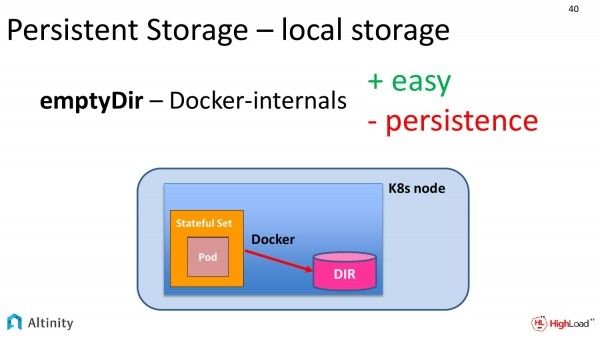
Commençons par le plus simple, c'est-à-dire emptyDir. Qu'est-ce que c'est en pratique ? C'est quand dans notre spécification, nous demandons au système de conteneurisation (la plupart du temps, c'est Docker) de nous donner accès à un dossier sur le disque local.
En pratique, Docker crée quelque part, sur ses propres chemins, un dossier temporaire, le nommant avec un long hachage. Et il fournit une interface d'accès à celui-ci.
Comment cela fonctionnera-t-il en termes de performance ? Cela fonctionnera à la vitesse du disque local, c'est-à-dire que c'est un accès complet à votre disque.
Mais cela a son inconvénient. La persistance est assez douteuse dans ce cas. À la première action de Docker avec des conteneurs, la persistance est perdue. Si Kubernetes décide pour une raison quelconque de déplacer ce Pod sur un autre disque, les données seront perdues.
Cette approche est bonne pour les tests, car elle montre déjà une vitesse satisfaisante, mais pour quelque chose de sérieux, cette option n'est pas adéquate.
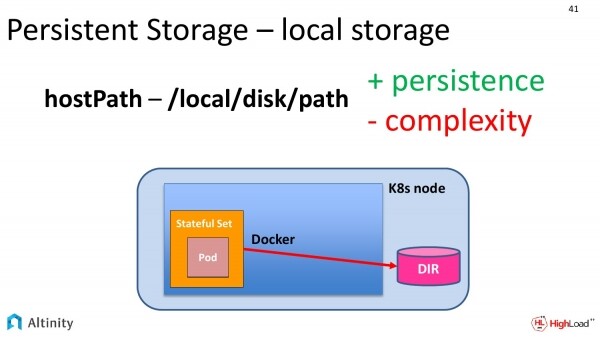
C'est pourquoi il existe une deuxième approche. C'est le hostPath. Si nous regardons les diapositives précédentes et celle-ci, nous pouvons voir une seule différence. Notre dossier a été déplacé du Docker vers le nœud Kubernetes. C'est un peu plus simple. Nous inscrivons directement le chemin dans le système de fichiers local où nous souhaitons stocker nos données.
Ce moyen présente des avantages. C'est une véritable persistance, et en plus, c'est classique. Les données seront enregistrées sur le disque à une certaine adresse.
Il y a aussi des inconvénients. C'est la complexité de la gestion. Notre Kubernetes peut vouloir déplacer un Pod vers un autre nœud physique. Et c'est là qu'intervient DevOps. Il doit bien expliquer à tout le système que ces Pods ne peuvent être déplacés que sur des nœuds où tu as quelque chose monté sur ces chemins, et pas plus d'un nœud à la fois. C'est assez compliqué.
Spécifiquement pour ces besoins, nous avons créé des modèles chez notre opérateur pour cacher toute cette complexité. On pouvait simplement dire : « Je veux qu'il y ait une instance de ClickHouse sur chaque nœud physique et sur tel chemin ».
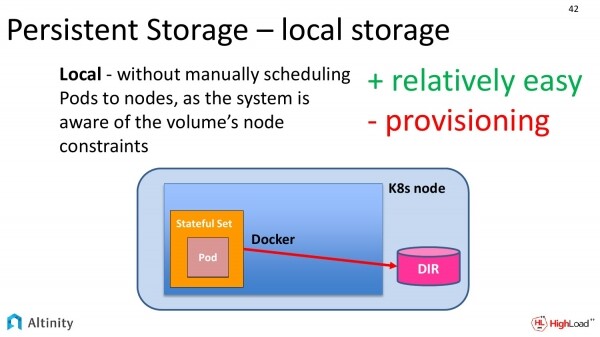
Mais ce besoin n'est pas seulement le nôtre, donc les messieurs de Kubernetes comprennent aussi que les gens veulent accéder aux disques physiques, c'est pourquoi ils offrent un troisième niveau.
Cela s'appelle local. La différence avec la diapositive précédente est pratiquement nulle. Auparavant, il fallait le faire manuellement, dire que ces Pods ne peuvent pas être déplacés d'un nœud à un autre, parce qu'ils doivent être attachés à un chemin spécifique d'un disque physique local, et maintenant toutes ces connaissances sont encapsulées dans Kubernetes lui-même. Et donc, c'est beaucoup plus facile à configurer.
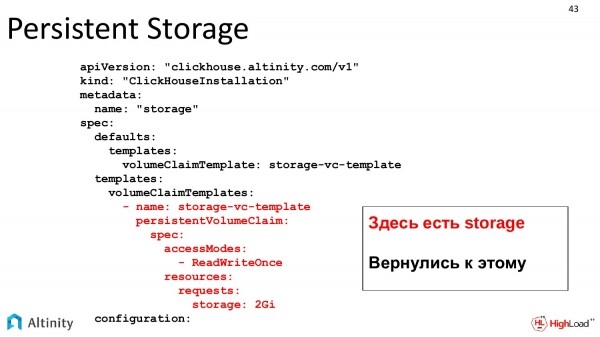
Revenons à notre tâche pratique. Revenons au modèle YAML. Ici, nous avons un vrai stockage. Nous sommes revenus à cela. Nous définissons un modèle classique VolumeClaim comme dans k8s. Et nous décrivons quel stockage nous voulons.
Après cela, k8s demandera du stockage. Il nous en attribuera dans le StatefulSet. Et finalement, cela sera à la disposition de ClickHouse.
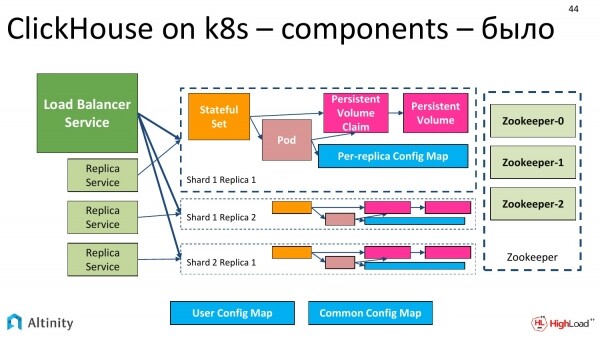
Nous avions un schéma comme ceci. Notre stockage persistant était rouge, ce qui suggérait qu'il fallait le faire.
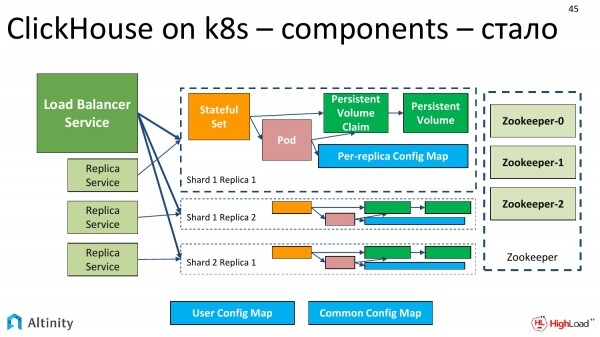
Et il devient vert. Maintenant, le schéma du cluster ClickHouse sur k8s est complètement finalisé. Nous avons des shards, des répliques, ZooKeeper, il y a un vrai persistant, réalisé d'une manière ou d'une autre. Le schéma est déjà entièrement opérationnel.
Nouscontinuons à avancer. Notre cluster évolue. Et Alexey s'efforce, il sort une nouvelle version de ClickHouse.
Une tâche pratique se pose - tester la nouvelle version de ClickHouse sur notre cluster. Évidemment, on ne veut pas tout mettre à jour, on veut peut-être installer la nouvelle version dans un coin éloigné sur une réplique, ou peut-être pas une nouvelle version, mais deux, car elles sortent fréquemment.
Que pouvons-nous en dire ?
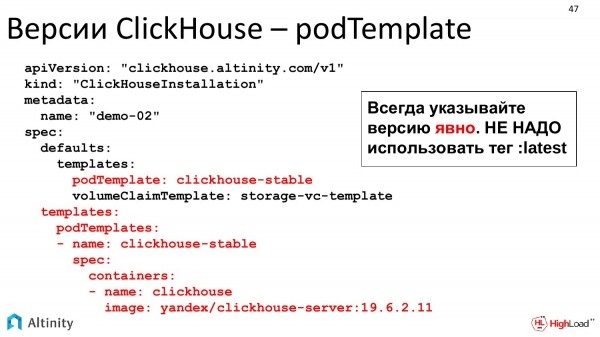
Ici, nous avons justement cette possibilité. Ce sont des modèles de pod. On peut détailler comment notre opérateur permet de construire un cluster hétérogène. C’est-à-dire configuré, allant de toutes les répliques en tas, jusqu'à chaque réplique personnelle, avec quelle version de ClickHouse nous souhaitons, quelle version de stockage nous voulons. Nous pouvons complètement configurer un cluster de cette configuration comme nous en avons besoin.
Nous allons maintenant approfondir un peu. Auparavant, nous avons parlé du fonctionnement de l'opérateur ClickHouse en relation avec la spécificité de ClickHouse.
Maintenant, j'aimerais dire quelques mots sur le fonctionnement de n'importe quel opérateur, ainsi que sur la manière dont il interagit avec K8s.
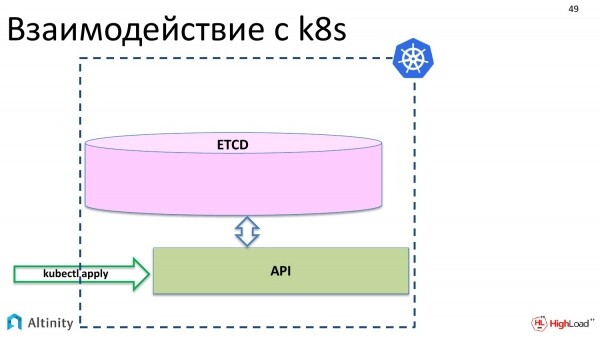
Commençons par examiner l'interaction avec K8s. Que se passe-t-il lorsque nous faisons un kubectl apply ? Nos objets apparaissent via l'API dans etcd.
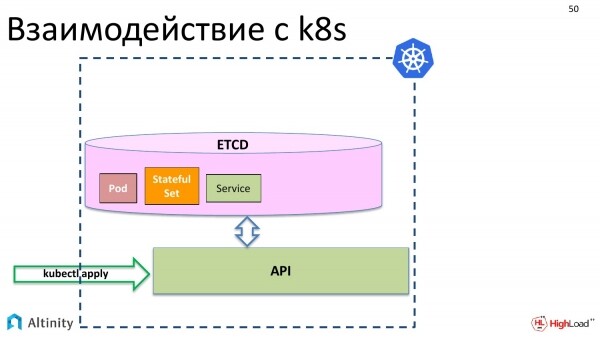
Par exemple, les objets de base de Kubernetes : pod, StatefulSet, service, etc.
À ce stade, rien de physique ne se produit encore. Ces objets doivent être matérialisés dans le cluster.
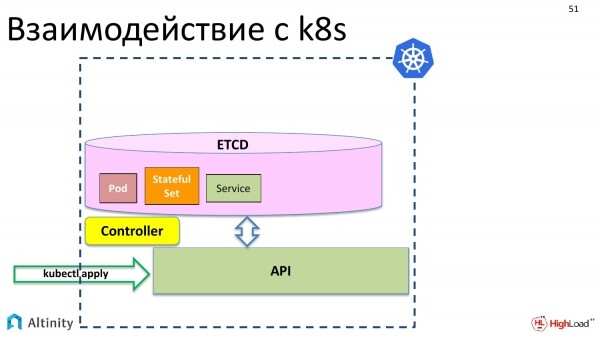
Pour cela, un contrôleur apparaît. Le contrôleur est un composant spécial de k8s qui sait comment matérialiser ces descriptions. Il sait comment et ce qu'il faut faire physiquement. Il sait comment exécuter des conteneurs, ce qu'il faut configurer pour que le serveur fonctionne.
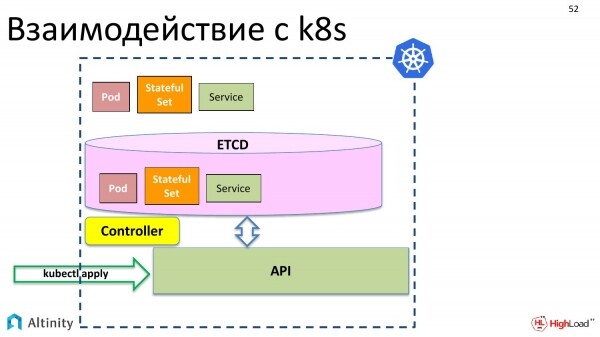
Et il matérialise nos objets dans K8s.
Mais nous voulons opérer non seulement avec des pods et des StatefulSets, nous voulons créer une ClickHouseInstallation, c'est-à-dire un objet de type ClickHouse, pour l'opérer comme un tout. Pour l'instant, cette possibilité n'existe pas.
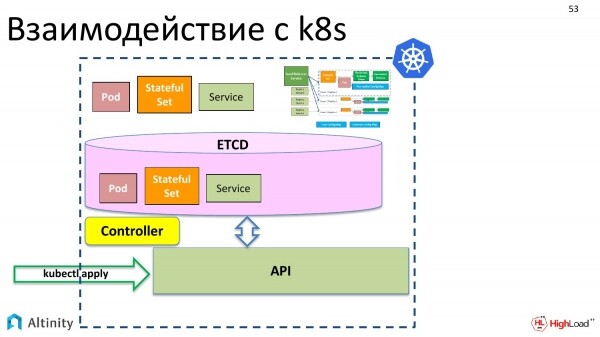
Mais K8s a une autre chose sympa. Nous souhaitons qu'il y ait quelque part cette entité complexe, qui serait constituée de pods et de StatefulSets pour notre cluster.
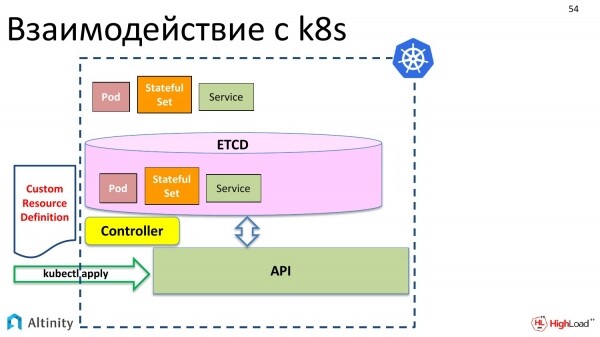
Et que faut-il faire pour cela ? Tout d'abord, la Custom Resource Definition entre en jeu. Qu'est-ce que c'est ? C'est une description pour K8s indiquant que vous aurez un autre type de données, que nous souhaitons ajouter une ressource personnalisée complexe aux pods et StatefulSets. C'est une description de la structure des données.
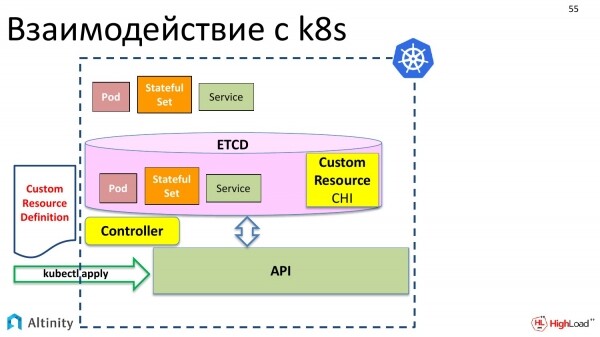
Nous l'envoyons également via kubectl apply. Kubernetes l'a joyeusement accepté.
Et maintenant, nous avons dans le stockage, dans l'objet dans etcd, la possibilité d'enregistrer une ressource personnalisée appelée ClickHouseInstallation.
Mais pour l'instant, rien d'autre ne se produira. C'est-à-dire que si nous créons maintenant un fichier YAML que nous avons examiné, contenant la description des shards, des répliques, et que nous exécutons « kubectl apply », Kubernetes l'acceptera, le mettra dans etcd et dira : « Très bien, mais je ne sais pas quoi en faire. Je ne sais pas comment gérer ClickHouseInstallation. »
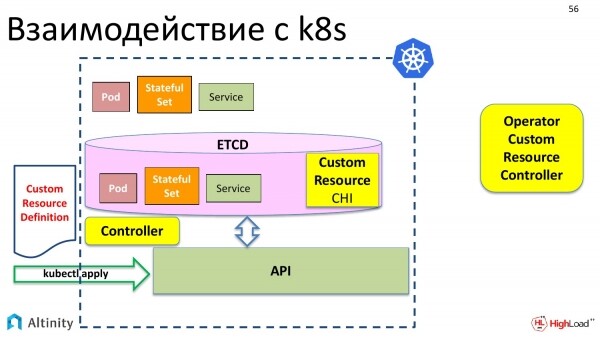
Par conséquent, nous avons besoin de quelqu'un pour aider Kubernetes à gérer un nouveau type de données. À gauche, nous avons le contrôleur Kubernetes par défaut, qui travaille avec des types de données standard. À droite, nous devrions avoir un contrôleur personnalisé qui sait travailler avec des types de données personnalisés.
Et autrement dit, cela s'appelle un opérateur. Je l'ai ici spécifiquement mis en dehors de Kubernetes, car il peut fonctionner en dehors de K8s. Le plus souvent, tous les opérateurs fonctionnent dans Kubernetes, mais rien ne l'empêche de fonctionner à l'extérieur, c'est pourquoi il est spécifiquement mis à l'extérieur ici.
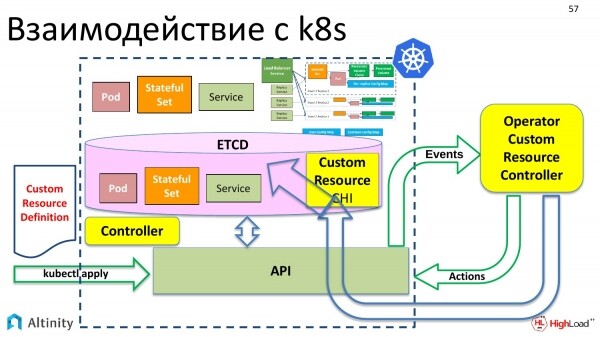
Et déjà à son tour, le contrôleur personnalisé, aussi appelé opérateur, interagit avec Kubernetes via l'API. Il sait déjà interagir avec l'API. Et il sait déjà comment matérialiser un schéma complexe à partir d'une ressource personnalisée que nous voulons créer. C'est précisément ce que fait l'opérateur.
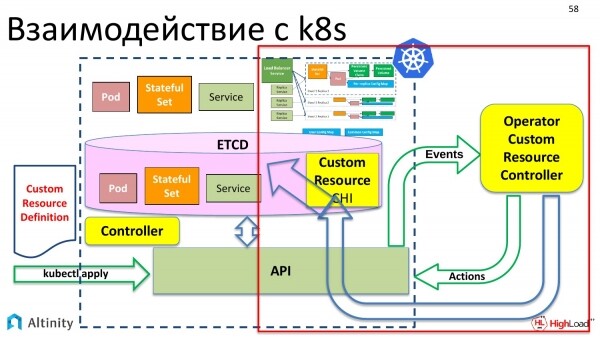
Comment fonctionne un opérateur ? Regardons la partie droite pour savoir comment il fait cela. Découvrons comment l'opérateur matérialise tout cela et comment se déroule ensuite l'interaction avec K8s.
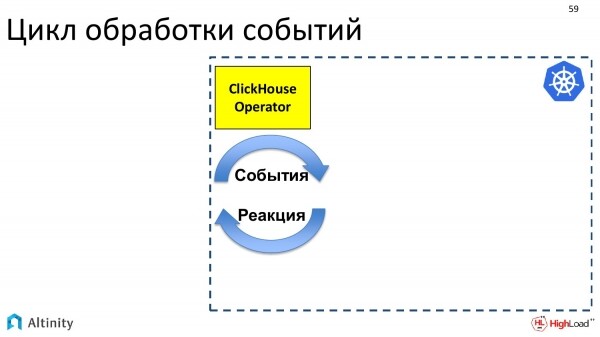
L'opérateur est un programme. Il est orienté événements. L'opérateur s'abonne aux événements via l'API Kubernetes. Dans l'API Kubernetes, il existe des points d'entrée où l'on peut s'abonner aux événements. Et si quelque chose change dans K8s, Kubernetes envoie des événements à tous ceux qui le souhaitent, c'est-à-dire que ceux qui se sont abonnés à ce point API recevront des notifications.
L'opérateur s'abonne aux événements et doit effectuer une certaine réaction. Sa tâche est de réagir aux événements qui apparaissent.
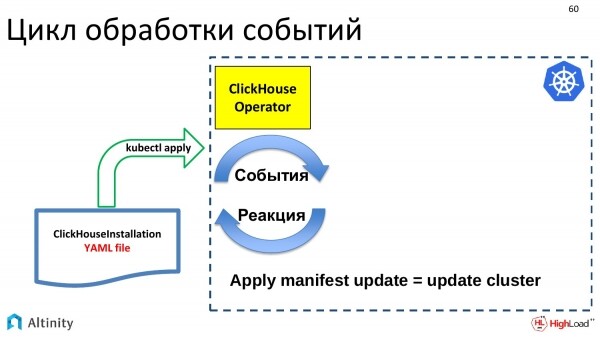
Les événements sont générés par certaines mises à jour. Notre fichier YAML avec la description de ClickHouseInstallation arrive. Il passe par kubectl apply et va dans etcd. Un événement a alors été déclenché, et cet événement est finalement arrivé au ClickHouse-operator. L'opérateur a reçu cette description. Et il doit faire quelque chose. Si une mise à jour de l'objet ClickHouseInstallation arrive, il faut mettre à jour le cluster. Et la tâche de l'opérateur est de mettre à jour le cluster.
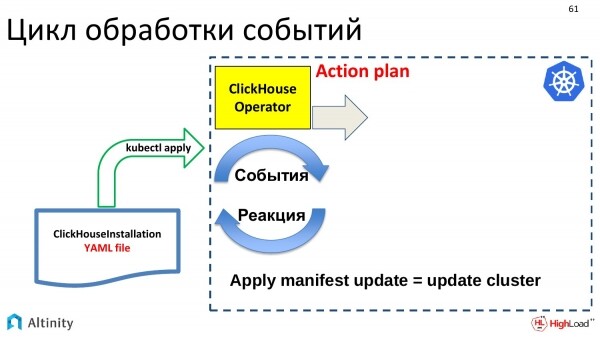
Que fait-il ? Tout d'abord, il faut établir un plan d'action pour déterminer ce que nous allons faire avec cette mise à jour. Les mises à jour peuvent être très petites, c'est-à-dire de petites exécutions YAML, mais elles peuvent entraîner des changements très importants dans le cluster. Par conséquent, l'opérateur crée un plan et s'y tient ensuite.
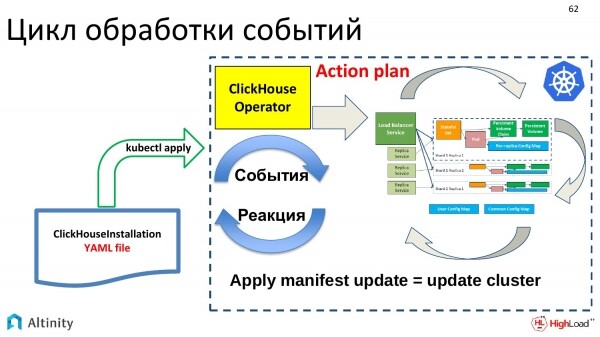
Il commence à travailler en conformité avec ce plan pour matérialiser les pod, les services, c'est-à-dire pour faire ce qui est sa tâche principale. C'est comme construire un cluster ClickHouse dans Kubernetes.
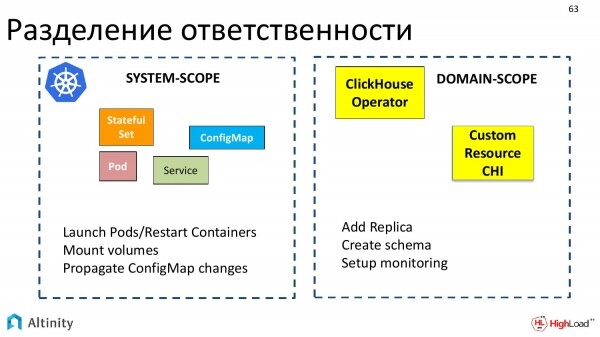
Désormais, abordons une question intéressante. Il s'agit de la répartition des responsabilités entre Kubernetes et l'opérateur, c'est-à-dire ce que fait Kubernetes, ce que fait l'opérateur et comment ils interagissent entre eux.
Kubernetes s'occupe des éléments système, c'est-à-dire du jeu d'objets de base qui peut être interprété comme un ensemble à portée système. Kubernetes sait comment lancer des pod, redémarrer des conteneurs, monter des volumes, travailler avec ConfigMap, c'est-à-dire tout ce qui peut être qualifié de système.
Les opérateurs opèrent dans des domaines d'application. Chaque opérateur est conçu pour son domaine d'application. Nous avons créé celui pour ClickHouse.
Et l'opérateur interagit précisément dans les termes du domaine d'application, tels que l'ajout d'une réplique, la création d'un schéma, la configuration de la surveillance. Il en résulte une telle répartition.
Examinons un exemple pratique de la façon dont cette répartition des responsabilités se produit lorsque nous effectuons l'action d'ajout d'une réplique.
L'opérateur reçoit la tâche d'ajouter une réplique. Que fait-il ? L'opérateur calcule qu'il faut créer un nouveau StatefulSet, dans lequel il doit décrire certains modèles et les réclamations de volumes.
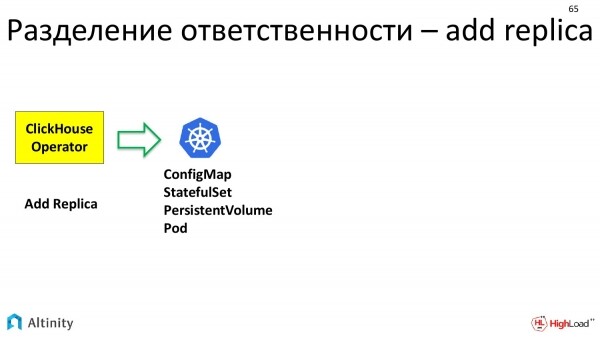
Il prépare tout cela et le transmet ensuite à K8s. Il indique qu'il a besoin d'une ConfigMap, d'un StatefulSet, d'un Volume. Kubernetes exécute cela. Il matérialise les unités de base avec lesquelles il fonctionne.
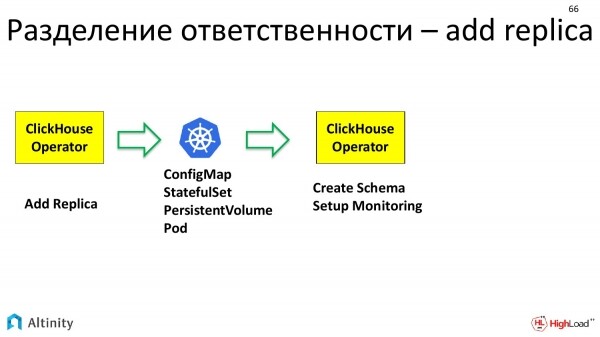
Et ensuite, le ClickHouse-operator entre à nouveau en jeu. Il a déjà un pod physique sur lequel il peut travailler. Et le ClickHouse-operator travaille à nouveau dans les termes du domaine d'application. C'est-à-dire que pour inclure une réplique dans le cluster ClickHouse, il faut d'abord configurer le schéma de données existant dans ce cluster. Deuxièmement, cette réplique doit être intégrée dans la surveillance afin d'être bien suivie. L'opérateur s'en occupe déjà.
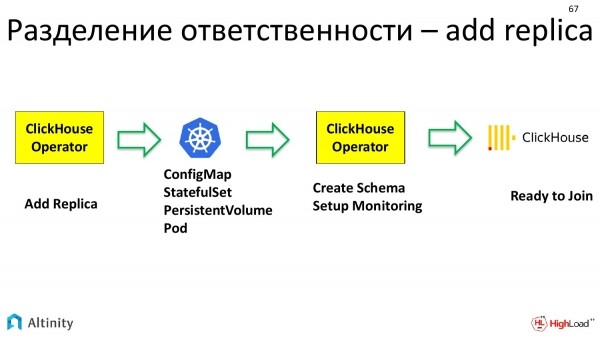
Et ce n'est qu'ensuite que ClickHouse entre en jeu, c'est-à-dire une autre entité de niveau supérieur. C'est déjà une base de données. Elle dispose de sa propre instance, d'une nouvelle réplique configurée, prête à rejoindre le cluster.
On obtient une chaîne d'exécution et de répartition des responsabilités lors de l'ajout d'une réplique qui est assez longue.
Continuons nos tâches pratiques. Si le cluster existe déjà, il est possible d'effectuer la migration de la configuration.
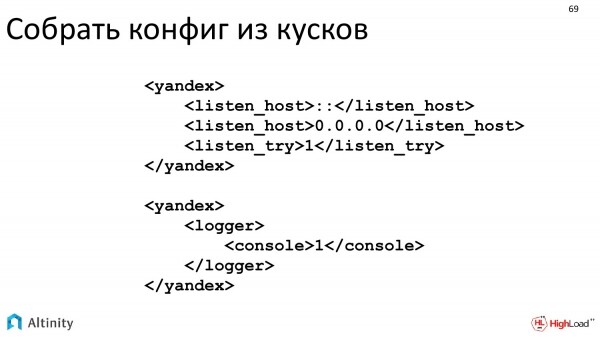
Nous avons fait en sorte que dans le XML existant, que ClickHouse comprend, on puisse passer à travers.
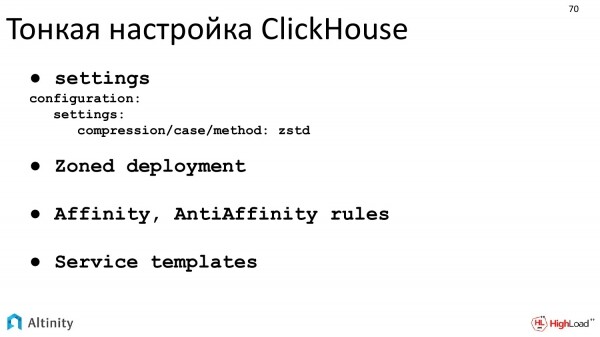
Il est possible de faire un réglage fin de ClickHouse. En fait, le déploiement zoné est ce dont j'ai parlé en expliquant hostPath, le stockage local. C'est comment réaliser correctement un déploiement zoné.
La prochaine tâche pratique concerne la surveillance.
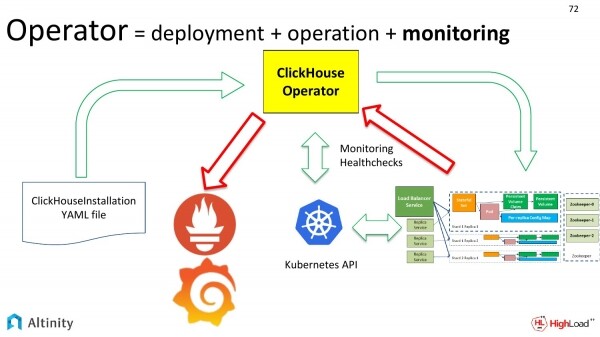
Si notre cluster change, il est nécessaire de configurer périodiquement la surveillance.
Examinons le schéma. Nous avons déjà étudié les flèches vertes ici. Maintenant, regardons les flèches rouges. C'est ainsi que nous voulons surveiller notre cluster. Comment les métriques du cluster ClickHouse vont dans Prometheus, puis dans Grafana.
Quelle est la difficulté liée à la surveillance ? Pourquoi cela est-il considéré comme un accomplissement ? La complexité réside dans la dynamique. Lorsque nous avons un cluster unique et qu'il est statique, il est possible de configurer une fois pour toutes la surveillance et de ne plus s'en préoccuper.
Mais si nous avons plusieurs clusters, ou si quelque chose change constamment, le processus devient dynamique. Et s'occuper en permanence de la reconfiguration de la surveillance est une perte de ressources et de temps, c'est-à-dire même simplement de l'ennui. Il faut automatiser cela. La complexité réside précisément dans la dynamique du processus. Et l'opérateur l'automatise très bien.
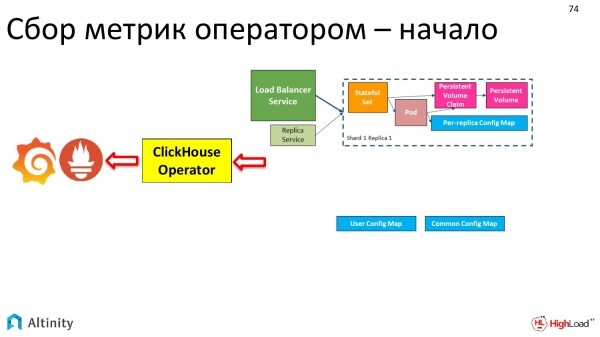
Comment notre cluster a-t-il évolué ? Au début, il était comme ça.
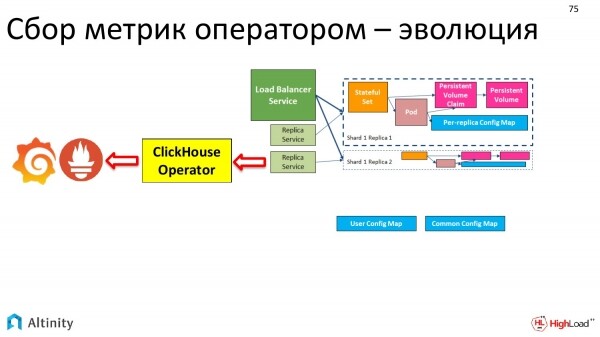
Ensuite, il est devenu comme ça.
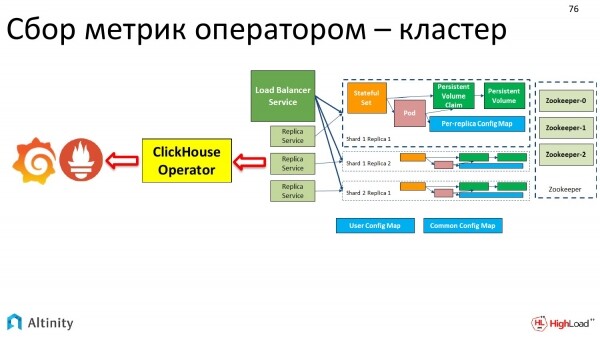
Au final, il est devenu comme ça.
Et la surveillance est automatiquement effectuée par l'opérateur. Un point d'entrée unique.
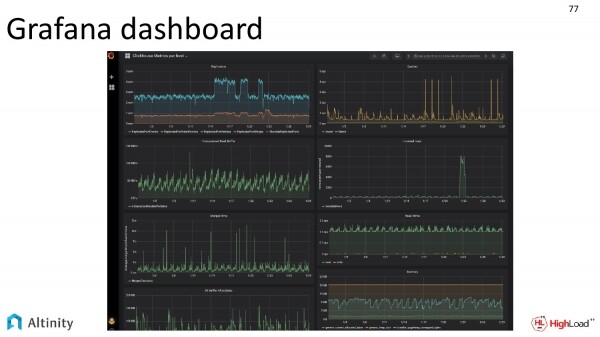
Nous regardons simplement dans le tableau de bord Grafana pour voir comment la vie de notre cluster s'anime à l'intérieur.
Au fait, le tableau de bord Grafana est également distribué avec notre opérateur directement dans le code source. Vous pouvez le connecter et l'utiliser. Ce screenshot m'a été donné par nos DevOps.
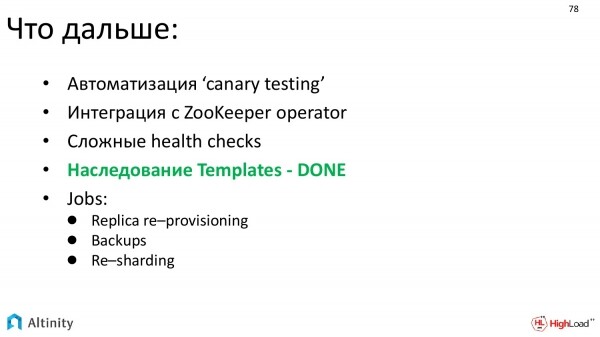
Où voudrions-nous avancer ? C'est :
- Développer l'automatisation des tests. L'objectif principal est le test automatisé des nouvelles versions.
- Nous voulons également automatiser l'intégration avec ZooKeeper. Et nous prévoyons de nous intégrer avec ZooKeeper-operator. C'est-à-dire qu'un opérateur a été écrit pour ZooKeeper et il est logique que les deux opérateurs commencent à s'intégrer pour créer une solution plus conviviale.
- Nous souhaitons effectuer des contrôles de santé plus complexes.
- En vert, j'ai souligné que nous avons l'héritage des Templates en cours - FAIT, c'est-à-dire qu'avec la prochaine version de l'opérateur, nous aurons déjà l'héritage des modèles. C'est un outil puissant qui permet de construire des configurations complexes à partir de morceaux.
- Et nous voulons automatiser des tâches complexes. La principale est le Re-sharding.
Faisons le point intermédiaire.
Qu'obtenons-nous à la sortie ? Et vaut-il la peine de s'en occuper ou non ? Devons-nous vraiment essayer d'intégrer la base de données dans Kubernetes et d'appliquer l'opérateur en général, et l'opérateur Alitnity en particulier ?
À la sortie, nous obtenons :
- Une simplification significative et une automatisation de la configuration, du déploiement, ainsi que du support.
- Surveillance intégrée immédiatement.
- Et des modèles codifiés prêts à l'emploi pour des situations complexes. Il n'est plus nécessaire d'ajouter une réplique manuellement. Cela est géré par l'opérateur.
Il reste une dernière question. Nous avons déjà une base de données dans Kubernetes, de la virtualisation. Quelle est la performance de cette solution, surtout en tenant compte du fait que ClickHouse est optimisé pour la performance ?
La réponse - tout est normal ! Je ne vais pas détailler cela, c'est un sujet pour une présentation séparée.
Mais il existe un projet, appelé TSBS. Quel est son objectif principal ? C'est un test de bases de données pour la performance. C'est une tentative de comparer le chaud avec le chaud, le doux avec le doux.
Comment cela fonctionne-t-il ? Un ensemble de données est généré. Ensuite, cet ensemble de données est exécuté sur le même ensemble de tests sur différentes bases de données. Chaque base de données résout un problème comme elle sait le faire. Et ensuite, les résultats peuvent être comparés.
Il prend déjà en charge un grand nombre de bases de données. J'ai mis en avant trois principales. Ce sont :
- TimescaleDB.
- InfluxDB.
- ClickHouse.
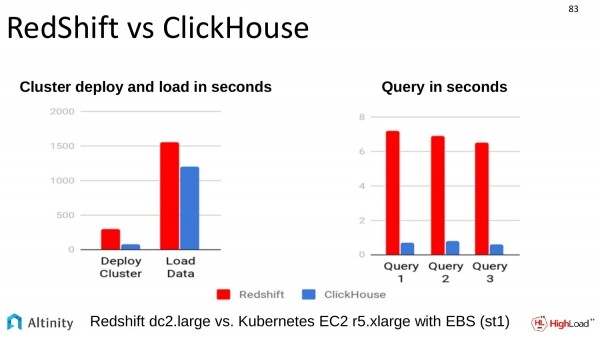
Une comparaison a également été menée avec une autre solution similaire. Une comparaison avec RedShift. La comparaison a été faite sur Amazon. ClickHouse devance également tous dans ce domaine.
Que peut-on conclure de ce que je viens de dire ?
- Il est possible d'utiliser une base de données dans Kubernetes. Peut-être que n'importe quelle base de données est utilisable, mais globalement, cela semble possible. Il est certainement possible d'utiliser ClickHouse dans Kubernetes grâce à notre opérateur.
- L'opérateur aide à automatiser les processus et rend la vie vraiment plus simple.
- La performance est correcte.
- Et il nous semble que cela peut et doit être utilisé.
Open source – rejoignez-nous !
Comme je l'ai déjà mentionné, l'opérateur est un produit entièrement open source, donc ce serait formidable si le plus grand nombre de personnes possible l'utilisait. Rejoignez-nous ! Nous vous attendons tous !
Merci à tous !
Questions
Merci pour la présentation ! Je m'appelle Anton. Je viens de l'entreprise SEMrush. Je suis curieux de savoir ce qu'il en est de la journalisation. On entend parler de surveillance, mais pas de journalisation, quand on parle de tout le cluster. Par exemple, nous avons installé un cluster sur du matériel. Et nous utilisons la journalisation centralisée, en rassemblant les données avec des outils standard dans un tout commun. Et puis nous en extrayons les données qui nous intéressent.
C'est une bonne question, c'est-à-dire que la journalisation figure sur la liste des choses à faire. Pour l'instant, notre opérateur ne l'automatise pas. Il est encore en développement, le projet est encore assez jeune. Nous comprenons la nécessité de la journalisation. C'est aussi un sujet très important. Et il est probablement tout aussi crucial que la surveillance. Mais la surveillance était en tête de liste pour la mise en œuvre. La journalisation viendra. Nous essayons évidemment d'automatiser tous les aspects de la vie du cluster. Donc, la réponse est qu'à l'heure actuelle, l'opérateur ne peut malheureusement pas le faire, mais c'est prévu, nous allons le faire. Si vous avez envie de participer, n'hésitez pas à faire un pull request.
Bonjour ! Merci pour la présentation ! J'ai une question standard liée aux Persistent Volumes. Lorsque nous créons une configuration avec cet opérateur, comment l'opérateur détermine-t-il sur quel nœud un disque ou un dossier est monté ? Devons-nous lui expliquer au préalable, s'il vous plaît, de placer notre ClickHouse uniquement sur ces nœuds où il y a un disque ?
D'après ce que je comprends, cette question est une prolongation du stockage local, en particulier de la partie sur hostPath. C'est comme expliquer à tout le système qu'il faut que le pod soit lancé précisément sur un nœud où nous avons un disque connectés physiquement qui est monté à un certain chemin. C'est un sujet que j'ai abordé très superficiellement, car la réponse est assez longue.
En résumé, cela ressemble à ceci. Bien sûr, nous devons effectuer le provisioning de ces volumes. À l'heure actuelle, il n'y a pas de provisioning dynamique dans le stockage local, donc les DevOps doivent découper les disques eux-mêmes, ces volumes. Ils doivent expliquer à Kubernetes le provisioning, que vous aurez des volumes persistants d'une certaine classe, qui se trouvent sur certains nœuds. Ensuite, il faudra expliquer à Kubernetes que les pods qui exigent une certaine classe de stockage local doivent être programmés uniquement sur certains nœuds selon les labels. Pour ces objectifs, l'opérateur a la possibilité d'assigner un certain label et un par instance hôte. Ainsi, il en résultera que les pods seront routés par Kubernetes pour ne s'exécuter que sur des nœuds répondant aux exigences, en termes de labels, pour parler simplement. Les administrateurs attribuent des labels et effectuent le provisioning des disques manuellement. Ainsi, cela se dimensionne.
Et justement, la troisième option locale aide à faciliter cela. Comme je l'ai souligné, c'est un travail minutieux de configuration, qui aide à obtenir des performances maximales en sortie.
J'ai une deuxième question à ce sujet. Kubernetes a été conçu de manière à ce que la perte d'un nœud ne soit pas un problème pour nous. Que faire si nous perdons le nœud où se trouve notre shard ?
Oui, Kubernetes était initialement positionné de sorte que notre relation avec nos pods soit celle du bétail, mais ici, chaque disque devient quelque chose comme un animal de compagnie. Il y a un problème, c'est que nous ne pouvons pas simplement les jeter. L'évolution de Kubernetes va dans le sens où il n'est pas possible de traiter cela de manière totalement philosophique, comme s'il s'agissait de ressources complètement interchangeables.
Maintenant, une question pratique. Que faire si vous avez perdu le nœud sur lequel se trouvait le disque ? Ici, le problème doit être résolu à un niveau supérieur. Dans le cas de ClickHouse, nous avons des répliques qui fonctionnent à un niveau supérieur, c'est-à-dire au niveau de ClickHouse.
Quelle est donc la disposition ? C'est à DevOps que revient la responsabilité de ne pas perdre les données. Ils doivent correctement configurer la réplication et veiller à ce que celle-ci s'exécute. Les données doivent être dupliquées dans la réplique au niveau de ClickHouse. Ce n'est pas la tâche d'un opérateur. Et ce n'est pas non plus la tâche de Kubernetes lui-même. C'est au niveau de ClickHouse.
Que faire si vous avez un nœud physique qui a échoué ? Il faudra en installer un second, et correctement y provisionner un disque, appliquer des labels. Après cela, il répondra aux exigences permettant à Kubernetes de lancer une instance de pod dessus. Kubernetes l'initialisera. Vous avez en effet un nombre de pods insuffisant pour atteindre l'objectif. Cela passera par le cycle que j'ai montré. Et au plus haut niveau, ClickHouse comprendra qu'une réplique est entrée, qu'elle est encore vide et qu'il faut commencer à y transférer des données. Ce processus est encore mal automatisé.
Merci pour votre présentation ! Lorsque des incidents se produisent, que l'opérateur tombe et redémarre, tout en recevant des événements, comment traitez-vous cela ?
Que se passe-t-il si l'opérateur est tombé et redémarré, n'est-ce pas ?
Oui. Et à ce moment-là, des événements sont apparus.
La tâche de gérer cette situation est en partie partagée entre l'opérateur et Kubernetes. Kubernetes a la capacité de rejouer l'événement qui s'est produit. Il le rejoue. La tâche de l'opérateur est de s'assurer que lorsque le replay du log d'événements est effectué, ces événements soient idempotents. Ainsi, la répétition de la même entrée d'événement ne détruira pas notre système. Et notre opérateur gère cette tâche.
Bonjour ! Merci pour votre présentation ! Dmitry Zavyalov, entreprise Smedova. Envisagez-vous d'ajouter la possibilité de configurer l'opérateur avec haproxy ? Un autre équilibreur de charge en plus de l'option standard serait intéressant, pour qu'il soit intelligent et comprenne que c'est véritablement ClickHouse.
Parlez-vous de Ingress ?
Oui, remplacer Ingress par haproxy. Dans haproxy, vous pouvez spécifier la topologie du cluster, où se trouvent ses répliques.
Pour l'instant, nous n'y avons pas réfléchi. Si c'est nécessaire pour vous et que vous pouvez expliquer pourquoi, nous pourrions le mettre en œuvre, surtout si vous souhaitez participer. Nous examinerons avec plaisir cette option. En résumé, non, nous n'avons pas cette fonctionnalité actuellement. Merci pour la suggestion, nous y jetterons un œil. Et si vous pouvez aussi expliquer le cas d'utilisation et pourquoi c'est nécessaire en pratique, par exemple en créant des issues sur GitHub, ce serait parfait.
C'est déjà fait.
Bien. Nous sommes ouverts à toutes les propositions. Et haproxy est sur la liste des tâches à faire. La liste des tâches s'allonge, elle ne diminue pas pour l'instant. Mais c'est une bonne chose, cela signifie que le produit est demandé.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish