

Bonjour, Habr ! Je m'appelle Maxim Vassiliev, je travaille comme analyste et chef de projet chez FINCH. Aujourd'hui, je voudrais expliquer comment, grâce à ElasticSearch, nous avons pu traiter 15 millions de requêtes en 6 minutes et optimiser les charges quotidiennes sur le site de l'un de nos clients. Malheureusement, nous devrons nous passer de noms, car nous avons un NDA, mais nous espérons que le contenu de l'article ne souffrira pas de cela. Allons-y.
Comment le projet est structuré
Dans notre backend, nous créons des services qui assurent le bon fonctionnement des sites et de l'application mobile de notre client. La structure générale peut être vue sur le schéma :
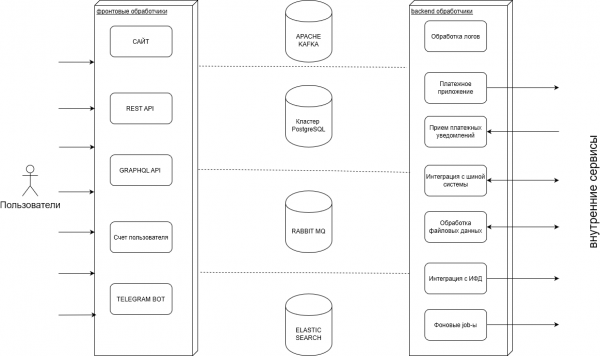
Dans le cadre de notre travail, nous traitons un grand nombre de transactions : achats, paiements, opérations sur les soldes des utilisateurs, pour lesquelles nous stockons de nombreux logs, et nous importons également et exportons ces données vers des systèmes externes.
Des processus inverses se déroulent également, lorsque nous recevons des données du client et les transmettons aux utilisateurs. En outre, il existe des processus relatifs aux paiements et aux programmes de bonus.
Une brève histoire
Au départ, nous utilisions PostgreSQL comme unique stockage de données. Ses avantages standards pour les SGBD : la présence de transactions, un langage de requête développé, un large éventail d'outils pour l'intégration ; associés à une bonne performance, ils satisfaisaient nos besoins pendant assez longtemps.
Nous stockions dans Postgres absolument toutes les données : des transactions aux actualités. Mais le nombre d'utilisateurs augmentait, et avec lui, le nombre de requêtes.
Pour donner une idée, le nombre annuel de sessions en 2017 sur le site desktop était de 131 millions. En 2018, il est tombé à 125 millions. En 2019, il a de nouveau atteint 130 millions. Ajoutez-y encore 100 à 200 millions de la version mobile du site et de l'application mobile, et vous obtiendrez un nombre colossal de requêtes.
Avec la croissance du projet, Postgres a cessé de gérer la charge, nous n'arrivions plus à suivre — un grand nombre de requêtes variées sont apparues, pour lesquelles nous n'avons pas pu créer un nombre suffisant d'index.
Nous comprenions qu'il était nécessaire d'avoir d'autres systèmes de stockage qui répondraient à nos besoins et allégeraient la charge sur PostgreSQL. Nous avons envisagé Elasticsearch et MongoDB comme options possibles. La dernière a échoué sur les points suivants :
- Une vitesse d'indexation lente avec l'augmentation du volume de données dans les index. Avec Elastic, la vitesse n'est pas affectée par le volume de données.
- Pas de recherche en texte intégral
C'est ainsi que nous avons choisi Elastic et nous nous sommes préparés à la migration.
Migration vers Elastic
1. Nous avons commencé la migration avec le service de recherche de points de vente. Notre client a environ 70 000 points de vente au total, et il nécessite plusieurs types de recherches sur le site et dans l'application :
- Recherche textuelle par nom de localité
- Recherche géographique dans un rayon donné à partir d'un point. Par exemple, si l'utilisateur veut voir quels points de vente sont les plus proches de chez lui.
- Recherche par un carré défini – l'utilisateur trace un carré sur la carte et tous les points dans ce rayon lui sont montrés.
- Recherche par filtres supplémentaires. Les points de vente diffèrent les uns des autres par leur assortiment.
En ce qui concerne l'organisation, dans Postgres, nous avons une source de données tant pour la carte que pour les nouvelles, et dans Elastic, des instantanés des données originales sont créés. Le fait est qu'à l'origine, Postgres ne parvenait pas à effectuer des recherches selon tous les critères. Non seulement il y avait de nombreux index, mais ils pouvaient également se chevaucher, ce qui perdait le planificateur de Postgres et l'empêchait de comprendre quel index utiliser.
2. Ensuite, c'était au tour de la section des nouvelles. Chaque jour, de nouvelles publications apparaissent sur le site, et pour que l'utilisateur ne se perde pas dans le flux d'informations, les données doivent être triées avant d'être affichées. C'est également le but de la recherche: sur le site, il est possible de rechercher par correspondance textuelle, tout en branchant des filtres supplémentaires, puisqu'ils sont aussi réalisés via Elastic.
3. Ensuite, nous avons transféré le traitement des transactions. Les utilisateurs peuvent acheter un certain produit sur le site et participer à des tirages au sort. Après ces achats, nous traitons un grand volume de données, surtout durant les week-ends et les jours fériés. À titre de comparaison, en semaine, le nombre d'achats est d'environ 1,5 à 2 millions, alors qu'en période de fêtes, ce chiffre peut atteindre 53 millions.
De plus, les données doivent être traitées dans les plus brefs délais — les utilisateurs n'aiment pas attendre plusieurs jours pour connaître les résultats. Avec Postgres, on ne peut pas atteindre de tels délais — nous subissions souvent des blocages, et pendant que nous traitions toutes les requêtes, les utilisateurs ne pouvaient pas vérifier s'ils avaient gagné des prix ou non. Ce n'est pas très agréable pour les affaires, c'est pourquoi nous avons transféré le traitement dans Elasticsearch.
Fréquence
Les mises à jour sont actuellement configurées sur une base d'événements, selon les conditions suivantes :
- Points de vente. Dès que nous recevons des données d'une source externe, nous lançons immédiatement la mise à jour.
- Actualités. Dès qu'une actualité est modifiée sur le site, elle est automatiquement envoyée à Elastic.
Il convient encore une fois de mentionner les avantages d'Elastic. Dans Postgres, lors de l'envoi d'une requête, il faut attendre qu'elle traite toutes les entrées. Avec Elastic, il est possible d'envoyer 10 000 enregistrements et de commencer à travailler immédiatement, sans attendre que les données se répartissent sur tous les Shards. Bien sûr, un Shard ou une Réplica peuvent ne pas voir les données immédiatement, mais bientôt tout sera accessible.
Méthodes d'intégration
Il existe 2 méthodes d'intégration avec Elastic :
- Via le client natif par TCP. Le pilote natif est progressivement abandonné : il n'est plus soutenu et a une syntaxe très peu pratique. C'est pourquoi nous l'utilisons pratiquement plus et essayons de nous en débarrasser totalement.
- Via l'interface HTTP, où l'on peut utiliser à la fois des requêtes JSON et la syntaxe Lucene. Ce dernier est le moteur texte utilisé par Elastic. Dans cette option, nous avons la possibilité de Batch via des requêtes JSON sur HTTP. C'est cette option que nous essayons d'utiliser.
Grâce à l'interface HTTP, nous pouvons utiliser des bibliothèques qui fournissent une implémentation asynchrone du client HTTP. Nous pouvons tirer parti de Batch et de l'API asynchrone, ce qui, en fin de compte, donne de hautes performances, qui ont été très utiles lors des grandes opérations (à ce sujet ci-dessous)
Quelques chiffres pour la comparaison :
- Sauvegarde des utilisateurs ayant reçu des prix dans Postgres en 20 threads sans regroupements : 460 713 enregistrements en 42 secondes
- Elastic + client réactif sur 10 threads + batch de 1000 éléments : 596 749 enregistrements en 11 secondes
- Elastic + client réactif sur 10 threads + batch de 1000 éléments : 23 801 684 enregistrements en 4 minutes
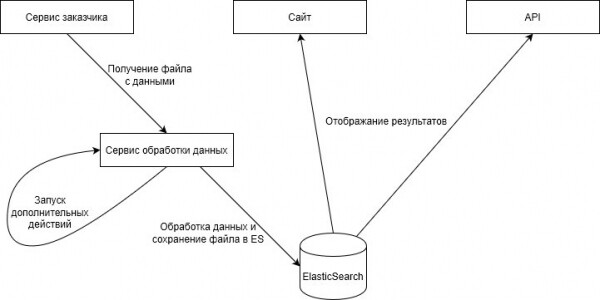
Nous avons maintenant écrit un gestionnaire de requêtes HTTP qui construit JSON, en tant que Batch/non Batch, et envoie via n'importe quel client HTTP, indépendamment de la bibliothèque. Il est également possible de choisir d'envoyer des requêtes de manière synchrone ou asynchrone.
Dans certaines intégrations, nous utilisons encore le client de transport officiel, mais c'est juste une question de refactorisation prochaine. Pour le traitement, un client propre, construit sur la base de Spring WebClient, est utilisé.
Grande opération
Une grande promotion a lieu une fois par an pour les utilisateurs - c'est ce fameux Highload, car à ce moment là, nous traitons des dizaines de millions d'utilisateurs simultanément.
Les pics de charge se produisent généralement pendant les jours fériés, mais cette promotion est d'un tout autre niveau. L'année précédente, le jour de la promotion, nous avons vendu 27 580 890 unités. Les données ont été traitées pendant plus d'une demi-heure, ce qui a causé des désagréments aux utilisateurs. Les utilisateurs ont reçu des prix pour leur participation, mais il est devenu évident que le processus devait être accéléré.
Début 2019, nous avons décidé qu'ElasticSearch était nécessaire. Pendant toute une année, nous avons organisé le traitement des données reçues dans Elastic et leur fourniture via l'API de l'application mobile et du site. En conséquence, l'année suivante, pendant la promotion, nous avons traité 15 131 783 enregistrements en 6 minutes.
Étant donné qu'il y a beaucoup de personnes désireuses d'acheter des produits et de participer à des tirages pendant les promotions, c'est une mesure temporaire. Actuellement, nous envoyons les informations actuelles vers Elastic, mais à l'avenir, nous prévoyons de transférer des informations archivées des mois précédents vers Postgres, comme un stockage permanent. Cela nous permet d'éviter de surcharger l'index Elastic, qui a aussi ses limites.
Conclusion / Résumé
À l'heure actuelle, nous avons transféré vers Elastic tous les services que nous voulions et nous avons mis cela en pause pour le moment. Maintenant, nous construisons un index dans Elastic au-dessus du stockage persistant principal dans Postgres, qui prend en charge la charge utilisateur.
À l'avenir, nous prévoyons de transférer des services si nous réalisons que les demandes de données deviennent trop variées et que la recherche s'effectue sur un nombre illimité de colonnes. Cela devient déjà une tâche pour Postgres.
Si nous avons besoin de recherche en texte intégral dans les fonctionnalités ou si de nombreux critères de recherche variés apparaissent, nous savons déjà que cela devra être transféré vers Elastic.
⌘⌘⌘
Merci d'avoir lu. Si votre entreprise utilise également ElasticSearch et a ses propres cas d'implémentation, n'hésitez pas à en parler. Ce sera intéressant de savoir comment d'autres font 🙂
Source : habr.com
