

La base de données analytique ClickHouse traite de nombreuses chaînes différentes, consommant des ressources. Pour accélérer le fonctionnement du système, de nouvelles optimisations sont constamment ajoutées. Le développeur de ClickHouse, Nikolai Kochetov, parle du type de données string, y compris d'un nouveau type, LowCardinality, et explique comment accélérer le traitement des chaînes.
— Commençons par comprendre comment stocker les chaînes.
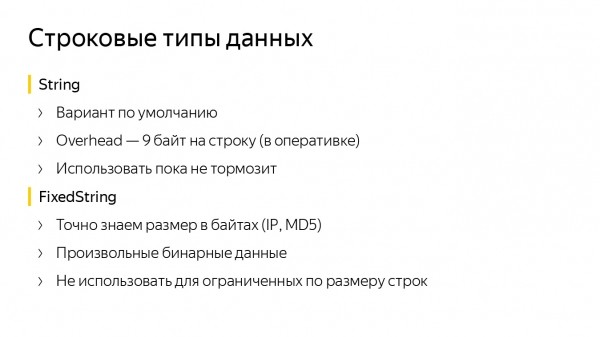
Nous avons des types de données string. String convient comme valeur par défaut, il est presque toujours préférable de l'utiliser. Il a un faible Overhead — 9 octets par chaîne. Si nous voulons que la taille des chaînes soit fixe et connue à l'avance, il vaut mieux utiliser FixedString. Dans ce type, nous pouvons définir le nombre d'octets souhaité, ce qui est pratique pour les données comme les adresses IP ou les fonctions de hachage.
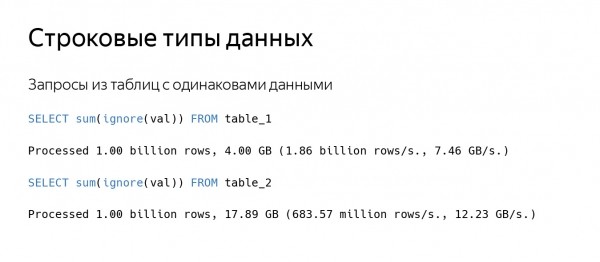
Bien sûr, parfois quelque chose ralentit. Supposons que vous fassiez une requête à une table. ClickHouse lit une quantité assez importante de données, disons à une vitesse de 100 Go/s, tout en traitant peu de chaînes. Nous avons deux tables qui stockent presque les mêmes données. ClickHouse lit les données de la deuxième table à une vitesse plus élevée, mais le nombre de chaînes lues par seconde est trois fois inférieur.
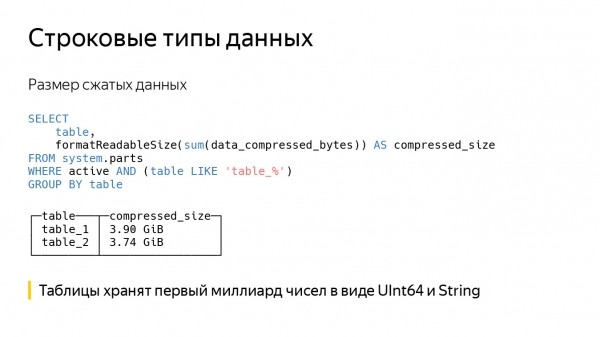
Si nous regardons la taille des données compressées, elle sera presque équivalente. En réalité, les mêmes données sont enregistrées dans les tables — le premier milliard de nombres — seulement dans la première colonne, elles sont enregistrées sous forme de UInt64, tandis que dans la seconde, elles sont sous forme de String. À cause de cela, la deuxième requête met plus de temps à lire les données depuis le disque et à les décompresser.
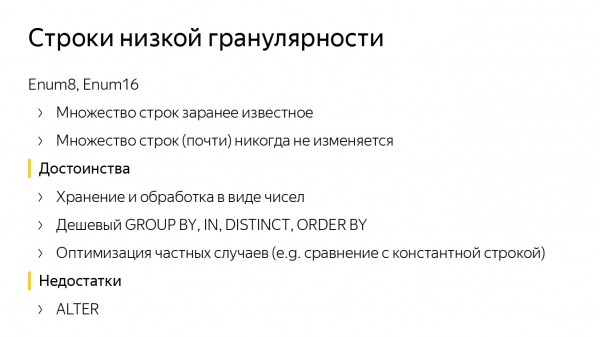
Voici un autre exemple. Supposons qu'il y ait un ensemble de chaînes connu à l'avance, limité par une constante de 1000 ou 10 000 et qui ne change presque jamais. Dans ce cas, le type de données Enum est approprié, ClickHouse en propose deux — Enum8 et Enum16. Grâce au stockage sous Enum, nous traitons rapidement les requêtes.
ClickHouse dispose d'accélérations pour GROUP BY, IN, DISTINCT et d'optimisations pour certaines fonctions, par exemple pour la comparaison avec une chaîne constante. Bien sûr, les nombres dans la chaîne ne sont pas convertis, au contraire, la chaîne constante est convertie en valeur Enum. Après cela, tout se compare rapidement.
Mais il y a aussi des inconvénients. Même si nous connaissons précisément l'ensemble des chaînes, il doit parfois être complété. Une nouvelle chaîne arrive — nous devons effectuer un ALTER.
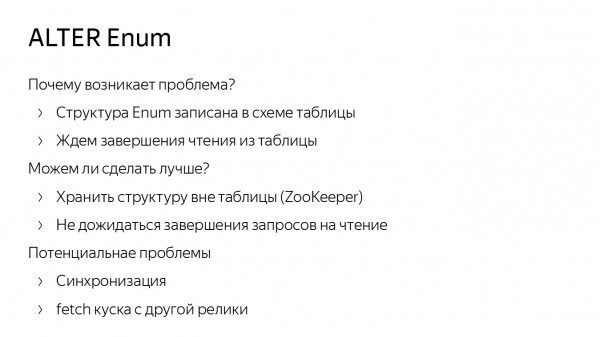
L'ALTER pour Enum dans ClickHouse est réalisé de manière optimale. Nous ne réécrivons pas les données sur le disque, mais l'ALTER peut ralentir en raison du stockage des structures Enum dans le schéma même de la table. Par conséquent, nous devons attendre les requêtes de lecture de la table, par exemple.
La question se pose : peut-on faire mieux ? Probablement, oui. On peut conserver la structure Enum non pas dans le schéma de la table, mais dans ZooKeeper. Cependant, des problèmes de synchronisation peuvent survenir. Par exemple, une réplique a reçu des données, l'autre non, et si elle possède une vieille Enum, alors quelque chose pourrait échouer. (Dans ClickHouse, nous avons presque terminé les requêtes ALTER non bloquantes. Lorsque nous les terminerons entièrement, il ne sera plus nécessaire d'attendre les requêtes de lecture.)
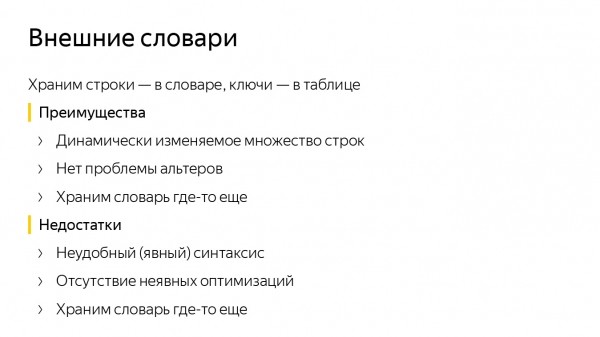
Pour éviter de s'embêter avec ALTER Enum, on peut utiliser des dictionnaires externes dans ClickHouse. Je rappelle que c'est une structure de données clé-valeur à l'intérieur de ClickHouse, qui permet d'obtenir des données à partir de sources externes, comme des tables MySQL.
Dans le dictionnaire ClickHouse, nous stockons de nombreuses chaînes différentes, et dans la table, leurs identifiants sous forme de nombres. Si nous devons obtenir une chaîne, nous appelons la fonction dictGet et travaillons avec elle. Après cela, nous n'avons plus besoin de faire ALTER. Pour ajouter quelque chose à l'Enum, nous l'insérons dans la même table MySQL.
Mais cela pose d'autres problèmes. Premièrement, une syntaxe peu pratique. Si nous voulons obtenir une chaîne, nous devons appeler dictGet. Deuxièmement, l'absence de certaines optimisations. Comparer avec une chaîne constante pour les dictionnaires n'est pas aussi rapide.
Il peut également y avoir des problèmes de mise à jour. Supposons que nous ayons demandé une chaîne dans le dictionnaire cache, mais qu'elle n'y soit pas. Dans ce cas, nous devons attendre que les données soient chargées à partir de la source externe.
Le principal inconvénient des deux méthodes est que nous stockons toutes les clés au même endroit et les synchronisons. Alors, pourquoi ne pas stocker les dictionnaires localement ? Pas de synchronisation, pas de problème. On peut stocker le dictionnaire localement dans un morceau sur le disque. C'est-à-dire que nous avons fait un Insert, enregistré le dictionnaire. Si nous travaillons avec des données en mémoire, nous pouvons enregistrer le dictionnaire soit dans un bloc de données, soit dans un morceau de colonne, soit dans un cache, pour accélérer les calculs.
Codage par dictionnaire des chaînes
Ainsi, nous sommes arrivés à la création d'un nouveau type de données dans ClickHouse — LowCardinality. C'est un format de stockage de données : comment elles sont écrites sur le disque et comment elles sont lues, comment elles sont représentées en mémoire et leur schéma de traitement.
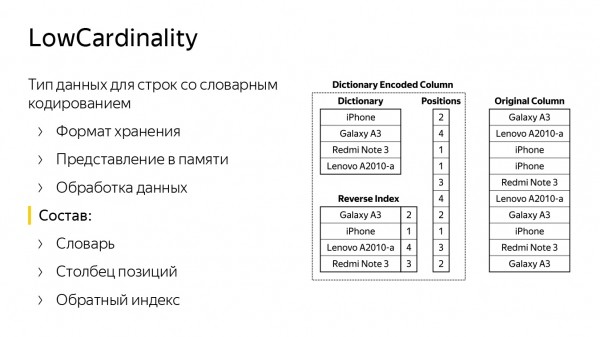
Le diaporama comporte deux colonnes. À droite, les chaînes sont standardisées en type String. On peut voir qu'il s'agit de modèles de téléphones mobiles. À gauche, il y a une colonne identique, mais de type LowCardinality. Elle est composée d'un dictionnaire avec de nombreuses chaînes différentes (les chaînes de la colonne de droite) et d'une liste de positions (numéros de lignes).
Avec ces deux structures, il est possible de restaurer la colonne d'origine. Il existe également un index inversé — une table de hachage qui aide à trouver la position dans le dictionnaire par la chaîne. Cela est nécessaire pour accélérer certaines requêtes. Par exemple, si nous voulons comparer, rechercher une chaîne dans notre colonne ou les fusionner.
LowCardinality est un type de données paramétrique. Il peut être soit un nombre, soit quelque chose stocké sous forme de nombre, soit une chaîne, soit Nullable de ceux-ci.
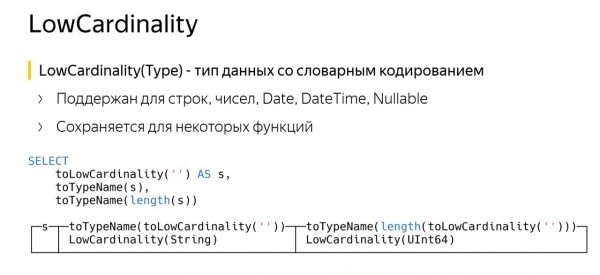
La particularité de LowCardinality est qu'il peut être conservé pour certaines fonctions. Dans le diaporama, un exemple de requête est montré. Dans la première ligne, j'ai créé une colonne de type LowCardinality à partir de String, que j'ai nommée S. Ensuite, j'ai demandé son nom — ClickHouse a indiqué que c'est LowCardinality de String. C'est correct.
La troisième ligne est presque la même, sauf que nous avons appelé la fonction length. Dans ClickHouse, la fonction length renvoie le type de données UInt64. Mais nous avons obtenu LowCardinality de UInt64. Quel est le sens ?
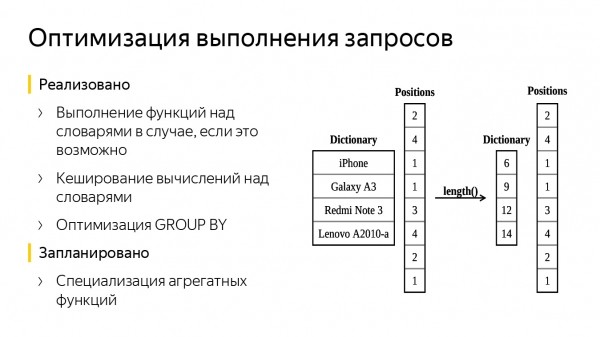
Dans le dictionnaire étaient stockés les noms de téléphones mobiles, nous avons appliqué la fonction length. Nous avons maintenant un dictionnaire similaire, composé uniquement de nombres — ce sont les longueurs des chaînes. La colonne avec les positions n'a pas changé. Au final, nous avons traité moins de données, économisant ainsi du temps de requête.
Il peut y avoir d'autres optimisations, telles que l'ajout d'un cache simple. Lors du calcul de la valeur d'une fonction, il est possible de s'en souvenir et de composer une identique sans avoir à recalculer.
Une optimisation GROUP BY peut également être effectuée, car notre colonne avec le dictionnaire est déjà partiellement agrégée — cela permet de calculer plus rapidement les valeurs des fonctions de hachage et de trouver approximativement le bucket où insérer la prochaine ligne. De plus, certaines fonctions d'agrégation peuvent être spécialisées, par exemple uniq, car elle peut recevoir uniquement le dictionnaire, laissant les positions intactes — tout cela fonctionnera plus rapidement. Les deux premières optimisations ont déjà été ajoutées dans ClickHouse.
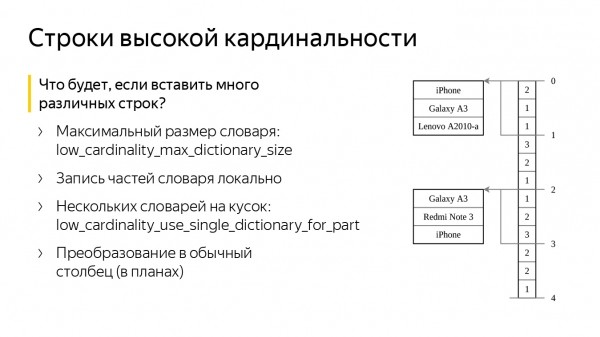
Que se passerait-il si nous créions une colonne avec notre type de données et y insérions de nombreuses chaînes de caractères différentes et non conformes ? La mémoire ne va-t-elle pas déborder ? Non, pour cela, ClickHouse dispose de deux configurations spéciales. La première est low_cardinality_max_dictionary_size. C'est la taille maximale du dictionnaire qui peut être écrit sur le disque. L'insertion se déroule comme suit : lorsque nous insérons des données, un flux de chaînes de caractères nous parvient, à partir duquel nous formons un grand dictionnaire commun. Si le dictionnaire devient plus grand que la valeur de la configuration, nous écrivons le dictionnaire actuel sur le disque, et les autres chaînes sont « mises de côté », à côté des index. Au final, nous ne recalculons jamais un grand dictionnaire et ne rencontrons pas de problèmes de mémoire.
La deuxième configuration s'appelle low_cardinality_use_single_dictionary_for_part. Imaginez que dans le schéma précédent, lorsque nous insérions des données, notre dictionnaire a débordé et que nous l'avons écrit sur le disque. La question se pose : pourquoi ne pas maintenant former un autre dictionnaire identique ?
Lorsqu'il débordera, nous l'écrirons à nouveau sur le disque et commencerons à former un troisième. Cette configuration désactive par défaut une telle possibilité.
En fait, avoir plusieurs dictionnaires peut être utile si nous voulons insérer un certain nombre de chaînes de caractères, mais que nous avons accidentellement inséré des « déchets ». Disons que nous avons d'abord inséré des chaînes de mauvaise qualité, puis de bonnes. Dans ce cas, le dictionnaire se divisera en plusieurs petits dictionnaires. Certains d'entre eux contiendront des « déchets », mais les derniers contiendront de bonnes chaînes. Et si nous lisons, disons, seulement le dernier fragment, cela fonctionnera également rapidement.
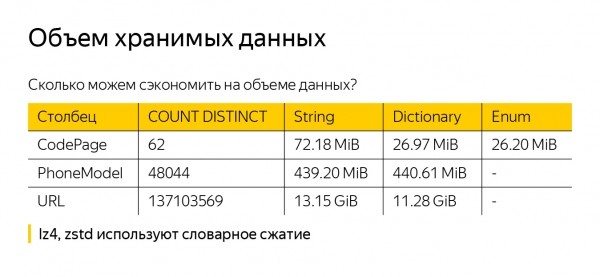
Avant de parler des avantages de LowCardinality, je dois dire tout de suite que nous ne réussirons probablement pas à réduire les données sur le disque (bien que cela puisse se produire), car ClickHouse compresse les données. Il existe une option par défaut : LZ4. Il est également possible de compresser par ZSTD. Mais les deux algorithmes implémentent déjà la compression par dictionnaire, donc notre dictionnaire externe ClickHouse n'aidera pas vraiment.
Pour ne pas être accusé de dire des bêtises, j'ai pris certaines données de la métrique — String, LowCardinality(String) et Enum — et je les ai enregistrées dans différents types de données. Cela a donné trois colonnes, contenant un milliard de lignes. Dans la première colonne, CodePage, il y a seulement 62 valeurs. On voit que dans LowCardinality(String), nous avons mieux compressé. String est un peu moins performant, mais c'est probablement dû au fait que les chaînes sont courtes, nous stockons leurs longueurs, et elles prennent beaucoup de place, se compressent mal.
Concernant PhoneModel, il y en a 48 000 — déjà plus, et les différences entre String et LowCardinality(String) sont presque inexistantes. Pour les URL, nous avons également économisé seulement 2 Go — je pense qu'il ne faut pas trop compter là-dessus.
Évaluation de la vitesse de traitement
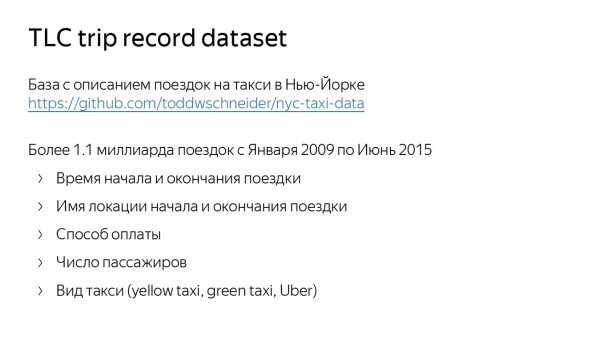
Évaluons maintenant la vitesse de traitement. Pour cela, j'ai utilisé un ensemble de données sur les trajets de taxi à New York. Il se trouve sur GitHub. Il contient un peu plus d'un milliard de trajets. Il reflète la localisation, l'heure de départ et de fin du trajet, le mode de paiement, le nombre de passagers et même le type de taxi — vert, jaune et Uber.
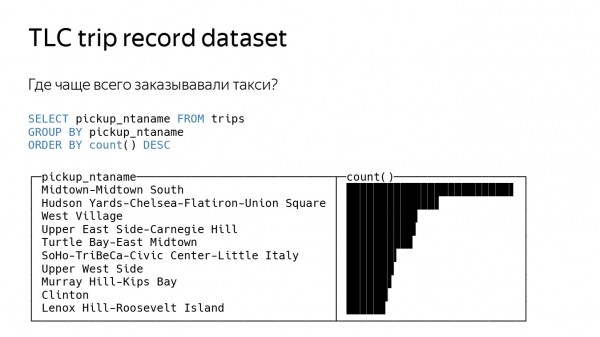
J'ai commencé par une requête assez simple — j'ai demandé où les taxis sont commandés le plus souvent. Pour cela, il faut prendre la localisation d'où le taxi a été commandé, faire un GROUP BY sur celle-ci et compter avec la fonction count. Voici ce que ClickHouse retourne.
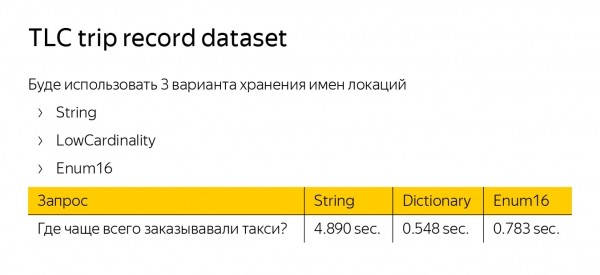
Pour mesurer la vitesse de traitement de la requête, j'ai créé trois tables avec les mêmes données, mais j'ai utilisé pour notre localisation de départ trois types de données différents — String, LowCardinality et Enum. LowCardinality et Enum se sont révélés cinq fois plus rapides que String. Enum est plus rapide car il fonctionne avec des chiffres. LowCardinality — car une optimisation GROUP BY a été mise en œuvre.
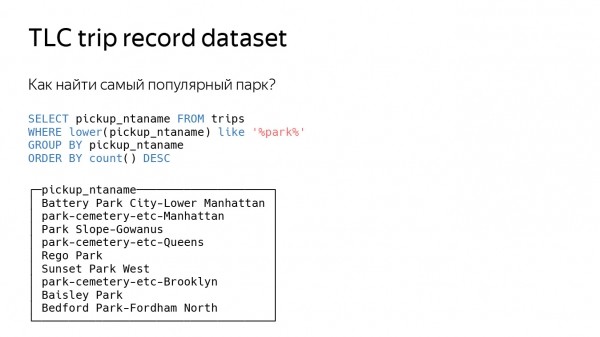
Rendons la requête un peu plus complexe — demandons où se trouve le parc le plus populaire à New York. Encore une fois, nous allons le mesurer en fonction des endroits où les taxis sont le plus souvent commandés, mais en filtrant uniquement les localisations contenant le mot « parc ». Nous ajouterons également la fonction like.
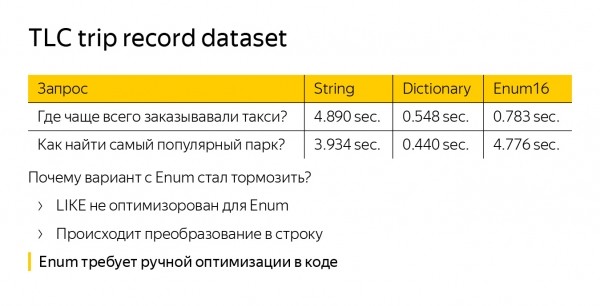
Regardons le temps — nous voyons qu'Enum a soudainement commencé à ralentir. Il fonctionne même plus lentement que le type de données standard String. Cela se produit parce que la fonction like n'est pas du tout optimisée pour Enum. Nous devons convertir nos chaînes d'Enum en chaînes ordinaires — cela alourdit notre travail. LowCardinality(String) n'est pas non plus optimisé par défaut, mais dans ce cas, like fonctionne sur le dictionnaire, donc la requête est accélérée par rapport à String.
Lors de l'utilisation d'Enum, il existe un problème plus global. Si nous voulons l'optimiser, nous devons le faire à chaque endroit dans le code. Supposons que nous ayons écrit une nouvelle fonction - il est impératif de penser à une optimisation pour Enum. En revanche, LowCardinality est optimisé par défaut.
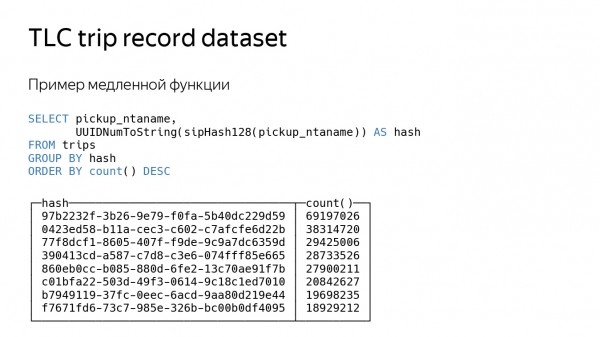
Examinons la dernière requête, plus artificielle. Nous allons simplement calculer la fonction de hachage de notre emplacement. La fonction de hachage est une requête assez lente, elle prend du temps à calculer, donc tout sera retardé d'environ trois fois.
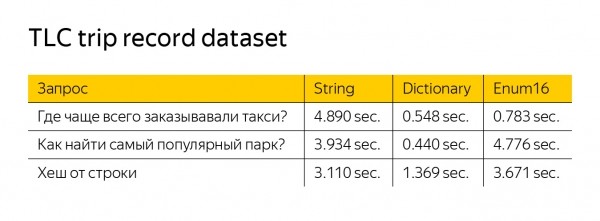
LowCardinality fonctionne encore plus rapidement, bien qu'il n'y ait pas de filtrage. Cela est dû au fait que nos fonctions ne travaillent que sur le dictionnaire. La fonction de calcul de hachage a un argument - elle peut traiter moins de données et peut également renvoyer LowCardinality.
Notre objectif global est d'atteindre une vitesse de fonctionnement équivalente à celle de String dans tous les cas, tout en conservant les améliorations. Et, peut-être, un jour, nous remplacerons String par LowCardinality, vous mettrez à jour ClickHouse, et tout fonctionnera un peu plus vite.
Source : habr.com
