

Comment multiplier par 10 le nombre de requêtes à une base de données sans changer pour un serveur plus performant tout en maintenant le bon fonctionnement du système ? Je vais vous raconter comment nous avons lutté contre la baisse de performance de notre base de données, comment nous avons optimisé les requêtes SQL pour servir le plus grand nombre d'utilisateurs possible sans augmenter les coûts des ressources de calcul.
Je développe un service de gestion des processus d'affaires pour les entreprises de construction. Environ 3 000 entreprises travaillent avec nous. Plus de 10 000 personnes utilisent notre système chaque jour pendant 4 à 10 heures. Il résout divers problèmes de planification, d'alerte, de notification, de validation… Nous utilisons PostgreSQL 9.6. Nous avons environ 300 tables dans notre base de données et jusqu'à 200 millions de requêtes y parviennent chaque jour (10 000 différentes). En moyenne, nous traitons 3 000 à 4 000 requêtes par seconde, et dans les moments les plus actifs, plus de 10 000 requêtes par seconde. La plupart des requêtes sont des OLAP. Les ajouts, modifications et suppressions sont beaucoup moins fréquents, ce qui signifie que la charge OLTP est relativement faible. J'ai présenté tous ces chiffres pour que vous puissiez évaluer l'ampleur de notre projet et comprendre à quel point notre expérience peut vous être utile.
Première image. Lyrique
Lorsque nous avons commencé le développement, nous ne pensions pas vraiment à la charge qui pèserait sur la base de données et ce que nous ferions si le serveur cessait de fonctionner. Lors de la conception de la base de données, nous avons suivi des recommandations générales et avons essayé de ne pas nous tirer une balle dans le pied, mais au-delà des conseils généraux tels que « ne pas utiliser le modèle nous n'avons pas approfondi. Nous avons conçu en nous basant sur les principes de normalisation, évitant la redondance des données, sans nous soucier d'accélérer certaines requêtes. Dès que les premiers utilisateurs sont arrivés, nous avons été confrontés à des problèmes de performance. Comme d'habitude, nous étions totalement mal préparés. Les premiers problèmes étaient simples. En règle générale, il suffisait d'ajouter un nouvel index. Mais il est arrivé un moment où ces solutions simples ont cessé de fonctionner. Réalisant que nous manquions d'expérience et que nous avions de plus en plus de mal à comprendre la cause des problèmes, nous avons engagé des spécialistes qui nous ont aidés à configurer correctement le serveur, à connecter le monitoring et à nous montrer où regarder pour obtenir .
Deuxième image. Statistique
Nous avons environ 10 000 requêtes différentes qui s'exécutent sur notre base de données chaque jour. Parmi ces 10 000, il y a des monstres qui s'exécutent 2 à 3 millions de fois avec un temps d'exécution moyen de 0,1 à 0,3 ms, ainsi que des requêtes avec un temps d'exécution moyen de 30 secondes, invoquées 100 fois par jour.
Il n'était pas possible d'optimiser les 10 000 requêtes, alors nous avons décidé de déterminer où concentrer nos efforts pour améliorer correctement les performances de la base de données. Après plusieurs itérations, nous avons commencé à classer les requêtes par types.
REQUÊTES TOP
Ce sont les requêtes les plus lourdes qui prennent le plus de temps (temps total). Ce sont des requêtes qui sont soit très souvent appelées, soit des requêtes qui prennent beaucoup de temps à s'exécuter (les requêtes longues et fréquentes avaient déjà été optimisées lors des premières itérations pour gagner en vitesse). Au final, le serveur passe le plus de temps à les exécuter. Il est également important de séparer les requêtes top par le temps d'exécution total et par le temps IO. Les méthodes d'optimisation de ces requêtes sont légèrement différentes.
La pratique courante de toutes les entreprises est de travailler sur les REQUÊTES TOP. Elles sont peu nombreuses, et l'optimisation d'une seule requête peut libérer 5 à 10 % des ressources. Cependant, à mesure que le projet « grandit », l'optimisation des REQUÊTES TOP devient une tâche de plus en plus complexe. Tous les moyens simples ont déjà été éprouvés, et la requête la plus « lourde » n'accapare « que » 3 à 5 % des ressources. Si les REQUÊTES TOP occupent moins de 30 à 40 % du temps total, vous avez probablement déjà travaillé pour qu'elles fonctionnent rapidement et il est temps de passer à l'optimisation des requêtes du groupe suivant.
Il reste à répondre à la question de combien de requêtes supérieures inclure dans ce groupe. Je prends généralement pas moins de 10, mais pas plus de 20. J'essaie de m'assurer que le temps d'exécution de la première et de la dernière requête dans le groupe TOP ne diffère pas de plus de 10 fois. C'est-à-dire que si le temps d'exécution des requêtes chute brusquement de la première à la dixième place, je prends le TOP-10, si la chute est plus progressive, j'augmente la taille du groupe à 15 ou 20.
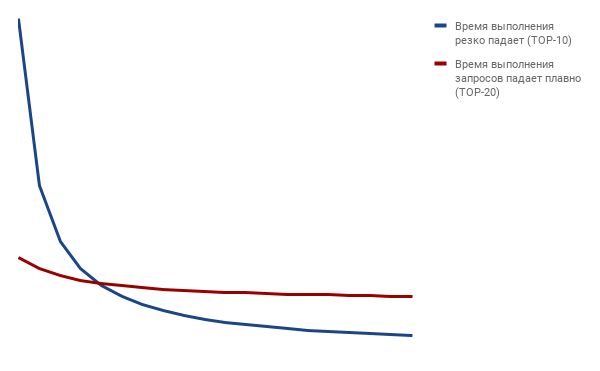
Requêtes intermédiaires (medium)
Ce sont toutes les requêtes qui viennent juste après les REQUÊTES TOP, à l'exception des 5 à 10 % dernières. L'optimisation de ces requêtes recèle souvent la possibilité d'augmenter considérablement les performances du serveur. Ces requêtes peuvent représenter jusqu'à 80 %. Mais même si leur part dépasse 50 %, il est temps de les examiner de plus près.
Queue (tail)
Comme mentionné, ces requêtes arrivent à la fin et prennent 5 à 10 % de notre temps. On peut les oublier, sauf si vous utilisez des outils d'analyse de requêtes automatiques, alors leur optimisation peut aussi coûter peu.
Comment évaluer chaque groupe ?
J'utilise une requête SQL qui permet de faire cette évaluation pour PostgreSQL (je suis sûr qu'il est possible d'écrire une requête similaire pour de nombreux autres SGBD).
Requête SQL pour évaluer la taille des groupes TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) AS sum_tail
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800 THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
Le résultat de la requête comporte trois colonnes, chacune contenant le pourcentage de temps consacré au traitement des requêtes de ce groupe. À l'intérieur de la requête, il y a deux nombres (dans mon cas, 20 et 800) qui séparent les requêtes d'un groupe à l'autre.
Voici comment se rapportaient les parts des requêtes au début de l'optimisation et maintenant.
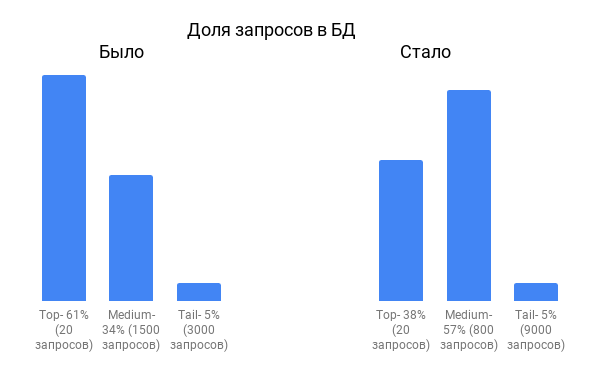
Le diagramme montre que la part des requêtes TOP a fortement diminué, tandis que celle des "moyennes" a augmenté.
Au départ, les erreurs évidentes figuraient dans les requêtes TOP. Avec le temps, les maladies de jeunesse ont disparu, la part des requêtes TOP a diminué et il a fallu fournir de plus en plus d'efforts pour accélérer les requêtes lourdes.
Pour obtenir le texte des requêtes, nous utilisons cette requête.
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Voici une liste des techniques les plus souvent utilisées qui nous ont aidés à accélérer les requêtes TOP :
- Redesign du système, par exemple, la refonte de la logique des notifications sur un message broker au lieu de requêtes périodiques à la base de données.
- Ajout ou modification d'index.
- Réécriture des requêtes ORM en SQL pur.
- Réécriture de la logique de chargement paresseux des données.
- Mise en cache par dénormalisation des données. Par exemple, nous avons une relation entre les tables Livraison -> Facture -> Requête -> Demande. Cela signifie que chaque livraison est liée à une demande via d'autres tables. Pour ne pas lier toutes les tables dans chaque requête, nous avons dupliqué le lien vers la demande dans la table Livraison.
- Mise en cache des tables statiques avec des référentiels et des tables rarement modifiées en mémoire du programme.
Parfois, les modifications entraînaient un redesign important, mais offraient une réduction de 5 à 10% de la charge système et étaient justifiées. Au fil du temps, les résultats devenaient de moins en moins significatifs, tandis qu'un redesign plus sérieux était de plus en plus nécessaire.
Nous avons alors prêté attention à un deuxième groupe de requêtes, le groupe intermédiaire. Ce groupe comportait beaucoup plus de requêtes et semblait nécessiter beaucoup de temps pour l'analyse. Cependant, la plupart des requêtes se sont avérées très simples à optimiser, et de nombreux problèmes se répétaient des dizaines de fois sous différentes variations. Voici quelques exemples d'optimisations typiques que nous avons appliquées à des dizaines de requêtes similaires, chacune de ces groupes optimisés allégeant la base de données de 3 à 5%.
- Au lieu de vérifier la présence d'enregistrements avec COUNT et de faire un scan complet de la table, nous avons commencé à utiliser EXISTS.
- Nous nous sommes débarrassés de DISTINCT (il n’y a pas de recette universelle, mais parfois on peut facilement s’en passer en accélérant la requête de 10 à 100 fois).
Par exemple, au lieu de la requête pour extraire tous les chauffeurs d'une grande table de livraisons (DELIVERY),
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
nous avons effectué une requête sur une table PERSON relativement petite.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Il semblerait que nous ayons utilisé une sous-requête corrélée, mais elle offre une acceleration de plus de 10 fois.
- Dans de nombreux cas, nous avons même renoncé à COUNT et
- au lieu de
UPPER(s) LIKE JOHN%nous utilisons
s ILIKE “John%”
Chaque requête spécifique a parfois pu être accélérée de 3 à 1000 fois. Malgré ces performances impressionnantes, au début, nous pensions qu'il n'y avait pas de sens à optimiser une requête qui s'exécutait en 10 ms, qui figurait dans le 300e rang des requêtes les plus lourdes et qui, en termes de charge totale sur la base de données, ne représentait qu'un infime pourcentage. Mais en appliquant la même recette à un groupe de requêtes similaires, nous regagnions plusieurs pourcentages. Pour ne pas perdre de temps à examiner manuellement des centaines de requêtes, nous avons écrit quelques scripts simples qui, grâce à des expressions régulières, identifiaient des requêtes similaires. Au final, la recherche automatique de groupes de requêtes nous a permis d'améliorer encore notre performance avec des efforts modestes.
Nous travaillons depuis trois ans sur le même matériel. La charge moyenne quotidienne est d'environ 30 %, atteignant jusqu'à 70 % lors des pics. Le nombre de requêtes ainsi que le nombre d'utilisateurs ont augmenté d'environ dix fois. Tout cela grâce à un suivi constant de ces groupes de requêtes TOP-MEDIUM. Dès qu'une nouvelle requête apparaît dans le groupe TOP, nous l'analysions immédiatement et essayons d'accélérer. Nous examinons le groupe MEDIUM une fois par semaine à l'aide de scripts d'analyse des requêtes. Si de nouvelles requêtes apparaissent que nous savons déjà comment optimiser, nous les modifions rapidement. Parfois, nous trouvons de nouvelles méthodes d'optimisation applicables instantanément à plusieurs requêtes.
Selon nos prévisions, le serveur actuel pourra supporter une augmentation du nombre d'utilisateurs encore de 3 à 5 fois. Cependant, nous avons un autre atout dans notre manche : nous n'avons toujours pas transféré les requêtes SELECT sur le miroir, comme cela est recommandé. Mais nous ne le faisons pas consciemment, car nous souhaitons d'abord exploiter pleinement les possibilités de "l'optimisation intelligente" avant de recourir à "l'artillerie lourde".
Un regard critique sur le travail accompli peut suggérer l'utilisation du dimensionnement vertical. Acheter un serveur plus puissant au lieu de faire perdre du temps aux spécialistes. Un serveur peut ne pas coûter si cher, surtout que nos limites de dimensionnement vertical ne sont pas encore atteintes. Cependant, le nombre de requêtes n'a augmenté que de dix fois. Au cours des dernières années, la fonctionnalité du système s'est élargie et nous avons maintenant plus de variétés de requêtes. La fonctionnalité existante, grâce à la mise en cache, est exécutée avec moins de requêtes et, de plus, des requêtes plus efficaces. Cela signifie que nous pouvons multiplier par cinq de manière optimiste pour obtenir le véritable coefficient d'accélération. Ainsi, selon des calculs très conservateurs, on peut dire que l'accélération a été de 50 fois et plus. Dimensionner verticalement le serveur 50 fois coûterait plus cher. Surtout en tenant compte que l'optimisation réalisée une fois fonctionne en permanence, tandis que la facture pour le serveur loué arrive chaque mois.
Source : habr.com
