

Tout grand projet a commencé avec quelques serveurs. D'abord il y avait un serveur de base de données, puis des esclaves ont été ajoutés pour scalabilité de lecture. Et là — stop ! Un maître, mais beaucoup d'esclaves ; si l'un des esclaves part, tout ira bien, mais si le maître part — ça va mal : temps d'arrêt, les admins se battent pour redémarrer le serveur. Que faire ? Réserver le maître. Mon collègue Pavel en a déjà parlé. , je ne vais pas le répéter. À la place, je vais vous expliquer pourquoi vous avez absolument besoin d'Orchestrator pour MySQL !
Commençons par la question principale : « Comment allons-nous passer le code sur une nouvelle machine lorsque le maître part ? »
- Le schéma avec VIP (IP virtuelle) me plaît le plus, et c'est de cela que nous allons parler ci-dessous. C'est le plus simple et le plus évident, bien qu'il ait une limitation claire : le maître que nous allons réserver doit se trouver dans le segment L2 avec la nouvelle machine, c'est-à-dire qu'on peut oublier le deuxième centre de données. De plus, en théorie, si l'on suit la règle selon laquelle un grand L2 est le mal, car L2 est uniquement pour le rack, et entre les racks c'est L3, un tel schéma a encore plus de limitations.
- On peut écrire dans le code le nom DNS et le résoudre via /etc/hosts. En réalité, il n'y aura pas de résolution. L'avantage de ce schéma : il n'y a pas de limite propre à la première méthode, c'est-à-dire qu'on peut organiser des cross-DC. Mais alors se pose la question évidente, à quelle vitesse nous amènerons le changement dans /etc/hosts via Puppet-Ansible.
- On peut modifier un peu le deuxième moyen : installer un DNS caché sur tous les serveurs web, par lequel le code ira vers la base de données maître. On peut définir un TTL de 60 pour cet enregistrement DNS. Il semble que si cela est bien implémenté, c'est une bonne méthode.
- Le schéma avec la découverte de services, impliquant l'utilisation de Consul et etcd.
- Une option intéressante avec . Il faut acheminer tout le trafic vers MySQL à travers ProxySQL, ProxySQL sait déjà déterminer qui est le maître. Au fait, on peut lire à propos de l'une des utilisations de ce produit dans mon .
L'auteur d'Orchestrator, travaillant chez Github, a d'abord réalisé le premier schéma avec VIP, puis l'a adapté au schéma avec Consul.
Schéma typique de l'infrastructure :
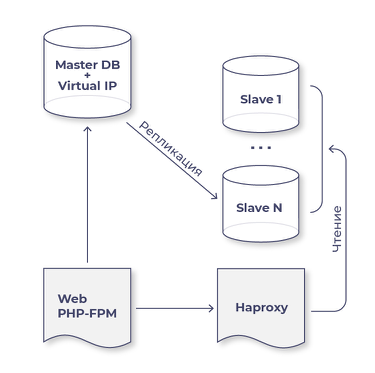
Je vais d'abord décrire les situations évidentes à prendre en compte :
- L'adresse VIP ne doit pas être configurée sur aucun des serveurs. Imaginons la situation : le maître redémarre, et pendant qu'il se charge, Orchestrator est passé en mode failover et a fait de l'un des esclaves un maître ; ensuite, l'ancien maître se réveille, et maintenant le VIP est sur deux machines. C'est mauvais.
- Pour l'orchestrateur, un script devra être écrit pour communiquer avec l'ancien et le nouveau maître. Sur l'ancien, il faut effectuer un ifdown, et sur le nouveau maître — un ifup vip. Il serait également bon d'intégrer dans ce script que, en cas de basculement, le port sur le commutateur de l'ancien maître soit simplement éteint, afin d'éviter toute situation de split-brain.
- Après que l'Orchestrateur a appelé votre script pour d'abord retirer le VIP et/ou éteindre le port sur le commutateur, puis a appelé le script pour activer le VIP sur le nouveau maître, n'oubliez pas d'indiquer à tous via la commande arping que le nouveau VIP est maintenant actif ici.
- Tous les esclaves doivent avoir read_only=1, et dès que vous promouvez un esclave en maître, il doit passer à read_only=0.
- N'oubliez pas qu'un esclave peut devenir maître, celui que nous avons choisi pour cela (l'Orchestrateur dispose d'un mécanisme de préférence pour déterminer quel esclave sera considéré comme candidat au nouveau maître en premier, lequel en second, et quel esclave ne doit en aucun cas être choisi comme maître). Si un esclave devient maître, il conservera la charge de l'esclave et ajoutera la charge du maître, ce qui doit être pris en compte.
Pourquoi avez-vous absolument besoin de l'Orchestrateur si vous ne l'avez pas ?
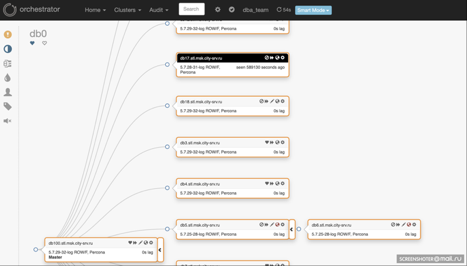
- L'Orchestrateur a une interface graphique très conviviale qui affiche toute la topologie (voir la capture d'écran ci-dessous).
- L'Orchestrateur peut suivre quels esclaves sont à la traîne et où la réplication a totalement échoué (nous avons des scripts attachés à l'Orchestrateur pour l'envoi de SMS).
- L'Orchestrateur vous indique sur quels esclaves il y a une erreur de GTID errant.
Interface de l'Orchestrateur :
Qu'est-ce que le GTID errant ?
Il y a deux exigences principales pour le fonctionnement de l'Orchestrateur :
- Il est nécessaire que sur toutes les machines du cluster MySQL, le pseudo GTID soit activé, nous avons le GTID activé.
- Il faut qu'il y ait le même type de binlogs partout, cela peut être en mode statement. Nous avions une configuration où le maître et la plupart des esclaves étaient en mode Row, tandis que deux sont restés en mode Mixed pour des raisons historiques. En conséquence, ces esclaves l'Orchestrateur a simplement refusé de connecter au nouveau maître.
Rappelez-vous que le plus important dans un esclave de production est sa cohérence avec le maître ! Si vous avez le Global Transaction ID (GTID) activé à la fois sur le maître et sur l'esclave, vous pouvez utiliser la fonction gtid_subset pour vérifier si les mêmes requêtes de modification de données ont bien été exécutées sur ces machines. Vous pouvez lire plus à ce sujet. .
Ainsi, Orchestrator vous montre à travers l'erreur GTID errant qu'il y a des transactions sur le slave qui ne figurent pas sur le master. Pourquoi cela se produit-il ?
- Le read_only=1 n'est pas activé sur le slave, quelqu'un s'est connecté et a exécuté une requête de modification des données.
- Le super_read_only=1 n'est pas activé sur le slave, alors l'administrateur, confondant les serveurs, est entré et a exécuté une requête là-bas.
- Si vous avez pris en compte les deux points précédents, il y a encore une astuce : dans MySQL, la requête de flush des binlogs est également inscrite dans le binlog, donc à la première flush sur le maître, tous les slaves auront un GTID errant. Comment éviter cela ? Dans la version perona-5.7.25-28, un paramètre binlog_skip_flush_commands=1 a été introduit, interdisant l'écriture de flush dans les binlogs. Plus d'informations sont disponibles sur le site mysql.com. .
Pour résumer tout ce qui a été dit précédemment. Si vous ne souhaitez pas utiliser Orchestrator en mode failover pour le moment, configurez-le en mode observation. Vous aurez alors toujours sous les yeux une carte des interactions entre les machines MySQL et des informations visuelles sur le type de réplication sur chaque machine, si les slaves sont à la traîne, et surtout — dans quelle mesure ils sont cohérents avec le maître !
La question évidente : « Comment Orchestrator doit-il fonctionner ? ». Il doit sélectionner un nouveau maître parmi les slaves actuels, puis reconnecter tous les slaves à celui-ci (c'est précisément pour cela que nous avons besoin de GTID ; si l'on utilise l'ancien mécanisme avec binlog_name et binlog_pos, le passage d'un slave de l'ancien maître au nouveau est tout simplement impossible !). Avant qu'Orchestrator n'arrive, j'ai dû faire tout cela manuellement une fois. L'ancien maître avait des problèmes avec le contrôleur Adaptec, il avait environ 10 slaves. Je devais transférer le VIP de l'ancien maître vers l'un des slaves et reconnecter tous les autres slaves à celui-ci. Combien de consoles ai-je dû ouvrir, combien de commandes simultanées ai-je dû entrer… J'ai dû attendre jusqu'à 3 heures du matin, alléger la charge sur tous les slaves, sauf deux, faire du premier des deux machines le maître, immédiatement y connecter la seconde machine, puis connecter tous les autres slaves au nouveau maître et rétablir la charge. En gros, un véritable cauchemar…
Comment fonctionne Orchestrator lorsqu'il passe en mode failover ? La façon la plus simple de le montrer est d'expliquer une situation où nous souhaitons faire d'une machine plus puissante et plus moderne que celle actuellement le nouveau maître.
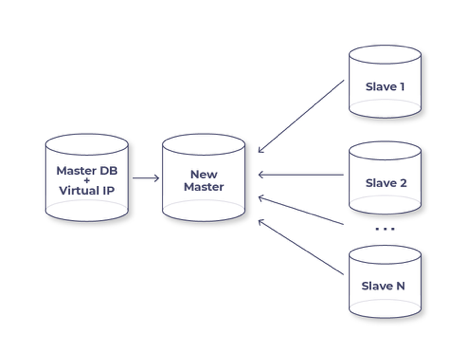
L'image montre le centre du processus. Qu'est-ce qui a été fait jusqu'à présent ? Nous avons dit que nous voulions faire d'un certain esclave un nouveau maître, l'Orchestrateur a commencé à reconnecter tous les autres esclaves à celui-ci, tandis que le nouveau maître joue le rôle de machine de transit. Avec ce schéma, il n'y a pas d'erreurs, tous les esclaves fonctionnent, l'Orchestrateur retire le VIP de l'ancien maître, le transfère au nouveau, met read_only=0 et oublie l'ancien maître. Voilà ! Le temps d'arrêt de notre service est le temps de transfert du VIP, soit 2 à 3 secondes.
C'est tout pour aujourd'hui, merci à tous. Bientôt, il y aura un deuxième article sur l'Orchestrateur. Dans le célèbre film soviétique « Garage », un personnage a dit : « Je ne partirais pas en mission avec lui ! » Eh bien, Orchestrateur, je partirais en mission avec toi !
Source : habr.com
