

En continuant à examiner les technologies d'accélération des opérations d'entrée/sortie appliquées aux systèmes de stockage, commencées dans , il est impossible de ne pas s'arrêter sur une option très populaire, le tiering (Auto Tiering). Bien que l'idéologie de fonctionnement de cette fonction soit très similaire chez différents fabricants de systèmes de stockage, nous examinerons les particularités de la mise en œuvre du tiering à titre d'exemple de .
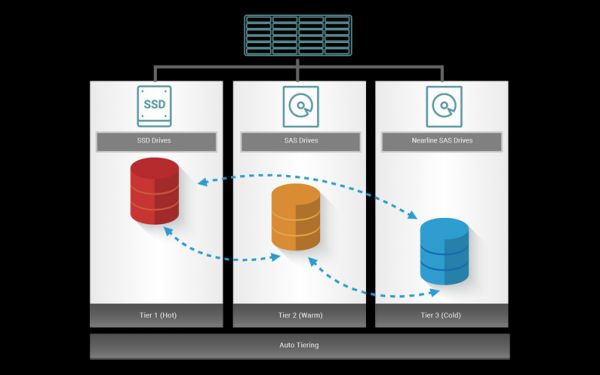
Malgré la diversité des données stockées sur le système de stockage, ces données peuvent être réparties en plusieurs groupes en fonction de leur demande (fréquence d'utilisation). Il est crucial d'organiser un accès aussi rapide que possible aux données les plus populaires (« chaudes »), tandis que le traitement des données moins demandées (« froides ») peut se faire avec une priorité plus basse.
Pour mettre en place un tel schéma, la fonctionnalité de tiering est justement utilisée. Dans ce cas, le tableau de données ne se compose pas de disques homogènes, mais de plusieurs groupes de stockage formant différents niveaux (tier). À l'aide d'un algorithme spécial, les données sont automatiquement déplacées entre les niveaux afin d'assurer une performance finale maximale.
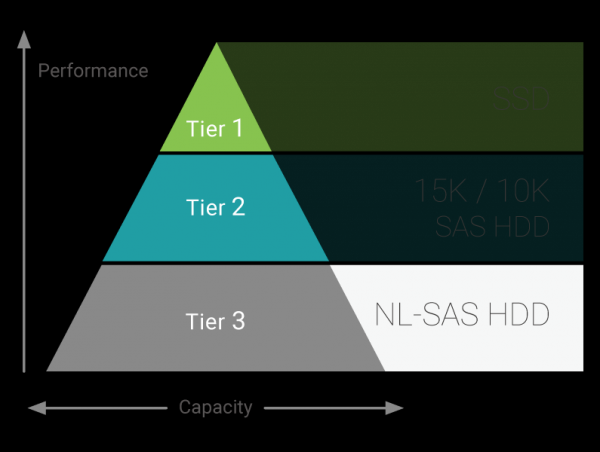
SAN supportent jusqu'à trois niveaux de stockage :
- Niveau 1 : SSD, performance maximale
- Niveau 2 : HDD SAS 10K/15K, haute performance
- Niveau 3 : HDD NL-SAS 7.2K, capacité maximale
Le pool de l'Auto Tiering peut contenir tous les trois niveaux ou seulement deux dans n'importe quelle combinaison. À l'intérieur de chaque niveau, les disques sont regroupés en groupes RAID habituels. Pour une flexibilité maximale, le niveau RAID dans chaque tier peut être différent. Par exemple, rien n'empêche d'organiser une structure comme 4x SSD RAID10 + 6x HDD 10K RAID5 + 12 HDD 7.2K RAID6
Après la création des volumes (disques virtuels) sur le pool, une collecte de statistiques en arrière-plan sur toutes les opérations d'entrée/sortie commence. Pour cela, l'espace est découpé en blocs de 1 Go (appelés sub LUN). À chaque accès à un tel bloc, un coefficient de 1 lui est attribué. Ensuite, au fil du temps, ce coefficient diminue. Après 24 heures, en l'absence de requêtes d'entrée/sortie sur ce bloc, il sera déjà égal à 0,5 et continuera à diminuer chaque heure suivante.
À un moment donné (par défaut chaque jour à minuit), un classement des résultats collectés selon l'activité du sub LUN est effectué en fonction de leurs coefficients. Sur cette base, une décision est prise sur les blocs à déplacer et dans quelle direction. C'est alors que la relocalisation des données entre les niveaux a lieu.
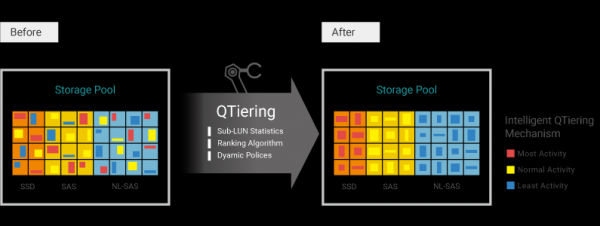
Dans le stockage Qsan, la gestion du processus de tiering est ainsi parfaitement réalisée grâce à de nombreux paramètres, ce qui permet de configurer de manière très flexible la performance finale du système.
Pour déterminer la position initiale des données et la direction prioritaire de leur déplacement, des politiques sont définies séparément pour chaque volume :
- Auto Tiering – politique par défaut, la position initiale et la direction des mouvements sont automatiquement déterminées, c'est-à-dire que les données « chaudes » tendent à aller vers le niveau le plus élevé, tandis que les données « froides » descendent. La position de départ est choisie en fonction de l'espace disponible sur chacun des niveaux. Mais il faut comprendre que le système vise avant tout à maximiser l'utilisation des dispositifs de stockage les plus rapides. Ainsi, en cas d'espace libre, les données seront placées sur les niveaux supérieurs. Cette politique convient à la plupart des scénarios où il n'est pas possible de prévoir à l'avance la demande de données.
- Commencer par le haut, puis Auto Tiering – la différence avec la précédente réside uniquement dans la position initiale des données (au niveau le plus rapide)
- Niveau le plus élevé – les données visent toujours à occuper le niveau le plus rapide. Si, au cours de leur utilisation, elles sont déplacées vers le bas, elles seront ramenées dès que possible. Cette politique convient aux données qui nécessitent un accès extrêmement rapide.
- Niveau minimal – les données visent toujours à occuper le niveau le plus bas. Cette politique est parfaite pour les données peu utilisées (par exemple, les archives).
- Pas de déplacement – le système détermine automatiquement la position initiale des données et ne les déplace pas. Cependant, les statistiques continuent d'être collectées au cas où une relocalisation serait nécessaire par la suite.
Il convient de noter que, bien que les politiques soient définies lors de la création de chaque volume, elles peuvent être modifiées à plusieurs reprises "à la volée" tout au long du cycle de vie du système.
En plus des politiques de la mécanisme de tiering, la fréquence et le rythme de déplacement des données entre les niveaux peuvent également être ajustés. Il est possible de définir un moment spécifique pour le déplacement : quotidiennement ou certains jours de la semaine, ainsi que de réduire l'intervalle de collecte des statistiques à quelques heures (fréquence minimale – 2 heures). Si vous devez limiter le temps d'exécution de l'opération de déplacement des données, vous pouvez définir des plages horaires (fenêtre pour le déplacement). De plus, la vitesse de relocation doit également être indiquée – 3 modes : rapide, moyen, lent.
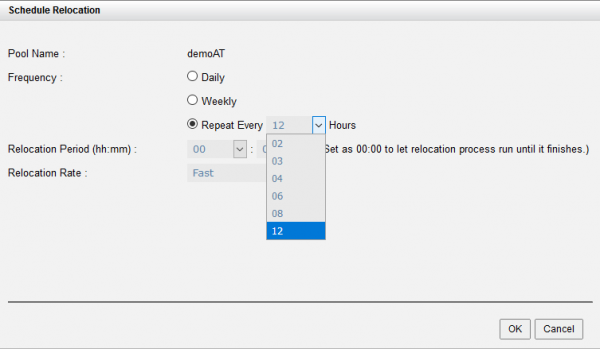
En cas de besoin de relocation immédiate des données, il est possible de l'exécuter manuellement à tout moment sur commande de l'administrateur.
Il est évident que plus les données sont déplacées fréquemment et rapidement entre les niveaux, plus le système de stockage s'adapte de manière flexible aux conditions d'exploitation actuelles. Mais il faut également garder à l'esprit que le déplacement entraîne une charge supplémentaire (principalement sur les disques), donc il n'est pas conseillé de "déplacer" les données sans nécessité absolue. Il est préférable de planifier le déplacement durante les moments de faibles charges. Si les opérations du système de stockage nécessitent constamment une haute performance en mode 24/7, il est conseillé de réduire le rythme de relocation au minimum.
La multitude d'options de tiering ravira sans aucun doute les utilisateurs avancés. Cependant, même pour ceux qui rencontrent cette technologie pour la première fois, il n'y a rien de dérangeant. Vous pouvez parfaitement faire confiance aux paramètres par défaut (politique Auto Tiering, déplacement à la vitesse maximale une fois par jour pendant la nuit) et, au fur et à mesure que les statistiques s'accumulent, ajuster certains paramètres pour obtenir le résultat souhaité.
En comparant le tiering avec une autre technologie également populaire d'augmentation de la performance, comme , il convient de se souvenir des différents principes de fonctionnement de leurs algorithmes.
la mise en cache SSD
Auto Tiering
La vitesse d'apparition de l'effet
Quasi instantanément. Mais l'effet notable n'apparaît qu'après le "pré-chauffage" du cache (minutes-heures)
Après la collecte des statistiques (à partir de 2 heures, idéalement 24 heures) plus le temps de déplacement des données
Durée de l'effet
Tant que les données ne sont pas évincées par un nouvel ensemble (minutes-heures)
Tant que la demande de données reste pertinente (jours et plus)
Indications pour l'application
Augmentation instantanée des performances sur une courte durée (bases de données, environnements de virtualisation)
Augmentation des performances sur une longue période (serveurs de fichiers, web, mails)
Une des caractéristiques du tiering est également sa capacité à être utilisé non seulement pour des scénarios tels que « SSD + HDD », mais aussi pour « HDD rapides + HDD lents » ou même tous les trois niveaux, ce qui est en principe impossible dans le cas où l’on applique un cache SSD.
Test
Pour vérifier le fonctionnement des algorithmes de tiering, nous avons réalisé un test simple. Un pool de deux niveaux SSD (RAID 1) + HDD 7.2K (RAID 1) a été créé, sur lequel un volume avec la politique « niveau minimum » a été placé. C'est-à-dire que les données doivent toujours être positionnées sur les disques lents.
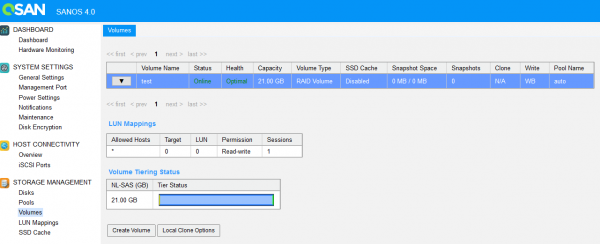
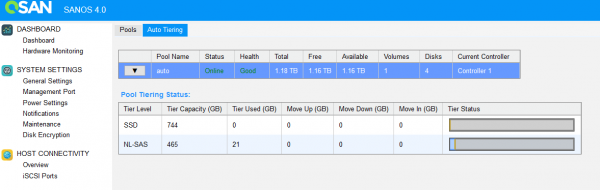
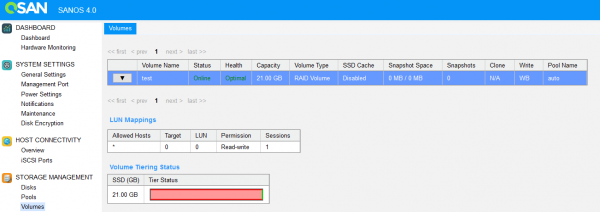
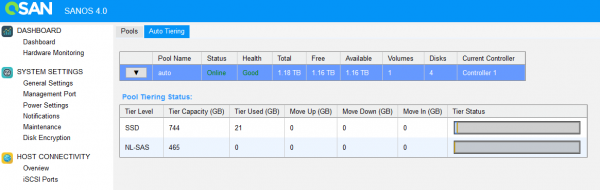
L'interface de gestion montre clairement la répartition des données entre les niveaux.
Après avoir rempli le volume de données, nous avons changé la politique de placement en Auto Tiering et lancé le test IOmeter.
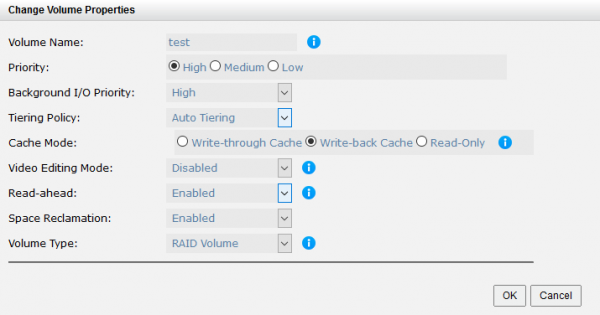
Après plusieurs heures de test, lorsque le système a pu accumuler des statistiques, le processus de relocalisation a commencé.
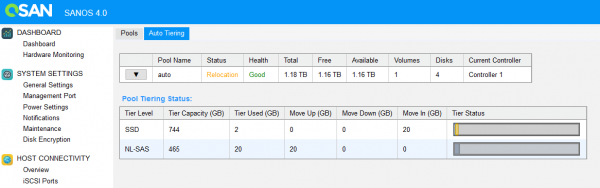
À la fin du déplacement des données, notre volume de test a complètement « migré » vers le niveau supérieur (SSD).
Verdict
L’Auto Tiering est une technologie remarquable, permettant d'améliorer les performances du système de stockage avec un minimum de coûts matériels et temporels grâce à une utilisation plus intensive des supports rapides. Concernant le seul investissement est la licence, qui est acquise une fois pour toutes sans limitation sur le nombre de disques/étagères. Cette fonctionnalité est dotée de tant de riches paramétrages qu’elle peut satisfaire pratiquement tous les besoins d'affaires. Et la visualisation des processus dans l'interface permet de gérer efficacement l'appareil.
Source : habr.com
