

Le composant ETL (Extract, Transform, Load) d'un entrepôt de données se retrouve souvent dans l'ombre de l'entrepôt lui-même et reçoit moins d'attention que la base de données principale ou les composants front-end, BI et génération de rapports. Pourtant, en termes de mécanisme d'alimentation de l'entrepôt en données, l'ETL joue un rôle clé et nécessite autant d'attention de la part des administrateurs que les autres composants. Je m'appelle Alexandre, je gère actuellement l'ETL chez Rostelecom, et dans cet article, je vais essayer de partager un peu ce à quoi un administrateur de l'un des systèmes ETL les plus connus dans un grand entrepôt de données de Rostelecom est confronté.
Si nos chers lecteurs sont déjà familiarisés avec notre projet d'entrepôt de données et avec le produit Informatica PowerCenter, nous pouvons passer directement à la section suivante.
Il y a quelques années, chez Rostelecom, l'idée d'un entrepôt de données d'entreprise unique a mûri et a commencé à prendre forme. Plusieurs entrepôts, qui résolvaient des tâches séparées, avaient déjà été créés, mais le nombre de scénarios augmentait, les coûts de maintenance montaient également, et il est devenu évident que l'avenir était à la centralisation. Architectuellement, cet entrepôt se compose de plusieurs couches, réalisées sur Hadoop et GreenPlum, des bases de données auxiliaires, des mécanismes ETL et BI.
Cependant, en raison du grand nombre de sources de données géographiquement dispersées et hétérogènes, un mécanisme spécial d'extraction des données a été créé, dont le fonctionnement est géré par Informatica. En conséquence, des paquets de données se retrouvent dans la zone d'interface de Hadoop, après quoi les processus de chargement des données dans les couches de l'entrepôt commencent, à la fois dans Hadoop et GreenPlum, gérés par ce que l'on appelle le mécanisme de contrôle ETL, réalisé dans Informatica. Ainsi, le système Informatica est l'un des éléments clés garantissant le bon fonctionnement de l'entrepôt.
Nous parlerons plus en détail de notre entrepôt dans l'un des prochains articles.
Informatica PowerCenter/Big Data Management est actuellement considéré comme le logiciel leader dans le domaine des outils d'intégration des données. C'est un produit de la société américaine Informatica, qui est l'un des acteurs les plus puissants dans les domaines de l'ETL (Extract, Transform, Load), de la gestion de la qualité des données, de la MDM (Gestion des Données de Référence), de l'ILM (Gestion du Cycle de Vie de l'Information) et autres.
Le PowerCenter que nous utilisons est un serveur d'application Tomcat intégré, dans lequel fonctionnent les applications Informatica réalisant ses services :
Domaine, il constitue en fait la base de tout le reste, au sein du domaine, des services, des utilisateurs et des composants GRID fonctionnent.
Console d'Administration, un outil web de gestion et de surveillance, en plus du client Informatica Developer, l'outil principal pour interagir avec le produit.
MRS, Service de Répertoire de Modèles, un entrepôt de métadonnées, qui fait office de couche entre la base où les métadonnées sont stockées physiquement et le client Informatica Developer, où le développement a lieu. Les dépôts conservent à la fois la description des données et d'autres informations, y compris pour plusieurs autres services Informatica, comme le calendrier des exécutions de tâches (Schedules) ou les données de surveillance, ainsi que les ensembles de paramètres des applications, permettant notamment d'utiliser la même application pour travailler avec différentes sources et récepteurs de données.
DIS, Service d'Intégration de Données, est le service où se déroulent les principaux processus fonctionnels, dans lequel les applications fonctionnent et où les Workflows (descriptions de séquence des mappings et de leur interaction) et les Mappings (transformations, blocs où les transformations et le traitement des données ont lieu) sont effectivement lancés.
Configuration GRID – il s'agit en fait d'une variante de construction d'un complexe utilisant plusieurs serveurs, lorsque la charge lancée par le DIS est distribuée sur les nœuds (c'est-à-dire les serveurs entrant dans le domaine). Dans ce cas, en plus de la distribution de la charge dans le DIS à travers une couche d'abstraction GRID supplémentaire, regroupant plusieurs nœuds, sur laquelle fonctionne le DIS au lieu d'une nœud spécifique, des instances MRS de secours peuvent également être créées. On peut même réaliser une haute disponibilité, où les accès externes peuvent se faire via des nœuds de secours en cas de défaillance du principal. Nous avons pour l'instant abandonné cette variante de construction.
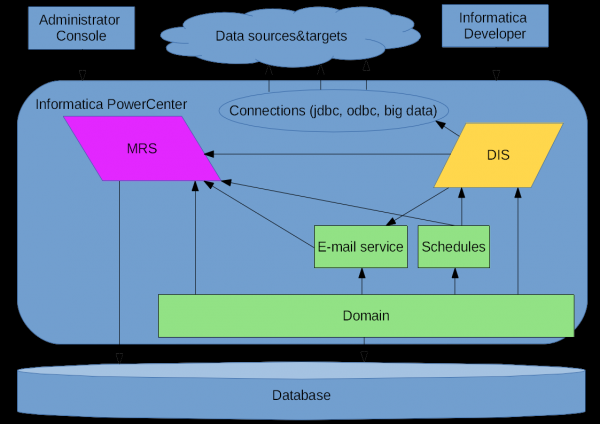
Informatica PowerCenter, schématiquement
Au cours des premières étapes de travail dans la chaîne d'approvisionnement de données, des problèmes se sont régulièrement posés, certains d'entre eux étant dus à la stabilité instable d'Informatica à ce moment-là. Je vais partager certains des moments mémorables de cette saga – la maîtrise d'Informatica 10.
Ancien logo Informatica
Le domaine de responsabilité de notre direction comprend également d'autres environnements Informatica, qui ont leur propre spécificité en raison d'une charge différente. Pour l'instant, je vais me concentrer sur l'évolution d'Informatica en tant que composant ETL du dépôt de données lui-même.
Comment cela a-t-il pu se produire ?
En 2016, lorsque nous avons commencé à gérer Informatica, elle avait déjà atteint la version 10.0, et pour les collègues optimistes qui prenaient la décision d'utiliser un produit avec une version mineure .0, tout semblait évident : il fallait utiliser la nouvelle version ! Du point de vue des ressources matérielles, tout allait très bien à l'époque.
Au printemps 2016, un sous-traitant était responsable du fonctionnement d'Informatica, et d'après les rares utilisateurs de la système, "elle ne fonctionnait que quelques fois par semaine". Il est important de préciser que le dépôt était de facto à l'étape PoC, qu'il n'y avait pas d'administrateurs dans l'équipe et que le système tombait régulièrement pour diverses raisons, après quoi l'ingénieur du sous-traitant le relançait.
À l'automne, trois administrateurs ont rejoint l'équipe, se répartissant les domaines de responsabilité, et un fonctionnement normal de l'exploitation des systèmes dans le projet, y compris Informatica, a commencé à se mettre en place. Il convient de mentionner que ce produit n'est pas largement répandu et ne dispose pas d'une grande communauté où l'on peut trouver des réponses à toutes les questions et résoudre n'importe quel problème. Par conséquent, un soutien technique complet de la part du partenaire russe d'Informatica s'est avéré très important, car il a permis de corriger toutes nos erreurs et celles de la jeune Informatica 10.
La première chose que nous avons dû faire pour les développeurs de notre équipe et le sous-traitant a été de stabiliser le fonctionnement même d'Informatica et d'assurer la fonctionnalité de la console web d'administration (Informatica Administrator).
C'est ainsi que nous avons souvent rencontré les développeurs d'Informatica.
En laissant de côté le processus lui-même d'analyse des causes, la principale raison des pannes était le schéma d'interaction du logiciel Informatica avec la base de données du référentiel, qui se trouvait sur un serveur relativement éloigné, du point de vue du paysage réseau. Cela entraînait des retards et perturbait le fonctionnement des mécanismes assurant le contrôle de l'état du domaine Informatica. Après quelques ajustements de la base de données, un changement des paramètres d'Informatica, les rendant plus tolérants aux retards de la base de données, et finalement la mise à jour de la version d'Informatica à 10.1 ainsi que le transfert de la base de données de l'ancien serveur vers un serveur plus proche d'Informatica, le problème a perdu de son actualité, et depuis, nous n'observons plus de pannes de ce type.
Une des tentatives d'obtenir le fonctionnement d'Informatica Monitor
La situation avec la console d'administration était également critique. Comme le développement se faisait activement directement sur un environnement supposément productif, il était constamment nécessaire pour les collègues d'analyser le fonctionnement des mappings et des workflows « à la volée ». Dans la nouvelle version d'Informatica, le Data Integration Service ne dispose pas d'un outil distinct pour ce type de surveillance, mais dans la console web d'administration, une section de monitoring (Informatica Administrator Monitor) a été ajoutée, où il est possible d'observer le fonctionnement des applications, des workflows et des mappings, ainsi que les exécutions et les logs. Périodiquement, la console devenait totalement inaccessible, ou les informations sur les processus en cours dans DIS cessaient de se mettre à jour, ou des erreurs survenaient lors du chargement des pages.
Optimisation des paramètres java pour stabiliser le fonctionnement
La résolution du problème a été abordée de plusieurs manières, des expériences étaient menées pour modifier les paramètres, des logs et des jstack étaient collectés et envoyés au support, tout en menant activement des recherches sur Google et en observant simplement.
Tout d'abord, un MRS distinct a été créé pour le monitoring, ce qui s'est avéré être l'un des principaux consommateurs de ressources dans nos environnements, car les exécutions de mappings se font très intensivement. Des ajustements ont été effectués concernant le java heap et quelques autres paramètres.
En conséquence, lors de la mise à jour suivante d'Informatica 10.1.1, la fonctionnalité de la console et du monitor a pu être stabilisée, les développeurs ont pu travailler plus efficacement, et les processus réguliers devenaient de plus en plus réguliers.
L'expérience d'interaction entre le développement et l'administration peut être intéressante. La question de la compréhension générale de la façon dont tout fonctionne, ce qui est possible et ce qui ne l'est pas, est toujours importante lors de l'utilisation de systèmes complexes. Il est donc conseillé de former d'abord l'équipe d'administrateurs sur la façon d'administrer le logiciel, puis l'équipe de développeurs sur la façon d'écrire le code et de modéliser les processus dans le système, avant de les envoyer travailler à l'obtention de résultats. C'est vraiment important lorsque le temps n'est pas une ressource illimitée. Beaucoup de problèmes peuvent être résolus par une simple exploration des options, mais parfois, certains nécessitent des connaissances préalables — notre cas confirme l'importance de comprendre cette axiomatique.
Par exemple, lors de l'activation de la versionnage dans MRS (comme il s'est finalement avéré, une autre version de SVN était nécessaire), après un certain temps, nous avons constaté avec inquiétude que le temps de redémarrage du système avait augmenté à plusieurs dizaines de minutes. En identifiant la cause du retard au démarrage et en désactivant le versionnage, tout est redevenu normal.
Parmi les obstacles notables liés à Informatica, on peut rappeler l'épique bataille contre les flux java en constante augmentation. À un moment donné, il était temps de répliquer, c'est-à-dire de diffuser les processus établis sur un grand nombre de systèmes sources. Il s'est avéré que tous les processus dans 10.1.1 ne fonctionnaient pas bien et, après un certain temps, DIS devenait inopérant. Des dizaines de milliers de flux étaient détectés, leur nombre augmentant de manière particulièrement notoire lors de la procédure de déploiement des applications. Parfois, il fallait redémarrer plusieurs fois par jour pour rétablir le bon fonctionnement.
Il convient de remercier le support technique, les problèmes ont été localisés et résolus relativement rapidement grâce à l'EBF (Emergency Bug Fix) – après cela, tout le monde a eu le sentiment que l'outil fonctionnait vraiment.
Ça fonctionne quand même !
Au moment du début de l'opération en mode cible, Informatica se présentait comme suit. Version Informatica 10.1.1HF1 (HF1 signifie HotFix1, une version du fournisseur issue du complexe des EBF) avec des EBF supplémentaires installés, corrigeant nos problèmes de mise à l'échelle et d'autres, sur un serveur des trois qui composaient le GRID, 20 cœurs x86_64 et un stockage sur un énorme et lent ensemble de disques locaux — c'est tout. configuration du serveur pour le cluster Hadoop. Sur un autre serveur identique se trouve la base de données Oracle, avec laquelle interagissent à la fois le domaine Informatica et le mécanisme de gestion ETL. Tout cela est surveillé par des outils de monitoring standards utilisés par l'équipe (Zabbix + Grafana), concernant à la fois Informatica avec ses services et les processus de chargement qui l'alimentent. Actuellement, la performance et la stabilité de fonctionnement, sans tenir compte des facteurs externes, dépendent des réglages qui limitent la charge.
Il convient de mentionner séparément le GRID. L'environnement a été construit sur trois nœuds, avec la possibilité de répartition de charge. Cependant, lors des tests, il a été découvert qu'en raison de problèmes d'interaction entre les instances de nos applications, cette configuration ne fonctionnait pas comme prévu, et nous avons temporairement décidé d'abandonner ce schéma de construction en retirant deux des trois nœuds du domaine. Le schéma lui-même est resté inchangé, et c'est actuellement un service GRID, mais réduit à un seul nœud.
Actuellement, une difficulté persiste liée à la chute de performance lors du nettoyage régulier du schéma de surveillance - lors de processus simultanés dans le système et d'un nettoyage en cours, des pannes peuvent survenir dans le mécanisme de gestion ETL. Cela est actuellement résolu de manière « bricolée » - par un nettoyage manuel du schéma de surveillance, entraînant la perte de toutes ses données précédentes. Cela n'est pas trop critique pour la production lors d'un fonctionnement normal, mais la recherche d'une solution pérenne est en cours.
De cette situation découle un autre problème - il arrive parfois que de multiples lancements de notre mécanisme de gestion se produisent.
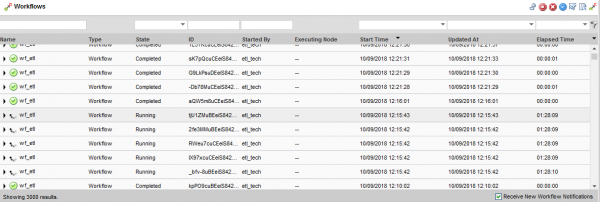
Des lancements multiples de l'application entraînant une défaillance du mécanisme
Lors d'une exécution programmée à des moments de forte charge sur le système, il arrive parfois que des situations se produisent, menant à une défaillance du mécanisme. Jusqu'à présent, le problème est corrigé manuellement, et nous recherchons une solution permanente.
Dans l'ensemble, on peut résumer qu'en cas de forte charge, il est très important de fournir des ressources adéquates, cela concerne aussi bien les ressources matérielles pour Informatica que pour son référentiel de base de données, tout en assurant des paramètres optimaux pour ceux-ci. De plus, la question demeure ouverte quant à la meilleure disposition de la base de données — sur un hôte séparé ou sur le même que celui où fonctionne le logiciel Informatica. D'un côté, avoir tout sur un seul serveur pourrait être moins coûteux, et ce regroupement éliminerait pratiquement tout problème potentiel d'interaction réseau, mais d'un autre côté, la charge sur l'hôte de la base de données s'ajoute à la charge d'Informatica.
Comme dans tout produit sérieux, il existe des moments cocasses dans Informatica.
Une fois, en analysant une certaine panne, j'ai remarqué que les heures des événements dans les journaux MRS étaient étrangement notées.
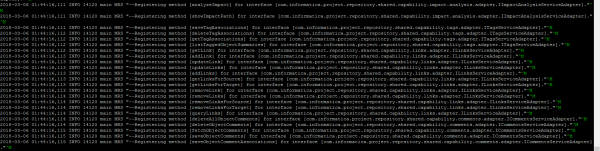
Le dualisme temporel dans les journaux MRS « par design »
Il s'est avéré que les horodatages étaient écrits au format 12 heures, sans indication AM/PM, donc avant ou après midi. Une requête avait même été ouverte à ce sujet, et une réponse officielle avait été obtenue — c'était bien prévu ainsi, dans le journal MRS les marquages sont écrits exactement dans ce format. Cela laisse parfois un certain mystère quant à l'heure à laquelle un ERROR se produit...
S'efforcer de s'améliorer
Aujourd'hui, Informatica est un outil assez stable, facile à utiliser pour les administrateurs et les utilisateurs, extrêmement puissant en termes de capacités actuelles et de potentiel. Ses fonctionnalités dépassent de loin nos besoins et, de facto, il est actuellement utilisé dans le projet d'une manière qui n'est pas très caractéristique ou typique. Les difficultés sont en partie liées à la manière dont fonctionnent les mécanismes — la spécificité étant qu'en très peu de temps, un grand nombre de flux est lancé, qui mettent à jour intensément les paramètres et interagissent avec le référentiel de base de données, tout en utilisant presque entièrement les ressources matérielles du serveur en termes de CPU.
Nous sommes actuellement sur le point de passer à Informatica 10.2.1 ou 10.2.2, dans lesquels certains mécanismes internes ont été retravaillés, et le support promet l'absence d'un certain nombre de problèmes de performance et de fonctionnement que nous rencontrons actuellement. De plus, d'un point de vue matériel, des serveurs dotés d'une configuration optimale pour nous sont attendus, compte tenu des réserves à court terme en vue de la croissance et du développement du stockage.
Il faudra bien sûr procéder à des tests, vérifier la compatibilité et, éventuellement, apporter des modifications architecturales concernant le HA GRID. Le développement dans le cadre d'Informatica se poursuivra, car à court terme, nous ne pouvons pas remplacer le système.
Et ceux qui seront responsables de ce système à l'avenir parviendront sans aucun doute à atteindre les niveaux de fiabilité et de performance exigés par les clients.
Cet article a été préparé par l'équipe de gestion des données de Rostelecom
Logo actuel d'Informatica
Source : habr.com
