

Il existe de nombreux outils sous Linux pour le débogage des noyaux et des applications. La plupart d'entre eux ont un impact négatif sur les performances des applications et ne peuvent pas être utilisés en production.
Il y a quelques années, un nouvel outil a été développé Il existe maintenant de nombreux utilitaires applicatifs qui utilisent eBPF, et dans cet article, nous verrons comment écrire notre propre utilitaire de profilage basé sur la bibliothèque
PythonBCC Ceph est lent
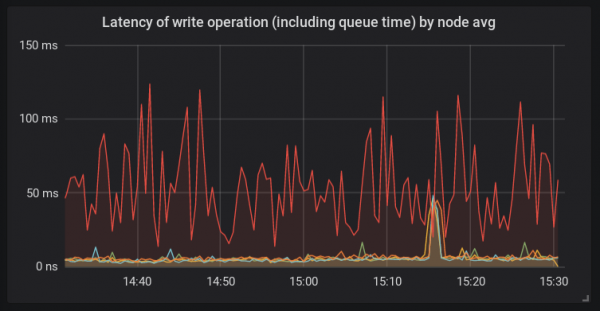
Un nouvel hôte a été ajouté au cluster Ceph. Après la migration d'une partie des données vers celui-ci, nous avons remarqué que la vitesse de traitement des requêtes d'écriture était bien inférieure à celle des autres serveurs.
Contrairement aux autres plateformes, cet hôte utilisait bcache et un nouveau noyau Linux 4.15. Ce type de configuration était utilisé ici pour la première fois. À ce moment-là, il était clair que le problème pouvait théoriquement provenir de n'importe où.
Enquête sur l'hôte
Commençons par examiner ce qui se passe à l'intérieur du processus ceph-osd. Pour ce faire, nous utiliserons
flamescope et L'image nous indique que la fonction ):
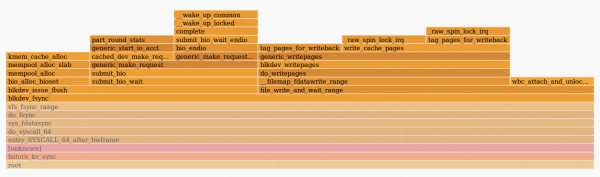
a passé beaucoup de temps à envoyer des requêtes à la fonction fdatasync() generic_make_request() . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.En vérifiant l'hôte, nous avons découvert que le démon systemd-udevd consommait beaucoup de temps CPU — environ 20 % sur plusieurs cœurs. Ce comportement étrange nécessite une enquête. Puisque Systemd-udevd travaille avec des uevent, nous avons décidé de les observer à travers
udevadm monitor . Il s'avère qu'un grand nombre d'événements de changement étaient générés pour chaque périphérique de bloc dans le système. Cela semble assez inhabituel, donc nous devrons déterminer ce qui génère tous ces événements.Utilisation de l'outil BCC
Comme nous l'avons découvert, le noyau (et le démon ceph dans l'appel système) consomme beaucoup de temps dans
. Essayons de mesurer la vitesse d'exécution de cette fonction. Il existe déjà un excellent utilitaire — . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.funclatency il existe déjà un excellent utilitaire — funclatency. Nous allons tracer le démon par son PID avec un intervalle d'affichage d'une seconde et afficher le résultat en millisecondes.
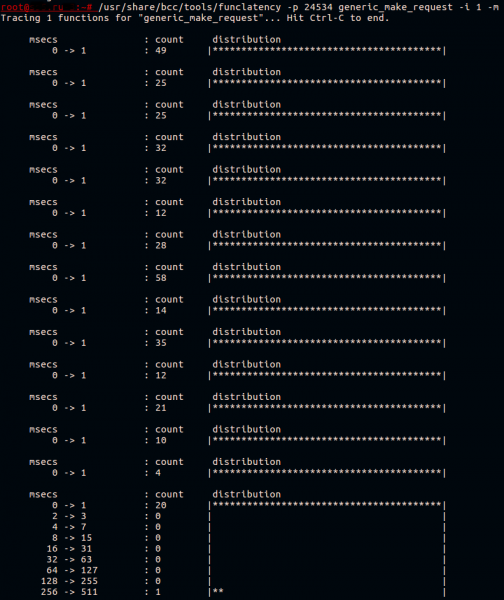
Cette fonction fonctionne généralement rapidement. Tout ce qu'elle fait est de transmettre la requête dans la file d'attente du pilote du périphérique.
Bcache est un dispositif complexe qui se compose en réalité de trois disques :
- dispositif de sauvegarde (disque mis en cache), dans ce cas un HDD lent ;
- dispositif de mise en cache (disque de cache), ici un partition NVMe de l'appareil ;
- un dispositif virtuel bcache, avec lequel l'application travaille.
Nous savons que la transmission de la requête se bloque, mais pour lequel de ces dispositifs ? Nous allons examiner cela un peu plus tard.
Pour l'instant, nous savons que les uevents sont probablement à l'origine des problèmes. Trouver ce qui cause leur génération n'est pas si simple. Supposons que ce soit un logiciel qui s'exécute périodiquement. Regardons quel logiciel est exécuté dans le système à l'aide du script execsnoop du même . Exécutons-le et dirigeons la sortie vers un fichier.
Par exemple comme ceci :
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nous ne fournirons pas ici la sortie complète d'execsnoop, mais une ligne qui nous intéresse ressemblait à ceci :
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
La troisième colonne est le PPID (PID parent) du processus. Le processus avec le PID 5802 s'est avéré être un des threads de notre système de surveillance. Lors de la vérification de la configuration du système de surveillance, des paramètres incorrectement définis ont été trouvés. La température de l'adaptateur HBA était mesurée toutes les 30 secondes, ce qui est beaucoup trop fréquent. Après avoir modifié l'intervalle de vérification pour un plus long, nous avons constaté que le retard dans le traitement des requêtes de cet hôte ne se distinguait plus des autres hôtes.
Mais il reste encore à comprendre pourquoi le dispositif bcache était si lent. Nous avons préparé une plateforme de test avec une configuration identique et avons essayé de reproduire le problème en exécutant fio sur bcache, en lançant périodiquement udevadm trigger pour générer des uevents.
Écrire des outils basés sur BCC
Essayons d'écrire un utilitaire simple pour tracer et afficher à l'écran les appels les plus lents . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.. Nous sommes également intéressés par le nom du disque pour lequel cette fonction a été appelée.
Le plan est simple :
- Enregistrement kprobe sur . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.:
- Nous sauvegardons en mémoire le nom du disque accessible via l'argument de la fonction ;
- Nous sauvegardons le timestamp.
- Enregistrement kretprobe au retour de . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.:
- Nous obtenons le timestamp actuel ;
- Nous cherchons le timestamp sauvegardé et le comparons avec le courant ;
- Si le résultat est supérieur à celui indiqué, nous trouvons le nom du disque enregistré et l'affichons dans le terminal.
Kprobes et kretprobes utilisent un mécanisme de points d'arrêt pour modifier le code des fonctions à la volée. Vous pouvez lire et article à ce sujet. Si l'on regarde le code de divers utilitaires dans , on peut remarquer qu'ils ont une structure identique. Dans cet article, nous omettrons donc l'analyse des arguments du script et passerons directement au programme BPF.
Le texte eBPF dans le script python ressemble à ceci :
bpf_text = """ # Ici sera le code du programme bpf """
Pour échanger des données entre les fonctions, les programmes eBPF utilisent . Nous allons faire de même. Comme clé, nous utiliserons le PID du processus, et comme valeur, nous définirons la structure :
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Ici, nous enregistrons une table de hachage appelée p, avec une clé de type u64 et une valeur de type struct data_t. La table sera accessible dans le contexte de notre programme BPF. Le macro BPF_PERF_OUTPUT enregistre une autre table appelée events, qui est utilisée pour vers l'espace utilisateur.
Lors de la mesure des délais entre l'appel d'une fonction et son retour, ou entre les appels de différentes fonctions, il faut prendre en compte le fait que les données obtenues doivent appartenir à un même contexte. En d'autres termes, il faut se souvenir des possibles exécutions en parallèle des fonctions. Nous avons la possibilité de mesurer le délai entre l'appel d'une fonction dans le contexte d'un processus et le retour de cette fonction dans le contexte d'un autre processus, mais cela sera probablement inutile. Un bon exemple ici peut être , où comme clé de la table de hachage, on utilise un pointeur sur struct request, qui reflète une seule requête au disque.
Ensuite, nous devons écrire le code qui sera exécuté lors de l'appel de la fonction étudiée :
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Ici, le deuxième argument sera remplacé par le premier argument de la fonction appelée . Après cela, nous obtenons le PID du processus dans le contexte duquel nous travaillons, ainsi que le timestamp actuel en nanosecondes. Nous enregistrons tout cela dans un nouvel struct data_t data. Le nom du disque est obtenu à partir de la structure bio, qui est transmis lors de l'appel . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache., et nous le conservons dans la même structure data. La dernière étape consiste à ajouter une entrée dans la table de hachage mentionnée précédemment.
La fonction suivante sera appelée à la sortie de . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache.:
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Cette fonction est similaire à la précédente : nous obtenons le PID du processus et le timestamp, mais nous n'allouons pas de mémoire pour une nouvelle structure de données. Au lieu de cela, nous cherchons dans la table de hachage une structure existante avec la clé == le PID actuel. Si la structure est trouvée, nous obtenons le nom du processus en cours d'exécution et l'ajoutons à celle-ci.
Le décalage binaire que nous utilisons ici est nécessaire pour obtenir le GID de thread, c'est-à-dire le PID du processus principal qui a lancé le thread, dans le contexte duquel nous travaillons. La fonction que nous appelons renvoie à la fois le GID du thread et son PID dans une seule valeur 64 bits.
Lors de l'affichage dans le terminal, nous ne nous intéressons pas actuellement au thread, mais au processus principal. Après avoir comparé la latence obtenue avec le seuil donné, nous transmettons notre structure data à l'espace utilisateur via la table events, après quoi nous supprimons l'entrée de p.
Dans le script Python qui chargera ce code, nous devons remplacer MIN_US et FACTOR par les seuils de latence et d'unités de temps que nous transmettrons via des arguments :
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Nous devons maintenant préparer le programme BPF via et enregistrer les probes :
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Nous devrons également définir struct data_t dans notre script, sinon nous ne pourrons rien lire :
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
La dernière étape consiste à afficher les données dans le terminal :
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Le script lui-même est disponible sur . Essayons de l'exécuter sur une plateforme de test où fio est en cours d'exécution, écrivant sur bcache, et d'appeler udevadm monitor :
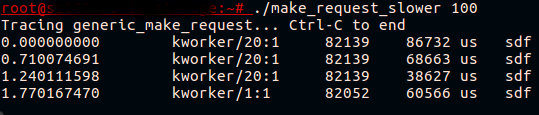
Enfin ! Maintenant nous voyons que ce qui semblait être un dispositif bcache ralentissant est en réalité un appel de ralentissement . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache. pour le disque mis en cache.
Analysez le noyau
Qu'est-ce qui ralentit exactement lors de la transmission de la requête ? Nous voyons que le délai survient même avant le début de la comptabilité de la requête, c'est-à-dire que le comptage spécifique de la requête pour une sortie statistique ultérieure ( /proc/diskstats ou iostat ) n'a pas encore commencé. Il est facile de vérifier cela en exécutant iostat pendant la reproduction du problème, ou , qui se base sur le début et la fin de la comptabilité des requêtes. Aucune de ces utilitaires ne montrera de problèmes pour les requêtes vers le disque mis en cache.
Si nous regardons la fonction . Cela signifie que la cause des problèmes se trouve probablement en dehors du démon osd lui-même. Cela pourrait être soit le noyau, soit les disques. La sortie de iostat montrait une forte latence dans le traitement des requêtes par les disques bcache., nous verrons qu'avant le début de la comptabilité de la requête, deux autres fonctions sont appelées. La première — generic_make_request_checks(), effectue des vérifications de la légitimité de la requête par rapport aux paramètres du disque. La seconde — , qui contient un appel intéressant à :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Dans celle-ci, le noyau attend le dégel de la file d'attente. Mesurons le délai blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Traçage de 1 fonction pour "blk_queue_enter"... Appuyez sur Ctrl-C pour terminer.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Il semble que nous soyons proches de la solution. Les fonctions utilisées pour "geler/dégeler" la file d'attente sont et . Elles sont utilisées lorsqu'il est nécessaire de modifier les paramètres de la file d'attente des requêtes, susceptibles d'affecter les requêtes en cours dans cette file d'attente. Lors de l'appel de blk_mq_freeze_queue() par la fonction le compteur q->mq_freeze_depth. Ensuite, le noyau attend que la file soit vidée dans .
Le temps d'attente pour vider cette file est équivalent au délai du disque, car le noyau attend l'achèvement de toutes les opérations en file d'attente. Dès que la file est vide, les paramètres sont appliqués. Ensuite, on appelle , qui décrémente le compteur freeze_depth.
Nous savons maintenant assez de choses pour corriger la situation. La commande udevadm trigger entraîne l'application des paramètres pour le périphérique de bloc. Ces paramètres sont décrits dans les règles udev. Nous pouvons identifier quels paramètres « gèlent » la file en essayant de les modifier via sysfs ou en consultant le code source du noyau. Nous pouvons également essayer l'outil BCC , qui affichera dans le terminal les traces de pile du noyau et de l'espace utilisateur pour chaque appel à blk_freeze_queue, par exemple :
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [noyau]
    	elevator_switch+0x29 [noyau]
    	elv_iosched_store+0x197 [noyau]
    	queue_attr_store+0x5c [noyau]
    	sysfs_kf_write+0x3c [noyau]
    	kernfs_fop_write+0x125 [noyau]
    	__vfs_write+0x1b [noyau]
    	vfs_write+0xb8 [noyau]
    	sys_write+0x55 [noyau]
    	do_syscall_64+0x73 [noyau]
    	entry_SYSCALL_64_after_hwframe+0x3d [noyau]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[inconnu]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [noyau]
    	queue_requests_store+0xb6 [noyau]
    	queue_attr_store+0x5c [noyau]
    	sysfs_kf_write+0x3c [noyau]
    	kernfs_fop_write+0x125 [noyau]
    	__vfs_write+0x1b [noyau]
    	vfs_write+0xb8 [noyau]
    	sys_write+0x55 [noyau]
    	do_syscall_64+0x73 [noyau]
    	entry_SYSCALL_64_after_hwframe+0x3d [noyau]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[inconnu]
Les règles Udev changent assez rarement et cela se fait généralement sous contrôle. Nous constatons donc que même l'application de valeurs déjà définies entraîne une augmentation du délai de transmission des requêtes de l'application au disque. Bien sûr, générer des événements udev lorsqu'il n'y a pas de changements dans la configuration des disques (par exemple, un périphérique n'est pas branché/débranché), n'est pas une bonne pratique. Néanmoins, nous pouvons aider le noyau à ne pas effectuer de travail inutile et à ne pas « geler » la file des requêtes si cela n'est pas nécessaire. corrigent la situation.
Conclusion
eBPF est un outil extrêmement flexible et puissant. Dans cet article, nous avons examiné un cas pratique et démontré une petite partie de ce qu'il est possible de faire. Si vous êtes intéressé par le développement d'outils BCC, il vaut la peine de consulter , qui décrit bien les bases du fonctionnement.
Il existe également d'autres outils intéressants pour le débogage et le profilage basés sur eBPF. L'un d'eux est , qui permet d'écrire des lignes de code puissantes et de petits programmes dans un langage de type awk. L'autre est , qui permet de collecter des métriques bas-niveau à haute résolution directement sur votre serveur Prometheus, avec la possibilité d'obtenir par la suite une belle visualisation et même des alertes.
Source : habr.com
