

Lors de RIT 2019, notre collègue Alexandre Korotkov a présenté sur l'automatisation du développement chez CIAN : pour simplifier la vie et le travail, nous utilisons notre propre plateforme Integro. Elle suit le cycle de vie des tâches, décharge les développeurs des opérations répétitives et réduit considérablement le nombre de bugs en production. Dans cet article, nous compléterons la présentation d'Alexandre et raconterons comment nous sommes passés de simples scripts à l'intégration de produits open source via notre plateforme et ce qu'une équipe d'automatisation fait chez nous.
Niveau zéro
« Le niveau zéro n'existe pas, je ne sais pas ce que c'est »
Maître Shifu du film « Kung Fu Panda »
L'automatisation chez CIAN a commencé 14 ans après la création de l'entreprise. À l'époque, l'équipe de développement comptait 35 personnes. C'est difficile à croire, non ? Bien sûr, d'une certaine manière, l'automatisation existait déjà, mais une direction distincte pour l'intégration continue et la livraison de code a commencé à se former précisément en 2015.
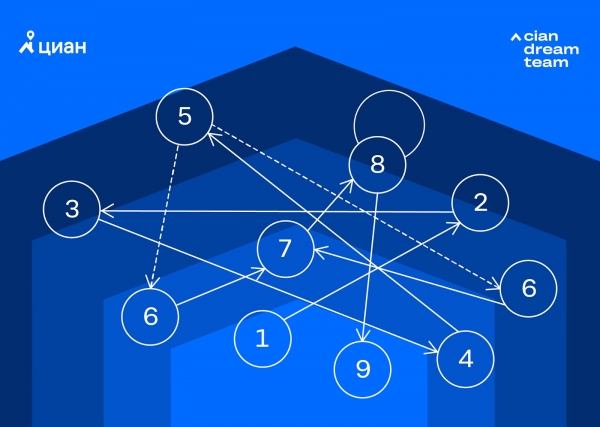
À ce moment-là, nous avions un énorme monolithe en Python, C# et PHP, déployé sur des serveurs Linux/Windows. Pour déployer ce monstre, nous avions un ensemble de scripts que nous exécutions manuellement. Il y avait aussi la construction du monolithe, qui causait douleur et souffrance à cause des conflits lors de la fusion des branches, des corrections de défauts et de la reconstruction « avec un autre ensemble de tâches dans le build ». Globalement, le processus ressemblait à cela :
Cela ne nous convenait pas, et nous voulions construire un processus de construction et de déploiement répétable, automatisé et contrôlé. Pour cela, nous avions besoin d'un système CI/CD, et nous hésitions entre la version gratuite de Teamcity et Jenkins gratuit, car nous avions déjà travaillé avec eux et les deux satisfaisaient nos besoins en termes de fonctionnalités. Nous avons choisi Teamcity comme produit plus récent. À l'époque, nous n'utilisions pas encore une architecture microservices et ne prévoyions pas un grand nombre de tâches et de projets.
Nous arrivons à l'idée d'un système propre.
La mise en œuvre de Teamcity a éliminé une partie du travail manuel : il reste encore à créer des Pull Requests, à faire avancer les tâches dans Jira et à choisir les tâches pour les versions. Avec ça, Teamcity ne pouvait déjà plus gérer. Il fallait choisir la voie d'une automatisation supplémentaire. Nous avons envisagé des options de scripts dans Teamcity ou le passage à des systèmes d'automatisation tiers. Mais au final, nous avons décidé qu'il fallait la flexibilité maximale, que seule une solution interne pouvait offrir. C'est ainsi qu'est née la première version de notre système d'automatisation interne appelé Integro.
Teamcity s'occupe de l'automatisation au niveau du lancement des processus de construction et de déploiement, tandis qu'Integro s'est concentré sur l'automatisation de haut niveau des processus de développement. Il fallait combiner le travail sur les tâches dans Jira avec le traitement du code source associé dans Bitbucket. À ce stade, des workflows spécifiques ont commencé à apparaître au sein d'Integro pour travailler avec différents types de tâches.
Avec l'augmentation de l'automatisation dans les processus commerciaux, le nombre de projets et d'exécutions dans Teamcity a augmenté. Cela a engendré un nouveau problème : un seul instance gratuite de Teamcity ne suffisait plus (3 agents et 100 projets), nous avons ajouté une autre instance (encore 3 agents et 100 projets), puis une autre. Au final, nous avons obtenu un système composé de plusieurs clusters, difficile à gérer :
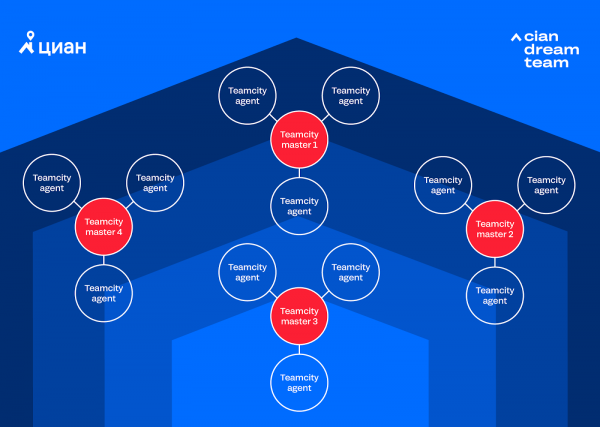
Lorsque la question d'une quatrième instance s'est posée, nous avons compris qu'il ne pouvait plus être question de continuer ainsi, car les coûts cumulés de maintenance de 4 instances dépassaient largement les limites acceptables. Il fallait envisager l'achat d'une Teamcity payante ou opter pour la gratuite Jenkins. Nous avons effectué des calculs sur les instances et les plans d'automatisation et avons décidé que nous allions vivre avec Jenkins. Après quelques semaines, nous avons migré vers Jenkins et nous nous sommes débarrassés d'une partie des tracas liés à la maintenance de plusieurs instances de Teamcity. Cela nous a permis de nous concentrer sur le développement d'Integro et d'adapter Jenkins à nos besoins.
Avec l'augmentation de l'automatisation de base (sous la forme de la création automatique de Pull Requests, de la collecte et de la publication de la couverture de code et d'autres vérifications), il est devenu impératif de s'éloigner des publications manuelles et de confier ce travail aux robots. De plus, l'entreprise a commencé sa transition vers des microservices, nécessitant des publications fréquentes, chacune séparément. Ainsi, nous avons progressivement adopté les publications automatiques de nos microservices (le monolithe est encore publié manuellement en raison de la complexité du processus). Mais, comme c'est souvent le cas, une nouvelle complexité est apparue.
Automatisons les tests
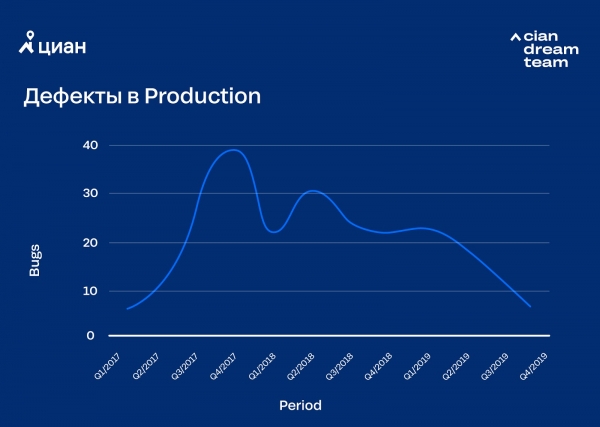
En raison de l'automatisation des publications, les processus de développement se sont accélérés, en partie grâce au passage de certaines étapes de test. Cela a entraîné une perte temporaire de qualité. Cela peut sembler banal, mais avec l'accélération des publications, il fallait également changer la méthodologie de développement du produit. Il était nécessaire de réfléchir à l'automatisation des tests, à l'instauration d'une responsabilité personnelle (il s'agit de « l'acceptation d'une idée dans la tête », pas de sanctions financières) des développeurs pour le code publié et les bugs qu'il contient, ainsi qu'à une décision sur la publication ou non d'une tâche via le déploiement automatique.
En résolvant les problèmes de qualité, nous avons pris deux décisions importantes : nous avons commencé à réaliser des tests canari et avons mis en place une surveillance automatique des erreurs avec une réponse automatique en cas de dépassement. La première solution a permis de repérer des erreurs évidentes avant que le code n'atteigne pleinement la production, la seconde a diminué le temps de réaction aux problèmes en production. Des erreurs, bien sûr, il y en a, mais nous passons une plus grande partie de notre temps et de nos efforts non pas à corriger, mais à minimiser.
Équipe d'automatisation
Nous avons actuellement une équipe de 130 développeurs, et nous continuons . L'équipe d'intégration et de livraison continues de code (ci-après dénommée équipe CI/CD) se compose de 7 personnes et travaille dans 2 directions : le développement de la plateforme d'automatisation Integro et DevOps.
Le DevOps est responsable des environnements Dev/Beta du site CIAN, de l'environnement Integro, aide les développeurs à résoudre des problèmes et élabore de nouvelles approches pour l'extension des environnements. La direction du développement Integro s’occupe à la fois d’Integro elle-même et de services connexes, tels que des plugins pour Jenkins, Jira, Confluence, et développe également des utilitaires et des applications pour les équipes de développeurs.
L'équipe DI travaille en collaboration avec l'équipe Plateforme, qui s'occupe de l'architecture, des bibliothèques et des approches de développement au sein de l'entreprise. De plus, tout développeur au sein de CIAN peut contribuer à l'automatisation, par exemple en réalisant de la micro-automatisation selon les besoins de l'équipe ou en partageant une idée innovante pour améliorer encore l'automatisation.
Le gâteau à plusieurs couches de l'automatisation chez CIAN
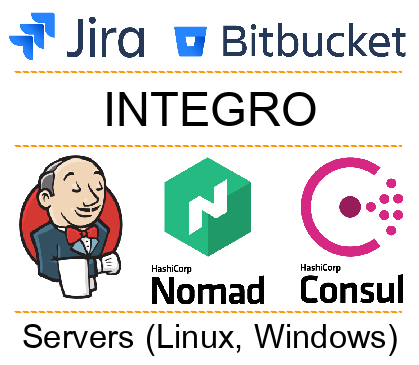
Tous les systèmes impliqués dans l'automatisation peuvent être divisés en plusieurs couches :
- Systèmes externes (Jira, Bitbucket, etc.). Ils sont utilisés par les équipes de développement.
- Plateforme Integro. Les développeurs n'y travaillent généralement pas directement, mais elle soutient le bon fonctionnement de l'ensemble de l'automatisation.
- Services de déploiement, d'orchestration et de découverte (par exemple, Jenkins, Consul, Nomad). Grâce à eux, nous déployons le code sur les serveurs et garantissons la collaboration entre les services.
- Niveau physique (serveurs, systèmes d'exploitation, logiciels connexes). Notre code fonctionne à ce niveau. Cela peut être un serveur physique ou virtuel (LXC, KVM, Docker).
Sur la base de ce concept, nous délimitons les zones de responsabilité au sein de l'équipe DI. Les deux premiers niveaux relèvent de la direction du développement Integro, tandis que les deux derniers niveaux relèvent de la responsabilité de DevOps. Cette répartition permet de se concentrer sur les tâches sans interférer avec la collaboration, car nous sommes proches les uns des autres et échangeons constamment des connaissances et des expériences.
Integro
Focalisons-nous sur Integro et commençons par la pile technologique :
- CentOs 7
- Docker + Nomad + Consul + Vault
- Java 11 (l'ancien monolithe Integro restera sur Java 8)
- Spring Boot 2.X + Spring Cloud Config
- PostgreSql 11
- RabbitMQ
- Apache Ignite
- Camunda (embeddé)
- Grafana + Graphite + Prometheus + Jaeger + ELK
- UI Web : React (CSR) + MobX
- SSO : Keycloak
Nous nous en tenons au principe du développement microservices, bien que nous ayons également un héritage sous la forme d'un monolithe de l'ancienne version d'Integro. Chaque microservice fonctionne dans son propre conteneur Docker, les services communiquent entre eux via des requêtes HTTP et des messages RabbitMQ. Les microservices se trouvent mutuellement via Consul et envoient une requête à celui-ci, en passant par une autorisation via SSO (Keycloak, OAuth 2/OpenID Connect).
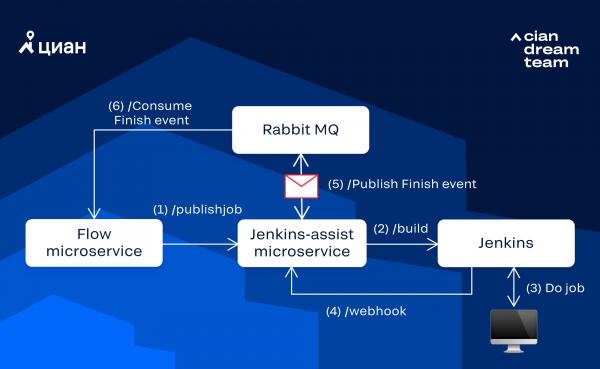
Prenons un exemple concret de l'interaction avec Jenkins, qui se compose des étapes suivantes :
- Le microservice de gestion des workflows (ci-après le microservice Flow) souhaite déclencher une build dans Jenkins. Pour cela, il trouve via Consul l'IP:PORT du microservice d'intégration avec Jenkins (ci-après le microservice Jenkins) et lui envoie une requête asynchrone pour lancer la build dans Jenkins.
- Le microservice Jenkins, après avoir reçu la requête, génère et renvoie un Job ID, par lequel il sera possible d'identifier le résultat du travail. En même temps, il déclenche la build dans Jenkins en appelant l'API REST.
- Jenkins exécute la build et, une fois terminée, envoie un webhook avec les résultats d'exécution au microservice Jenkins.
- Le microservice Jenkins, ayant reçu le webhook, forme un message sur la fin du traitement de la requête et y joint les résultats d'exécution. Le message ainsi formé est envoyé dans la file RabbitMQ.
- Via RabbitMQ, le message publié atteint le microservice Flow, qui prend connaissance du résultat du traitement de sa tâche en associant le Job ID de la requête au message reçu.
Nous avons actuellement environ 30 microservices, que l'on peut diviser en plusieurs groupes :
- Gestion des configurations.
- Information et interaction avec les utilisateurs (messageries, e-mails).
- Travail avec le code source.
- Intégration avec les outils de déploiement (Jenkins, Nomad, Consul, etc.).
- Surveillance (des releases, des erreurs, etc.).
- Outils web (interface pour gérer les environnements de test, collecter des statistiques, etc.).
- Intégration avec des gestionnaires de tâches et des systèmes similaires.
- Gestion des workflows pour différentes tâches.
Workflow de tâches
Integro automatise les actions liées au cycle de vie d'une tâche. De manière simplifiée, nous entendons par cycle de vie d'une tâche le workflow d'une tâche dans Jira. Dans nos processus de développement, il existe plusieurs variations de workflow en fonction du projet, du type de tâche et des options choisies dans une tâche spécifique.
Examinons le workflow que nous utilisons le plus souvent :
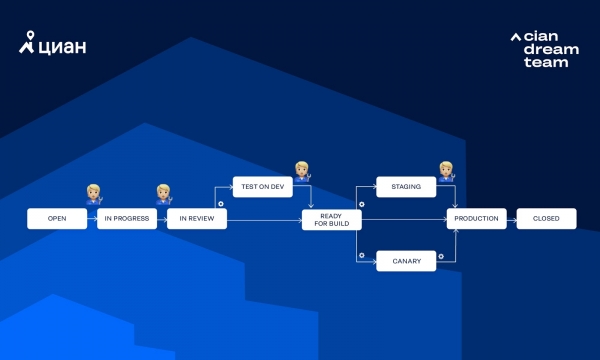
Dans le schéma, l'engrenage indique que la transition est déclenchée automatiquement par Integro, tandis que la figure humaine signifie que la transition est initiée manuellement par un utilisateur. Examinons plusieurs chemins par lesquels une tâche peut avancer dans ce workflow.
Tests totalement manuels sur DEV+BETA sans tests canary (c'est généralement ainsi que nous déployons le monolithe) :
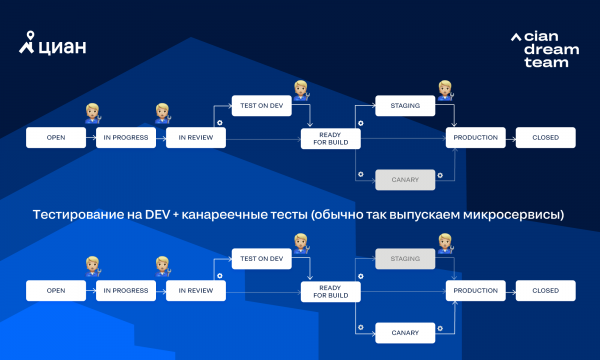
D'autres combinaisons de transitions peuvent également exister. Parfois, le chemin que prendra la tâche peut être choisi via des options dans Jira.
Déplacement de la tâche
Examinons les étapes principales réalisées lors du déplacement d'une tâche à travers le workflow « Testing on DEV + tests canaries » :
1. Le développeur ou le PM crée une tâche.
2. Le développeur prend la tâche en charge. Une fois terminée, elle est transférée au statut IN REVIEW.
3. Jira envoie un Webhook vers le microservice Jira (responsable de l'intégration avec Jira).
4. Le microservice Jira envoie une demande au service Flow (responsable des workflows internes où le travail est effectué) pour déclencher le workflow.
5. À l'intérieur du service Flow :
- Des réviseurs sont assignés à la tâche (microservice Users, qui connaît tout sur les utilisateurs + microservice Jira).
- Via le microservice Source (qui connaît les dépôts et les branches, mais ne travaille pas avec le code lui-même), une recherche est effectuée dans les dépôts où se trouve la branche de notre tâche (pour simplifier la recherche, le nom de la branche correspond au numéro de la tâche dans Jira). Dans la plupart des cas, une tâche n'a qu'une seule branche dans un seul dépôt, ce qui simplifie la gestion de la file d'attente pour le déploiement et réduit l'interdépendance entre les dépôts.
- Pour chaque branche trouvée, la séquence d'actions suivante est exécutée :
i) Fusion de la branche master (microservice Git pour travailler avec le code).
ii) La branche est verrouillée contre les modifications par le développeur (microservice Bitbucket).
iii) Une Pull Request est créée sur cette branche (microservice Bitbucket).
iv) Un message concernant la nouvelle Pull Request est envoyé dans les chats des développeurs (microservice Notify pour les notifications).
v) La construction, les tests et le déploiement de la tâche sur DEV sont lancés (microservice Jenkins pour travailler avec Jenkins).
vi) Si toutes les étapes précédentes se sont bien passées, Integro donne son approbation sur la Pull Request (microservice Bitbucket). - Integro attend l'approbation sur la Pull Request de la part des réviseurs désignés.
- Dès que toutes les approbations nécessaires sont obtenues (y compris les tests automatisés ayant réussi), Integro déplace la tâche vers le statut Test on Dev (microservice Jira).
6. Les testeurs effectuent des tests sur la tâche. S'il n'y a pas de problèmes, la tâche est transférée au statut Ready For Build.
7. Integro « voit » que la tâche est prête pour le déploiement et lance son déploiement en mode canari (microservice Jenkins). La readiness pour le déploiement est déterminée par un ensemble de règles. Par exemple, la tâche doit être dans le bon statut, il ne doit pas y avoir de blocages sur d'autres tâches, il n'y a pas de déploiements actifs de ce microservice, etc.
8. La tâche est transférée au statut Canary (microservice Jira).
9. Jenkins lance, via Nomad, le déploiement de la tâche en mode canari (généralement 1 à 3 instances) et informe le service de surveillance des déploiements (microservice DeployWatch) du déploiement.
10. Le microservice DeployWatch collecte le niveau d'erreur et y réagit si nécessaire. Si le niveau d'erreur dépasse le seuil (la norme est calculée automatiquement), une notification est envoyée aux développeurs via le microservice Notify. Si, après 5 minutes, le développeur ne réagit pas (en appuyant sur Revert ou Stay), un rollback automatique des instances canaries est effectué. Si le niveau d'erreur n'est pas dépassé, le développeur doit manuellement lancer le déploiement de la tâche en Production (en appuyant sur un bouton dans l'interface utilisateur). Si, dans les 60 minutes, le développeur n'a pas lancé le déploiement en Production, les instances canaries seront également retirées par mesure de sécurité.
11. Après le lancement du déploiement en Production :
- La tâche est transférée au statut Production (microservice Jira).
- Le microservice Jenkins lance le processus de déploiement et informe le microservice DeployWatch du déploiement.
- Le microservice DeployWatch vérifie que tous les conteneurs en Production ont été mis à jour (il y a eu des cas où ce n'était pas le cas).
- Une notification sur les résultats du déploiement en Production est envoyée via le microservice Notify.
12. Les développeurs disposeront de 30 minutes pour lancer un rollback de la tâche en Production en cas de comportement anormal du microservice. Passé ce délai, la tâche sera automatiquement intégrée dans master (microservice Git).
13. Après un merge réussi dans master, le statut de la tâche sera changé en Closed (microservice Jira).
Ce schéma ne prétend pas à une exhaustivité (il y a en réalité plus d'étapes), mais permet d'évaluer le degré d'intégration dans les processus. Nous ne considérons pas ce schéma comme parfait et nous améliorons les processus d'automatisation de la gestion des déploiements et des sorties.
Que faire ensuite
Nous avons de grands projets pour développer l'automatisation, tels que l'abandon des opérations manuelles lors des sorties du monolithe, l'amélioration du suivi lors du déploiement automatique, et l'optimisation de l'interaction avec les développeurs.
Mais nous nous arrêterons ici pour le moment. Nous avons survolé de nombreux sujets dans l'examen de l'automatisation, et certains n'ont même pas été abordés, donc nous serons heureux de répondre aux questions. Nous attendons vos suggestions sur ce qu'il serait bon de traiter en détail, n'hésitez pas à écrire dans les commentaires.
Source : habr.com
