

Si votre infrastructure IT croît trop rapidement, vous serez tôt ou tard confronté à un choix : augmenter linéairement les ressources humaines pour la soutenir ou commencer l'automatisation. Jusqu'à un certain point, nous avons vécu dans ce premier paradigme, puis a commencé un long chemin vers l'Infrastructure-as-Code.
Bien sûr, NSPK n'est pas une startup, mais c'est l'atmosphère qui régnait dans l'entreprise durant les premières années, et elles ont été très intéressantes. Je m'appelle , cela fait plus de 10 ans que je soutiens une infrastructure Linux avec des exigences de disponibilité élevées. J'ai rejoint l'équipe NSPK en janvier 2016 et, malheureusement, je n'ai pas connu le tout début de l'existence de l'entreprise, mais je suis arrivé à un moment de grands changements.
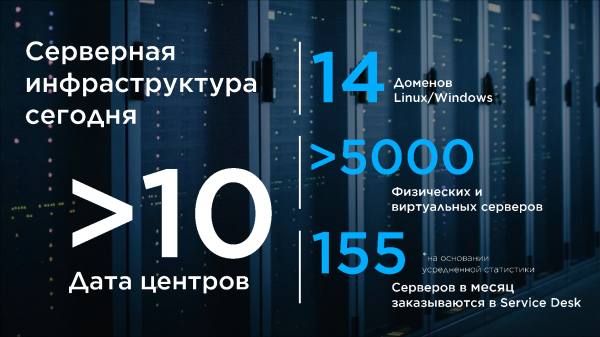
Dans l'ensemble, on peut dire que notre équipe fournit deux produits à l'entreprise. Le premier est l'infrastructure. Les e-mails doivent circuler, le DNS doit fonctionner, et les contrôleurs de domaine doivent vous permettre d'accéder à des serveurs qui ne doivent pas tomber. Le paysage IT de l'entreprise est immense ! Ce sont des systèmes critiques pour les affaires et les missions, et les exigences de disponibilité de certains atteignent 99,999. Le deuxième produit est constitué par les serveurs eux-mêmes, physiques et virtuels. Il faut surveiller ceux qui existent, et en fournir de nouveaux régulièrement aux clients dans de nombreux départements. Dans cet article, je souhaite me concentrer sur la manière dont nous avons développé l'infrastructure qui gère le cycle de vie. serveurs.
Le début du parcours
Au début, notre pile technologique ressemblait à ceci :
OS CentOS 7
Contrôleurs de domaine FreeIPA
Automatisation - Ansible(+Tower), Cobbler
Tout cela était réparti sur 3 domaines, dispersés sur plusieurs centres de données. Dans un centre de données se trouvaient les systèmes bureautiques et les environnements de test, dans les autres, la production.
La création de serveurs à un certain moment ressemblait à ceci :
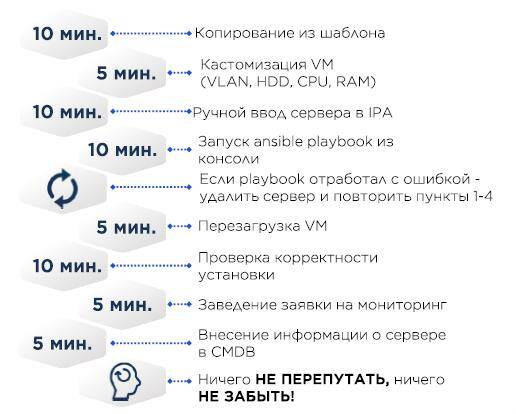
Dans le modèle VM CentOS minimal, le minimum nécessaire comme un correct /etc/resolv.conf, le reste arrive via Ansible.
CMDB - Excel.
Si le serveur est physique, au lieu de copier la machine virtuelle, on installait le système d'exploitation à l'aide de Cobbler - les adresses MAC du serveur cible étaient ajoutées à la configuration de Cobbler, le serveur obtenait une adresse IP via DHCP, et ensuite, le système d'exploitation était chargé.
Au début, nous avons même essayé de faire une gestion de configuration dans Cobbler. Mais avec le temps, cela a commencé à poser des problèmes de portabilité des configurations à la fois vers d'autres centres de données et dans le code Ansible pour la préparation des VM.
À l'époque, beaucoup d'entre nous percevaient Ansible comme une extension pratique de Bash et n'hésitaient pas à utiliser des constructions avec shell, sed. En gros, Bashsible. Cela menait finalement au fait que, si un playbook ne fonctionnait pas pour une raison quelconque sur le serveur, il était plus simple de supprimer le serveur, de corriger le playbook et de le faire passer à nouveau. Il n'y avait en fait aucune version des scripts, et la portabilité des configurations non plus.
Par exemple, si nous souhaitions modifier une certaine configuration sur tous les serveurs :
- Nous modifions la configuration sur les serveurs existants dans un segment logique / un datacenter. Parfois pas en un jour – les exigences de disponibilité et la loi des grands nombres ne permettent pas d'appliquer tous les changements d'un coup. Et certains changements peuvent être potentiellement destructeurs et nécessiter un redémarrage de quelque chose – des services jusqu'au système d'exploitation lui-même.
- Correction dans Ansible
- Correction dans Cobbler
- Répétons N fois pour chaque segment logique / datacenter
Pour que tous les changements se passent sans accroc, il était nécessaire de prendre en compte de nombreux facteurs, et les changements se produisent constamment.
- Refactorisation du code ansible, des fichiers de configuration
- Changement des meilleures pratiques internes
- Modifications suite à l'analyse d'incidents / pannes
- Changement des normes de sécurité, tant internes qu'externes. Par exemple, le PCI DSS est complété chaque année par de nouvelles exigences.
Croissance de l'infrastructure et début du parcours
Le nombre de serveurs / domaines logiques / datacenters a augmenté, tout comme le nombre d'erreurs dans les configurations. À un certain moment, nous sommes arrivés à trois directions vers lesquelles nous devions développer la gestion de configuration :
- Automatisation. Dans la mesure du possible, il faut éviter le facteur humain dans les opérations répétées.
- Répétabilité. Gérer l'infrastructure est beaucoup plus simple lorsqu'elle est prévisible. La configuration des serveurs et des outils pour leur préparation doit être la même partout. Cela est tout aussi important pour les équipes produits – l'application doit garantir qu'après les tests, elle arrive en production dans un environnement configuré de manière identique à celui de test.
- Simplicité et transparence dans l'apport de modifications à la gestion de configuration.
Il reste à ajouter quelques outils.
Comme dépôt de code, nous avons choisi GitLab CE, en partie pour ses modules CI/CD intégrés.
Dépôt de secrets – Hashicorp Vault, y compris pour son excellent API.
Tests de configurations et de rôles Ansible – Molecule+Testinfra. Les tests s'exécutent beaucoup plus rapidement lorsque vous utilisez mitogen avec Ansible. Parallèlement, nous avons commencé à écrire notre propre CMDB et un orchestrateur pour le déploiement automatique (comme indiqué sur l'image au-dessus de Cobbler), mais c'est une toute autre histoire, que mon collègue et chef de projet de ces systèmes racontera à l'avenir.
Notre choix :
Molecule + Testinfra
Ansible + Tower + AWX
World Servers + DITNET (Développement interne)
Cobbler
Gitlab + GitLab runner
Hashicorp Vault
À propos des rôles Ansible. Au départ, il n'y en avait qu'un, après plusieurs refactorisations, il y en a eu 17. Je recommande catégoriquement de diviser le monolithe en rôles idempotents, que l'on peut ensuite exécuter séparément. On peut également ajouter des tags. Nous avons divisé les rôles par fonctionnalité – réseau, journalisation, packages, matériel, moleculé, etc. En fait, nous avons respecté la stratégie suivante. Je ne prétends pas que c'est la vérité en une seule instance, mais cela a fonctionné pour nous.
- La copie de serveurs à partir d'une "image dorée" – c'est le mal !Parmi les principaux inconvénients – vous ne savez pas vraiment dans quel état sont les images actuellement, et que toutes les modifications seront appliquées à toutes les images dans toutes les fermes de virtualisation.
- Utilisez les fichiers de configuration par défaut au minimum et convenez avec les autres départements que vous êtes responsable des fichiers système principaux., par exemple :
- Laissez /etc/sysctl.conf vide, les paramètres doivent être uniquement dans /etc/sysctl.d/. Votre défaut dans un fichier, le personnalisé pour l'application dans un autre.
- Utilisez des fichiers d'override pour modifier les unités systemd.
- Templatez toutes les configs et déployez-les entièrement, évitez autant que possible les sed et autres analogues dans les playbooks.
- En refactorisant le code du système de gestion de configurations :
- Divisez les tâches en entités logiques et réécrivez le monolithe en rôles.
- Utilisez des linters ! Ansible-lint, yaml-lint, etc.
- Changez d'approche ! Pas de bashsible. Il faut décrire l'état du système.
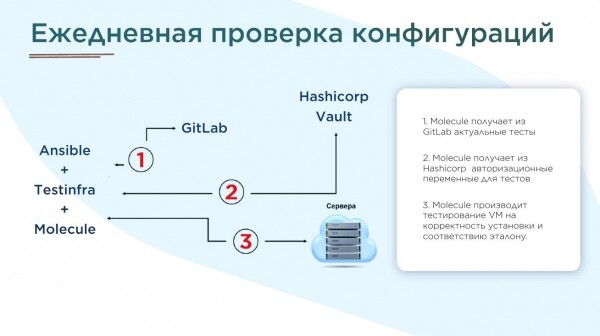
- Pour tous les rôles Ansible, des tests doivent être écrits dans Molecule et des rapports doivent être générés une fois par jour.
- Dans notre cas, après la préparation des tests (de plus de 100), environ 70000 erreurs ont été détectées. Nous avons corrigé cela pendant plusieurs mois.

Notre réalisation
Ainsi, les rôles Ansible étaient prêts, templatisés et vérifiés par des linters. Et même les dépôts git étaient actifs partout. Mais la question de la livraison fiable du code dans les différents segments restait ouverte. Nous avons décidé de synchroniser avec des scripts. Cela ressemble à :
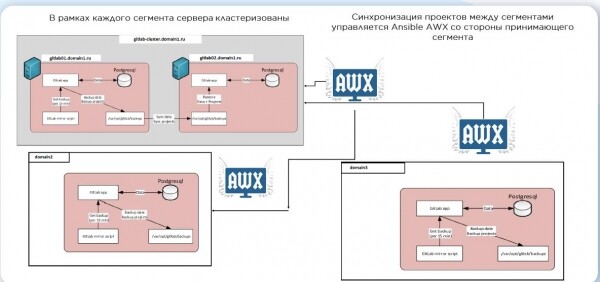
Une fois que le changement est arrivé, CI se lance, un serveur de test est créé, des rôles sont appliqués, et les tests sont effectués avec Molecule. Si tout va bien, le code est transféré vers la branche de production. Cependant, nous ne déployons pas le nouveau code sur les serveurs existants automatiquement. C'est une sorte de frein nécessaire pour maintenir la haute disponibilité de nos systèmes. Et lorsque l'infrastructure devient immense, la loi des grands nombres entre en jeu – même si vous êtes certain que le changement est inoffensif, il peut avoir des conséquences fâcheuses.
Il existe également de nombreuses options pour créer des serveurs. Nous avons finalement choisi des scripts personnalisés en Python. Et pour CI, Ansible :
- name: create1.yml - Créer une VM à partir d'un modèle
  vmware_guest:
    hostname: "{{datacenter}}".domain.fr
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.fr
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Voici où nous en sommes, le système continue de vivre et d'évoluer.
- 17 rôles Ansible pour la configuration des serveurs. Chacun des rôles est destiné à résoudre une tâche logique spécifique (journalisation, audit, authentification des utilisateurs, surveillance, etc.).
- Test des rôles. Molecule + TestInfra.
- Développement interne : CMDB + Orchestrateur.
- Temps de création d'un serveur ~30 minutes, automatisé et presque indépendant de la file des tâches.
- État/nom de l'infrastructure homogène dans tous les segments – playbooks, dépôts, éléments de virtualisation.
- Vérification quotidienne de l'état des serveurs avec génération de rapports sur les écarts avec la référence.
J'espère que mon récit sera utile à ceux qui débutent. Quel est votre stack d'automatisation ?
Source : habr.com
