

Dans cet article, je vais expliquer comment nous avons abordé la question de la résilience de PostgreSQL, pourquoi cela est devenu important pour nous et ce que nous avons finalement réalisé.
Nous avons un service à fort trafic : 2,5 millions d'utilisateurs à travers le monde, plus de 50 000 utilisateurs actifs chaque jour. Les serveurs sont hébergés sur Amazon dans une seule région en Irlande : nous avons en fonctionnement plus de 100 serveurs différents, dont près de 50 avec des bases de données.
L'intégralité de notre backend est une grande application monolithique stateful en Java, qui maintient une connexion websocket permanente avec le client. Lorsque plusieurs utilisateurs travaillent simultanément sur un même tableau, ils voient tous les changements en temps réel, car chaque changement est enregistré dans la base de données. Nous traitons environ 10 000 requêtes par seconde sur nos bases. En période de pointe, nous écrivons entre 80 000 et 100 000 requêtes par seconde dans Redis.
Pourquoi nous sommes passés de Redis à PostgreSQL
Au départ, notre service fonctionnait avec Redis, un magasin de type key-value qui stocke toutes les données en mémoire vive. de serveurs.
Avantages de Redis :
- Haute vitesse de réponse, car tout est stocké en mémoire ;
- Facilité de sauvegarde et de réplication.
Inconvénients de Redis pour nous :
- Pas de véritables transactions. Nous avons tenté de les simuler au niveau de notre application. Malheureusement, ce n'était pas toujours efficace et cela nécessitait d'écrire un code très complexe.
- Le volume de données est limité par la quantité de mémoire. En augmentant la quantité de données, la mémoire va croître, et finalement, nous atteindrons les caractéristiques de l'instance choisie, ce qui dans AWS nécessite de stopper notre service pour changer le type d'instance.
- Il est impératif de maintenir un niveau de latence bas, car nous avons un très grand nombre de requêtes. Le niveau de latence optimal pour nous est de 17 à 20 ms. Avec un niveau de 30 à 40 ms, nous obtenons des réponses tardives aux requêtes de notre application et une dégradation du service. Malheureusement, cela nous est arrivé en septembre 2018, lorsque l'une des instances avec Redis a inexplicablement connu une latence deux fois plus élevée que la normale. Pour résoudre le problème, nous avons arrêté le service au milieu de la journée pour une maintenance imprévue et remplacé l'instance Redis défaillante.
- Il est facile de rencontrer des incohérences de données même avec des erreurs mineures dans le code, et ensuite de passer beaucoup de temps à écrire du code pour corriger ces données.
Nous avons pris en compte les inconvénients et réalisé qu'il était nécessaire de passer à une solution plus adaptée, avec des transactions normales et une moindre dépendance à la latence. Nous avons mené une étude, analysé de nombreuses options et choisi PostgreSQL.
Nous migrons vers la nouvelle base de données depuis déjà 1,5 an et n'avons transféré qu'une petite partie des données, c'est pourquoi nous travaillons actuellement avec Redis et PostgreSQL en parallèle. Plus de détails sur les étapes de la migration et le basculement des données entre les bases de données sont décrits dans un article de mon collègue.
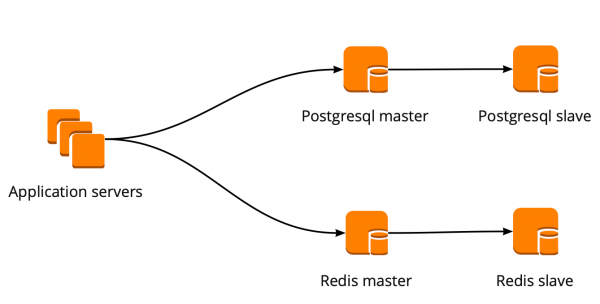
Lorsque nous avons commencé la migration, notre application interagissait directement avec la base de données en se connectant à Redis et PostgreSQL. Le cluster PostgreSQL était composé d'un maître et d'une réplique avec réplication asynchrone. Voici à quoi ressemblait le schéma de fonctionnement avec les bases :
Mise en œuvre de PgBouncer
Pendant que nous migrions, le produit évoluait également : le nombre d'utilisateurs et de serveurs utilisant PostgreSQL augmentait, et nous avons commencé à manquer de connexions. PostgreSQL crée un processus distinct pour chaque connexion, consommant des ressources. On peut augmenter le nombre de connexions jusqu'à un certain point, sinon il existe un risque de performances sous-optimales de la base de données. La meilleure solution dans cette situation est de choisir un gestionnaire de connexions qui se positionne devant la base.
Nous avions deux options pour le gestionnaire de connexions : Pgpool et PgBouncer. Cependant, le premier ne prend pas en charge le mode de travail transactionnel avec la base, donc nous avons choisi PgBouncer.
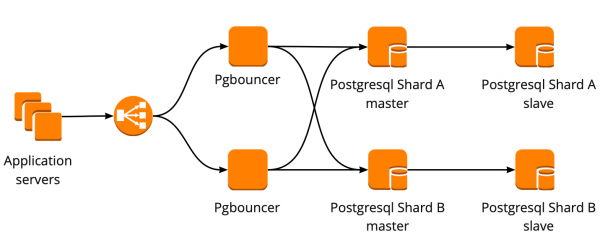
Nous avons configuré le schéma suivant : notre application se connecte à un PgBouncer, derrière lequel se trouvent les maîtres PostgreSQL, et derrière chaque maître se trouve une réplique avec réplication asynchrone.
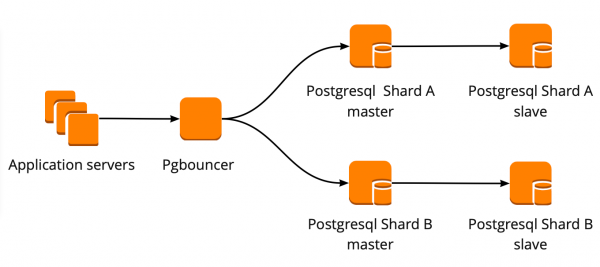
Dans le même temps, nous ne pouvions pas stocker tout le volume de données dans PostgreSQL, et la rapidité d'accès à la base était essentielle pour nous, c'est pourquoi nous avons commencé à shard PostgreSQL au niveau applicatif. Le schéma décrit ci-dessus est relativement pratique pour cela : lors de l'ajout d'un nouveau shard, il suffit de mettre à jour la configuration de PgBouncer et l'application peut directement travailler avec le nouveau shard.
Résilience de PgBouncer
Ce schéma a fonctionné jusqu'à ce que l'unique instance de PgBouncer tombe en panne. Nous sommes dans AWS, où toutes les instances fonctionnent sur du matériel qui tombe périodiquement. Dans de tels cas, l'instance est simplement transférée sur un nouveau matériel et fonctionne à nouveau. C'est ce qui est arrivé avec PgBouncer, cependant, il est devenu inaccessible. En conséquence, notre service a été indisponible pendant 25 minutes. AWS recommande d'utiliser la redondance côté utilisateur dans de telles situations, ce qui n'avait pas été mis en œuvre chez nous à ce moment-là.
Après cela, nous avons réfléchi sérieusement à la tolérance aux pannes de PgBouncer et des clusters PostgreSQL, car une telle situation pourrait se reproduire avec n'importe quelle instance de notre compte AWS.
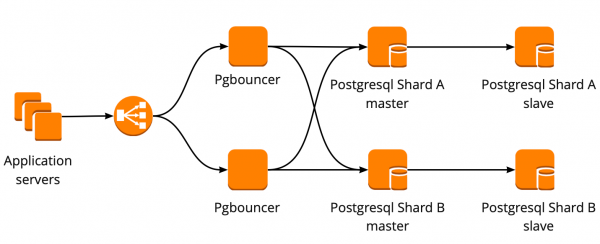
Nous avons construit le schéma de tolérance aux pannes de PgBouncer de la manière suivante : tous les serveurs d'application se connectent à un Network Load Balancer, derrière lequel se trouvent deux PgBouncer. Chacun des PgBouncer surveille les mêmes master PostgreSQL de chaque shard. En cas de répétition de la situation de panne d'une instance AWS, tout le trafic est redirigé via un autre PgBouncer. La tolérance aux pannes du Network Load Balancer est assurée par AWS.
Ce schéma permet d'ajouter facilement de nouveaux serveurs PgBouncer.
Création d'un cluster PostgreSQL tolérant aux pannes
Dans la résolution de cette tâche, nous avons examiné différentes options : failover fait maison, repmgr, AWS RDS, Patroni.
Scripts faits maison
Peuvent surveiller le fonctionnement du master et, en cas de panne, promouvoir la réplique au rang de master et mettre à jour la configuration de PgBouncer.
Les avantages de cette approche résident dans sa simplicité maximale, car vous écrivez vous-même les scripts et comprenez exactement comment ils fonctionnent.
Inconvénients :
- Le master n'a pas pu tomber en panne, il pourrait plutôt s'agir d'une défaillance réseau. Le failover, sans le savoir, va promouvoir la réplique au rang de master, tandis que l'ancien master continuera à fonctionner. En conséquence, nous aurons deux serveurs jouant le rôle de master et nous ne saurons pas lequel contient les dernières données actuelles. Cette situation est également appelée split-brain.
- Nous nous sommes retrouvés sans réplique. Dans notre configuration, le master et une réplique, après le basculement, la réplique est promue au rang de master et nous n'avons plus de répliques, donc nous devons ajouter manuellement une nouvelle réplique.
- Un suivi supplémentaire du fonctionnement du failover est nécessaire, sachant que nous avons 12 shards PostgreSQL, ce qui signifie que nous devons surveiller 12 clusters. Lors de l'augmentation du nombre de shards, il ne faut pas oublier de mettre à jour le failover.
Un failover fait maison semble très complexe et nécessite un support non trivial. Avec un seul cluster PostgreSQL, ce sera l'option la plus simple, mais elle n'est pas évolutive, donc elle ne nous convient pas.
Repmgr
Replication Manager pour les clusters PostgreSQL, qui gère le fonctionnement du cluster PostgreSQL. Cependant, il n'y a pas de failover automatique 'prêt à l'emploi', donc il sera nécessaire d'écrire notre propre 'wrapper' autour de la solution existante. Cela pourrait donc être encore plus compliqué que des scripts faits maison, c'est pourquoi nous n'avons même pas essayé Repmgr.
AWS RDS
Il prend en charge tout ce dont nous avons besoin, peut effectuer des sauvegardes et soutient un pool de connexions. Il a une bascule automatique : lorsque le maître meurt, la réplique devient le nouveau maître, et AWS change l'enregistrement DNS vers le nouveau maître, tout en permettant aux répliques d'être situées dans différentes AZ.
Parmi les inconvénients, on peut noter l'absence de réglages fins. Un exemple de réglages fins : sur nos instances, il y a des limitations pour les connexions TCP, ce qui, malheureusement, ne peut pas être fait dans RDS :
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
De plus, le prix de AWS RDS est presque deux fois plus élevé que le prix normal de l'instance, ce qui a été la principale raison de notre refus de cette solution.
Patroni
C'est un modèle en python pour gérer PostgreSQL avec une bonne documentation, un failover automatique et un code source sur github.
Les avantages de Patroni :
- Chaque paramètre de configuration est détaillé, il est clair comment tout fonctionne ;
- Le failover automatique fonctionne 'prêt à l'emploi' ;
- Écrit en python, et comme nous écrivons beaucoup en python, il nous sera plus facile de résoudre les problèmes et éventuellement de contribuer au développement du projet ;
- Gère complètement PostgreSQL, permet de changer la configuration sur tous les nœuds du cluster, et si un redémarrage du cluster est nécessaire pour appliquer une nouvelle configuration, cela peut également être fait avec l'aide de Patroni.
Inconvénients :
- Il n'est pas clair à partir de la documentation comment travailler correctement avec PgBouncer. Même si l'on peut difficilement appeler cela un inconvénient, car la mission de Patroni est de gérer PostgreSQL, et comment les connexions passeront par Patroni est notre problème.
- Il y a peu d'exemples d'implémentation de Patroni à grande échelle, alors qu'il y a de nombreux exemples d'implémentation à partir de zéro.
En fin de compte, pour créer un cluster résilient, nous avons choisi Patroni.
Le processus d'implémentation de Patroni
Avant Patroni, nous avions 12 shards PostgreSQL configurés avec un maître et une réplique en réplication asynchrone. Les serveurs d'application accédaient aux bases de données via un équilibreur de charge réseau, derrière lequel se trouvaient deux instances avec PgBouncer, et derrière elles se trouvaient tous les serveurs PostgreSQL.
Pour déployer Patroni, nous devions choisir un stockage de configuration de cluster distribué. Patroni fonctionne avec des systèmes de stockage de configuration distribués, tels qu'etcd, Zookeeper et Consul. Nous avons justement un cluster Consul pleinement fonctionnel sur notre production, qui travaille en lien avec Vault et que nous n'utilisons pas autrement. Une excellente occasion de commencer à utiliser Consul comme prévu.
Comment fonctionne Patroni avec Consul
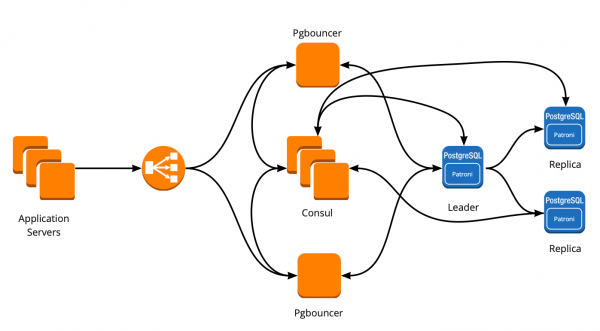
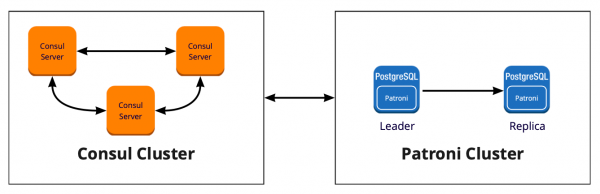
Nous avons un cluster Consul composé de trois nœuds et un cluster Patroni composé d'un leader et d'une réplique (dans Patroni, le maître est appelé leader du cluster, et les slaves sont appelés répliques). Chaque instance du cluster Patroni envoie en permanence des informations sur l'état du cluster à Consul. Par conséquent, il est toujours possible de connaître la configuration actuelle du cluster Patroni et qui est le leader en ce moment.
Pour connecter Patroni à Consul, il suffit de consulter la documentation officielle, qui indique qu'il est nécessaire de spécifier l'hôte au format http ou https selon notre mode d'interaction avec Consul, ainsi que le schéma de connexion, de manière optionnelle :
host : l'hôte:port pour le point de terminaison Consul, au format : http(s)://host:port
scheme : (optionnel) http ou https, par défaut http
Cela semble simple, mais c'est là que les pièges commencent. Avec Consul, nous travaillons par connexion sécurisée via https et notre configuration de connexion ressemblera à ceci :
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Mais cela ne fonctionne pas. Lors du démarrage, Patroni ne peut pas se connecter à Consul car il essaie toujours d'utiliser http.
Comprendre le problème a été facilité par le code source de Patroni. Heureusement, il est écrit en Python. Il s'avère que le paramètre host n'est pas analysé, et le protocole doit être spécifié dans le schéma. Voici à quoi ressemble le bloc de configuration fonctionnel pour fonctionner avec Consul chez nous :
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Nous avons donc choisi le stockage pour la configuration. Maintenant, il faut comprendre comment PgBouncer va changer sa configuration lors du changement de leader dans le cluster Patroni. La documentation ne répond pas à cette question, car elle ne décrit pas le fonctionnement avec PgBouncer.
À la recherche d'une solution, nous avons trouvé un article (je ne me souviens malheureusement pas du titre) qui mentionnait que Consul-template avait beaucoup aidé à relier PgBouncer et Patroni. Cela nous a poussés à explorer le fonctionnement de Consul-template.
Il s'est avéré que Consul-template surveille en permanence la configuration du cluster PostgreSQL dans Consul. Lors du changement de leader, il met à jour la configuration de PgBouncer et envoie la commande pour le redémarrer.
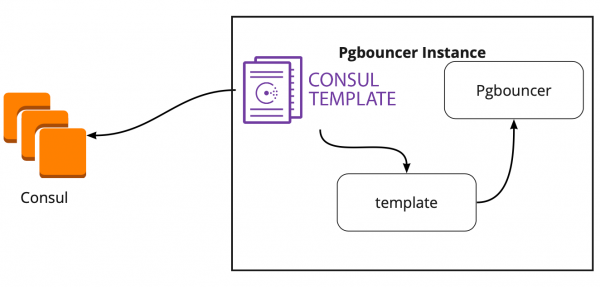
Un grand avantage du template est qu'il est stocké sous forme de code, donc lors de l'ajout d'une nouvelle shard, il suffit de faire un nouveau commit et de mettre à jour le template automatiquement, en respectant le principe de l'Infrastructure as code.
Nouvelle architecture avec Patroni
En conséquence, nous avons obtenu ce schéma de fonctionnement :
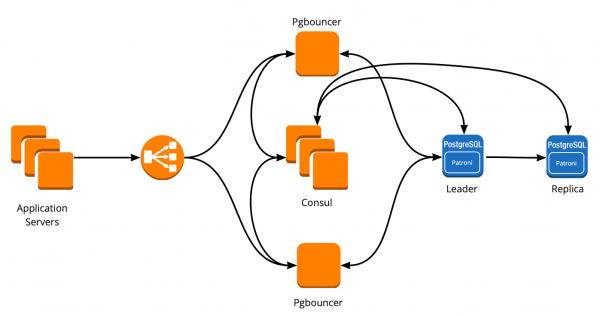
Tous les serveurs d'application se connectent au répartiteur de charge → derrière se trouvent deux instances PgBouncer → sur chaque instance, Consul-template est en cours d'exécution et surveille l'état de chaque cluster Patroni, tout en veillant à l'actualité de la config PgBouncer, qui dirige les requêtes vers le leader actuel de chaque cluster.
Test manuel
Avant de passer en production, nous avons lancé ce schéma sur un petit environnement de test et vérifié le fonctionnement du basculement automatique. Nous avons ouvert un tableau, déplacé un sticker et en même temps 'tuions' le leader du cluster. Dans AWS, il suffit d'éteindre l'instance via la console.
Le sticker revenait en arrière pendant 10 à 20 secondes, puis recommençait à se déplacer normalement. Cela signifie que le cluster Patroni a fonctionné correctement : il a changé de leader, a envoyé les informations à Consul, et Consul-template a immédiatement récupéré ces informations, remplacé la configuration de PgBouncer et envoyé la commande de rechargement.
Comment survivre à une forte charge tout en conservant un temps d'arrêt minimal ?
Tout fonctionne parfaitement ! Mais de nouvelles questions se posent : Comment cela fonctionnera-t-il sous charge élevée ? Comment déployer tout cela rapidement et en toute sécurité en production ?
Répondre à la première question nous aide à utiliser un environnement de test, sur lequel nous effectuons des tests de charge. Il est complètement identique à la production en termes d'architecture et dispose de données de test générées, dont le volume est à peu près égal à celui de la production. Nous décidons simplement de 'tuer' un des masters PostgreSQL pendant le test et de voir ce qui se passe. Mais avant cela, il est important de vérifier le déploiement automatique, car sur cet environnement, nous avons plusieurs shards PostgreSQL, ce qui nous donnera un excellent test des scripts de configuration avant la mise en production.
Les deux tâches semblent ambitieuses, mais nous avons PostgreSQL 9.6. Peut-être devrions-nous directement mettre à jour vers 11.2 ?
Nous avons décidé de le faire en 2 étapes : d'abord mettre à jour la version vers 11.2, puis lancer Patroni.
Mise à jour de PostgreSQL
Pour mettre à jour rapidement la version de PostgreSQL, il est nécessaire d'utiliser l'option -k, qui crée des liens physiques sur le disque et n'exige pas de copier vos données. Pour des bases d'une taille de 300 à 400 Go, la mise à jour ne prend qu'une seconde.
Nous avons beaucoup de shards, donc la mise à jour doit être effectuée de manière automatique. Pour cela, nous avons écrit un playbook Ansible qui exécute tout le processus de mise à jour pour nous :
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--lien </b>
--ancien-datadir='' --nouveau-datadir=''
 --ancien-bindir=''  --nouveau-bindir=''
 --anciennes-options=' -c fichier_config='
 --nouvelles-options=' -c fichier_config='
Il est important de noter qu'avant de lancer la mise à niveau, il est nécessaire de l'exécuter avec le paramètre —check, afin de s'assurer que la mise à niveau est possible. De plus, notre script effectue un remplacement des configurations pendant la mise à niveau. Notre script s'est exécuté en 30 secondes, ce qui est un excellent résultat.
Lancement de Patroni
Pour résoudre le deuxième problème, il suffit de jeter un œil à la configuration de Patroni. Dans le dépôt officiel, il y a un exemple de configuration avec initdb, qui est responsable de l'initialisation d'une nouvelle base lors du premier lancement de Patroni. Mais comme nous avons déjà une base prête, nous avons simplement supprimé cette section de la configuration.
Lorsque nous avons commencé à installer Patroni sur un cluster PostgreSQL déjà existant et à le démarrer, nous avons rencontré un nouveau problème : les deux serveurs se lançaient en tant que leader. Patroni ne sait rien de l'état précédent du cluster et essaie de lancer les deux serveurs comme deux clusters distincts avec le même nom. Pour résoudre ce problème, il est nécessaire de supprimer le répertoire des données sur le slave :
rm -rf /var/lib/postgresql/Cela doit être fait uniquement sur le slave !
Lorsque l'on connecte une réplique propre, Patroni effectue un basebackup du leader et le restaure sur la réplique, puis attrape l'état actuel à l'aide des journaux WAL.
Une autre difficulté que nous avons rencontrée est que tous les clusters PostgreSQL sont par défaut appelés main. Quand chaque cluster ne sait rien de l'autre, cela fonctionne. Mais lorsque vous souhaitez utiliser Patroni, tous les clusters doivent avoir un nom unique. La solution consiste à changer le nom du cluster dans la configuration PostgreSQL.
Test de charge
Nous avons lancé un test qui simule le comportement des utilisateurs sur les tableaux. Lorsque la charge a atteint notre moyenne quotidienne, nous avons répété exactement le même test en éteignant une instance avec le leader PostgreSQL. Le failover automatique a fonctionné comme nous l'attendions : Patroni a changé de leader, Consul-template a mis à jour la configuration de PgBouncer et a envoyé une commande de reload. Sur nos graphiques dans Grafana, nous avons constaté des retards de 20 à 30 secondes et un petit volume d'erreurs provenant des serveurs liées à la connexion à la base de données. C'est une situation normale, ces valeurs sont acceptables pour notre failover et clairement mieux qu'un temps d'arrêt du service.
Sortie de Patroni en production
En fin de compte, nous avons élaboré le plan suivant :
- Déploiement de Consul-template sur les serveurs PgBouncer et démarrage ;
- Mise à jour de PostgreSQL vers la version 11.2 ;
- Changement de nom du cluster ;
- Démarrage du cluster Patroni.
Notre schéma permet de réaliser le premier point à pratiquement tout moment, nous pouvons retirer chaque PgBouncer progressivement et procéder au déploiement et au démarrage de consul-template. C'est ce que nous avons fait.
Pour un déploiement rapide, nous avons utilisé Ansible, car tous les playbooks ont déjà été testés dans un environnement test, et le temps d'exécution du scénario complet était de 1,5 à 2 minutes pour chaque shard. Nous pouvions tout déployer progressivement sur chaque shard sans arrêter notre service, mais nous aurions dû éteindre chaque PostgreSQL pendant quelques minutes. Dans ce cas, les utilisateurs dont les données étaient sur ce shard n'auraient pas pu travailler pleinement durant ce temps, ce qui est inacceptable pour nous.
La solution à cette situation a été une maintenance planifiée, qui a lieu tous les 3 mois. C'est une fenêtre pour les travaux planifiés, lorsque nous arrêtons complètement notre service et mettons à jour les instances de bases de données. Il restait une semaine avant la prochaine fenêtre, et nous avons décidé d'attendre et de nous préparer davantage. Pendant cette période d'attente, nous avons également pris des précautions : pour chaque shard PostgreSQL, nous avons lancé une réplique de secours en cas d'échec, afin de conserver les dernières données, et ajouté une nouvelle instance pour chaque shard, qui devait devenir la nouvelle réplique dans le cluster Patroni, afin de ne pas exécuter la commande pour supprimer des données. Tout cela a contribué à réduire au maximum le risque d'erreur.
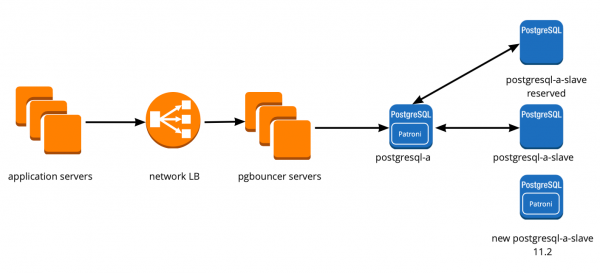
Nous avons redémarré notre service, tout a fonctionné comme prévu, les utilisateurs ont continué à travailler, mais sur les graphiques, nous avons observé une charge anormalement élevée sur les serveurs Consul.
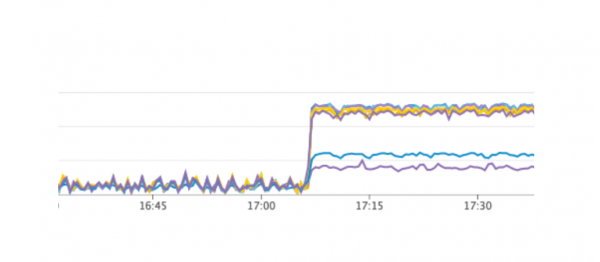
Pourquoi ne l'avons-nous pas remarqué dans l'environnement de test ? Ce problème illustre très bien qu'il est nécessaire de suivre le principe de l'Infrastructure as Code et d'améliorer toute l'infrastructure, depuis les environnements de test jusqu'à la production. Sinon, il est très facile d'obtenir un problème similaire à celui que nous avons rencontré. Que s'est-il passé ? Consul est d'abord apparu en production, puis dans les environnements de test, et au final, dans les environnements de test, la version de Consul était supérieure à celle de la production. En effet, dans l'une des versions, une fuite du CPU lors de l'utilisation de consul-template a été corrigée. Par conséquent, nous avons simplement mis à jour Consul, résolvant ainsi le problème.
Redémarrer le cluster Patroni
Cependant, nous avons rencontré un nouveau problème dont nous n'avions même pas soupçonné l'existence. Lors de la mise à jour de Consul, nous supprimons simplement le nœud Consul du cluster à l'aide de la commande consul leave → Patroni se connecte à un autre serveur Consul → tout fonctionne. Mais lorsque nous sommes arrivés à la dernière instance du cluster Consul et avons envoyé la commande consul leave, tous les clusters Patroni se sont simplement redémarrés, et dans les journaux, nous avons vu l'erreur suivante :
ERREUR : get_cluster
Traceback (appel le plus récent en dernier) :
...
RetryFailedError : 'Délai de nouvelle tentative dépassé'
ERREUR : Erreur de communication avec DCS
<b>LOG : le système de base de données est arrêté</b>
Le cluster Patroni n'a pas pu obtenir d'informations sur son cluster et s'est redémarré.
Pour trouver une solution, nous avons contacté les auteurs de Patroni via un problème sur github. Ils ont proposé des améliorations à nos fichiers de configuration :
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Nous avons pu reproduire le problème dans un environnement de test et y avons testé ces paramètres, mais malheureusement, ils n'ont pas fonctionné.
Le problème reste encore non résolu. Nous prévoyons d'essayer les options suivantes :
- Utiliser l'agent Consul sur chaque instance du cluster Patroni ;
- Corriger le problème dans le code.
Nous comprenons d'où vient l'erreur : il semble que le problème provienne de l'utilisation du timeout par défaut, qui n'est pas redéfini dans le fichier de configuration. Lorsque le dernier serveur Consul est supprimé du cluster, l'ensemble du cluster Consul se fige pendant plus d'une seconde, ce qui empêche Patroni d'obtenir l'état du cluster et redémarre complètement le cluster.
Heureusement, nous n'avons pas rencontré d'autres erreurs.
Bilan de l'utilisation de Patroni
Après le démarrage réussi de Patroni, nous avons ajouté une réplique supplémentaire dans chaque cluster. Maintenant, chaque cluster dispose d'un semblant de quorum : un leader et deux répliques, afin de se prémunir contre le split-brain lors du basculement.
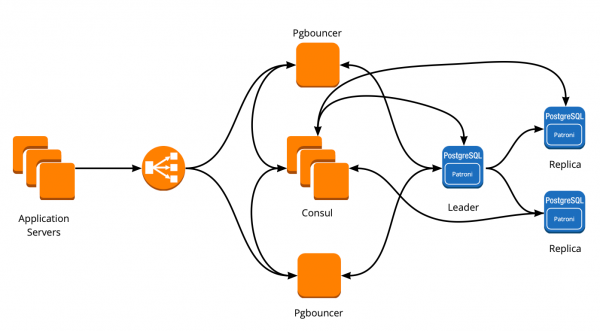
Dans l'environnement de production, Patroni fonctionne depuis plus de trois mois. Pendant ce temps, il a déjà été d'une grande aide. Récemment, le leader d'un des clusters est tombé en panne sur AWS, le basculement automatique a fonctionné et les utilisateurs ont pu continuer à travailler. Patroni a rempli sa tâche principale.
Petit bilan de l'utilisation de Patroni :
- Facilité de modification de la configuration. Il suffit de modifier la configuration sur une instance et elle sera appliquée à tout le cluster. Si un redémarrage est nécessaire pour appliquer la nouvelle configuration, Patroni vous informera. Patroni peut redémarrer tout le cluster en une seule commande, ce qui est également très pratique.
- Le basculement automatique fonctionne et a déjà réussi à nous dépanner.
- Mise à jour de PostgreSQL sans temps d'arrêt de l'application. Il est nécessaire de mettre d'abord à jour les répliques vers la nouvelle version, puis de changer le leader dans le cluster Patroni et de mettre à jour l'ancien leader. Un test du basculement automatique est également effectué.
Source : habr.com
