

, destinée à collecter, transformer et envoyer des données de journaux, de métriques et d'événements.
→
Écrite en Rust, elle offre une haute performance et une faible consommation de mémoire par rapport aux alternatives. De plus, une grande attention est portée aux fonctionnalités liées à la fiabilité, notamment la possibilité de mettre en mémoire tampon les événements non envoyés sur le disque et la rotation des fichiers.
Architecturalement, Vector est un routeur d'événements qui reçoit des messages d'une ou plusieurs sources, appliquant éventuellement des transformations, et les envoyant vers une ou plusieurs sorties.
Vector est un remplacement de filebeat et logstash, il peut jouer les deux rôles (recevoir et envoyer des journaux), plus de détails sur leur .
Si dans Logstash, la chaîne est construite comme input → filter → output, alors dans Vector c'est → →
Des exemples peuvent être consultés dans la documentation.
Ce guide est une version retravaillée du guide de . Dans le guide original, il y a un traitement geoip. Lors de mes tests geoip depuis un réseau interne, vector a généré une erreur.
Aug 05 06:25:31.889 DEBUG transform{name=nginx_parse_rename_fields type=rename_fields}: vector::transforms::rename_fields: Le champ n'existe pas field=«geoip.country_name» rate_limit_secs=30Si quelqu'un a besoin de traiter geoip, veuillez vous référer au guide original de .
Nous allons configurer la chaîne Nginx (Access logs) → Vector (Client | Filebeat) → Vector (Server | Logstash) → séparément dans Clickhouse et séparément Elasticsearch. Nous allons installer 4 serveurs. Bien que 3 serveurs suffisent.
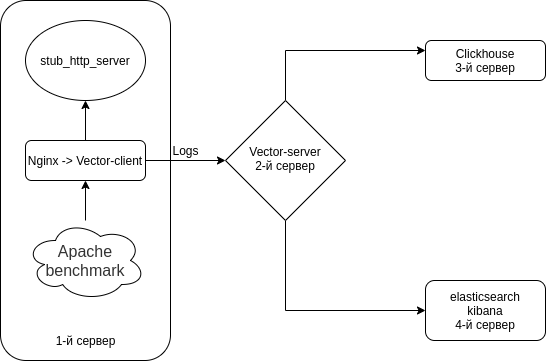
Le schéma est environ le suivant.
Nous désactivons Selinux sur tous vos serveurs
sed -i 's/^SELINUX=.* /SELINUX=disabled/g' /etc/selinux/config
reboot
Nous installons un émulateur de serveur HTTP + des utilitaires sur tous les serveurs
Nous allons utiliser comme émulateur de serveur HTTP à partir de
Nodejs-stub-server n'a pas de rpm. nous lui créons un rpm. Le rpm sera construit avec
Ajoutons le dépôt antonpatsev/nodejs-stub-server
yum -y install yum-plugin-copr epel-release
yes | yum copr enable antonpatsev/nodejs-stub-server
Nous installons nodejs-stub-server, Apache benchmark et le multiplexeur de terminal screen sur tous les serveurs
yum -y install stub_http_server screen mc httpd-tools screenJ'ai corrigé dans le fichier /var/lib/stub_http_server/stub_http_server.js le temps de réponse de stub_http_server pour avoir plus de journaux.
var max_sleep = 10;Lançons stub_http_server.
systemctl start stub_http_server
systemctl enable stub_http_serversur le 3ème serveur
ClickHouse utilise un ensemble d'instructions SSE 4.2, donc, sauf indication contraire, la prise en charge de celle-ci par le processeur utilisé devient une exigence supplémentaire pour le système. Voici la commande pour vérifier si le processeur actuel prend en charge SSE 4.2:
grep -q sse4_2 /proc/cpuinfo && echo "SSE 4.2 pris supporté" || echo "SSE 4.2 non supporté"Tout d'abord, il faut connecter le dépôt officiel :
sudo yum install -y yum-utils
sudo rpm --import https://repo.clickhouse.tech/CLICKHOUSE-KEY.GPG
sudo yum-config-manager --add-repo https://repo.clickhouse.tech/rpm/stable/x86_64
Pour installer les packages, il est nécessaire d'exécuter les commandes suivantes :
sudo yum install -y clickhouse-server clickhouse-clientNous autorisons clickhouse-server à écouter sur la carte réseau dans le fichier /etc/clickhouse-server/config.xml
0.0.0.0Nous changeons le niveau de logging de trace à debug
debug
Les paramètres de compression par défaut sont :
min_compress_block_size  65536
max_compress_block_size  1048576
Pour activer la compression Zstd, il est conseillé de ne pas toucher au config, mais plutôt d'appliquer le DDL.
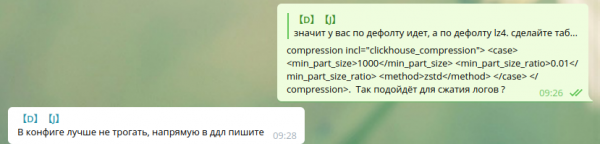
Je n'ai pas trouvé comment appliquer la compression zstd via DDL sur Google. Donc je l'ai laissé tel quel.
Collègues, ceux qui utilisent la compression zstd dans Clickhouse — merci de partager les instructions.
Pour démarrer le serveur en tant que démon, exécutez :
service clickhouse-server startPassons maintenant à la configuration de Clickhouse
Accédons à Clickhouse
clickhouse-client -h 172.26.10.109 -m172.26.10.109 — IP du serveur où Clickhouse est installé.
Créons la base de données vector
CREATE DATABASE vector;Vérifions que la base de données existe.
show databases;Créons la table vector.logs.
/* Это таблица где хранятся логи как есть */

CREATE TABLE vector.logs
(
    `node_name` String,
    `timestamp` DateTime,
    `server_name` String,
    `user_id` String,
    `request_full` String,
    `request_user_agent` String,
    `request_http_host` String,
    `request_uri` String,
    `request_scheme` String,
    `request_method` String,
    `request_length` UInt64,
    `request_time` Float32,
    `request_referrer` String,
    `response_status` UInt16,
    `response_body_bytes_sent` UInt64,
    `response_content_type` String,
    `remote_addr` IPv4,
    `remote_port` UInt32,
    `remote_user` String,
    `upstream_addr` IPv4,
    `upstream_port` UInt32,
    `upstream_bytes_received` UInt64,
    `upstream_bytes_sent` UInt64,
    `upstream_cache_status` String,
    `upstream_connect_time` Float32,
    `upstream_header_time` Float32,
    `upstream_response_length` UInt64,
    `upstream_response_time` Float32,
    `upstream_status` UInt16,
    `upstream_content_type` String,
    INDEX idx_http_host request_http_host TYPE set(0) GRANULARITY 1
)
ENGINE = MergeTree()
PARTITION BY toYYYYMMDD(timestamp)
ORDER BY timestamp
TTL timestamp + toIntervalMonth(1)
SETTINGS index_granularity = 8192;
Vérifions que les tables ont été créées. Exécutons clickhouse-client et faisons une requête.
Passons à la base de données vector.
use vector;

Ok.

0 rows in set. Elapsed: 0.001 sec.
Voyons les tables.
show tables;

┌─name────────────────┐
│ logs                │
└─────────────────────┘
Installation d'elasticsearch sur le 4ème serveur pour envoyer les mêmes données vers Elasticsearch pour comparaison avec Clickhouse
Ajoutons la clé publique rpm
rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearchCréons 2 dépôts :
/etc/yum.repos.d/elasticsearch.repo
[elasticsearch]
name=Elasticsearch repository for 7.x packages
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=0
autorefresh=1
type=rpm-md
/etc/yum.repos.d/kibana.repo
[kibana-7.x]
name=Kibana repository for 7.x packages
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
Installons elasticsearch et kibana
yum install -y kibana elasticsearchPuisqu'il y aura une seule instance, il faut ajouter dans le fichier /etc/elasticsearch/elasticsearch.yml :
discovery.type: single-nodePour que vector puisse envoyer des données à elasticsearch depuis un autre serveur, modifions network.host.
network.host: 0.0.0.0Pour se connecter à kibana, modifions le paramètre server.host dans le fichier /etc/kibana/kibana.yml
server.host: "0.0.0.0"Nous démarrons et activons elasticsearch au démarrage
systemctl enable elasticsearch
systemctl start elasticsearch
et kibana
systemctl enable kibana
systemctl start kibana
Configuration d'Elasticsearch pour le mode single-node 1 shard, 0 replica. Il est probable que vous ayez un cluster constitué d'un grand nombre de serveurs et que vous n'ayez pas besoin de faire cela.
Pour les futurs index, nous mettons à jour le modèle par défaut :
curl -X PUT http://localhost:9200/_template/default -H 'Content-Type: application/json' -d '{"index_patterns": ["*"],"order": -1,"settings": {"number_of_shards": "1","number_of_replicas": "0"}}' Installation comme remplacement de Logstash sur le 2ème serveur
yum install -y https://packages.timber.io/vector/0.9.X/vector-x86_64.rpm mc httpd-tools screenConfigurons Vector comme remplacement de Logstash. Éditons le fichier /etc/vector/vector.toml
# /etc/vector/vector.toml

data_dir = "/var/lib/vector"

[sources.nginx_input_vector]
  # General
  type                          = "vector"
  address                       = "0.0.0.0:9876"
  shutdown_timeout_secs         = 30

[transforms.nginx_parse_json]
  inputs                        = [ "nginx_input_vector" ]
  type                          = "json_parser"

[transforms.nginx_parse_add_defaults]
  inputs                        = [ "nginx_parse_json" ]
  type                          = "lua"
  version                       = "2"

  hooks.process = """
  function (event, emit)

    function split_first(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[1];
    end

    function split_last(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[#result];
    end

    event.log.upstream_addr             = split_first(split_last(event.log.upstream_addr, ', '), ':')
    event.log.upstream_bytes_received   = split_last(event.log.upstream_bytes_received, ', ')
    event.log.upstream_bytes_sent       = split_last(event.log.upstream_bytes_sent, ', ')
    event.log.upstream_connect_time     = split_last(event.log.upstream_connect_time, ', ')
    event.log.upstream_header_time      = split_last(event.log.upstream_header_time, ', ')
    event.log.upstream_response_length  = split_last(event.log.upstream_response_length, ', ')
    event.log.upstream_response_time    = split_last(event.log.upstream_response_time, ', ')
    event.log.upstream_status           = split_last(event.log.upstream_status, ', ')

    if event.log.upstream_addr == "" then
        event.log.upstream_addr = "127.0.0.1"
    end

    if (event.log.upstream_bytes_received == "-" or event.log.upstream_bytes_received == "") then
        event.log.upstream_bytes_received = "0"
    end

    if (event.log.upstream_bytes_sent == "-" or event.log.upstream_bytes_sent == "") then
        event.log.upstream_bytes_sent = "0"
    end

    if event.log.upstream_cache_status == "" then
        event.log.upstream_cache_status = "DISABLED"
    end

    if (event.log.upstream_connect_time == "-" or event.log.upstream_connect_time == "") then
        event.log.upstream_connect_time = "0"
    end

    if (event.log.upstream_header_time == "-" or event.log.upstream_header_time == "") then
        event.log.upstream_header_time = "0"
    end

    if (event.log.upstream_response_length == "-" or event.log.upstream_response_length == "") then
        event.log.upstream_response_length = "0"
    end

    if (event.log.upstream_response_time == "-" or event.log.upstream_response_time == "") then
        event.log.upstream_response_time = "0"
    end

    if (event.log.upstream_status == "-" or event.log.upstream_status == "") then
        event.log.upstream_status = "0"
    end

    emit(event)

  end
  """

[transforms.nginx_parse_remove_fields]
    inputs                              = [ "nginx_parse_add_defaults" ]
    type                                = "remove_fields"
    fields                              = ["data", "file", "host", "source_type"]

[transforms.nginx_parse_coercer]

    type                                = "coercer"
    inputs                              = ["nginx_parse_remove_fields"]

    types.request_length = "int"
    types.request_time = "float"

    types.response_status = "int"
    types.response_body_bytes_sent = "int"

    types.remote_port = "int"

    types.upstream_bytes_received = "int"
    types.upstream_bytes_send = "int"
    types.upstream_connect_time = "float"
    types.upstream_header_time = "float"
    types.upstream_response_length = "int"
    types.upstream_response_time = "float"
    types.upstream_status = "int"

    types.timestamp = "timestamp"

[sinks.nginx_output_clickhouse]
    inputs   = ["nginx_parse_coercer"]
    type     = "clickhouse"

    database = "vector"
    healthcheck = true
    host = "http://172.26.10.109:8123" #  Адрес Clickhouse
    table = "logs"

    encoding.timestamp_format = "unix"

    buffer.type = "disk"
    buffer.max_size = 104900000
    buffer.when_full = "block"

    request.in_flight_limit = 20

[sinks.elasticsearch]
    type = "elasticsearch"
    inputs   = ["nginx_parse_coercer"]
    compression = "none"
    healthcheck = true
    # 172.26.10.116 - сервер где установен elasticsearch
    host = "http://172.26.10.116:9200"
    index = "vector-%Y-%m-%d"
Vous pouvez modifier la section transforms.nginx_parse_add_defaults.
Puisque utilise ces configurations pour un petit CDN et là-dedans, en upstream_*, plusieurs valeurs peuvent arriver
Par exemple :
"upstream_addr": "128.66.0.10:443, 128.66.0.11:443, 128.66.0.12:443"
"upstream_bytes_received": "-, -, 123"
"upstream_status": "502, 502, 200"
Si ce n'est pas votre situation, vous pouvez simplifier cette section.
Créons les configurations de service pour systemd /etc/systemd/system/vector.service
# /etc/systemd/system/vector.service

[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=/usr/bin/vector
ExecReload=/bin/kill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
Après avoir créé les tables, vous pouvez démarrer Vector
systemctl enable vector
systemctl start vector
Vous pouvez consulter les logs de vector de cette manière
journalctl -f -u vectorLes logs doivent contenir les enregistrements suivants
INFO vector::topology::builder: Vérification de santé : Réussie.
INFO vector::topology::builder: Vérification de santé : Réussie.
Sur le client (Serveur Web) — 1er serveur
Sur le serveur avec nginx, il est nécessaire de désactiver ipv6, car dans la table logs de clickhouse, le champ upstream_addr est en IPv4, car je n'utilise pas ipv6 à l'intérieur du réseau. Si ipv6 n'est pas désactivé, il y aura des erreurs :
DB::Exception: Valeur IPv4 invalide : (en lisant la valeur de la clé upstream_addr)Peut-être que les lecteurs, devraient ajouter la prise en charge de ipv6.
Créons le fichier /etc/sysctl.d/98-disable-ipv6.conf
net.ipv6.conf.all.disable_ipv6 = 1
net.ipv6.conf.default.disable_ipv6 = 1
net.ipv6.conf.lo.disable_ipv6 = 1
Appliquons les réglages
sysctl --systemInstallons nginx.
Ajout du fichier de référentiel nginx /etc/yum.repos.d/nginx.repo
[nginx-stable]
name=référentiel stable nginx
baseurl=http://nginx.org/packages/centos/$releasever/$basearch/
gpgcheck=1
enabled=1
gpgkey=https://nginx.org/keys/nginx_signing.key
module_hotfixes=true
Installons le paquet nginx
yum install -y nginxPour commencer, nous devons configurer le format des logs dans Nginx dans le fichier /etc/nginx/nginx.conf
utilisateur nginx;
# vous devez définir les processus de travail en fonction de vos cœurs CPU, nginx ne bénéficie pas de la définition de plus que cela
worker_processes auto; # certaines dernières versions le calculent automatiquement

# nombre de descripteurs de fichiers utilisés pour nginx
# la limite maximale des FD sur le serveur est généralement définie par le système d'exploitation.
# si vous ne définissez pas les FD, les paramètres du système d'exploitation seront utilisés, qui sont par défaut 2000
worker_rlimit_nofile 100000;

error_log  /var/log/nginx/error.log warn;
pid        /var/run/nginx.pid;

# fournit le contexte du fichier de configuration dans lequel les directives qui affectent le traitement des connexions sont spécifiées.
events {
    # détermine combien de clients seront servis par worker
    # clients max = worker_connections * worker_processes
    # les clients max sont également limités par le nombre de connexions socket disponibles sur le système (~64k)
    worker_connections 4000;

    # optimisé pour servir de nombreux clients avec chaque thread, essentiel pour linux -- pour environnement de test
    use epoll;

    # acceptez autant de connexions que possible, peut inonder les connexions de travail si défini trop bas -- pour environnement de test
    multi_accept on;
}

http {
    include       /etc/nginx/mime.types;
    default_type  application/octet-stream;

    log_format  main  '$remote_addr - $remote_user [$time_local] "$request" '
                      '$status $body_bytes_sent "$http_referer" '
                      '"$http_user_agent" "$http_x_forwarded_for"';

log_format vector escape=json
    '{'
        '"node_name":"nginx-vector",'
        '"timestamp":"$time_iso8601",'
        '"server_name":"$server_name",'
        '"request_full": "$request",'
        '"request_user_agent":"$http_user_agent",'
        '"request_http_host":"$http_host",'
        '"request_uri":"$request_uri",'
        '"request_scheme": "$scheme",'
        '"request_method":"$request_method",'
        '"request_length":"$request_length",'
        '"request_time": "$request_time",'
        '"request_referrer":"$http_referer",'
        '"response_status": "$status",'
        '"response_body_bytes_sent":"$body_bytes_sent",'
        '"response_content_type":"$sent_http_content_type",'
        '"remote_addr": "$remote_addr",'
        '"remote_port": "$remote_port",'
        '"remote_user": "$remote_user",'
        '"upstream_addr": "$upstream_addr",'
        '"upstream_bytes_received": "$upstream_bytes_received",'
        '"upstream_bytes_sent": "$upstream_bytes_sent",'
        '"upstream_cache_status":"$upstream_cache_status",'
        '"upstream_connect_time":"$upstream_connect_time",'
        '"upstream_header_time":"$upstream_header_time",'
        '"upstream_response_length":"$upstream_response_length",'
        '"upstream_response_time":"$upstream_response_time",'
        '"upstream_status": "$upstream_status",'
        '"upstream_content_type":"$upstream_http_content_type"'
    '}';

    access_log  /var/log/nginx/access.log  main;
    access_log  /var/log/nginx/access.json.log vector;      # Nouveau log au format json

    sendfile        on;
    #tcp_nopush     on;

    keepalive_timeout  65;

    #gzip  on;

    include /etc/nginx/conf.d/*.conf;
}
Pour ne pas casser votre configuration actuelle, Nginx permet d'avoir plusieurs directives access_log
access_log  /var/log/nginx/access.log  main;            # Log standard
access_log  /var/log/nginx/access.json.log vector;      # Nouveau log au format json
N'oubliez pas d'ajouter une règle dans logrotate pour les nouveaux logs (si le fichier log ne se termine pas par .log)
Supprimez default.conf de /etc/nginx/conf.d/
rm -f /etc/nginx/conf.d/default.confAjoutez un hôte virtuel /etc/nginx/conf.d/vhost1.conf
server {
    listen 80;
    server_name vhost1;
    location / {
        proxy_pass http://172.26.10.106:8080;
    }
}
Ajout d'un hôte virtuel /etc/nginx/conf.d/vhost2.conf
server {
    listen 80;
    server_name vhost2;
    location / {
        proxy_pass http://172.26.10.108:8080;
    }
}
Ajout d'un hôte virtuel /etc/nginx/conf.d/vhost3.conf
server {
    listen 80;
    server_name vhost3;
    location / {
        proxy_pass http://172.26.10.109:8080;
    }
}
Ajout d'un hôte virtuel /etc/nginx/conf.d/vhost4.conf
server {
    listen 80;
    server_name vhost4;
    location / {
        proxy_pass http://172.26.10.116:8080;
    }
}
Ajout des hôtes virtuels dans le fichier /etc/hosts (172.26.10.106 est l'IP du serveur où Nginx est installé) sur tous les serveurs :
172.26.10.106 vhost1
172.26.10.106 vhost2
172.26.10.106 vhost3
172.26.10.106 vhost4
Et si tout est prêt alors
nginx -t
systemctl restart nginx
Maintenant, installons-le
yum install -y https://packages.timber.io/vector/0.9.X/vector-x86_64.rpmCréons le fichier de configuration pour systemd /etc/systemd/system/vector.service
[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=/usr/bin/vector
ExecReload=/bin/kill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
Et configurons le remplacement de Filebeat dans le fichier /etc/vector/vector.toml. L'adresse IP 172.26.10.108 est celle du serveur de logs (Vector-Server)
data_dir = "/var/lib/vector"

[sources.nginx_file]
  type                          = "file"
  include                       = [ "/var/log/nginx/access.json.log" ]
  start_at_beginning            = false
  fingerprinting.strategy       = "device_and_inode"

[sinks.nginx_output_vector]
  type                          = "vector"
  inputs                        = [ "nginx_file" ]

  address                       = "172.26.10.108:9876"
N'oubliez pas d'ajouter l'utilisateur vector au groupe nécessaire pour qu'il puisse lire les fichiers de logs. Par exemple, Nginx sous CentOS crée des logs avec les droits du groupe adm.
usermod -a -G adm vectorLançons le service vector
systemctl enable vector
systemctl start vector
Vous pouvez consulter les logs de vector de cette manière
journalctl -f -u vectorLes logs doivent contenir cette entrée
INFO vector::topology::builder: Healthcheck: Passed.Test de charge
Nous effectuons des tests avec Apache benchmark.
Le paquet httpd-tools a été installé sur tous les serveurs
Nous lançons les tests avec Apache benchmark depuis 4 serveurs différents dans screen. D'abord, nous démarrons le multiplexeur terminal screen, puis nous exécutons les tests avec Apache benchmark. Vous pouvez trouver comment utiliser screen dans .
Depuis le 1er serveur
while true; do ab -H "User-Agent: 1server" -c 100 -n 10 -t 10 http://vhost1/; sleep 1; doneDepuis le 2e serveur
while true; do ab -H "User-Agent: 2server" -c 100 -n 10 -t 10 http://vhost2/; sleep 1; doneDepuis le 3e serveur
while true; do ab -H "User-Agent: 3server" -c 100 -n 10 -t 10 http://vhost3/; sleep 1; doneDepuis le 4e serveur
while true; do ab -H "User-Agent: 4server" -c 100 -n 10 -t 10 http://vhost4/; sleep 1; doneVérifions les données dans Clickhouse
Accédons à Clickhouse
clickhouse-client -h 172.26.10.109 -mFaisons une requête SQL
SELECT * FROM vector.logs;

┌─node_name────┬───────────timestamp─┬─server_name─┬─user_id─┬─request_full───┬─request_user_agent─┬─request_http_host─┬─request_uri─┬─request_scheme─┬─request_method─┬─request_length─┬─request_time─┬─request_referrer─┬─response_status─┬─response_body_bytes_sent─┬─response_content_type─┬───remote_addr─┬─remote_port─┬─remote_user─┬─upstream_addr─┬─upstream_port─┬─upstream_bytes_received─┬─upstream_bytes_sent─┬─upstream_cache_status─┬─upstream_connect_time─┬─upstream_header_time─┬─upstream_response_length─┬─upstream_response_time─┬─upstream_status─┬─upstream_content_type─┐
│ nginx-vector │ 2020-08-07 04:32:42 │ vhost1      │         │ GET / HTTP/1.0 │ 1server            │ vhost1            │ /           │ http           │ GET            │             66 │        0.028 │                  │             404 │                       27 │                       │ 172.26.10.106 │       45886 │             │ 172.26.10.106 │             0 │                     109 │                  97 │ DISABLED              │                     0 │                0.025 │                       27 │                  0.029 │             404 │                       │
└──────────────┴─────────────────────┴─────────────┴─────────┴────────────────┴────────────────────┴───────────────────┴─────────────┴────────────────┴────────────────┴────────────────┴──────────────┴──────────────────┴─────────────────┴──────────────────────────┴───────────────────────┴───────────────┴─────────────┴─────────────┴───────────────┴───────────────┴─────────────────────────┴─────────────────────┴───────────────────────┴───────────────────────┴───────────────────────┴──────────────────────────┴────────────────────────┴─────────────────┴───────────────────────
Découvrons la taille des tables dans Clickhouse
select concat(database, '.', table)                         as table,
       formatReadableSize(sum(bytes))                       as size,
       sum(rows)                                            as rows,
       max(modification_time)                               as latest_modification,
       sum(bytes)                                           as bytes_size,
       any(engine)                                          as engine,
       formatReadableSize(sum(primary_key_bytes_in_memory)) as primary_keys_size
from system.parts
where active
group by database, table
order by bytes_size desc;
Découvrons combien d'espace les logs occupent dans Clickhouse.
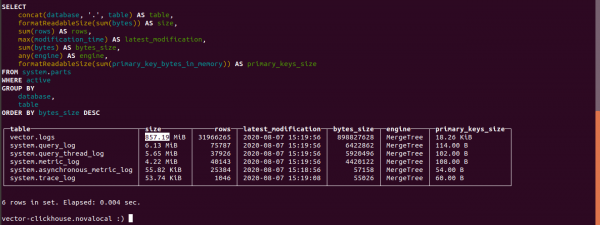
La taille de la table logs est de 857,19 Mo.
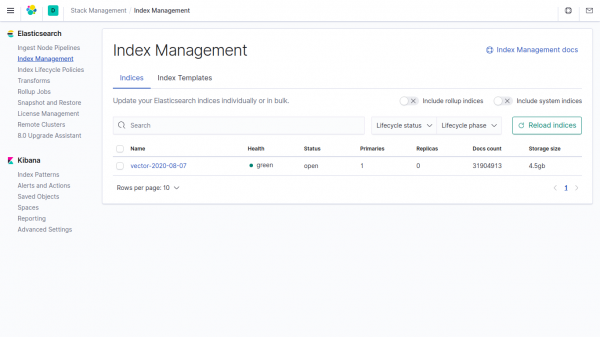
La taille des mêmes données dans l'index d'Elasticsearch occupe 4,5 Go.
Si l'on ne spécifie pas 'vector' dans les paramètres de Clickhouse, les données occupent 4500/857,19 = 5,24 fois moins que dans Elasticsearch.
Dans le champ vector, la compression est utilisée par défaut.
Chat Telegram sur
Chat Telegram sur
Chat Telegram sur ""
Source : habr.com
