

Plus le système est complexe, plus il se voit encombré de divers alertes. Il est donc nécessaire de réagir à ces alertes, de les agréger et de les visualiser. Je pense que cette situation est familière à beaucoup, au point de provoquer un tic nerveux.
La solution dont il sera question ici n'est pas la plus inattendue, mais une recherche approfondie sur ce sujet ne donne pas d'article complet.
C'est pourquoi j'ai décidé de partager l'expérience de FunCorp et d'expliquer comment le processus de gardes est organisé, qui appelle, pourquoi et comment tout cela peut être observé.
Qu'est-ce que PagerDuty ?
Ainsi, pour résoudre tous ces problèmes, nous avons commencé à chercher un outil pratique. Après une courte recherche, nous avons choisi PagerDuty. PD nous a semblé être une solution complète et concise avec de nombreuses intégrations et configurations. Que représente-t-elle ?
En résumé, PagerDuty est une plateforme de gestion des incidents, capable de traiter les incidents entrants via diverses intégrations, de configurer les rotations de garde et d'alerter l'ingénieur de garde en fonction du niveau de l'incident (pour un niveau élevé, un appel ; pour un niveau bas, une notification push de l'application/sms).
Qui est le gardien ?
C'est probablement le premier point à considérer pour configurer PD.
Chez FunCorp, comme dans d'autres entreprises, il existe un poste honorifique de gardien. Ce poste est transmis d'un ingénieur à l'autre tous les jours. Il y a ce qu'on appelle la première et la deuxième ligne de réponse aux alertes de PagerDuty. Supposons qu'une alerte de haute priorité arrive, et si, 10 minutes après l'appel au gardien de la première ligne, il n'y a pas de réponse (c'est-à-dire s'il n'est pas passé au statut 'acknowledge' ou 'resolved'), l'appel est transféré au deuxième ingénieur de garde. Cela se configure dans PagerDuty via les Escalation Policies.
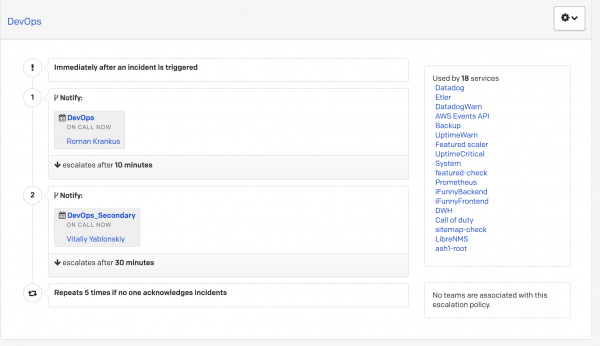
Si le deuxième gardien ne répond pas non plus, la notification revient au gardien principal. Ainsi, toute alerte entrante de haute priorité ne peut rester sans réponse.
Voyons maintenant d'où peuvent provenir les incidents.
Quelles intégrations utilisons-nous ?
Dans PD, de nombreux incidents variés proviennent de différents services. Actuellement, nous avons environ 25 de ces services, et pour les traiter, nous utilisons certaines intégrations prêtes à l'emploi.
De nombreux incidents variés provenant de différents services se produisent dans PD. Nous avons actuellement environ 25 de ces services, et pour les traiter, nous utilisons certaines intégrations prêtes à l'emploi.
- Prometheus
Le système principal de collecte de métriques est Prometheus. Beaucoup de choses ont déjà été écrites à son sujet sur Habr, je dirai juste que nous en avons plusieurs pour différents environnements : un collecte des métriques des machines virtuelles et des conteneurs Docker, un autre des services Amazon, et le troisième des machines physiques. Telegraf est principalement utilisé comme exportateur de métriques.
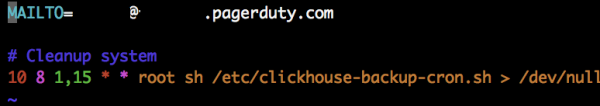
Ici aussi, je pense que tout est clair d'après le nom. Cette intégration est utilisée pour envoyer des notifications à partir de certains scripts exécutés via cron. PD vous fournit une adresse à laquelle vous envoyez des courriels. Lors de la création d'un service avec cette intégration, vous pouvez configurer les priorités concernant l'ordre de traitement des incidents entrants, ainsi que la manière de créer une alerte (pour chaque courriel reçu, pour le courriel reçu + une certaine règle, etc.).
- Slack
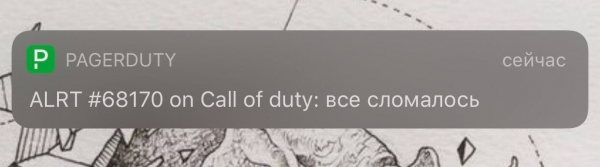
À mon avis, c'est une intégration plutôt intéressante. Il arrive qu'il se passe quelque chose mais sans être couvert par des incidents. C'est pourquoi nous avons ajouté l'intégration Slack pour la création d'incidents. C'est-à-dire que dans le Slack d'entreprise, on peut écrire /callofduty все тормозит и скоро сломается et PD le traitera et enverra l'incident à l'ingénieur de garde.
Nous faisons :
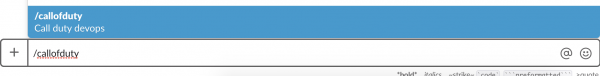
Nous voyons :
- API
Intégration via HTTP. En fait, il n'y a rien de particulièrement intéressant ici, juste une requête POST avec un corps au format JSON. Par exemple, parmi les choses intéressantes : nous l'utilisons pour la surveillance externe avec . Ce service vérifie la disponibilité de nos sites depuis différents points du monde. En cas de code de réponse inacceptable (par exemple, 502), un incident est créé et tout se poursuit selon la chaîne décrite ci-dessus. Dans StatusCake, il est possible de surveiller les URL internes, l'expiration des certificats SSL ou du domaine.
- LibreNMS
C'est un autre système de surveillance, dont vous pouvez lire plus sur leur site . Grâce à lui, nous surveillons les interfaces réseau et iDRAC des serveurs.
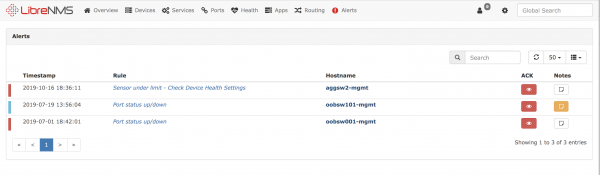
Il y avait aussi des intégrations comme Datadog, CloudWatch. Vous pouvez consulter ce qui leur est arrivé .
Visualisation
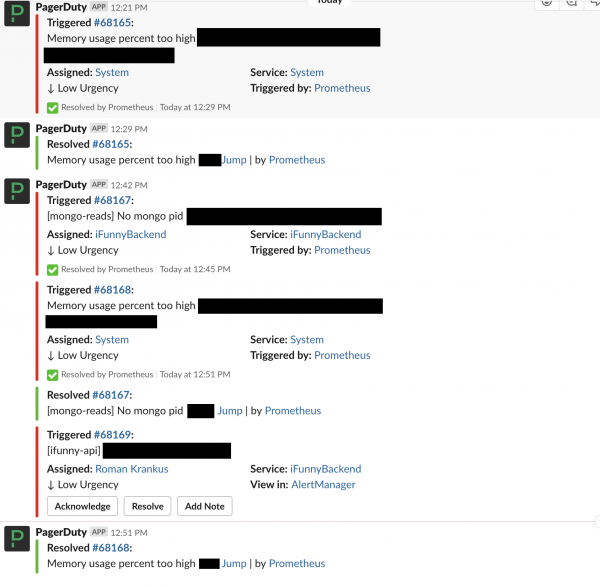
Le système principal d'information sur les incidents est Slack. Tous les incidents entrants dans PD sont écrits dans un chat spécial, et si leur statut change, cela est également affiché dans le chat.
Lorsque nous avons eu la possibilité d'afficher des données utiles sur les écrans suspendus au plafond, nous avons soudain réalisé que nous (dans le département devops) n'avions rien à afficher. Grafana est formidable, mais elle ne peut pas tout couvrir, et les employés réagissent aux alertes plutôt qu'aux graphiques.
Après une recherche minutieuse mais infructueuse d'un « board » concis et informatif pour PD sur GitHub, nous avons décidé d'en créer un nous-mêmes — uniquement avec ce dont nous avons besoin. Bien qu'au départ, l'idée était d'afficher l'interface de PD elle-même, cela semblait encore plus incommode.
Pour l'écrire, il suffit d'obtenir une clé de PD avec des droits en lecture seule.
Et voici ce que nous avons obtenu :
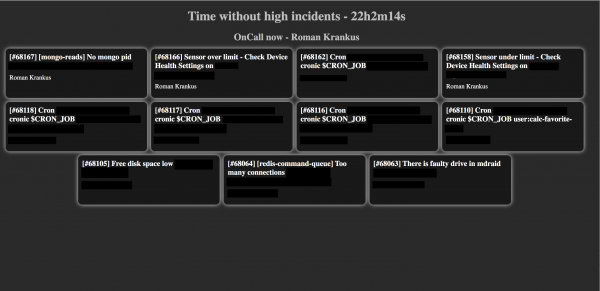
L'écran affiche les incidents en cours, le nom de l'ingénieur de garde actuel selon le planning choisi, et le temps écoulé sans incident de haute priorité (le panneau affichant l'incident de haute priorité sera surligné en rouge).
.
En fin de compte, nous avons obtenu un tableau de bord pratique pour consulter tous nos incidents. Je serais ravi si notre expérience pouvait être utile à certains d'entre vous.
Source : habr.com
