

Comment lire cet article: je suis désolé que le texte soit si long et confus. Pour vous faire gagner du temps, je commence chaque chapitre par une introduction « Ce que j'ai appris », où je résume en une ou deux phrases l'essence du chapitre.
« Montre simplement la solution ! » Si vous voulez juste voir où j'en suis, passez au chapitre « Je deviens plus inventive », mais je pense qu'il est plus intéressant et utile de lire sur les échecs.
Récemment, j'ai été chargé de configurer le processus de traitement d'un grand volume de séquences d'ADN d'origine (techniquement, il s'agit d'une puce SNP). Je devais rapidement obtenir des données sur une localisation génétique spécifique (appelée SNP) pour des modélisations et d'autres tâches. Grâce à R et AWK, j'ai réussi à nettoyer et organiser les données de manière naturelle, accélérant ainsi considérablement le traitement des requêtes. Cela n’a pas été facile et a nécessité de nombreuses itérations. Cet article vous aidera à éviter certaines de mes erreurs et vous montrera ce que j'ai finalement réussi à accomplir.
Tout d'abord, quelques explications préliminaires.
Données
Notre centre universitaire de traitement de l'information génétique nous a fourni des données au format TSV d'une taille de 25 To. Je les ai reçues sous forme de 5 paquets, compressés en Gzip, chacun contenant environ 240 fichiers de quatre Go. Chaque ligne contenait des données pour un SNP d'une personne. En tout, des données concernant ~2,5 millions de SNP et ~60 000 personnes ont été transmises. En plus des informations sur les SNP, les fichiers comprenaient de nombreuses colonnes de chiffres reflétant diverses caractéristiques, telles que l'intensité de lecture, la fréquence des différents allèles, etc. Environ 30 colonnes contenaient des valeurs uniques.
L'objectif
Comme dans tout projet de gestion des données, le plus important était de déterminer comment les données seraient utilisées. Dans ce cas nous allons principalement modéliser et établir des flux de travail pour les SNP en fonction des SNP. C'est-à-dire que nous aurons besoin de données uniquement pour un SNP à la fois. Je devais apprendre à extraire le plus simplement, le plus rapidement et le moins cher possible tous les enregistrements relatifs à l'un des 2,5 millions de SNP.
Comment ne pas faire cela
Je vais citer un cliché pertinent :
Je n'ai pas échoué mille fois, j'ai simplement découvert mille façons de ne pas analyser une tonne de données dans un format utile pour les requêtes.
Première tentative
Ce que j'ai appris: il n'existe pas de moyen économique de parser 25 To à la fois.
Après avoir suivi le cours « Méthodes avancées de traitement des grandes données » à l'Université Vanderbilt, j'étais convaincu que c'était facile. Il me faudrait probablement une heure ou deux pour configurer le serveur Hive afin de parcourir toutes les données et de rendre compte des résultats. Étant donné que nos données sont stockées sur AWS S3, j'ai utilisé le service , qui permet d'appliquer des requêtes SQL Hive sur les données S3. Pas besoin de configurer ou de lancer un cluster Hive, et vous payez seulement pour les données que vous recherchez.
Après avoir montré à Athena mes données et leur format, j'ai exécuté quelques tests avec des requêtes similaires :
select * from intensityData limit 10;Et j'ai rapidement obtenu des résultats bien structurés. Prêt.
Jusqu'à ce que nous essayions d'utiliser les données en pratique…
On m'a demandé d'extraire toutes les informations sur les SNP afin de tester le modèle. J'ai lancé la requête :
select * from intensityData
where snp = 'rs123456';
…et j'ai attendu. Après huit minutes et plus de 4 To de données demandées, j'ai obtenu un résultat. Athena facture en fonction du volume de données trouvées, à 5 $ le téraoctet. Donc, cette unique requête m'a coûté 20 $ et huit minutes d'attente. Pour exécuter le modèle sur toutes les données, il aurait fallu patienter 38 ans et payer 50 millions de dollars. Évidemment, cela ne nous convenait pas.
Il fallait utiliser Parquet…
Ce que j'ai appris: faites attention à la taille de vos fichiers Parquet et à leur organisation.
Tout d'abord, j'ai essayé de résoudre le problème en convertissant tous les TSV en . Ils sont pratiques pour travailler avec de grands ensembles de données, car l'information y est stockée sous forme de colonnes : chaque colonne est placée dans son propre segment de mémoire/disque, contrairement aux fichiers texte dans lesquels les lignes contiennent les éléments de chaque colonne. Et quand il faut trouver quelque chose, il suffit de lire la colonne nécessaire. De plus, dans chaque fichier, chaque colonne stocke une plage de valeurs, donc si une valeur recherchée n'est pas présente dans la plage de la colonne, Spark ne perdra pas de temps à balayer tout le fichier.
J'ai lancé une tâche simple Pour convertir nos TSV en Parquet, j'ai chargé de nouveaux fichiers dans Athena. Cela a pris environ 5 heures. Mais lorsque j'ai lancé la requête, son exécution a pris presque autant de temps et un peu moins d'argent. Le problème est que Spark, essayant d'optimiser la tâche, a simplement décompressé un morceau de TSV et l'a placé dans son propre morceau de Parquet. Et comme chaque morceau était assez gros et contenait des enregistrements complets de nombreuses personnes, tous les SNP étaient donc stockés dans chaque fichier, ce qui obligeait Spark à ouvrir tous les fichiers pour extraire les informations nécessaires.
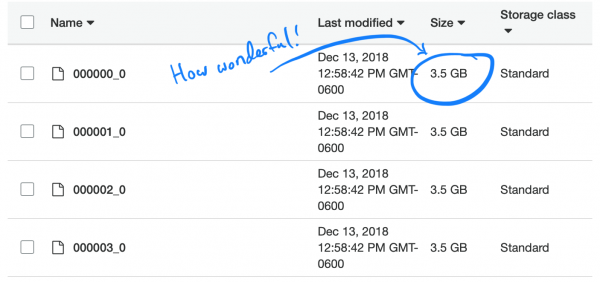
Il est intéressant de noter que le type de compression par défaut (et recommandé) dans Parquet — snappy — n'est pas partageable (splitable). Par conséquent, chaque exécuteur est resté bloqué sur la tâche de décompression et le chargement de l'ensemble complet de données de 3,5 Go.
Nous examinons le problème
Ce que j'ai appris: le tri est difficile, surtout si les données sont réparties.
J'avais l'impression que je comprenais maintenant l'essentiel du problème. Je devais simplement trier les données par colonne SNP, et non par personnes. Ainsi, plusieurs SNP seraient stockés dans un seul morceau de données, et alors, la fonction « intelligente » de Parquet « n'ouvre que si la valeur est dans la plage » montrerait toute sa valeur. Malheureusement, trier des milliards de lignes dispersées sur un cluster s'est avéré être une tâche complexe.
Moi, prenant des cours d'algorithmes à l'université : « Ugh, personne ne se soucie de la complexité computationnelle de tous ces algorithmes de tri »
Moi, essayant de trier sur une colonne dans un 20 To table : « Pourquoi cela prend-il autant de temps ? » difficultés.
— Nick Strayer (@NicholasStrayer)
AWS ne veut certainement pas rendre l'argent pour la raison « Je suis un étudiant distrait ». Après avoir lancé le tri sur Amazon Glue, il a fonctionné pendant 2 jours et a échoué.
Qu'en est-il du partitionnement ?
Ce que j'ai appris: les partitions dans Spark doivent être équilibrées.
Puis, j'ai eu l'idée de partitionner les données par chromosomes. Il y en a 23 (et quelques autres, si l'on considère l'ADN mitochondrial et les régions non mappées).
Cela permettra de diviser les données en portions plus petites. Si j'ajoute dans la fonction d'exportation de Spark dans le script Glue juste une ligne partition_by = "chr", alors les données devraient être réparties dans des seaux (buckets).
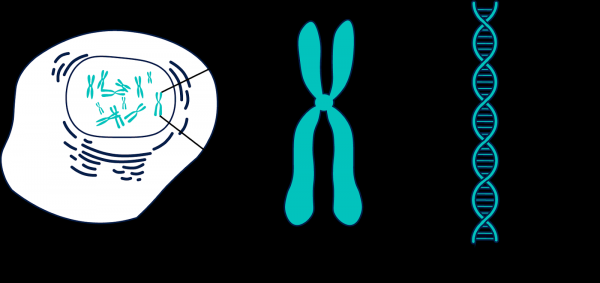
Le génome est composé de nombreux fragments appelés chromosomes.
Malheureusement, cela n'a pas fonctionné. Les chromosomes ont des tailles différentes, donc une quantité d'informations différente. Cela signifie que les tâches envoyées par Spark aux workers n'étaient pas équilibrées et s'exécutaient lentement, car certains nœuds terminaient plus tôt et restaient inactifs. Cependant, les tâches ont été exécutées. Mais lors de la demande d'un SNP, le déséquilibre a de nouveau causé des problèmes. Le coût de traitement des SNP dans des chromosomes plus grands (c'est-à-dire ceux d'où nous voulons obtenir des données) n'a diminué que d'environ 10 fois. Beaucoup, mais pas assez.
Et si l'on les divisait en partitions encore plus petites ?
Ce que j'ai appris: ne tentez jamais de créer 2,5 millions de partitions.
J'ai décidé de faire les choses en grand et de partitionner chaque SNP. Cela a garanti une taille de partitions uniforme. C'ÉTAIT UNE MAUVAISE IDÉE. J'ai utilisé Glue et ajouté une simple ligne partition_by = 'snp'. Le travail a été lancé et a commencé à s'exécuter. Un jour plus tard, j'ai vérifié et j'ai vu qu'il n'y avait toujours rien écrit dans S3, donc j'ai arrêté la tâche. Il semble que Glue écrivait des fichiers intermédiaires dans un emplacement caché dans S3, avec beaucoup de fichiers, peut-être plusieurs millions. En conséquence, mon erreur m'a coûté plus de mille dollars et n'a pas réjoui mon mentor.
Partitionnement + tri
Ce que j'ai appris: trier reste difficile, tout comme configurer Spark.
La dernière tentative de partitionnement consistait à partitionner les chromosomes, puis à trier chaque partition. En théorie, cela permettrait d'accélérer chaque requête, car les données de SNP souhaitées devraient se trouver dans quelques morceaux Parquet à l'intérieur d'une plage donnée. Malheureusement, le tri des données même partitionnées s'est révélé être une tâche difficile. En conséquence, je suis passé à EMR pour un cluster personnalisé et j'ai utilisé huit instances puissantes (C5.4xl) et Sparklyr pour créer un flux de travail plus flexible…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
… cependant, la tâche n'a toujours pas été exécutée. J'ai essayé diverses configurations : augmenter l'attribution de mémoire pour chaque exécuteur de requêtes, utiliser des nœuds avec plus de mémoire, appliquer des variables de diffusion (broadcasting variables), mais à chaque fois cela s'est révélé être des solutions temporaires, et progressivement les exécuteurs ont commencé à échouer jusqu'à ce que tout s'arrête.
Mise à jour : ça commence.
— Nick Strayer (@NicholasStrayer)
Je deviens plus inventif
Ce que j'ai appris: parfois, des données spécifiques nécessitent des solutions spécifiques.
Chaque SNP a une valeur de position. Ce nombre correspond à la quantité de bases le long de son chromosome. C'est une bonne et naturelle façon d'organiser nos données. Au départ, je voulais partitionner par zones de chaque chromosome. Par exemple, positions 1 - 2000, 2001 - 4000, etc. Mais le problème est que les SNPs sont répartis de manière inégale sur les chromosomes, donc la taille des groupes va varier considérablement.
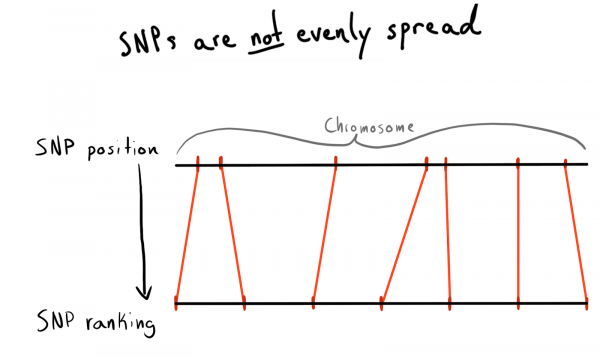
En conséquence, j'en suis venu à une classification par catégories (rang) des positions. Sur les données déjà chargées, j'ai exécuté une requête pour obtenir une liste unique de SNPs, leurs positions et chromosomes. Puis, j'ai trié les données à l'intérieur de chaque chromosome et regroupé les SNPs en groupes (bin) de taille donnée. Disons, par exemple, 1000 SNPs. Cela m'a donné une relation SNP avec un groupe dans le chromosome.
Finalement, j'ai créé des groupes (bin) de 75 SNPs, la raison sera expliquée ci-dessous.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Première tentative avec Spark
Ce que j'ai appris: la jointure dans Spark fonctionne rapidement, mais la partition reste coûteuse.
Je voulais lire ce petit (2,5 millions de lignes) dataframe dans Spark, le joindre avec des données brutes, puis le partitionner selon la nouvelle colonne ajoutée. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
J'ai utilisé sdf_broadcast(), de cette manière Spark sait qu'il doit envoyer le dataframe à tous les nœuds. Cela est utile si les données sont de petite taille et nécessaires pour toutes les tâches. Sinon, Spark essaie d'être intelligent et répartit les données au besoin, ce qui peut causer des ralentissements.
Et encore une fois, mon idée n'a pas fonctionné : les tâches ont fonctionné un moment, ont terminé la jointure, puis, tout comme les exécuteurs lancés par la partition, ont commencé à échouer.
J'ajoute AWK
Ce que j'ai appris: ne dormez pas quand on vous enseigne les bases. Évidemment, quelqu'un a déjà résolu votre problème dans les années 1980.
Jusqu'à présent, la raison de tous mes échecs avec Spark était la désorganisation des données dans le cluster. Peut-être que la situation peut être améliorée par un prétraitement. J'ai décidé d'essayer de diviser les données textuelles brutes en colonnes de chromosomes, espérant ainsi fournir à Spark des données « pré-partitionnées ».
J'ai cherché sur StackOverflow comment diviser par les valeurs des colonnes et j'ai trouvé Avec AWK, vous pouvez diviser un fichier texte en fonction des valeurs des colonnes en exécutant un script, plutôt qu'en envoyant les résultats à stdout.
Pour faire un essai, j'ai écrit un script Bash. J'ai téléchargé l'un des fichiers TSV compressés, puis je l'ai décompressé avec gzip et envoyé à awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
Ça a fonctionné !
Remplissage des cœurs
Ce que j'ai appris: gnu parallel — c'est une chose magique, tout le monde devrait l'utiliser.
Le division se faisait assez lentement, et lorsque j'ai lancé htop, pour vérifier l'utilisation d'une instance EC2 puissante (et coûteuse), il s'est avéré que j'utilisais seulement un cœur et environ 200 Mo de mémoire. Pour résoudre le problème sans perdre une fortune, il fallait penser à comment paralléliser le travail. Heureusement, dans le livre absolument incroyable de Jeroen Janssens, j'ai trouvé un chapitre dédié à la parallélisation. J'y ai appris à propos de gnu parallel, une méthode très flexible d'implémentation de la multithreading sous Unix.
Lorsque j'ai lancé la division avec le nouveau processus, tout était parfait, mais il restait un goulet d'étranglement: le téléchargement des objets S3 sur le disque n'était pas très rapide et pas entièrement parallélisé. Pour corriger cela, j'ai fait ce qui suit :
- J'ai découvert qu'il était possible d'implémenter l'étape de téléchargement S3 directement dans le pipeline, éliminant complètement le stockage intermédiaire sur disque. Cela signifie que je peux éviter d'écrire des données brutes sur le disque et utiliser un stockage encore plus petit, et donc moins cher, sur AWS.
- Avec la commande
aws configure set default.s3.max_concurrent_requests 50a fortement augmenté le nombre de threads utilisés par l'AWS CLI (par défaut 10). - Je suis passé à une instance EC2 optimisée pour la vitesse du réseau, avec la lettre n dans le nom. J'ai découvert que la perte de puissance de calcul lors de l'utilisation d'instances n était largement compensée par l'augmentation de la vitesse de téléchargement. Pour la plupart des tâches, j'ai utilisé c5n.4xl.
- J'ai changé
gzipsur , c'est un outil gzip qui peut faire des choses intéressantes pour paralléliser une tâche non parallélisée de décompression de fichiers (cela a aidé le moins).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Ces étapes sont combinées les unes avec les autres pour que tout fonctionne très rapidement. Grâce à l'augmentation de la vitesse de téléchargement et à l'élimination de l'écriture sur disque, j'ai maintenant pu traiter un lot de 5 To en quelques heures.
Il n'y a rien de plus doux que de voir tous les cœurs que vous payez sur AWS être utilisés. Grâce à gnu-parallel, je peux décompresser et diviser un fichier csv de 19 Go aussi rapidement que je peux le télécharger. Je n'ai même pas pu faire fonctionner Spark.
— Nick Strayer (@NicholasStrayer)
Ce tweet devait mentionner 'TSV'. Malheureusement.
Réutilisation des données analysées
Ce que j'ai appris: Spark préfère les données non compressées et n'aime pas combiner les partitions.
Les données étaient maintenant dans S3 au format non compressé (c'est-à-dire délimité) et semi-ordonné, et je pouvais revenir à Spark. J'ai eu une surprise : je n'ai pas réussi à obtenir le résultat souhaité ! Il était très difficile de dire avec précision à Spark comment les données étaient partitionnées. Même lorsque je l'ai fait, il s'est avéré que le nombre de partitions était trop élevé (95 000), et lorsque j'ai utilisé coalesce pour réduire leur nombre à des limites raisonnables, cela a nuit à ma partition. Je suis sûr que cela peut être corrigé, mais après quelques jours de recherche, je n'ai pas trouvé de solution. Finalement, j'ai réussi à terminer toutes les tâches dans Spark, même si cela a pris un certain temps, et mes fichiers Parquet divisés n'étaient pas très petits (~200 Ko). Cependant, les données étaient là où elles devaient être.
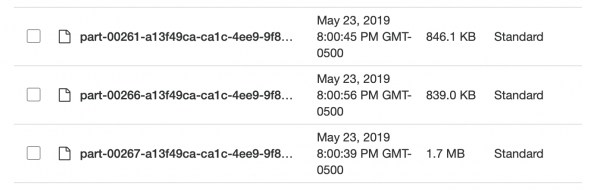
Trop petites et inégales, c'est merveilleux !
Test des requêtes Spark locales
Ce que j'ai appris: il y a trop de surcharge dans Spark pour résoudre des tâches simples.
En chargeant les données dans un format réfléchi, j'ai pu tester la vitesse. J'ai configuré un script en R pour exécuter un serveur Spark local, puis j'ai chargé un dataframe Spark depuis le stockage Parquet spécifié (bin). J'ai essayé de charger toutes les données, mais je n'ai pas pu faire reconnaître la partition à Sparklyr.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Démarrer un chronomètre
start_time <- Sys.time()

# Charger le bin désiré dans Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Sous-ensemble bin pour snp puis collecter localement
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
L'exécution a pris 29,415 secondes. Beaucoup mieux, mais pas assez bon pour des tests massifs. De plus, je ne pouvais pas accélérer le travail grâce au cache, car lorsque j'essayais de mettre en cache le dataframe en mémoire, Spark plantait toujours, même lorsque j'ai alloué plus de 50 Go de mémoire pour un dataset qui pesait moins de 15.
Retour à AWK
Ce que j'ai appris: les tableaux associatifs dans AWK sont très efficaces.
Je savais que je pouvais obtenir une vitesse plus élevée. Je me suis rappelé que dans le magnifique J'ai lu à propos d'une super fonctionnalité appelée «». En fait, ce sont des paires clé-valeur, qui, pour une raison quelconque, ont un autre nom dans AWK, et c'est pourquoi je n'y pense pas vraiment. m'a rappelé que le terme «tableaux associatifs» est beaucoup plus ancien que le terme «paire clé-valeur». Même si vous , vous ne trouverez pas ce terme là-bas, mais vous trouverez des tableaux associatifs ! De plus, «paire clé-valeur» est le plus souvent associé aux bases de données, il est donc beaucoup plus logique de comparer avec un hashmap. J'ai compris que je pouvais utiliser ces tableaux associatifs pour lier mes SNP à la table de groupes (bin table) et aux données brutes sans utiliser Spark.
Pour cela, dans le script AWK, j'ai utilisé le bloc BEGIN. C'est un fragment de code qui s'exécute avant que la première ligne de données ne soit transmise au corps principal du script.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Commande while(getline...) a chargé toutes les lignes du CSV de groupe (bin), a défini la première colonne (nom du SNP) comme clé pour le tableau associatif bin et la deuxième valeur (groupe) comme valeur. Ensuite, dans le bloc { }, qui s'exécute pour toutes les lignes du fichier principal, chaque ligne est envoyée dans un fichier de sortie, qui reçoit un nom unique en fonction de son groupe (bin) : ..._bin_"bin[$1]"_....
Variables batch_num et chunk_id correspondaient aux données fournies par le pipeline, ce qui a permis d'éviter une condition de course, et chaque thread d'exécution, lancé en parallèle, écrivait dans son propre fichier unique.
Puisque j'avais réparti toutes les données brutes dans des dossiers par chromosomes, restés après ma précédente expérience avec AWK, je pouvais maintenant écrire un autre script Bash pour traiter un chromosome à la fois et fournir des données plus profondément partitionnées dans S3.
DESIRED_CHR='13'

# Téléchargez les données de chromosome depuis s3 et divisez-les en bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'lecture {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Combinez tous les morceaux de processus parallèles en fichiers uniques et téléchargez-les sur rds en utilisant R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'compression bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
Le script a deux sections en parallèle.
Dans la première section, les données sont lues à partir de tous les fichiers contenant des informations sur le chromosome requis, puis ces données sont réparties sur des threads, qui répartissent les fichiers dans les groupes correspondants (bin). Pour éviter une condition de course, lorsque plusieurs threads écrivent dans un même fichier, AWK fournit des noms de fichiers pour écrire des données à différents emplacements, par exemple, chr_10_bin_52_batch_2_aa.csv. En conséquence, un grand nombre de petits fichiers sont créés sur le disque (j'ai utilisé des volumes EBS d'un téraoctet).
Le pipeline de la deuxième section en parallèle parcourt les groupes (bin) et fusionne leurs fichiers individuels en un CSV commun avec cat, puis les envoie à l'exportation.
Transcription dans R ?
Ce que j'ai appris: on peut y accéder depuis stdin et stdout un script R, ce qui signifie qu'on peut l'utiliser dans le pipeline.
Dans le script Bash, vous avez peut-être remarqué cette ligne : ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Elle transcrit tous les fichiers concaténés du groupe (bin) dans le script R ci-dessous. {} est une méthode spéciale en parallèle, qui insère toutes les données envoyées dans le flux spécifié directement dans la commande elle-même. L'option {#} fournit un ID unique de flux d'exécution, et {%} représente le numéro de slot de tâche (se répète, mais jamais en même temps). Une liste de toutes les options peut être trouvée dans
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Lorsque la variable file("stdin") est transmise à readr::read_csv, les données transmises au script R sont chargées dans un cadre qui est ensuite enregistré en tant que .rds-fichier à l'aide de aws.s3 , enregistré directement dans S3.
RDS est comme une version simplifiée de Parquet, sans les raffinements d'un entrepôt en colonnes.
Après la fin du script Bash, j'ai obtenu une série .rds-de fichiers situés dans S3, ce qui m'a permis d'utiliser une compression efficace et des types incorporés.
Malgré l'utilisation de l'R, tout fonctionnait très rapidement. Il n'est pas surprenant que les fragments en R, responsables de la lecture et de l'écriture des données, soient bien optimisés. Après des tests sur un chromosome de taille moyenne, la tâche s'est réalisée sur une instance C5n.4xl en environ deux heures.
Limitations de S3
Ce que j'ai appris: grâce à une implémentation intelligente des chemins, S3 peut gérer un grand nombre de fichiers.
Je m'inquiétais de savoir si S3 pourrait traiter le grand nombre de fichiers qui lui étaient transmis. Je pouvais donner des noms de fichiers significatifs, mais comment S3 les rechercherait-elle ?
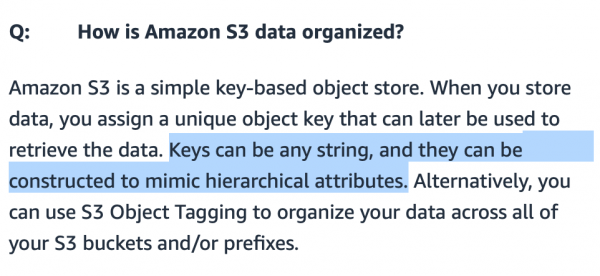
Les dossiers dans S3 ne sont que pour l'esthétique, en réalité, le système ne se soucie pas du symbole /.
Il semble que S3 représente le chemin vers un fichier spécifique sous la forme d'une clé dans une sorte de table de hachage ou base de données basée sur des documents. Un bucket peut être considéré comme une table, et les fichiers comme des enregistrements dans cette table.
Puisque la rapidité et l'efficacité sont cruciales pour générer des bénéfices sur Amazon, il n'est pas surprenant que ce système de « clé-en-tant-que-chemin-pour-le-fichier » soit extrêmement optimisé. J'ai essayé de trouver un équilibre : il ne fallait pas effectuer de nombreuses demandes GET, tout en veillant à ce que les requêtes soient traitées rapidement. Il s'est avéré qu'il était préférable de faire environ 20 000 fichiers binaires. Je pense que si l'on continue à optimiser, on pourrait augmenter la vitesse (par exemple, en créant un bucket spécial uniquement pour les données, réduisant ainsi la taille de la table de recherche). Mais il n'y avait déjà plus de temps ni d'argent pour d'autres expériences.
Qu'en est-il de la compatibilité croisée ?
Ce que j'ai appris : la principale raison de perte de temps est l'optimisation prématurée de votre méthode de stockage.
À ce moment-là, il est très important de se poser la question : « Pourquoi utiliser un format de fichier propriétaire ? » La raison réside dans la rapidité de chargement (les fichiers CSV compressés en gzip prenaient 7 fois plus de temps à se charger) et la compatibilité avec nos flux de travail. Je peux revoir ma décision si R peut facilement charger des fichiers Parquet (ou Arrow) sans la charge de Spark. Dans notre laboratoire, tout le monde utilise R, et si je dois convertir les données dans un autre format, j'ai toujours les données textuelles d'origine, donc je peux simplement relancer le pipeline.
Division du travail
Ce que j'ai appris: ne tentez pas d'optimiser les tâches manuellement, laissez cela à l'ordinateur.
J'ai validé le workflow sur un chromosome, maintenant il faut traiter toutes les autres données.
Je voulais lancer plusieurs instances EC2 pour la transformation, mais en même temps, j'avais peur d'obtenir une charge fortement déséquilibrée dans les différentes tâches de traitement (tout comme Spark souffrait de partitions déséquilibrées). De plus, je n'étais pas ravi de lancer une instance pour chaque chromosome, car il y a une limite par défaut de 10 instances pour les comptes AWS.
J'ai donc décidé d'écrire un script en R pour optimiser les tâches de traitement.
D'abord, j'ai demandé à S3 de calculer combien d'espace de stockage chaque chromosome occupait.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Extraire le chromosome du nom de fichier
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Diviser pour obtenir la valeur en Go


# Un tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … avec 17 autres lignes
Ensuite, j'ai écrit une fonction qui prend la taille totale, mélange l'ordre des chromosomes et les divise en groupes. num_jobs et rapporte à quel point les tailles de tous les travaux de traitement varient.
num_jobs <- 7
# Quelle serait la taille de chaque travail si elle était parfaitement divisée ?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Un tibble: 1 x 2
     sd data

1  153.
Puis j'ai exécuté avec purrr mille mélanges et sélectionné le meilleur.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Ainsi, j'ai obtenu un ensemble de travaux très similaires en taille. Il ne restait plus qu'à envelopper mon script Bash précédent dans une grande boucle. for. L'écriture de cette optimisation a pris environ 10 minutes. Et c'est beaucoup moins que ce que j'aurais passé à créer manuellement des travaux en cas de déséquilibre. C'est pourquoi je pense que cette optimisation préliminaire était une bonne décision.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Code pour traiter un seul chromosome
fi
À la fin, j'ajoute la commande d'arrêt :
sudo shutdown -h now … et tout a bien fonctionné ! Avec AWS CLI, j'ai lancé des instances et via l'option user_data j'ai transmis des scripts Bash pour leurs travaux de traitement. Ils s'exécutaient et s'éteignaient automatiquement, donc je ne payais pas pour une puissance de calcul excédentaire.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
On emballe !
Ce que j'ai appris: L'API doit être simple pour la simplicité et la flexibilité d'utilisation.
Enfin, j'ai obtenu les données au bon endroit et dans le bon format. Il ne restait plus qu'à simplifier au maximum le processus d'utilisation des données pour faciliter la tâche de mes collègues. Je voulais créer une API simple pour faire des requêtes. Si je décide un jour de passer à .rds Pour les fichiers Parquet, cela devrait être un problème pour moi et non pour mes collègues. Pour cela, j'ai décidé de créer un package R interne.
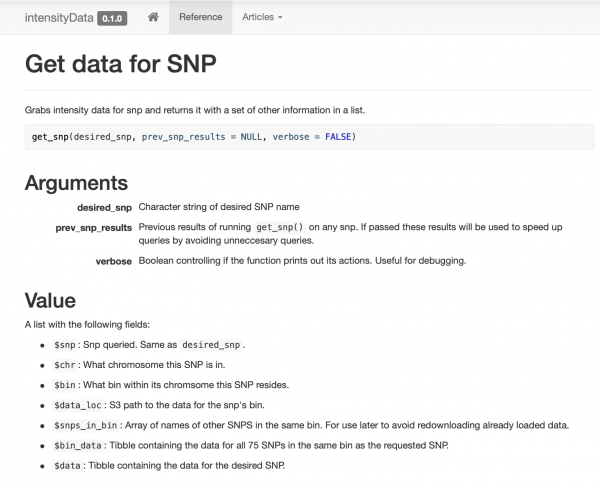
J'ai assemblé et documenté un package très simple contenant seulement quelques fonctions pour accéder aux données, regroupées autour de la fonction get_snp. J'ai également créé pour mes collègues un site , afin qu'ils puissent facilement consulter les exemples et la documentation.
Mise en cache intelligente
Ce que j'ai appris: si vos données sont bien préparées, il sera facile de mettre en cache !
Comme un des principaux flux de travail appliquait au package SNP le même modèle d'analyse, j'ai décidé d'utiliser le regroupement à mon avantage. Lors de la transmission des données par SNP, toutes les informations du groupe sont attachées à l'objet retourné. Cela signifie que les anciennes requêtes peuvent (en théorie) accélérer le traitement des nouvelles requêtes.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Lors de la création du package, j'ai exécuté de nombreux benchmarks pour comparer la vitesse en utilisant différentes méthodes. Je recommande de ne pas négliger cela, car parfois les résultats peuvent être surprenants. Par exemple, dplyr::filter s'est avéré beaucoup plus rapide que la capture des lignes par filtrage basé sur l'indexation, et obtenir une colonne unique à partir d'un cadre de données filtré fonctionnait beaucoup plus rapidement qu'en utilisant une syntaxe d'indexation.
Notez que l'objet prev_snp_results contient la clé snps_in_bin. Il s'agit d'un tableau de tous les SNP uniques dans le groupe, permettant de vérifier rapidement si des données de requêtes précédentes existent déjà. Cela simplifie également le passage cyclique à travers tous les SNP du groupe avec ce code :
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Résultats
Nous pouvons maintenant (et avons commencé sérieusement) à exécuter des modèles et des scénarios qui étaient auparavant inaccessibles. Le meilleur, c'est que mes collègues de laboratoire n'ont pas à se soucier des complexités. Ils ont simplement une fonction qui fonctionne.
Et bien que le package les libère des détails, j'ai essayé de rendre le format des données suffisamment simple pour qu'ils puissent comprendre, au cas où je disparaîtrais soudainement demain…
La vitesse a considérablement augmenté. En général, nous analysons des fragments fonctionnellement significatifs du génome. Auparavant, nous ne pouvions pas le faire (c'était trop coûteux), mais maintenant, grâce à la structure de groupe et à la mise en cache, une requête pour un SNP prend en moyenne moins de 0,1 seconde, et l'utilisation des données est si faible que les coûts en deviennent négligeables.
Récemment, j'ai été chargé de gérer plus de 25 To de données de génotypage brutes pour mon laboratoire. Au début, utiliser Spark prenait 8 minutes et coûtait 20 $ pour interroger un SNP. Après avoir utilisé AWK + pour traiter, cela prend désormais moins d'un dixième de seconde et coûte 0,00001 $. Mon gain personnel win.
— Nick Strayer (@NicholasStrayer)
Conclusion
Cet article n'est pas un guide. La solution est devenue individuelle et est presque certainement non optimale. C'est plutôt un récit d'un parcours. Je veux que d'autres comprennent que de telles solutions ne naissent pas entièrement formées dans l'esprit, mais sont le résultat d'essais et d'erreurs. De plus, si vous cherchez un spécialiste en analyse de données, gardez à l'esprit que pour utiliser efficacement ces outils, il faut de l'expérience, et l'expérience coûte de l'argent. Je suis heureux d'avoir eu les moyens de paiement, mais beaucoup d'autres, qui pourraient faire le même travail mieux que moi, n'auront jamais cette opportunité en raison d'un manque d'argent, même pour une tentative.
Les outils pour les grandes données sont universels. Si vous avez le temps, vous pourrez certainement écrire une solution plus rapide en appliquant un 'nettoyage' intelligent des données, un stockage et des méthodes d'extraction. En fin de compte, tout se résume à une analyse des coûts et des avantages.
Ce que j'ai appris :
- il n'existe pas de moyen peu coûteux de parser 25 To à la fois ;
- faites attention à la taille de vos fichiers Parquet et à leur organisation ;
- les partitions dans Spark doivent être équilibrées ;
- ne jamais essayer de faire 2,5 millions de partitions ;
- le tri reste difficile, tout comme la configuration de Spark ;
- parfois, des données spécifiques nécessitent des solutions spécifiques ;
- la fusion dans Spark fonctionne rapidement, mais le partitionnement reste coûteux ;
- ne dormez pas pendant qu'on vous enseigne les bases, quelqu'un a probablement déjà résolu votre problème dans les années 1980 ;
gnu parallel— c'est une chose magique, tout le monde devrait l'utiliser ;- Spark aime les données non compressées et n'aime pas combiner les partitions ;
- il y a trop de surcharge dans Spark pour résoudre des tâches simples ;
- les tableaux associatifs dans AWK sont très efficaces ;
- vous pouvez appeler
stdinetstdoutdepuis un script R, ce qui signifie que vous pouvez l'utiliser dans votre pipeline ; - grâce à une mise en œuvre intelligente des chemins S3 pouvant traiter de nombreux fichiers ;
- la principale raison de la perte de temps est l'optimisation prématurée de votre méthode de stockage ;
- n'essayez pas d'optimiser les tâches manuellement, laissez l'ordinateur le faire ;
- l'API doit être simple pour facilité et flexibilité d'utilisation ;
- si vos données sont bien préparées, le caching sera facile !
Source : habr.com
