

L'objectif principal de Patroni est d'assurer la haute disponibilité pour PostgreSQL. Mais Patroni n'est qu'un modèle, et non un outil prêt à l'emploi (comme cela est clairement indiqué dans la documentation). À première vue, en configurant Patroni dans un environnement de test, on peut voir à quel point c'est un excellent outil et comment il gère facilement nos tentatives de défaillance de cluster. Cependant, dans un environnement de production, tout ne se déroule pas toujours aussi joliment et élégamment que dans une salle de test.
Permettez-moi de me présenter. J'ai commencé en tant qu'administrateur système. J'ai travaillé dans le développement web. Depuis 2014, je suis chez Data Egret. L'entreprise est spécialisée dans le conseil en Postgres. Nous nous consacrons exclusivement à Postgres et travaillons avec lui chaque jour, ce qui nous procure une expertise variée liée à son exploitation.
Fin 2018, nous avons commencé à utiliser progressivement Patroni. Nous avons acquis une certaine expérience. Nous l'avons diagnostiqué, peaufiné, et avons établi nos meilleures pratiques. Dans cette présentation, je vais en parler.
Outre PostgreSQL, j'aime Linux. J'aime m'y plonger, explorer, compiler des kernels. J'apprécie la virtualisation, les conteneurs, Docker, Kubernetes. Cela m'intéresse beaucoup, car cela reflète mes anciennes habitudes d'administrateur. J'aime m'occuper des systèmes de monitoring. J'adore les aspects administratifs de Postgres, tels que la réplication et les sauvegardes. Pendant mon temps libre, j'écris en Go. Je ne suis pas ingénieur logiciel, mais j'écris pour moi-même en Go, et j'en tire beaucoup de plaisir.
- Je pense que beaucoup d'entre vous savent qu'il n'y a pas de haute disponibilité (HA) dans PostgreSQL par défaut. Pour obtenir la HA, il faut installer quelque chose, le configurer, faire des efforts et y parvenir.
- Il existe plusieurs outils, et Patroni est l'un d'eux, qui résout la HA de manière assez efficace et très bonne. Mais en le mettant en place dans un environnement de test et en le lançant, nous pouvons voir que tout fonctionne, que nous pouvons reproduire certains problèmes et observer comment Patroni les gère. Et nous verrons que tout cela fonctionne parfaitement.
- Mais en pratique, nous avons rencontré différents problèmes. Je vais parler de ces problèmes.
- Je vais expliquer comment nous avons diagnostiqué cela, ce que nous avons ajusté – cela nous a-t-il aidés ou non.
- Je ne vais pas expliquer comment installer Patroni, car il est possible de le trouver sur Internet, de consulter les fichiers de configuration pour comprendre comment tout cela fonctionne et comment le configurer. On peut se familiariser avec les schémas, les architectures en trouvant des informations à ce sujet en ligne.
- Je ne vais pas parler d'expériences étrangères. Je vais aborder uniquement les problèmes auxquels nous avons été confrontés spécifiquement.
- Je ne vais pas non plus aborder les problèmes en dehors de Patroni et PostgreSQL. Par exemple, en ce qui concerne les problèmes liés à l'équilibrage lorsque notre cluster s'est effondré, je ne vais pas en parler.
Et un petit avertissement avant de commencer notre présentation.
Tous ces problèmes auxquels nous avons été confrontés se sont présentés au cours des six à huit premiers mois d'exploitation. Avec le temps, nous avons élaboré nos meilleures pratiques internes. Et les problèmes ont disparu. C'est pourquoi la présentation a été annoncée il y a environ six mois, lorsque tout cela était encore frais dans ma mémoire.
Au fur et à mesure que je préparais la présentation, j'ai relu d'anciens post-mortems et examiné les journaux. Et certains détails ont pu être oubliés, ou certains aspects n'ont peut-être pas été suffisamment étudiés lors de l'analyse des problèmes, donc dans certains cas, il peut sembler que les problèmes n'ont pas été entièrement abordés ou qu'il manque des informations. Je vous demande donc de m'excuser pour cela.
Qu'est-ce que Patroni ?
- C'est un modèle pour la mise en place de la haute disponibilité. C'est ainsi que cela est écrit dans la documentation. Et de mon point de vue, c'est une précision très juste. Patroni n'est pas une solution miracle qui résoudra tous vos problèmes, c'est-à-dire qu'il faut faire un effort pour qu'il commence à fonctionner et qu'il apporte des bénéfices.
- C'est un service d'agent qui est installé sur chaque service avec une base de données et qui est une sorte de système d'initialisation pour votre Postgres. Il démarre, arrête, redémarre Postgres, modifie la configuration et change la topologie de votre cluster.
- Ainsi, pour stocker l'état du cluster, sa représentation actuelle, il faut un certain type de stockage. Et à cet égard, Patroni a choisi de conserver son état dans un système externe. C'est un système de stockage de configuration distribué. Cela peut être Etcd, Consul, ZooKeeper, ou encore Etcd de Kubernetes, donc l'une de ces options.
- L'une des caractéristiques de Patroni est que vous obtenez un basculement automatique dès le départ, simplement en le configurant. En comparaison avec Repmgr, le basculement automatique y est inclus. Avec Repmgr, nous avons un switchover, mais si nous voulons un basculement automatique, nous devons le configurer séparément. Patroni propose déjà un basculement automatique prêt à l'emploi.
- Et il y a beaucoup d'autres choses à considérer. Par exemple, la gestion des configurations, l'ajout de nouvelles répliques, les sauvegardes, etc. Mais cela sort du cadre de cette présentation, donc je n'en parlerai pas.
Pour résumer, la principale tâche de Patroni est d'assurer un basculement automatique de manière fiable afin que notre cluster reste opérationnel et que l'application ne perçoive aucune modification dans la topologie du cluster.
Cependant, lorsque nous commençons à utiliser Patroni, notre système devient un peu plus complexe. Si nous avions auparavant Postgres, l'utilisation de Patroni implique d'avoir Patroni lui-même ainsi qu'un DCS où l'état est stocké. Tout cela doit fonctionner ensemble. Alors, quels éléments peuvent tomber en panne ?
Les éléments qui peuvent tomber en panne :
- Postgres peut tomber en panne. Cela peut être le maître ou la réplique, l'un d'eux peut dysfonctionner.
- Patroni lui-même peut également tomber en panne.
- Le DCS, où l'état est stocké, peut tomber en panne.
- Et le réseau peut également avoir des problèmes.
Je vais aborder tous ces points dans ma présentation.
J'examinerai les cas au fur et à mesure qu'ils deviennent plus complexes, non pas du point de vue du nombre de composants impliqués, mais en fonction de la perception subjective de la difficulté de chaque cas, certains étant plus difficiles à analyser que d'autres.
Le premier cas est le plus simple. C'est celui où nous avons pris un cluster de bases de données et mis en place notre stockage DCS sur le même cluster. C'est l'erreur la plus courante. C'est une erreur d'architecture, c'est-à-dire de combiner différents composants au même endroit.
Ainsi, un événement de basculement s'est produit, et nous devons examiner ce qui s'est passé.
Nous devons nous intéresser au moment où le basculement s'est produit, c'est-à-dire au point précis dans le temps où l'état du cluster a changé.
Mais un basculement n'est pas toujours instantané, c'est-à-dire qu'il ne prend pas une unité de temps définie ; il peut s'étendre sur une durée prolongée.
Par conséquent, il dispose d'un temps de début et d'un temps de fin, c'est-à-dire qu'il s'agit d'un événement prolongé. Nous divisons tous les événements en trois intervalles : nous avons le temps avant le failover, pendant le failover et après le failover. C'est-à-dire que nous considérons tous les événements sur cette échelle temporelle.
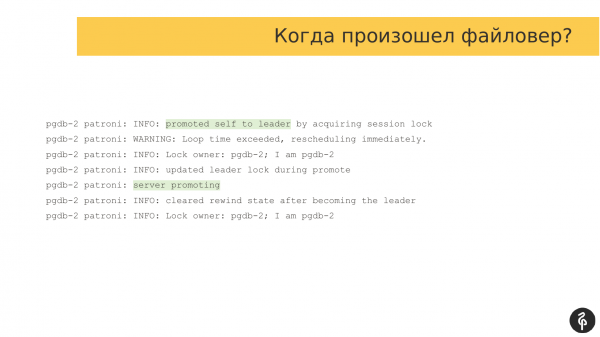
Et la première chose que nous faisons lorsque le failover se produit, c'est que nous cherchons la cause, ce qui s'est passé, ce qui a conduit au failover.
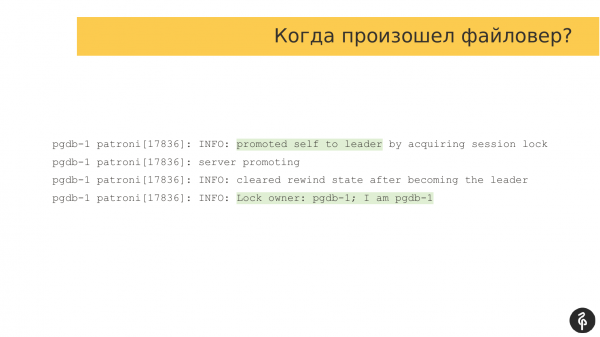
Si nous regardons les logs, ce seront les logs classiques de Patroni. Ils nous indiquent que le serveur est devenu maître et que le rôle de maître est passé à ce nœud. Cela est mis en évidence ici.
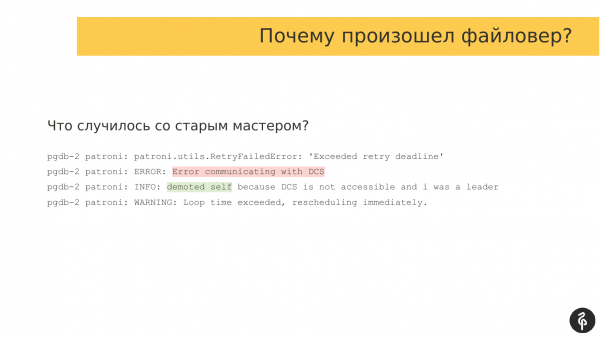
Ensuite, nous devons comprendre pourquoi le failover s'est produit, c'est-à-dire quels événements ont conduit le rôle de maître à se déplacer d'un nœud à un autre. Dans ce cas, c'est assez simple. Nous avons une erreur d'interaction avec le système de stockage. Le maître a compris qu'il ne pouvait pas travailler avec le DCS, c'est-à-dire qu'il y avait un problème d'interaction. Et il dit qu'il ne peut plus être le maître et qu'il renonce à ses pouvoirs. Cette ligne « demoted self » en parle précisément.
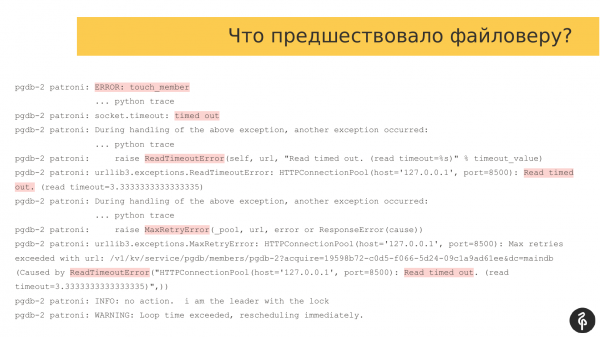
Si nous examinons les événements qui ont précédé le failover, nous pouvons voir les mêmes causes qui ont posé problème pour la continuité du fonctionnement du maître.
En regardant les logs de Patroni, nous verrons qu'il y a de nombreuses erreurs, des timeouts, c'est-à-dire que l'agent Patroni ne peut pas communiquer avec le DCS. Dans ce cas, il s'agit de l'agent Consul, avec lequel nous communiquons via le port 8500.
Et le problème ici est que Patroni et la base de données sont exécutés sur le même hôte. Et sur ce même nœud, des serveurs Consul ont été lancés. En créant une charge sur le serveur, nous avons également créé des problèmes pour serveurs Consul. Ils n'ont pas pu communiquer correctement.
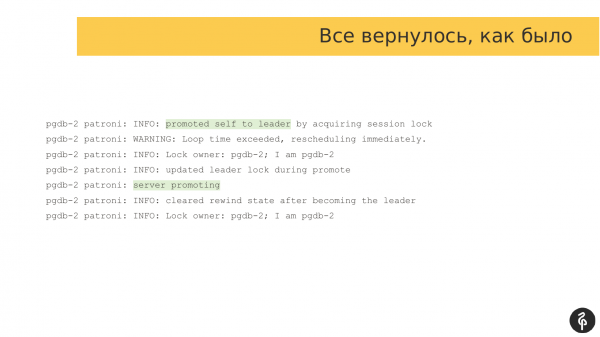
Après un certain temps, lorsque la charge a diminué, notre Patroni a pu à nouveau communiquer avec les agents. Le fonctionnement normal a repris. Et le même serveur Pgdb-2 est redevenu maître. C'est-à-dire qu'il y a eu un léger flip, à cause duquel le nœud a renoncé à ses pouvoirs de maître, puis les a repris, c'est-à-dire que tout est revenu comme avant.
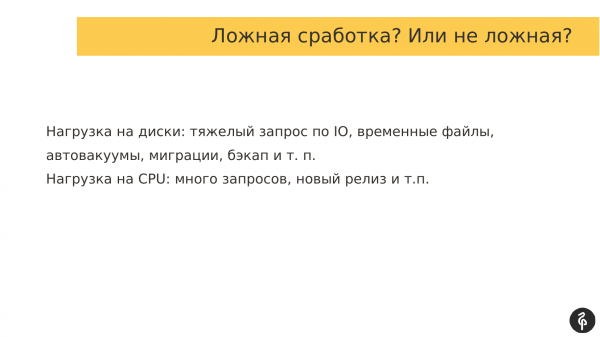
Et cela peut être considéré comme un faux déclenchement, ou l'on peut considérer que Patroni a bien agi. C'est-à-dire qu'il a compris qu'il ne pouvait pas maintenir l'état du cluster et a renoncé à ses pouvoirs.
Et ici, le problème est survenu parce que les serveurs Consul sont sur le même matériel que les bases de données. Par conséquent, toute charge : que ce soit une charge sur les disques ou sur les processeurs, elle impacte également l'interaction avec le cluster Consul.
Nous avons donc décidé que cela ne devait pas coexister, nous avons alloué un cluster séparé pour Consul. Patroni fonctionnait déjà avec un Consul distinct, c'est-à-dire qu'il y avait un cluster Postgres séparé, un cluster Consul séparé. Voici les instructions de base sur la façon dont tout cela doit être séparé et maintenu, afin qu'il ne vive pas ensemble.
En option, on peut ajuster les paramètres ttl, loop_wait, retry_timeout, c'est-à-dire essayer de survivre à ces pics de charge temporaires en augmentant ces paramètres. Mais ce n'est pas la meilleure option, car cette charge pourrait être prolongée dans le temps. Et nous allons simplement dépasser ces limites. Cela peut ne pas vraiment aider.
Le premier problème, comme vous l'avez compris, est simple. Nous avons pris et mis DCS avec la base, et nous avons rencontré un problème.
Le deuxième problème est similaire au premier. Il ressemble au premier en ce sens que nous avons encore des problèmes de communication avec le système DCS.
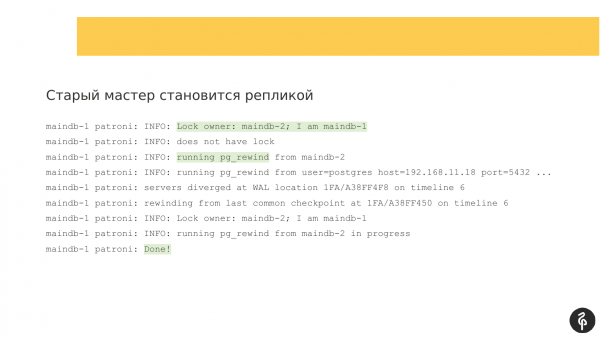
Si nous examinons les journaux, nous verrons que nous avons de nouveau une erreur de communication. Patroni dit qu'il ne peut pas interagir avec DCS, donc le maître actuel passe en mode réplique.
L'ancien maître devient une réplique, ici Patroni fonctionne comme il se doit. Il lance pg_rewind pour revenir sur le journal des transactions et ensuite se connecter au nouveau maître, et se synchroniser avec celui-ci. Patroni fonctionne ici comme il le devrait.
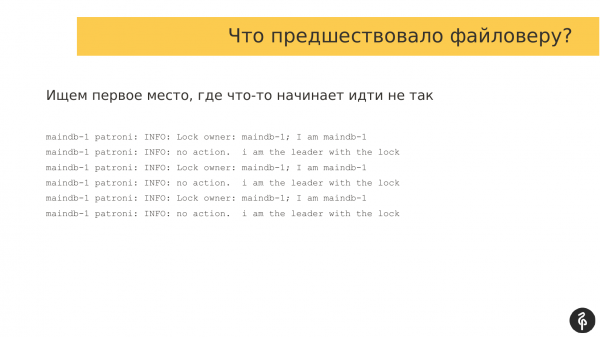
Ici, nous devons trouver l'endroit qui a précédé le fileur, c'est-à-dire les erreurs qui ont causé le fileur. Dans ce sens, travailler avec les journaux de Patroni est assez pratique. Il écrit, à intervalles réguliers, les mêmes messages. Et si nous commençons à faire défiler ces journaux rapidement, nous verrons que les journaux ont changé, ce qui signifie que des problèmes ont commencé. Nous retournons rapidement à cet endroit et voyons ce qui se passe.
Dans une situation normale, les journaux ressemblent à cela. Le propriétaire du verrou est vérifié. Et si le propriétaire, par exemple, a changé, alors certains événements peuvent se produire, auxquels Patroni doit réagir. Mais dans ce cas, tout va bien. Nous cherchons le moment où les erreurs ont commencé.
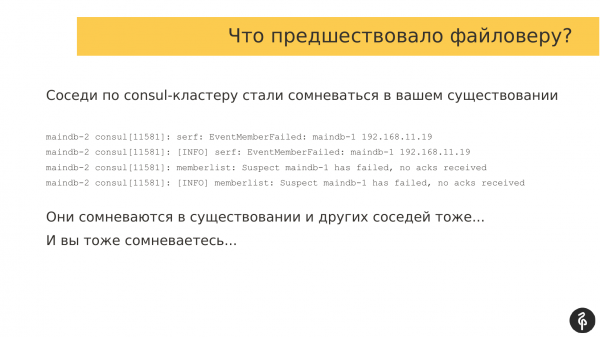
En faisant défiler jusqu'à cet endroit où les erreurs ont commencé à apparaître, nous voyons qu'un autofailover a eu lieu. Et puisque nos erreurs étaient liées à l'interaction avec le DCS et dans notre cas, nous avons utilisé Consul, nous consultons également les journaux de Consul pour voir ce qui s'est passé là-bas.
En comparant approximativement l'heure de l'autofailover et l'heure dans les journaux de Consul, nous constatons que nos voisins du cluster Consul ont commencé à douter de l'existence des autres participants du cluster Consul.
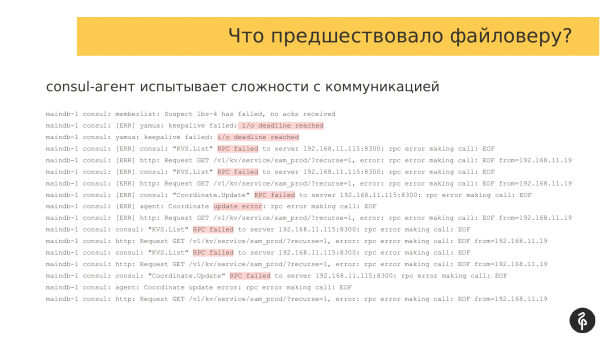
Et si nous regardons également les journaux d'autres agents Consul, nous voyons aussi qu'il se produit un certain type de collapse réseau. Tous les participants du cluster Consul doutent les uns des autres. Cela a été un déclencheur pour l'autofailover.
Si nous examinons ce qui s'est passé avant ces erreurs, nous pouvons voir toutes sortes d'erreurs, par exemple, des délais, des échecs RPC, c'est-à-dire qu'il y a manifestement un problème d'interaction entre les participants du cluster Consul.
La réponse la plus simple est de réparer le réseau. Mais pour moi, debout sur la tribune, c'est facile à dire. Mais les circonstances font que le client ne peut pas toujours se permettre de réparer le réseau. Il peut vivre dans un DC et ne pas avoir la possibilité de réparer le réseau ou d'influencer l'équipement. Ainsi, d'autres options sont nécessaires.
Il existe des options :
- La solution la plus simple, qui est apparemment même écrite dans la documentation, consiste à désactiver les contrôles Consul, c'est-à-dire à simplement transmettre un tableau vide. Nous disons à l'agent Consul de ne pas utiliser de contrôles. Grâce à ces contrôles, nous pouvons ignorer les tempêtes réseau et ne pas initier d'autofailover.
- Une autre option est de vérifier le raft_multiplier. Il s'agit d'un paramètre du serveur Consul lui-même. Par défaut, il est réglé sur 5. Ce paramètre est recommandé par la documentation pour les environnements de staging. En essence, cela influence la fréquence des échanges de messages entre les participants du réseau Consul. Fondamentalement, ce paramètre affecte la rapidité de la communication entre les participants du cluster Consul. Et pour la production, il est déjà recommandé de le réduire afin que les nœuds échangent des messages plus fréquemment.
- Une autre option que nous avons commencée à utiliser est d'augmenter la priorité des processus Consul par rapport aux autres processus pour le planificateur de processus du système d'exploitation. Il existe un paramètre appelé « nice » qui définit précisément la priorité des processus que le planificateur de l'OS prend en compte lors de la planification. Nous avons donc réduit la valeur nice pour les agents Consul, c'est-à-dire augmenté leur priorité afin que le système d'exploitation accorde plus de temps aux processus Consul pour fonctionner et exécuter leur code. Dans notre cas, cela a résolu notre problème.
- Une autre option est de ne pas utiliser Consul. J'ai un ami qui est un grand partisan d'Etcd. Nous avons régulièrement des débats sur ce qui est mieux, Etcd ou Consul. Mais en général, nous parvenons à la conclusion que Consul a un agent qui doit être exécuté sur chaque nœud avec la base de données. C'est-à-dire que l'interaction de Patroni avec le cluster Consul se fait via cet agent. Et cet agent devient un goulot d'étranglement. Si quelque chose arrive à l'agent, Patroni ne peut plus interagir avec le cluster Consul. C'est un problème. Dans le cas d'Etcd, il n'y a pas d'agent. Patroni peut interagir directement avec la liste des serveurs Etcd et communiquer avec eux. À cet égard, si vous utilisez Etcd dans votre entreprise, Etcd sera probablement un meilleur choix que Consul. Mais chez nos clients, nous sommes souvent limités par ce que le client a choisi et utilise. Dans la plupart des cas, tous nos clients utilisent Consul.
- Et le dernier point est de revoir les valeurs des paramètres. Nous pouvons augmenter ces paramètres dans l'espoir que nos problèmes réseau temporaires seront courts et ne dépasseront pas l'intervalle de ces paramètres. Ainsi, nous pouvons réduire l'agressivité de Patroni en ce qui concerne l'exécution de l'auto-failover, si des problèmes de réseau surviennent.
Je pense que beaucoup de ceux qui utilisent Patroni connaissent cette commande.
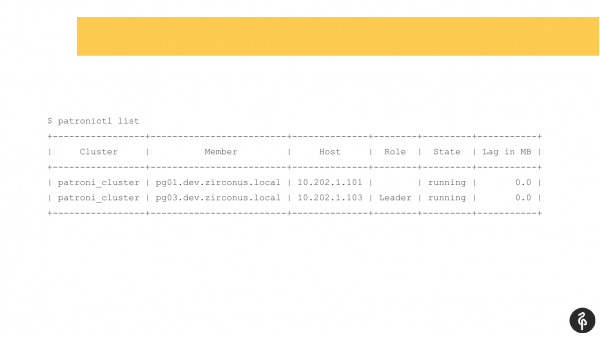
Cette commande montre l'état actuel du cluster. À première vue, cette situation peut sembler normale. Nous avons un master, nous avons une réplique, il n'y a pas de latence de réplication. Mais cette image est normale seulement jusqu'à ce que nous sachions qu'il devrait y avoir trois nœuds dans ce cluster et non deux.
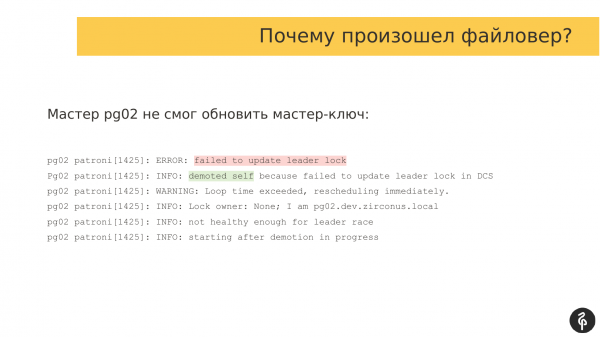
Par conséquent, un failover automatique s'est produit. Et après ce failover automatique, notre réplique a disparu. Nous devons comprendre pourquoi elle a disparu et la ramener, la restaurer. Nous retournons donc dans les logs et vérifions pourquoi nous avons eu ce failover automatique.
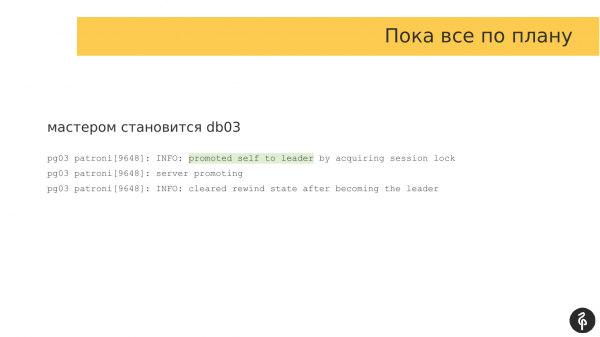
Dans ce cas, la deuxième réplique est devenue le maître. Tout est en ordre ici.
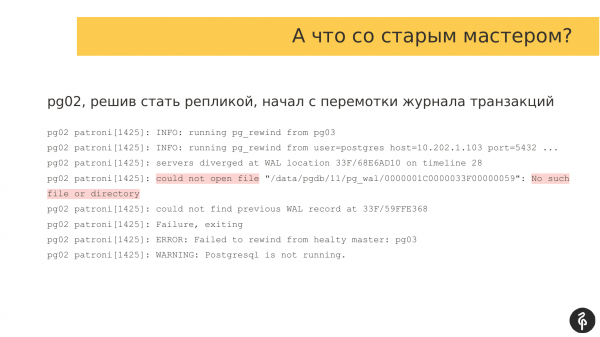
Et nous devons nous concentrer sur la réplique qui a échoué et qui n'est pas dans le cluster. Nous ouvrons les logs de Patroni et vérifions que lors de la connexion au cluster, un problème est survenu à l'étape pg_rewind. Pour se connecter au cluster, il faut revenir en arrière dans le journal des transactions, demander le journal des transactions nécessaire au maître et le rattraper.
Dans ce cas, nous n'avons pas de journal des transactions et la réplique ne peut pas démarrer. Par conséquent, nous arrêtons Postgres avec une erreur. Et c'est pourquoi elle n'est pas dans le cluster.
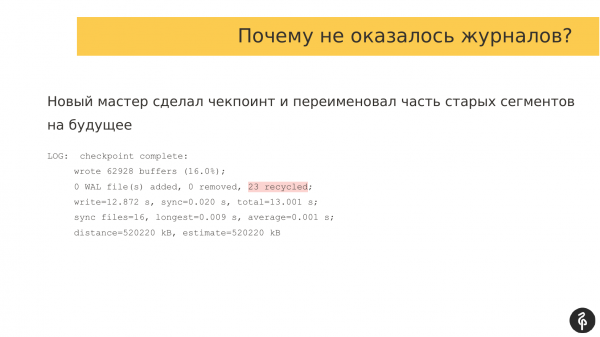
Il faut comprendre pourquoi elle n'est pas dans le cluster et pourquoi il n'y avait pas de logs. Nous allons sur le nouveau maître et vérifions ce qu'il y a dans ses logs. Il s'avère que lors de l'exécution de pg_rewind, un checkpoint s'est produit. Une partie des anciens journaux des transactions a simplement été renommée. Lorsque l'ancien maître a essayé de se connecter au nouveau maître et a demandé ces logs, ils avaient déjà été renommés, il n'y en avait tout simplement plus.
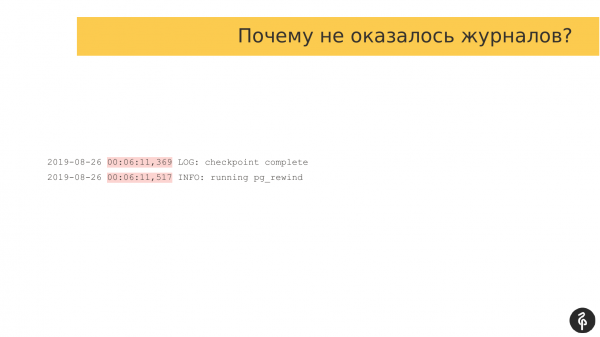
J'ai comparé les horodatages lorsque ces événements se sont produits. Et la différence est littéralement de 150 millisecondes, c'est-à-dire que le checkpoint s'est terminé en 369 millisecondes, les segments WAL ont été renommés. Et littéralement 517 millisecondes plus tard, 150 millisecondes après, le rewind a démarré sur l'ancienne réplique. C'est-à-dire qu'il a suffi de 150 millisecondes pour que la réplique ne puisse pas se connecter et fonctionner.
Quelles sont les options ?
Nous avons d'abord utilisé des slots de réplication. Nous pensions que c'était une bonne chose. Bien que lors de la première phase d'exploitation, nous ayons désactivé les slots. Nous pensions que si les slots accumulaient trop de segments WAL, nous pourrions faire tomber le maître. Il tomberait. Nous avons passé un certain temps sans slots. Et nous avons compris que nous avions besoin des slots, nous les avons remis.
Mais il y a un problème : lorsque le maître passe en réplique, il supprime les slots et avec les slots, il supprime les segments WAL. Pour éviter ce problème, nous avons décidé d'augmenter le paramètre wal_keep_segments. Par défaut, il est de 8 segments. Nous l'avons porté à 1000 et avons vérifié combien d'espace libre nous avons. Ainsi, nous avons réservé 16 Go pour wal_keep_segments. C'est-à-dire qu'en passant d'un nœud à un autre, nous avons toujours à disposition 16 Go de journaux de transactions sur tous les nœuds.
De plus, cela est particulièrement pertinent pour les tâches de maintenance prolongées. Par exemple, nous devons mettre à jour l'une des répliques. Nous voulons la mettre hors ligne. Nous devons mettre à jour le logiciel, peut-être le système d'exploitation, ou autre chose. Lorsque nous mettons la réplique hors ligne, le slot pour cette réplique est également supprimé. Si nous utilisons un wal_keep_segments faible, alors pendant l'absence prolongée de cette réplique, les journaux de transactions vont disparaître. Lorsque nous relèverons la réplique, elle demandera les journaux de transactions là où elle s'était arrêtée, mais il se peut qu'ils ne soient pas disponibles sur le maître. Cela empêchera la réplique de se connecter. C'est pourquoi nous maintenons un grand réservoir de journaux.
Nous avons une base de production. Des projets y fonctionnent déjà.
Il y a eu un failover. Nous avons vérifié et constaté que tout allait bien, les répliques étaient en place, il n'y avait pas de retard de réplication. Il n'y avait pas non plus d'erreurs dans les journaux, tout était en ordre.
L'équipe produit dit qu'il devrait y avoir des données, mais nous les voyons dans une source, tandis qu'elles ne sont pas visibles dans la base. Nous devons comprendre ce qui leur est arrivé.
Il est clair que pg_rewind les a écrasées. Nous l'avons immédiatement compris, mais nous sommes allés vérifier ce qui s'était passé.
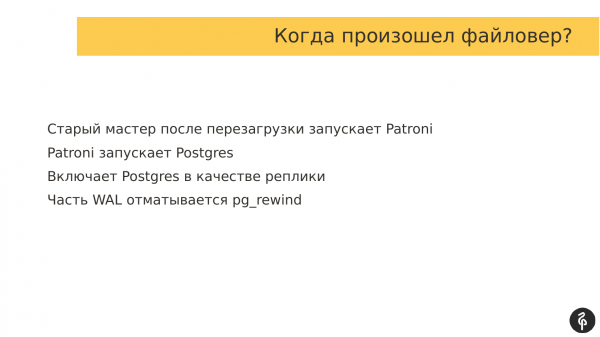
Dans les journaux, nous pouvons toujours trouver quand le failover s'est produit, qui est devenu maître et nous pouvons identifier qui était l'ancien maître et quand il a voulu devenir réplique, c'est-à-dire que ces journaux sont nécessaires pour déterminer le volume de journaux de transactions qui a été perdu.
Notre ancien maître a redémarré. Et dans le démarrage automatique avait été inscrit Patroni. Patroni a démarré. Il a ensuite lancé Postgres. Plus précisément, avant de lancer Postgres et avant de le faire devenir réplique, Patroni a démarré le processus pg_rewind. Par conséquent, il a supprimé une partie des journaux de transactions, a téléchargé les nouveaux et s'est connecté. Ici, Patroni a bien fonctionné, c'est-à-dire comme prévu. Notre cluster a été rétabli. Nous avions 3 nœuds, après le failover, 3 nœuds – tout est parfait.
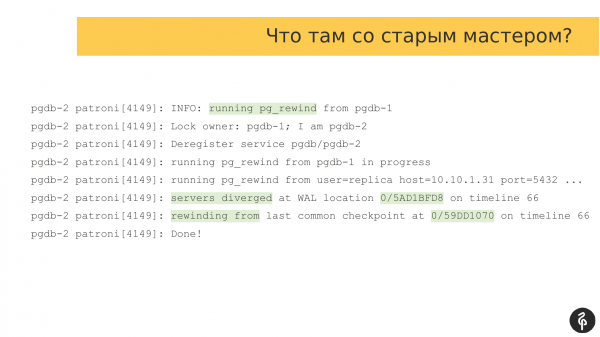
Nous avons perdu une partie des données. Et nous devons comprendre combien nous avons perdu. Nous cherchons précisément le moment où le rewind a eu lieu. Nous pouvons le trouver grâce à ces enregistrements dans le journal. Le rewind a été lancé, a effectué certaines actions et s'est terminé.
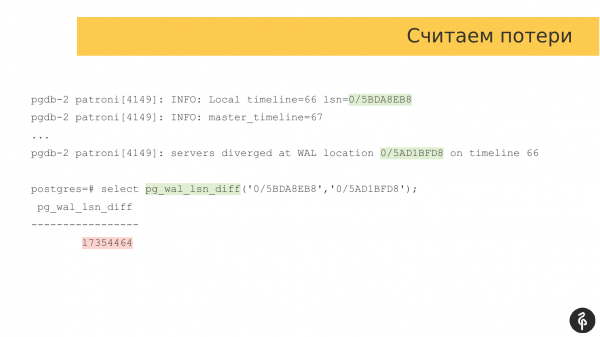
Nous devons trouver la position dans le journal des transactions où s'est arrêté l'ancien maître. Dans ce cas, c'est cette marque-ci. Et nous avons besoin d'une seconde marque, c'est-à-dire de la distance qui sépare l'ancien maître du nouveau.
Nous prenons la fonction pg_wal_lsn_diff habituelle et comparons ces deux marques. Dans ce cas, nous obtenons 17 mégaoctets. Chacun juge si c'est beaucoup ou peu. Parce que pour certains, 17 mégaoctets, c'est peu, pour d'autres, c'est beaucoup et inacceptable. Chacun doit déterminer cela individuellement en fonction des besoins de son entreprise.
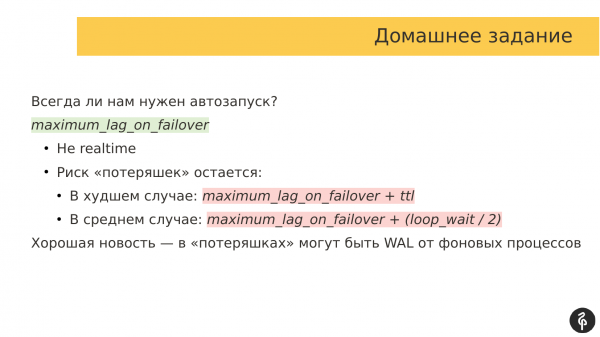
Mais qu'avons-nous conclu pour nous-mêmes ?
Tout d'abord, nous devons décider si nous avons toujours besoin du démarrage automatique de Patroni après un redémarrage système. Souvent, il est nécessaire de se connecter à l'ancien maître, de voir à quel point il est en retard. Il peut être nécessaire d'inspecter les segments du journal des transactions pour comprendre si nous pouvons perdre ces données ou si nous devons démarrer l'ancien maître en mode autonome pour récupérer ces données.
Et seulement après cela, nous devons prendre des décisions sur la possibilité de rejeter ces données ou de les récupérer, en connectant ce nœud en tant que réplique dans notre cluster.
En outre, il y a un paramètre « maximum_lag_on_failover ». Par défaut, si ma mémoire est bonne, cette valeur est de 1 mégaoctet.
Comment ça fonctionne ? Si notre réplique est en retard de 1 mégaoctet en matière de lag de réplication, cette réplique ne participe pas aux élections. Et si jamais il y a un basculement, Patroni vérifie quelles répliques sont en retard. Si elles le sont sur une grande quantité de journaux de transactions, elles ne peuvent pas devenir maîtres. C'est une très bonne fonction de protection qui permet d'éviter une perte de données importante.
Mais il y a un problème, le lag de réplication dans le cluster Patroni et DCS est mis à jour à intervalles réguliers. Je pense que la valeur ttl par défaut est de 30 secondes.
Il peut donc y avoir des situations où le délai de réplication pour les répliques dans le DCS est un, alors qu'en réalité, il peut y avoir un autre délai complètement différent ou il se peut qu'il n'y ait pas de délai du tout, c'est-à-dire que ce système n'est pas en temps réel. Et il ne reflète pas toujours la réalité. Il ne vaut donc pas la peine d’y établir une logique complexe.
Et le risque de perte de données reste toujours. Dans le pire des cas, il y a une formule, et dans le cas moyen, une autre formule. C'est-à-dire que lorsque nous planifions l'implémentation de Patroni et évaluons combien de données nous pouvons perdre, nous devons nous baser sur ces formules et avoir une idée générale de la quantité de données que nous pourrions perdre.
Et il y a une bonne nouvelle. Lorsque l'ancien maître part en avant, il peut avancer grâce à certains processus en arrière-plan. C'est-à-dire qu'il y a eu un autovacuum qui a écrit des données et les a enregistrées dans le journal des transactions. Et nous pouvons facilement ignorer ces données et les perdre. Il n'y a pas de problème à cela.
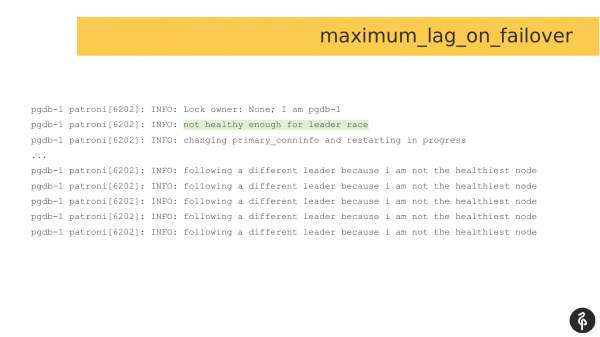
Voici à quoi ressemblent les journaux lorsque maximum_lag_on_failover est défini et qu'un failover s'est produit, nécessitant le choix d'un nouveau maître. La réplique s'évalue comme incapable de participer aux élections. Elle refuse de participer à la course pour le leadership. Elle attend qu'un nouveau maître soit choisi, afin de pouvoir s'y connecter par la suite. C'est une mesure supplémentaire contre la perte de données.
Notre équipe produit a signalé que son produit rencontre des problèmes lors de l'utilisation de Postgres. Cependant, on ne peut pas accéder au maître lui-même, car il n'est pas accessible par SSH. Et l'autofailover ne se produit pas non plus.
Cet hôte a été forcé à redémarrer. En raison du redémarrage, un autofailover s'est produit, bien qu'un autofailover manuel ait également pu être effectué, comme je le comprends maintenant. Et après le redémarrage, nous commençons à analyser ce qui se passe avec notre maître actuel.
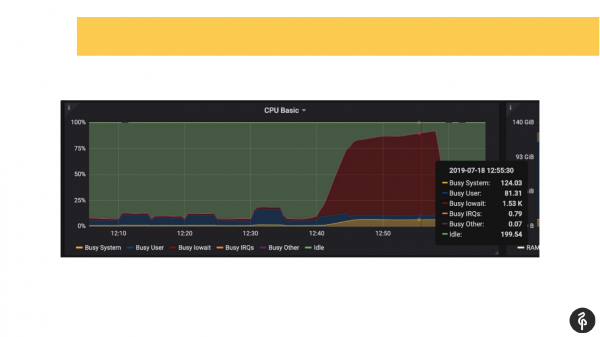
Nous savions d'avance que nous avions des problèmes avec les disques, c'est-à-dire que par le monitoring, nous savions déjà où chercher et quoi chercher.
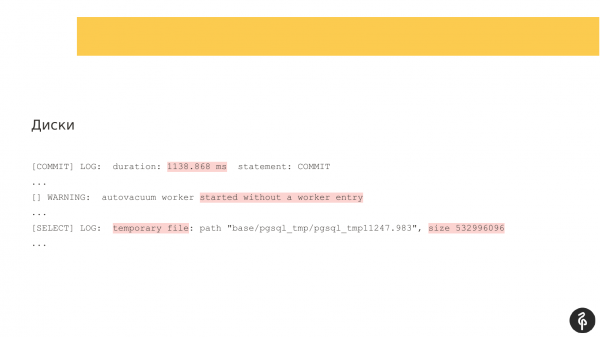
Nous avons plongé dans le journal de postgres, commencé à voir ce qui s'y passait. Nous avons vu des validations qui duraient une à trois secondes, ce qui n'est pas normal du tout. Nous avons constaté que notre autovacuum se déclenchait très lentement et bizarrement. Et nous avons vu des fichiers temporaires sur le disque. C'est-à-dire que tous ces indicateurs montrent des problèmes avec les disques.
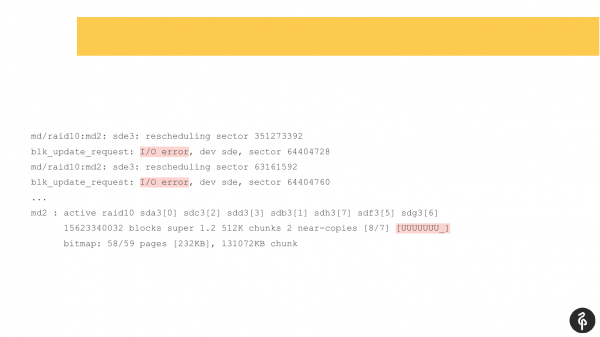
Nous avons consulté le dmesg système (le journal des messages du noyau). Et nous avons constaté qu'il y avait un problème avec l'un des disques. La configuration de la sous-système de disque était un RAID logiciel. Nous avons regardé /proc/mdstat et avons remarqué qu'il nous manque un disque. En d'autres termes, il s'agit d'un RAID de 8 disques, et nous avons un disque manquant. Si l'on examine attentivement la diapositive, on peut voir que le sde est absent. Nous avons, pour ainsi dire, perdu un disque. Cela a déclenché des problèmes de disque, et les applications ont également eu des difficultés à fonctionner avec le cluster Postgres.
Dans ce cas, Patroni ne nous aurait pas aidés, car Patroni n'a pas pour tâche de surveiller l'état du serveur ou des disques. Nous devons surveiller ces situations avec une surveillance externe. Nous avons rapidement ajouté la surveillance des disques à la surveillance externe.
Et il y avait cette idée - est-ce que le fencing ou un logiciel watchdog pourraient nous aider ? Nous avons pensé qu'il serait peu probable qu'ils nous aident dans ce cas, car pendant les problèmes, Patroni continuait à interagir avec le cluster DCS et ne voyait aucun problème. En d'autres termes, du point de vue de DCS et de Patroni, tout allait bien avec le cluster, bien qu'en réalité, il y avait des problèmes de disque et de disponibilité de la base.
À mon avis, c'est l'un des problèmes les plus étranges que j'ai étudiés pendant longtemps, j'ai relu beaucoup de journaux, et je l'ai appelé un cluster-simulateur.
Le problème était que l'ancien maître ne pouvait pas devenir une réplique normale, c'est-à-dire que Patroni le démarrait, Patroni montrait que ce nœud était présent en tant que réplique, mais en même temps, il n'était pas une réplique normale. Vous allez voir pourquoi. Cela m'est resté de l'analyse de ce problème.
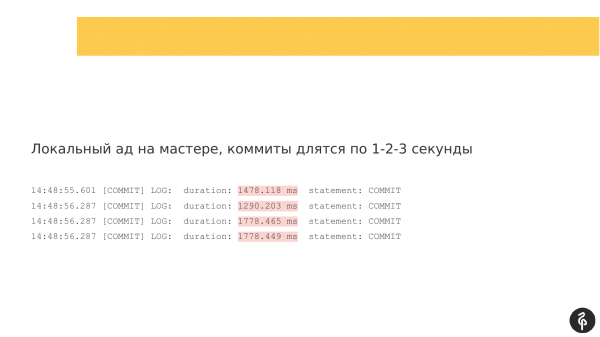
Et comment tout a commencé ? Cela a commencé, comme dans le précédent problème, par des lenteurs liées à des disques. Nous avions des commits toutes les secondes, voire deux.
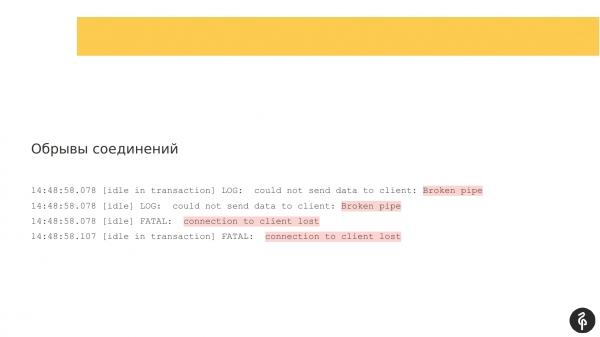
Il y avait des coupures de connexion, c'est-à-dire que les clients étaient déconnectés.
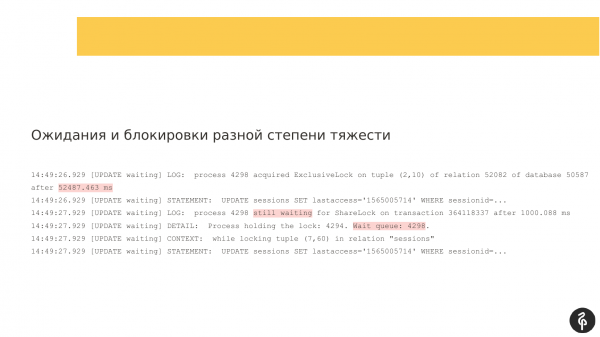
Il y avait des blocages de diverses gravités.
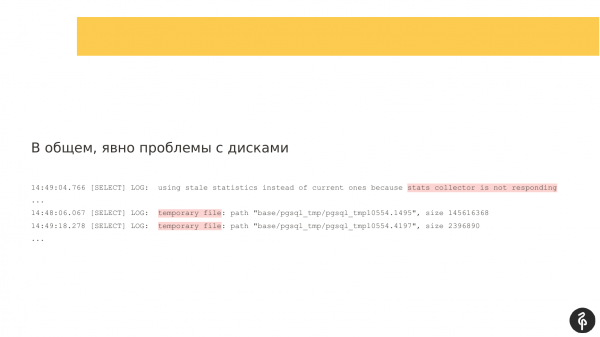
Et, par conséquent, le sous-système de disques n'était pas très réactif.
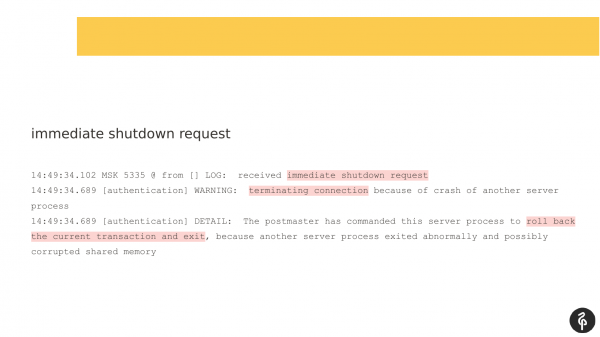
Et ce qui est le plus mystérieux pour moi, c'est cette requête de shutdown immédiate qui est arrivée. Postgres a trois modes d'arrêt :
- Il y a le mode gracieux, où nous attendons que tous les clients se déconnectent d'eux-mêmes.
- Il y a le mode rapide, où nous obligeons les clients à se déconnecter, car nous allons procéder à l'arrêt.
- L'arrêt immédiat. Dans ce cas, l'arrêt immédiat ne prévient même pas les clients qu'il faut se déconnecter, il se coupe simplement sans avertissement. Tous les clients reçoivent un message RST du système d'exploitation (message TCP indiquant que la connexion a été interrompue et qu'il n'y a plus rien à capter pour le client).
Qui a envoyé ce signal ? Les processus en arrière-plan de Postgres ne s'envoient pas de tels signaux, c'est-à-dire que c'est un kill -9. Ils ne s'envoient pas ça, ils réagissent juste à cela, donc c'est un redémarrage d'urgence de Postgres. Je ne sais pas qui l'a envoyé.
J'ai consulté la commande « last » et j'ai vu une personne qui s'est également connectée à ce serveur avec nous, mais j'ai hésité à poser la question. Peut-être que c'était un kill -9. J'aurais vu le kill -9 dans les logs, car Postgres indique avoir reçu un kill -9, mais je ne l'ai pas vu dans les logs.
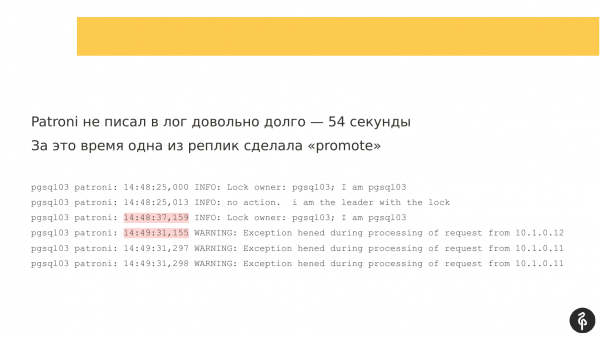
En continuant d'analyser, j'ai remarqué que Patroni n'avait pas écrit dans les logs pendant assez longtemps – 54 secondes. Si l'on compare deux horodatages, il y avait environ 54 secondes sans messages.
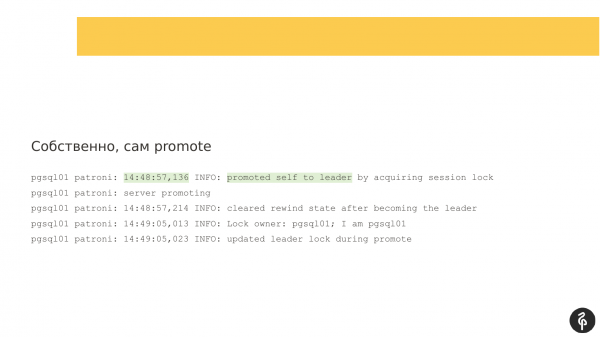
Et pendant ce temps, un basculement automatique s'est produit. Patroni a fonctionné à merveille ici. Notre ancien maître était inaccessible, quelque chose lui arrivait. Et les élections pour un nouveau maître ont commencé. Tout cela s'est bien déroulé. Notre pgsql01 est devenu le nouveau leader.
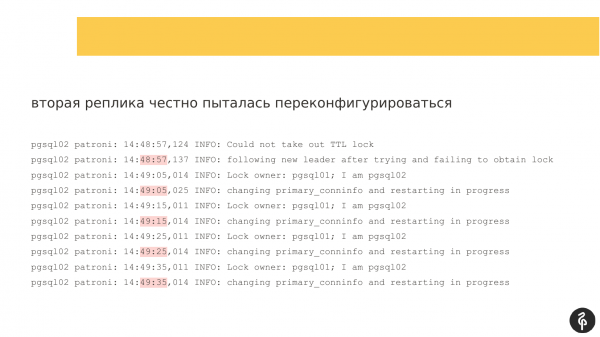
Nous avons une réplique qui est devenue maître. Et il y a une seconde réplique. Et c'est avec cette seconde réplique qu'il y avait des problèmes. Elle essayait de se reconfigurer. D'après ce que je comprends, elle tentait de changer le recovery.conf, de redémarrer Postgres et de se connecter au nouveau maître. Elle envoie des messages toutes les 10 secondes, disant qu'elle essaie, mais n'y parvient pas.
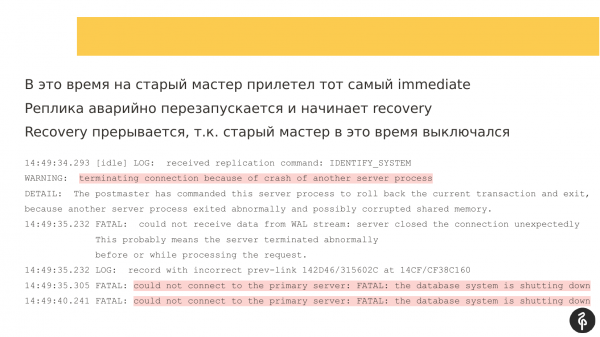
Et pendant ces tentatives, un signal d'arrêt immédiat arrive sur l'ancien maître. Le maître redémarre. Et également, la récupération s'arrête, car l'ancien maître se met à redémarrer. C'est-à-dire que la réplique ne peut pas se connecter à lui parce qu'il est en mode arrêt.
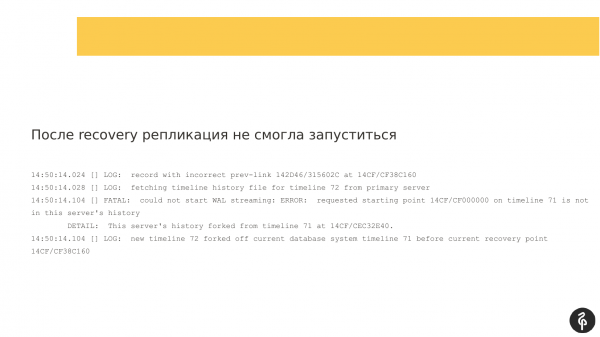
À un moment donné, elle a fonctionné, mais la réplication ne s'est pas lancée.
J'ai une seule hypothèse, c'est que l'adresse de l'ancien maître était dans le recovery.conf. Et quand le nouveau maître est apparu, la seconde réplique essayait toujours de se connecter à l'ancien maître.
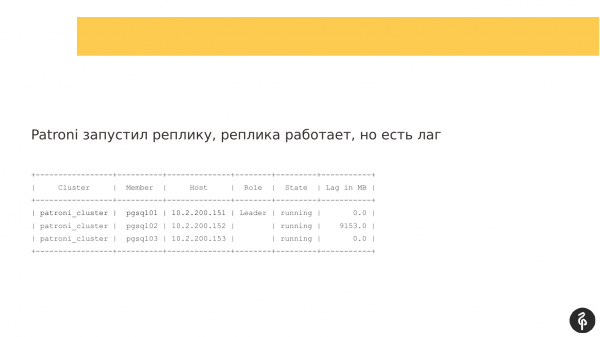
Quand Patroni s'est lancé sur la seconde réplique, le nœud a démarré, mais n'a pas pu se connecter en réplication. Et un retard de réplication s'est formé, qui ressemblait à cela. C'est-à-dire que les trois nœuds étaient présents, mais le second nœud était en retard.
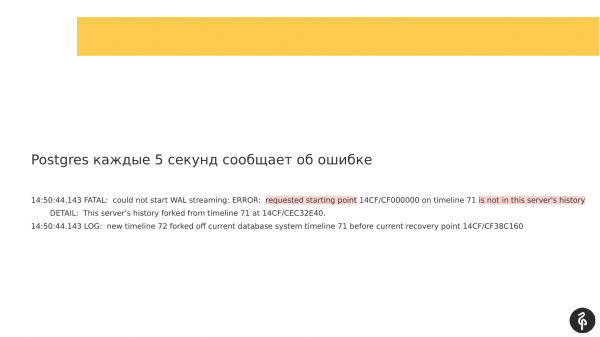
Cependant, si l'on regarde les journaux qui ont été écrits, on peut voir que la réplication ne peut pas démarrer, car les journaux de transactions sont différents. Et les journaux de transactions proposés par le maître, qui sont spécifiés dans recovery.conf, ne conviennent tout simplement pas à notre nœud actuel.
Et ici, j'ai fait une erreur. Je devais aller vérifier ce qu'il y avait dans recovery.conf, pour vérifier mon hypothèse selon laquelle nous ne nous connectons pas au bon maître. Mais à l'époque, je débutais juste avec ça et ça ne m'est pas venu à l'esprit, ou alors j'ai vu que la réplication était en retard et qu'il faudrait la réinitialiser, c'est-à-dire que j'ai un peu travaillé à l'arrache. C'était ma faute.
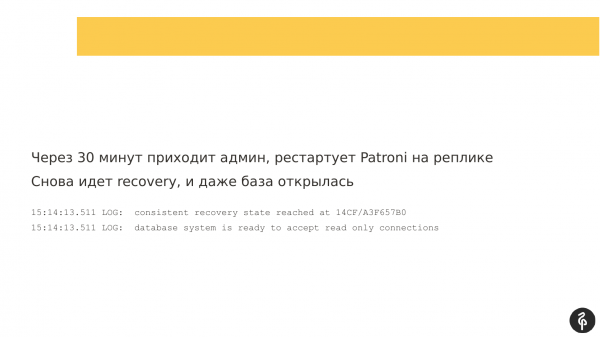
Trente minutes plus tard, l'administrateur est arrivé, c'est-à-dire que j'ai redémarré Patroni sur la réplique. Je l'avais déjà rayée de mes espoirs, je pensais qu'il faudrait la réinitialiser. J'ai donc pensé - je vais redémarrer Patroni, peut-être que ça fera quelque chose de bien. La récupération a démarré. Et la base de données s'est même ouverte, elle était prête à accepter des connexions.
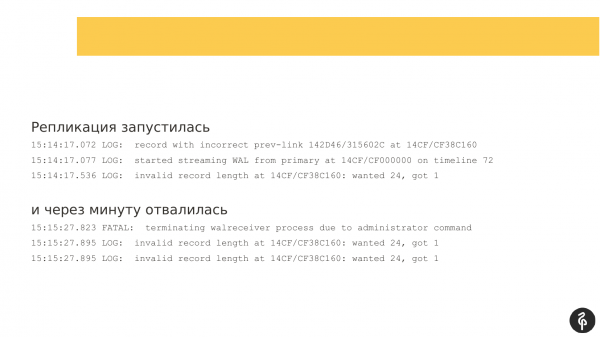
La réplication a démarré. Mais au bout d'une minute, elle s'est arrêtée avec une erreur indiquant que les journaux de transactions ne correspondaient pas.
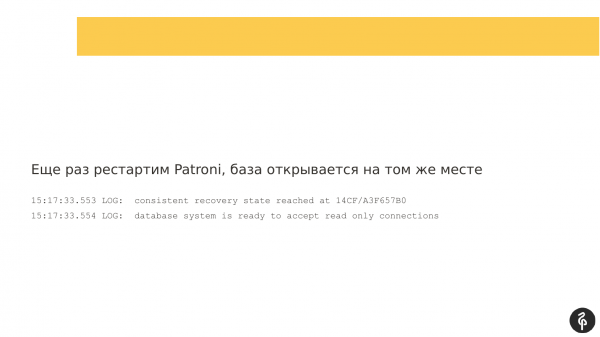
J'ai pensé à redémarrer encore une fois. J'ai redémarré à nouveau Patroni, et je n'ai pas redémarré Postgres, mais j'ai redémarré spécifiquement Patroni en espérant qu'il démarre la base de données par un miracle.
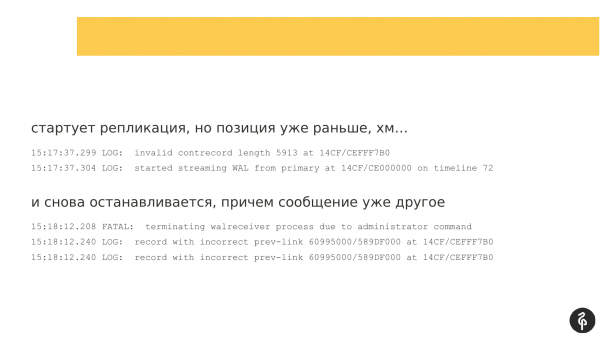
La réplication a redémarré, mais les marques dans les journaux de transactions étaient différentes, elles n'étaient pas celles de la tentative de démarrage précédente. La réplication s'est encore arrêtée. Et le message était déjà légèrement différent. Et il n'était pas très informatif pour moi.
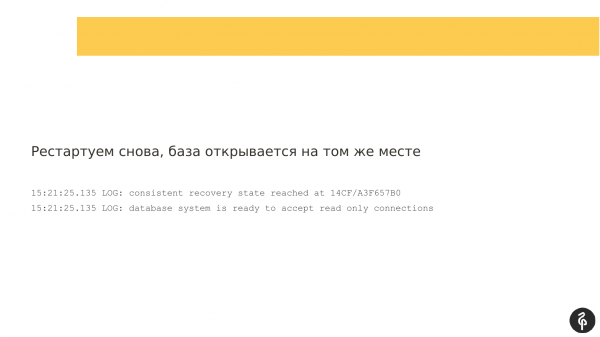
Et là, il m'est venu à l'esprit - et si je redémarre Postgres, pendant ce temps, je fais un checkpoint sur le maître actuel, pour faire avancer la position dans le journal des transactions un peu plus loin, pour que la récupération commence à un autre moment ? De plus, nous avions aussi des réserves de WAL.
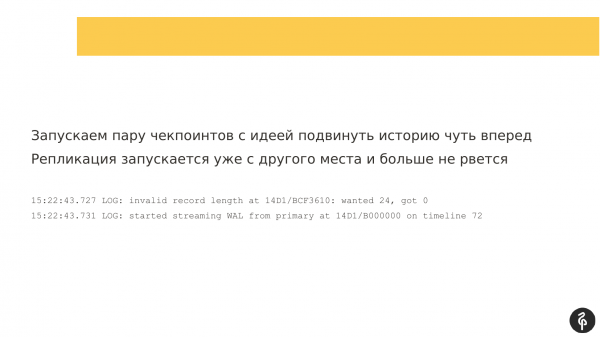
J'ai redémarré Patroni, fait quelques checkpoints sur le maître, quelques points de redémarrage sur la réplique, quand elle s'est ouverte. Et cela a aidé. J'ai longtemps réfléchi à pourquoi cela a fonctionné et comment cela a été possible. Et la réplique a démarré. Et la réplication ne s'est plus interrompue.
Ce problème est l'un des plus mystérieux pour moi, et je me demande encore ce qui se passait réellement.
Quelles sont les conclusions ici ? Patroni peut fonctionner comme prévu et sans erreurs. Mais cela ne garantit pas à 100 % que tout va bien. Une réplique peut se lancer, mais elle peut être dans un état semi-fonctionnel, et l'application ne doit pas travailler avec une telle réplique, car elle contient des données anciennes.
Et après un failover, il est toujours nécessaire de vérifier que tout va bien avec le cluster, c'est-à-dire qu'il y a le nombre nécessaire de répliques et qu'il n'y a pas de retard de réplication.
Et pendant que j'examine ces problèmes, je vais formuler des recommandations. J'ai essayé de les regrouper sur deux diapositives. Peut-être que toutes les histoires pouvaient être réunies en deux diapositives et seulement racontées.
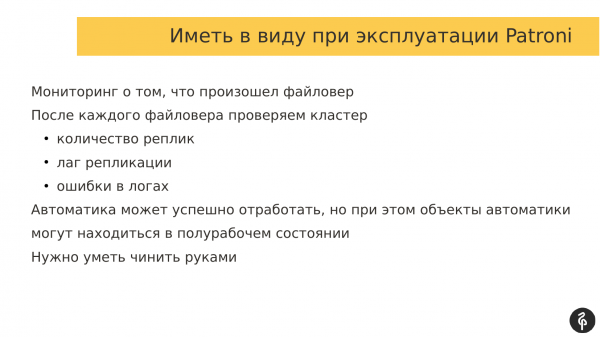
Lorsque vous utilisez Patroni, vous devez absolument avoir un monitoring. Vous devez toujours savoir quand un failover automatique a eu lieu, car si vous ne savez pas qu'un failover automatique s'est produit, vous ne contrôlez pas le cluster. Et c'est mauvais.
Après chaque failover, nous devons toujours vérifier manuellement le cluster. Nous devons nous assurer qu'il y a toujours le nombre actuel de répliques, qu'il n'y a pas de retard de réplication, et qu'il n'y a pas d'erreurs dans les logs liées à la réplication en continu, à Patroni ou au système DCS.
L'automatisation peut fonctionner avec succès, Patroni est un très bon outil. Il peut fonctionner, mais cela ne conduira pas le cluster à l'état souhaité. Et si nous ne le découvrons pas, nous aurons des problèmes.
Et Patroni n'est pas une solution miracle. Nous devons toujours avoir une idée de comment fonctionne Postgres, comment fonctionne la réplication et comment Patroni interagit avec Postgres, et comment l'interaction entre les nœuds est assurée. Cela est nécessaire pour pouvoir résoudre manuellement les problèmes qui surviennent.
Comment aborde-je la question du diagnostic ? Il se trouve que nous travaillons avec différents clients et personne n’a de stack ELK, donc nous devons analyser les logs, en ouvrant 6 consoles et 2 onglets. Dans un onglet, il y a les logs de Patroni pour chaque nœud, dans l'autre, ce sont les logs de Consul, ou les logs de Postgres si nécessaire. Diagnostiquer cela est très difficile.
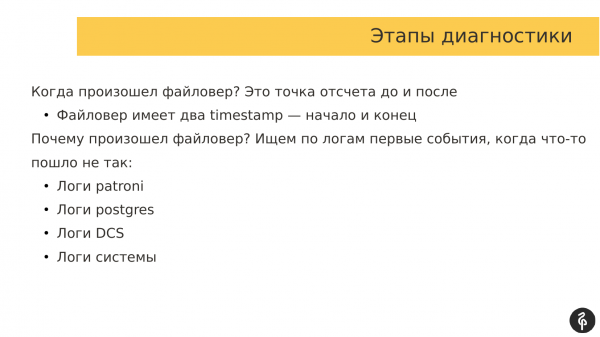
Quelles approches ai-je élaborées ? Premièrement, je regarde toujours quand le failover est survenu. Et pour moi, c'est une sorte de point de séparation. Je regarde ce qui s'est passé avant le failover, pendant le failover et après le failover. Le failover a deux marques : le temps de début et de fin.
Ensuite, je consulte les journaux pour voir les événements avant le basculement, c'est-à-dire que je cherche les raisons pour lesquelles le basculement a eu lieu.
Et cela donne une image de ce qui s'est passé et de ce que nous pouvons faire à l'avenir pour éviter que de telles circonstances ne se reproduisent (et par conséquent, que le basculement ne se produise).
Et où regardons-nous généralement ? Je regarde :
- D'abord dans les journaux de Patroni.
- Ensuite, je regarde les journaux de Postgres ou les journaux DCS, selon ce que j'ai trouvé dans les journaux de Patroni.
- Et les journaux système donnent parfois une idée de ce qui a causé le basculement.
Quel est mon avis sur Patroni ? J'ai une très bonne opinion de Patroni. À mon avis, c'est le meilleur outil qui existe aujourd'hui. Je connais beaucoup d'autres produits. C'est Stolon, Repmgr, Pg_auto_failover, PAF. Quatre outils. Je les ai tous essayés. Patroni est celui qui m'a le plus plu.
Si on me demande : « Recommande-je Patroni ? ». Je dirai oui, parce que j'aime Patroni. Et je pense avoir appris à bien l'utiliser.
Si vous êtes intéressé à voir quels autres problèmes peuvent survenir avec Patroni, à part ceux que j'ai mentionnés, vous pouvez toujours aller sur la page sur GitHub. Il y a beaucoup d'histoires diverses et de nombreux problèmes intéressants y sont discutés. En fin de compte, certains bugs ont été signalés et résolus, c'est-à-dire que c'est une lecture intéressante.
Il y a des histoires intéressantes sur comment des gens se tirent dans le pied. Très instructif. Vous lisez et vous comprenez qu'il ne faut pas faire cela. Je me suis fait un rappel.
Et je tiens à remercier chaleureusement l'entreprise Zalando pour le développement de ce projet, notamment Alexandre Kukushkin et Alexey Klyukin. Alexey Klyukin est l'un des co-auteurs, il ne travaille plus chez Zalando, mais ce sont deux personnes qui ont commencé à travailler avec ce produit.
Et je pense que Patroni est une chose vraiment géniale. Je suis content qu'il existe, c'est intéressant de travailler avec. Et un grand merci à tous les contributeurs qui écrivent des patches pour Patroni. J'espère que Patroni deviendra plus mature, génial et fonctionnel avec le temps. Il est déjà fonctionnel, mais j'espère qu'il s'améliorera encore. Donc si vous envisagez d'utiliser Patroni, n'ayez pas peur. C'est une bonne solution, elle peut être mise en œuvre et utilisée.
C'est tout. Si vous avez des questions, n'hésitez pas à les poser.
Questions
Merci pour la présentation ! Si après le basculement il faut toujours regarder là-dedans de près, pourquoi avons-nous besoin d'un basculement automatique ?
Parce que c'est quelque chose de nouveau. Nous travaillons avec cela depuis seulement un an. Mieux vaut être prudent. Nous voulons entrer et voir si tout a vraiment fonctionné comme prévu. C'est un niveau de méfiance adulte : mieux vaut vérifier et observer.
Par exemple, nous sommes entrés le matin et avons vérifié, n'est-ce pas ?
Pas le matin, nous apprenons généralement l'auto-failover presque immédiatement. Nous recevons des notifications, nous voyons qu'un auto-failover a eu lieu. Nous venons presque immédiatement et vérifions. Mais toutes ces vérifications devraient être déléguées à un niveau de surveillance. Si nous appelons Patroni via l'API REST, il y a un historique. Grâce à cet historique, nous pouvons voir les horodatages des occurrences de failover. Sur cette base, nous pouvons faire de la surveillance. Nous pouvons voir l'historique, combien d'événements ont eu lieu. Si nous avons plus d'événements, cela signifie qu'un auto-failover s'est produit. Nous pouvons aller vérifier. Ou notre automatisation dans la surveillance a vérifié que toutes nos répliques sont en place, qu'il n'y a pas de latence et que tout va bien.
Merci!
Merci beaucoup pour cet excellent récit ! Si nous déplaçons le cluster DCS loin du cluster Postgres, ce cluster doit-il également être entretenu périodiquement ? Quelles sont les meilleures pratiques concernant le fait que certaines parties du cluster DCS doivent être arrêtées, qu'il faut faire quelque chose avec elles, etc. ? Comment toute cette structure fonctionne-t-elle alors ? Et comment faire ces choses ?
Pour une entreprise, il était nécessaire de créer une matrice de problèmes pour savoir ce qui se passe si l'un des composants ou plusieurs composants tombent en panne. À partir de cette matrice, nous passons en revue tous les composants et construisons des scénarios en cas de panne de ces composants. En conséquence, pour chaque scénario de panne, il est possible d'avoir un plan d'action pour la récupération. Et dans le cas du DCS, cela fait partie de l'infrastructure standard. Et l'admin en assure la gestion, et nous comptons déjà sur les admins qui le gèrent et sur leur capacité à le réparer en cas d'urgence. S'il n'y a pas de DCS, nous le déployons, mais nous ne le surveillons pas particulièrement, car nous ne sommes pas responsables de l'infrastructure, mais nous donnons des recommandations sur quoi et comment surveiller.
C'est-à-dire, ai-je bien compris qu'il faut désactiver Patroni, désactiver le failover, désactiver tout avant de faire quoi que ce soit avec les hôtes ?
Cela dépend du nombre de nœuds dans le cluster DCS. S'il y a beaucoup de nœuds et que l'on met hors service seulement un des nœuds (réplique), alors le quorum reste intact dans le cluster. Patroni reste opérationnel et rien n'est déclenché. Si nous avons des opérations complexes touchant plusieurs nœuds, dont l'absence peut compromettre le quorum, alors oui, il peut être judicieux de mettre Patroni en pause. Il dispose d'une commande appropriée : patronictl pause, patronictl resume. Nous mettons simplement en pause, et l'auto-failover ne se déclenche pas pendant ce temps. Nous effectuons une maintenance sur le cluster DCS, puis nous levons la pause et continuons à fonctionner.
Merci beaucoup !
Un grand merci pour la présentation ! Quelle est l'attitude de l'équipe produit face à la possibilité de perte de données ?
Les équipes produits s'en fichent, mais les chefs d'équipe s'inquiètent.
Quelles garanties y a-t-il ?
Les garanties sont très difficiles. Il y a une présentation par Alexandre Koukhouchkine intitulée « Comment calculer RPO et RTO », c'est-à-dire le temps de rétablissement et combien de données nous pouvons perdre. Je pense qu'il faut retrouver ces diapositives et les étudier. Si je me souviens bien, il y a des étapes concrètes sur comment calculer ces éléments. Combien de transactions nous pouvons perdre, combien de données nous pouvons perdre. En option, nous pouvons utiliser la réplication synchrone au niveau de Patroni, mais c'est une épée à double tranchant : soit nous avons la fiabilité des données, soit nous perdons en vitesse. Il existe une réplication synchrone, mais elle ne garantit pas non plus une protection à 100 % contre la perte de données.
Alexeï, merci pour cette excellente présentation ! Avez-vous de l'expérience avec l'utilisation de Patroni pour une protection de niveau zéro ? C'est-à-dire en association avec un standby synchrone ? C'est ma première question. Et ma deuxième question. Vous avez utilisé différentes solutions. Nous avons utilisé Repmgr, mais sans auto-failover et nous prévoyons maintenant de le connecter à l'auto-failover. Nous envisageons Patroni comme une solution alternative. Que pouvez-vous dire des avantages par rapport à Repmgr ?
La première question concernait les répliques synchrones. Personne n'utilise la réplication synchrone chez nous, car tout le monde a peur (Déjà, plusieurs clients l'utilisent, et n'ont pas remarqué de problèmes de performance en général — Note du présentateur). Mais nous avons établi une règle selon laquelle un cluster de réplication synchronisée doit comporter au moins trois nœuds, car si nous avons deux nœuds et que le maître ou la réplique tombe en panne, Patroni met ce nœud en mode autonome pour que l'application continue de fonctionner. Dans ce cas, il y a des risques de perte de données.
Concernant la deuxième question, nous avons utilisé Repmgr et nous l'utilisons encore chez certains clients pour des raisons historiques. Que peut-on dire ? Dans Patroni, le basculement automatique est intégré, alors que dans Repmgr, il s'agit d'une fonctionnalité supplémentaire à activer. Il faut lancer le démon Repmgr sur chaque nœud et alors nous pouvons configurer le basculement automatique.
Repmgr vérifie si les nœuds Postgres sont vivants. Les processus Repmgr vérifient l'existence les uns des autres, ce qui n'est pas une approche très efficace car il peut y avoir des situations complexes d'isolement réseau où un grand cluster Repmgr peut se diviser en plusieurs petits et continuer de fonctionner. Je ne suis plus à jour sur Repmgr, peut-être que cela a été corrigé... ou peut-être pas. Cependant, extraire les informations sur l'état du cluster dans DCS, comme le fait Stolon, Patroni, est la solution la plus viable.
Alexeï, j'ai une question, peut-être naïve. Dans l'un des premiers exemples, vous avez déplacé DCS d'une machine locale à un nœud distant. Nous comprenons que le réseau est une chose avec ses particularités, il vit par lui-même. Que se passe-t-il si pour une raison quelconque, le cluster DCS devient inaccessible ? Je ne vais pas énumérer les raisons, il peut y en avoir beaucoup : des erreurs de configuration réseau à de réels problèmes.
Je ne l'ai pas dit à voix haute, mais le cluster DCS doit également être tolérant aux pannes, c'est-à-dire un nombre impair de nœuds, afin qu'un quorum puisse se former. Que se passe-t-il si le cluster DCS devient inaccessible, ou ne peut pas rassembler un quorum, c’est-à-dire en cas de défaillance réseau ou de panne des nœuds ? Dans ce cas, le cluster Patroni passe en mode lecture seule. Le cluster Patroni ne peut pas déterminer l'état du cluster et ce qu'il doit faire. Il ne peut pas communiquer avec DCS et enregistrer un nouvel état du cluster, donc tout le cluster passe en mode lecture seule. Il attend soit une intervention manuelle de l'opérateur, soit le rétablissement de DCS.
Grossièrement, DCS devient pour nous un service aussi important que la base elle-même ?
Oui, oui. Dans de nombreuses entreprises modernes, la découverte de services est une partie intégrante de l'infrastructure. Elle est mise en œuvre même avant qu'une base de données n'existe dans l'infrastructure. Pour le dire autrement, lorsque l'infrastructure est lancée, qu'elle est déployée dans un centre de données, nous avons immédiatement la découverte de services. Si c'est Consul, le DNS peut même y être construit. Si c'est Etcd, cela peut faire partie d'un cluster Kubernetes, où tout le reste sera déployé. Je pense que la découverte de services est déjà une composante indispensable des infrastructures modernes. Et on y pense bien avant les bases de données.
Merci!
Source : habr.com
