

Salut, Habr !
Nous vous rappelons que nous avons publié un autre livre extrêmement intéressant et utile Modèlesintense Kubernetes a fondamentalement changé les modèles traditionnels de développement et de déploiement d'applications. Désormais, une équipe peut passer seulement quelques jours à développer, tester et déployer une application dans différents environnements, le tout au sein de clusters Kubernetes. Ce type de travail avec les technologies des générations précédentes prenait généralement des semaines, voire des mois.
Cette accélération est rendue possible grâce à l'abstraction fournie par Kubernetes — c'est-à-dire grâce au fait que Kubernetes se charge des interactions avec les détails de bas niveau des machines physiques ou virtuelles, permettant aux utilisateurs de déclarer, parmi d'autres paramètres, le processeur nécessaire, la quantité de mémoire requise, et le nombre d'instances de conteneurs. Étant donné que le soutien de Kubernetes est assuré par une énorme communauté et que l'adoption de Kubernetes ne cesse de croître, il est de loin le leader parmi toutes les plateformes d'orchestration de conteneurs.
À mesure que l'utilisation de Kubernetes s'étend, la confusion concernant les modèles de stockage des données appliqués augmente également.
Dans une compétition générale pour une part de marché dans Kubernetes (c'est-à-dire pour le stockage des données), lorsqu'il s'agit de parler de stockage de données, le signal se perd dans un bruit fort..
Kubernetes incarne un modèle moderne de développement et de déploiement d'applications, ainsi que de gestion de celles-ci. Ce modèle moderne dissocie le stockage des données des calculs. Pour comprendre pleinement cette dissociation dans le contexte de Kubernetes, il est également nécessaire de comprendre ce que sont les applications à état et sans état, ainsi que la manière dont cela s'articule avec le stockage des données. C'est ici que l'approche REST API utilisée par S3 présente des avantages clairs par rapport à l'approche POSIX/CSI, typique d'autres solutions.
Kubernetes incarne un modèle moderne de développement et de déploiement d'applications, ainsi que de leur gestion. Ce modèle moderne dissocie le stockage des données des calculs. Pour comprendre pleinement cette dissociation dans le contexte de Kubernetes, il est également nécessaire de comprendre ce que sont les applications qui gèrent l'état et celles qui ne le gèrent pas, ainsi que la manière dont cela s'associe au stockage des données. C'est ici que l'approche REST API, appliquée par S3, présente des avantages évidents par rapport à l'approche POSIX/CSI, caractéristique d'autres solutions.
Dans cet article, nous allons parler des schémas de stockage des données dans Kubernetes et aborderons séparément le débat sur les applications fonctionnant avec et sans état, afin de bien comprendre la différence entre elles et pourquoi elle est importante. Par la suite, nous examinerons les applications et les schémas de stockage des données qui les concernent à la lumière des meilleures pratiques en matière de conteneurs et de Kubernetes.
Conteneurs sans état
Les conteneurs sont, par nature, légers et éphémères. Ils peuvent être arrêtés, supprimés ou déployés sur un autre nœud en quelques secondes. Dans un grand système d'orchestration de conteneurs, ces opérations se produisent constamment, et les utilisateurs ne remarquent même pas ces changements. Cependant, les déplacements ne sont possibles que si le conteneur n'a aucune dépendance vis-à-vis du nœud sur lequel il se trouve. Ces conteneurs sont dits fonctionner sans état.
Conteneurs avec état
Si un conteneur stocke des données sur des dispositifs locaux connectés (ou sur un dispositif de bloc), le stockage où il se trouve devra être déplacé vers un nouveau nœud avec le conteneur lui-même en cas de défaillance. C'est crucial, car sinon, l'application exécutée dans le conteneur ne pourra pas fonctionner correctement, car elle a besoin d'accéder aux données stockées sur des supports locaux. Ces conteneurs sont dits fonctionner avec état.
D'un point de vue purement technique, les conteneurs avec état peuvent également être déplacés vers d'autres nœuds. Cela est généralement réalisé à l'aide de systèmes de fichiers distribués ou de stockage en réseau de blocs attaché à tous les nœuds sur lesquels les conteneurs fonctionnent. Ainsi, les conteneurs peuvent accéder aux volumes pour le stockage persistant des données, et l'information est stockée sur des disques répartis sur le réseau. J'appellerai cette méthode «approche conteneur avec état», et je l'appellerai ainsi pour le reste de l'article afin d'assurer une uniformité.
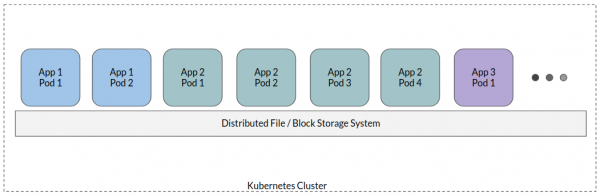
Dans une approche typique des conteneurs avec état, tous les pods d'application sont attachés à un système de fichiers distribué unique - on obtient une sorte de stockage partagé, où toutes les données des applications sont rassemblées. Bien que des variations soient possibles, c'est une approche de haut niveau.
Voyons maintenant pourquoi l'approche des conteneurs avec état est un anti-modèle dans un monde axé sur le cloud.
Conception d'applications axée sur le cloud
Traditionnellement, les applications utilisaient des bases de données pour le stockage structuré des informations et des disques locaux ou des systèmes de fichiers distribués où toutes les données non structurées, voire semi-structurées, étaient déposées. À mesure que les volumes de données non structurées augmentaient, les développeurs ont réalisé que POSIX était trop 'bavard', entraînant des coûts significatifs et, en fin de compte, entravant le fonctionnement des applications lors de la transition vers des échelles véritablement larges.
Cela a principalement contribué à l'émergence d'une nouvelle norme de stockage de données, à savoir les stockages axés sur le cloud, fonctionnant principalement sur la base d'API REST et libérant l'application de l'entretien fastidieux du stockage de données local. Dans ce cas, l'application fonctionne en mode sans état (puisque l'état se trouve dans un stockage distant). Les applications modernes sont construites dès le départ en tenant compte de ce facteur. En général, toute application moderne qui traite des données de tout type (logs, métadonnées, blobs, etc.) est basée sur une parologie axée sur le cloud, où l'état est transféré dans un système logiciel spécifiquement dédié à son stockage.
L'approche des conteneurs avec état ramène toute cette parologie à son point de départ !
Lors de l'utilisation des interfaces POSIX pour le stockage des données, les applications fonctionnent de manière similaire à la manière dont elles sauvegardent l'état. Cette approche s'éloigne des postulats les plus importants de la conception cloud-native, à savoir la capacité d'ajuster la taille des flux de travail des applications en fonction de la charge d'entrée, de basculer vers un nouveau nœud dès qu'un nœud actuel échoue, et ainsi de suite.
En examinant cette situation de plus près, nous découvrons qu'en choisissant un stockage de données, nous rencontrons encore et encore le dilemme « POSIX contre REST API », MAIS avec des problèmes supplémentaires liés à POSIX en raison de la nature distribuée des environnements Kubernetes. En particulier,
- POSIX bavard: La sémantique POSIX exige d'associer des métadonnées et des descripteurs de fichiers à chaque opération, ce qui aide à maintenir l'état de l'opération. Cela entraîne des coûts significatifs, sans réelle valeur ajoutée. Les API de stockage d'objets, en particulier l'API S3, se sont débarrassées de ces exigences, permettant à l'application d'agir, puis d'« oublier » l'appel. La réponse du système de stockage indique si l'action a été exécutée avec succès ou non. En cas d'échec, l'application peut essayer à nouveau.
- Limitations réseau: Dans un système distribué, on suppose qu'il peut exister de nombreuses applications essayant d'écrire des données sur un même support attaché. Par conséquent, non seulement les applications vont rivaliser entre elles pour la bande passante (pour envoyer des données sur le support), mais le système de stockage lui-même va également rivaliser pour cette bande passante, répartissant les données sur des disques physiques. En raison du caractère bavard de POSIX, le nombre d'appels réseau augmente de plusieurs fois. D'autre part, l'API S3 fournit une séparation claire des appels réseau entre ceux qui proviennent du client au serveur et ceux qui se produisent à l'intérieur du serveur.
- Sécurité: Le modèle de sécurité POSIX nécessite une participation active de l'utilisateur : les administrateurs configurent des niveaux d'accès spécifiques pour chaque utilisateur ou groupe. Cette approche est difficile à adapter à un monde axé sur le cloud. Les applications modernes s'appuient sur des modèles de sécurité basés sur des API, où les droits d'accès sont définis comme un ensemble de politiques, des comptes de service sont créés, des identifiants temporaires, etc.
- Gestion: Les conteneurs avec état impliquent certains coûts de gestion. Il s'agit de synchroniser l'accès parallèle aux données, d'assurer la cohérence des données, tout cela nécessite de réfléchir attentivement aux modèles d'accès aux données à utiliser. Il faut installer, contrôler et configurer des programmes supplémentaires, sans parler des efforts supplémentaires consacrés au développement.
Interface de stockage de conteneurs de données
Alors que l'interface de stockage de conteneurs (CSI) a bien aidé à la distribution du niveau des volumes Kubernetes, en le transférant en partie à des fournisseurs de stockage tiers, elle a également contribué par inadvertance à la conviction que l'approche des conteneurs avec état est la méthode recommandée pour le stockage de données dans Kubernetes.
Le CSI a été conçu comme un standard pour offrir des systèmes de stockage de données en bloc et de fichiers à des applications héritées fonctionnant avec Kubernetes. Et, comme le montre cet article, la seule situation dans laquelle l'approche des conteneurs avec état (et le CSI dans sa forme actuelle) est justifiée, c'est lorsque l'application elle-même est un système hérité pour lequel il est impossible d'ajouter le support des API de stockage d'objets.
Il est important de comprendre qu'en utilisant le CSI dans sa forme actuelle, c'est-à-dire en montant des volumes lors de l'utilisation d'applications modernes, nous rencontrerons à peu près les mêmes problèmes que ceux rencontrés dans les systèmes où le stockage de données est organisé selon le style POSIX.
Une approche de meilleure qualité
Dans ce cas, il est important de comprendre que la plupart des applications ne sont pas conçues pour fonctionner avec ou sans état. Ce comportement dépend de l'architecture générale du système et des choix spécifiques faits lors de la conception. Parlons un peu des applications qui conservent l'état.
En principe, toutes les données des applications peuvent être réparties en plusieurs types vastes :
- Données de logs
- Données de tampons temporels
- Données de transactions
- Métadonnées
- Images de conteneurs
- Données de blobs (objets binaires volumineux)
Tous ces types de données sont très bien pris en charge sur les plateformes de stockage modernes, et il existe plusieurs plateformes orientées cloud adaptées pour fournir des données dans chacun de ces formats spécifiques. Par exemple, les données de transactions et les métadonnées peuvent se trouver dans une base de données orientée cloud moderne telle que CockroachDB, YugaByte, etc. Les images de conteneurs ou les données de blobs peuvent être stockées dans un registre docker basé sur MinIO. Les données de tampons temporels peuvent être stockées dans une base de données de séries temporelles, par exemple InfluxDB, etc. Nous n'entrerons pas ici dans les détails de chaque type de données et des applications correspondantes, mais l'idée générale est d'éviter le stockage persistant des données basé sur le montage local des disques.
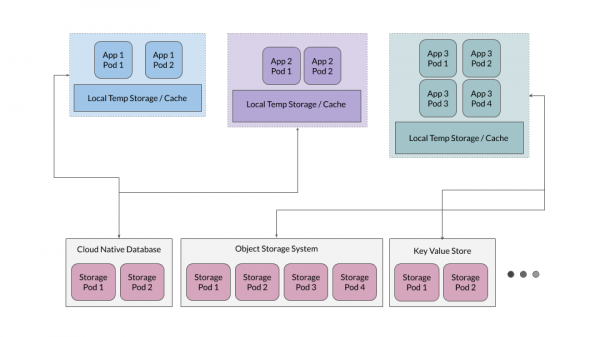
De plus, il s'avère souvent efficace de fournir un niveau de mise en cache temporaire, servant d'espace de stockage pour les fichiers temporaires des applications, mais celles-ci ne doivent pas dépendre de ce niveau comme source de vérité.
Stockage pour les applications avec état
Alors que dans la plupart des cas, il est utile de garder les applications sans état, celles qui sont destinées à stocker des données – par exemple, les bases de données, les stockages d'objets, les stockages clé-valeur – doivent conserver l'état. Comprenons pourquoi ces applications se déploient sur Kubernetes. Prenons MinIO comme exemple, mais des principes similaires s'appliquent à tout autre grand système de stockage orienté cloud.
Les applications orientées vers le cloud sont conçues pour maximiser l'utilisation de la flexibilité inhérente aux conteneurs. Cela signifie qu'aucune hypothèse n'est faite concernant l'environnement dans lequel elles seront déployées. Par exemple, MinIO utilise un mécanisme interne de codage d'effacement, garantissant que le système reste opérationnel même en cas de pannes de la moitié des disques. MinIO gère également l'intégrité et la sécurité des données en utilisant son propre hachage et le chiffrement côté serveur.
Pour de telles applications orientées vers le cloud, les volumes persistants locaux (PV) sont particulièrement adaptés comme stockage de secours. Un PV local permet le stockage de données brutes, tandis que les applications fonctionnant au-dessus de ces PV collectent elles-mêmes des informations permettant de mettre à l'échelle les données et de gérer les exigences croissantes en matière de données.
Cette approche est beaucoup plus simple et s'échelonne bien mieux que les PV basés sur CSI, qui apportent leurs propres niveaux de gestion des données et de redondance dans le système ; ces niveaux entrent généralement en conflit avec les applications conçues sur le principe de conservation de l'état.
Un mouvement sûr vers le découplage des données et du calcul
Dans cet article, nous avons discuté de la manière dont les applications se réorientent vers des opérations sans état, ou en d'autres termes, comment le stockage des données est séparé des calculs qui leur sont appliqués. En conclusion, examinons quelques exemples réels de cette tendance.
, la célèbre plateforme d'analyse de données, a traditionnellement été utilisée avec état et déployée dans le système de fichiers HDFS. Cependant, à mesure que Spark entre dans le monde orienté vers le cloud, cette plateforme est de plus en plus utilisée sans état en utilisant `s3a`. Spark utilise s3a pour transmettre des états à d'autres systèmes, tandis que les conteneurs Spark eux-mêmes fonctionnent entièrement sans état. D'autres grands acteurs de l'analyse des grandes données, notamment , , font également la transition vers une séparation du stockage des données et des calculs qui s'y appliquent.
Des modèles similaires peuvent également être observés sur d'autres grandes plateformes d'analyse, telles que Presto, Tensorflow to R, Jupyter. En extrayant l'état vers des systèmes de stockage cloud distants, il devient beaucoup plus facile de gérer votre application et de l'évoluer. De plus, cela favorise la portabilité de l'application dans divers environnements.
Source : habr.com
