

On pourrait penser que les développeurs de Terraform offrent des bonnes pratiques assez pratiques pour travailler avec l'infrastructure AWS. Cependant, il y a un détail. Avec le temps, le nombre d'environnements augmente, chacun ayant ses particularités. Une presque copie de la pile d'applications apparaît dans la région voisine. Et le code Terraform doit être soigneusement copié et modifié selon les nouvelles exigences ou être transformé en neige.
Ma présentation porte sur les modèles dans Terraform pour lutter contre le chaos et la routine manuelle sur de grands projets prolongés.
Vidéo :
J'ai 40 ans et je travaille dans l'informatique depuis 20 ans. Je suis avec l'entreprise Ixtens depuis 12 ans. Nous nous occupons du développement orienté e-commerce. Et cela fait 5 ans que je pratique des pratiques DevOps.
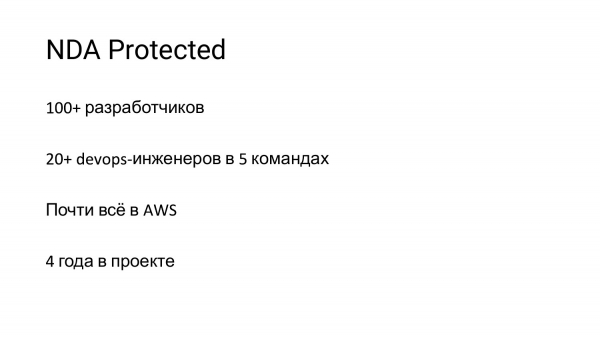
Mon récit concernera l'expérience d'un projet dans une entreprise dont je ne donnerai pas le nom, me protégeant par un accord de non-divulgation.
Les chiffres sur la diapositive indiquent l'échelle du projet. Et tout ce que je vais dire par la suite sera lié à Amazon.
J'ai rejoint ce projet il y a 4 ans. Et à ce moment-là, nous étions en plein milieu du refactoring de l'infrastructure, car le projet avait considérablement évolué. Les modèles utilisés n'étaient plus adaptés. Étant donné toute la croissance prévue du projet, il fallait innover.
Merci à Matvey, qui a parlé hier de ce qui se passait chez Dodo Pizza. C'est ce qu'il nous est arrivé il y a 4 ans.
Les développeurs sont venus et ont commencé à créer du code d'infrastructure.
Les raisons les plus évidentes pour lesquelles cela était nécessaire étaient le besoin de rapidité de mise sur le marché. Il fallait que l'équipe DevOps ne soit pas un goulet d'étranglement lors du déploiement. En outre, au tout début, nous avons utilisé Terraform et Puppet.
Terraform est un projet open source de l'entreprise HashiCorp. Et pour ceux qui ne savent pas du tout ce que c'est, les prochaines diapositives.
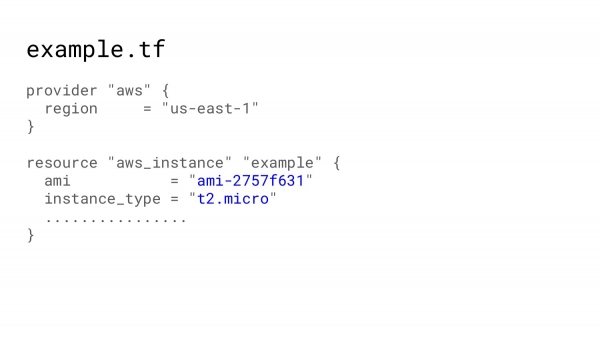
L'infrastructure en tant que code signifie que nous pouvons décrire notre infrastructure et demander à des robots de faire en sorte que nous obtenions les ressources que nous avons décrites.
Par exemple, nous avons besoin machine virtuelle. Nous allons le décrire, en ajoutant quelques paramètres obligatoires.
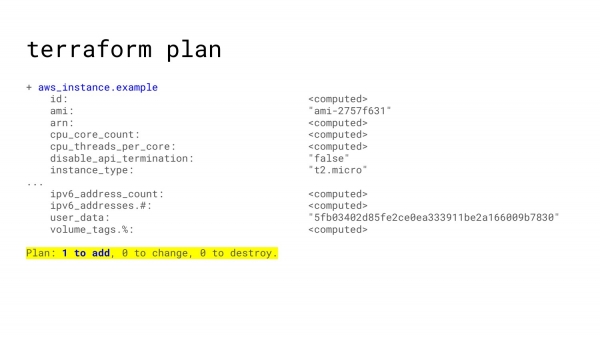
Après cela, nous configurerons l'accès à Amazon dans la console. Et nous demanderons à Terraform de planifier. Terraform plan dira : « Ok, pour votre ressource, nous pouvons faire ces choses-là ». Et, au minimum, une ressource sera ajoutée. Et aucun changement n'est prévu.
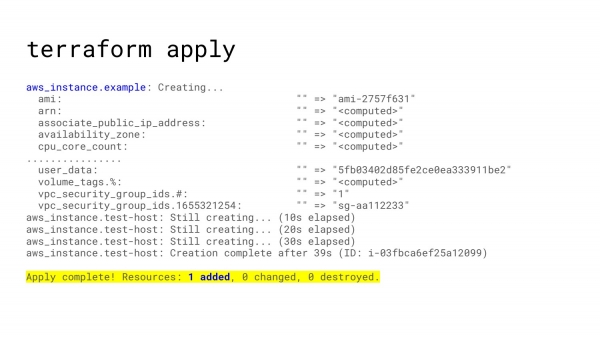
Une fois que tout vous convient, vous pouvez demander à Terraform d'appliquer et Terraform créera votre instance, et vous obtiendrez une machine virtuelle dans votre cloud.
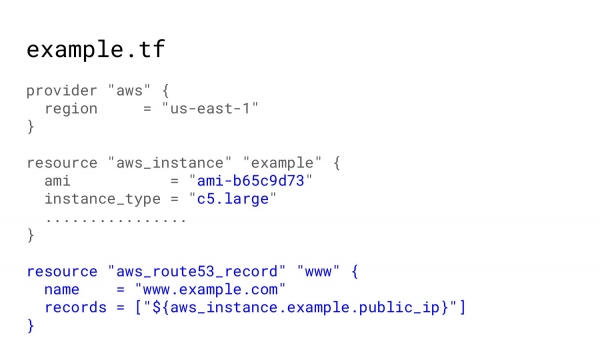
Ensuite, notre projet évolue. Nous apportons quelques modifications. Nous demandons plus d'instances, nous ajoutons 53 enregistrements.
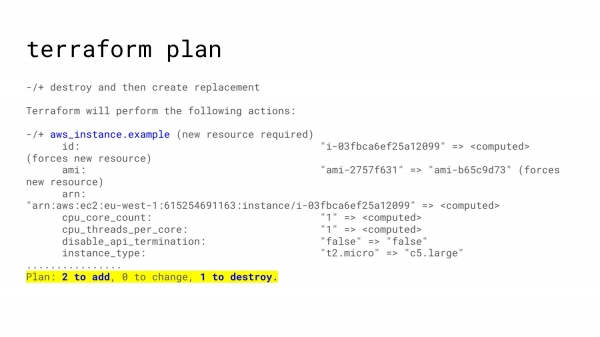
Et nous répétons. Nous demandons le plan. Nous voyons quelles modifications sont prévues. Nous les appliquons. Ainsi, notre infrastructure croît.
Terraform utilise ce qu'on appelle des fichiers d'état. C'est-à-dire que toutes les modifications envoyées sur Amazon sont enregistrées dans un fichier où, pour chaque ressource que vous avez décrite, il y a des ressources correspondantes qui ont été créées sur Amazon. Ainsi, lorsqu'une description de ressource est modifiée, Terraform sait exactement ce qu'il doit changer sur Amazon.
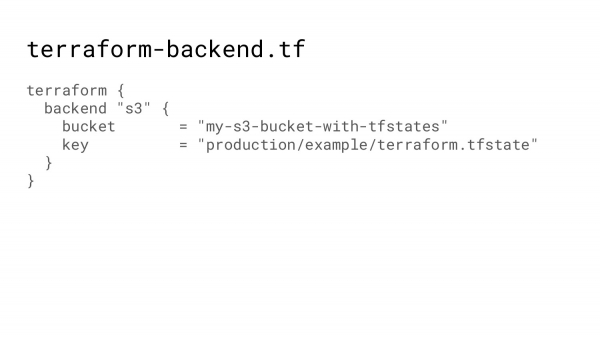
Ces fichiers d'état étaient à l'origine de simples fichiers. Et nous les stockions dans Git, ce qui était très peu pratique. Quelqu'un oubliait constamment de commettre les modifications, ce qui entraînait de nombreux conflits.
Il est maintenant possible d'utiliser un backend, c'est-à-dire que Terraform peut être indiqué dans quel bucket, sous quelle clé, le fichier d'état doit être enregistré. Et Terraform se chargera de récupérer ce fichier d'état, de faire toute la magie et de remettre le résultat final.
Notre infrastructure grandit. Voici notre code. Et nous ne voulons plus simplement créer une machine virtuelle, nous voulons un environnement de test.
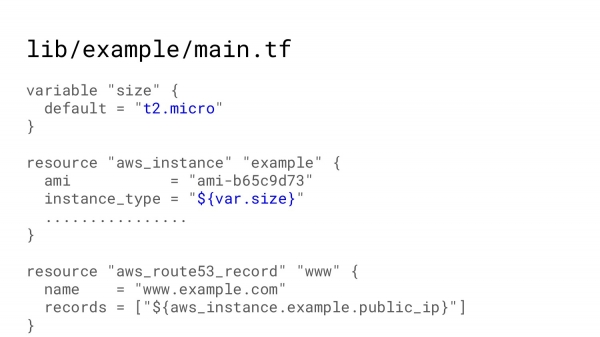
Terraform permet de créer ce qu'on appelle un module, c'est-à-dire de décrire la même chose dans un certain dossier.
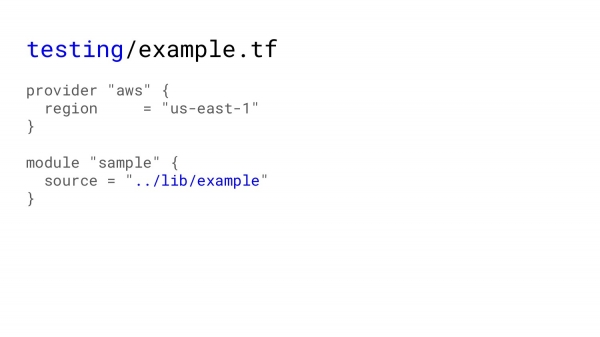
Et, par exemple, dans le test, appeler ce module et obtenir la même chose comme si nous avions exécuté Terraform apply dans le module lui-même. Voici le code pour le test.
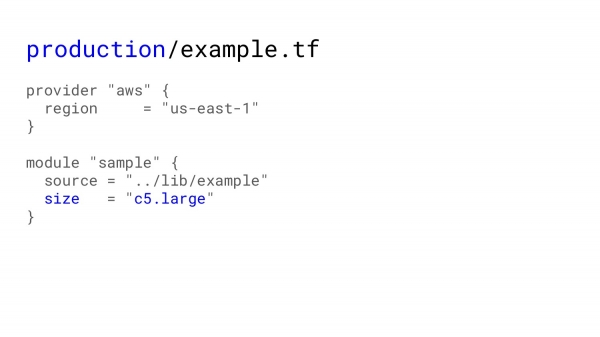
Pour la production, nous pouvons y envoyer certaines modifications, car dans le test, nous n'avons pas besoin de grosses instances, alors que dans la production, de grandes instances seront utiles.
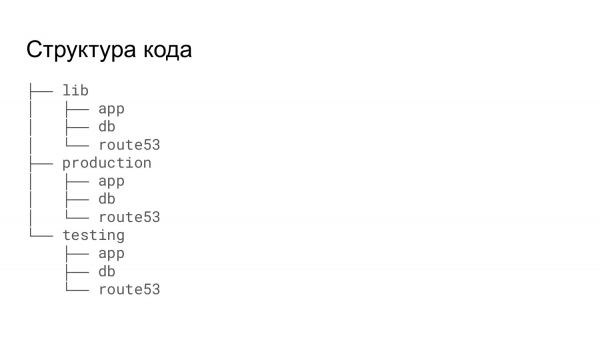
Et ensuite, je reviendrai au projet. La tâche était complexe, l'infrastructure était prévue pour être très grande. Il fallait trouver un moyen de structurer tout le code pour qu'il soit pratique pour tous : pour ceux qui assurent la maintenance de ce code et pour ceux qui y apportent des modifications. Il était prévu que tout développeur puisse accéder et modifier l'infrastructure comme il le fallait pour sa partie de la plateforme.
C'est l'arbre des répertoires recommandé par HashiCorp. Si vous avez un grand projet, il y a du sens à diviser toute l'infrastructure en petites parties et à décrire chaque morceau dans un dossier distinct.
Avec une bibliothèque de ressources étendue, on peut appeler à peu près la même chose dans les tests et en production.
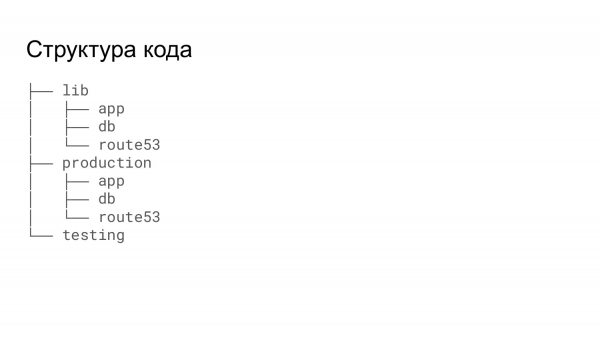
Dans notre cas, ce n'était pas tout à fait approprié, car il fallait obtenir la pile de test pour les développeurs ou pour les tests d'une manière plus simple. Nous ne voulions pas parcourir les dossiers et appliquer dans la bonne séquence, en nous préoccupant de ce que la base de données serait érigée, puis l'instance qui utilise cette base se lèverait. Donc, tout le test était lancé à partir d'un seul dossier. Les mêmes modules étaient appelés, mais tout était traité en une seule fois.
Terraform s'occupe de toutes les dépendances. Et il crée toujours les ressources dans l'ordre, de sorte que l'on peut obtenir une adresse IP, par exemple, d'une instance nouvellement créée, et obtenir cette adresse IP dans une entrée route53.
De plus, la plateforme est très grande. Et le lancement d'une pile de test, même pour une heure, même pour 8 heures, est un processus assez coûteux.
Nous avons automatisé cela. Et le job Jenkins permettait de lancer la pile. Il fallait lancer une demande de tirage avec les modifications que le développeur souhaitait tester, spécifier toutes les options nécessaires, les composants, ainsi que les tailles. S'il voulait effectuer des tests de performance, il pouvait prendre plus d'instances. S'il voulait juste vérifier qu'un formulaire certain s'ouvrait, il pouvait démarrer avec les minimums. Et il pouvait également indiquer si un cluster était nécessaire ou non, etc.
Ensuite, Jenkins poussait un script shell qui modifiait un peu le code dans le dossier Terraform. Il supprimait les fichiers inutiles, ajoutait les fichiers nécessaires. Et puis, avec un seul passage, Terraform apply faisait monter la pile.
Et ensuite, d'autres étapes suivaient, dont je ne veux pas m'approfondir.
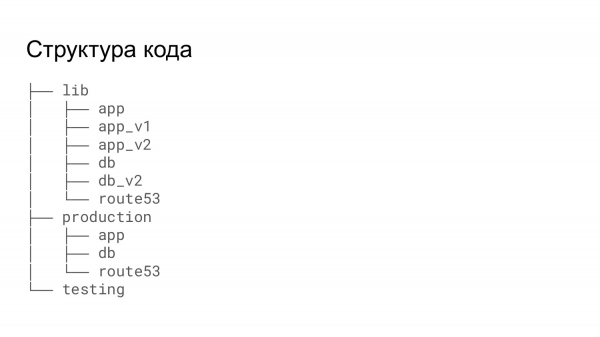
Parce que pour les tests, nous avions besoin de quelques options de plus que dans la production, nous devions faire des copies de modules, afin que nous puissions y ajouter les fonctionnalités qui ne sont nécessaires qu'aux tests.
Et il se trouve qu'en testing, on aimerait tester les modifications qui finiront par aller en production. Mais en réalité, on testait une chose, tandis qu'en production, une autre chose était appliquée. Et il y avait un petit décalage, car en production, toutes les modifications étaient mises en œuvre par l'équipe d'opérations. Parfois, il arrivait que les modifications qui devaient passer des tests à la production restaient dans une version différente.
De plus, il y avait un problème où un nouveau service était ajouté, qui différait légèrement d'un service déjà existant. Au lieu de modifier le module existant, il fallait en faire une copie et y apporter les modifications nécessaires.
En réalité, Terraform n'est pas un vrai langage. C'est une déclaration. Si nous devons déclarer quelque chose, nous le faisons. Et tout cela fonctionne.
À un moment donné, lors de la discussion d'une de mes demandes de tirage, un de mes collègues a dit qu'il ne fallait pas créer trop de flocons. J'ai été intrigué par ce qu'il voulait dire. Il existe un fait scientifique selon lequel il n'y a pas deux flocons de neige identiques dans le monde, tous sont légèrement différents. Et dès que j'ai entendu cela, j'ai ressenti tout le poids du code Terraform. Parce qu'il fallait passer d'une version à une autre, Terraform exigeait un changement de chaîne disruptive, c'est-à-dire que le code n'était plus compatible avec la version suivante. Il fallait donc faire une demande de tirage qui couvrait presque la moitié des fichiers de l'infrastructure, afin de mettre l'infrastructure à jour vers la version suivante de Terraform.
Et après qu'un tel flocon soit apparu, tout le code Terraform que nous avions se transformait en une énorme montagne de neige.
Pour un développeur externe, en dehors de l'opération, cela n'a pas beaucoup d'importance, car il a fait une demande de tirage, sa ressource a démarré. Et voilà, après, ce n'est plus son souci. Mais pour l'équipe DevOps, qui veille à ce que tout soit en ordre, il faut faire tous ces changements. Et le coût de ces modifications augmentait considérablement avec chaque flocon supplémentaire.
Il y a une histoire sur un étudiant qui dessine à la craie sur un tableau deux cercles parfaits pendant un séminaire. Et l'enseignant s'étonne de la façon dont il a réussi à dessiner si précisément sans compas. L'étudiant répond : « C'est très simple, j'ai passé deux ans dans l'armée à tourner une hachoir à viande ».
Et parmi les quatre années passées dans ce projet, environ deux ans, je me consacre à Terraform. Bien sûr, j'ai quelques astuces, quelques conseils pour simplifier le code Terraform, travailler avec lui comme avec un langage de programmation et réduire la charge sur les développeurs qui doivent maintenir ce code à jour.
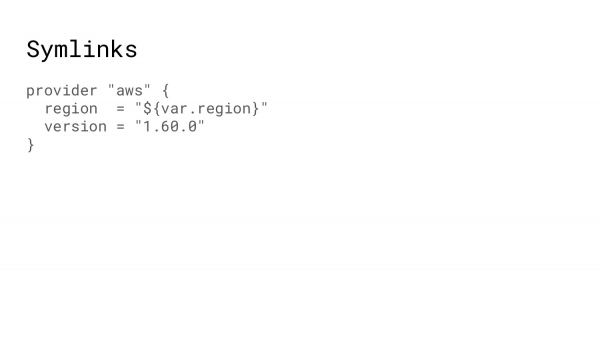
La première chose que je voudrais aborder, ce sont les Symlinks. Terraform a beaucoup de code répétitif. Par exemple, l'appel au fournisseur se retrouve pratiquement à chaque endroit où nous créons un morceau d'infrastructure, c'est toujours le même. Il est donc logique de le déplacer dans un dossier séparé. Et partout où le fournisseur est nécessaire, il faut créer des Symlinks vers ce fichier.
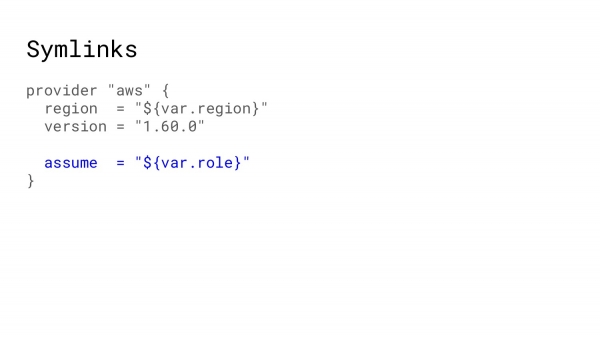
Par exemple, vous avez dans la production un rôle supposé qui vous permet d'obtenir des droits d'accès à un certain compte Amazon externe. En changeant un seul fichier, tous les autres dans l'arborescence des ressources auront les droits requis pour que Terraform sache à quel segment Amazon s'adresser.
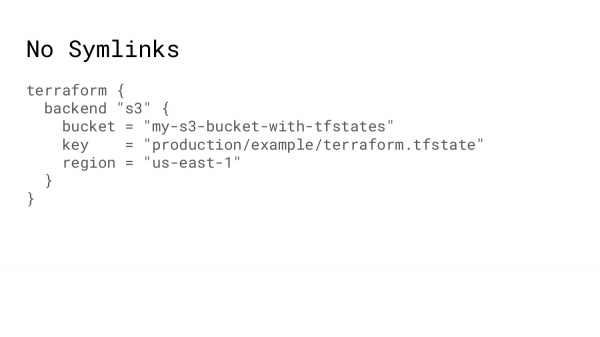
Où les Symlinks ne fonctionnent-ils pas ? Comme je l'ai dit, dans Terraform, il y a des fichiers d'état. Et ils sont très, très bons. Mais le fait est que Terraform initialise le backend en premier. Et il ne peut pas utiliser dans ces paramètres des variables, elles doivent toujours être écrites en texte.
En conséquence, quand quelqu'un crée une nouvelle ressource, il copie une partie du code d'autres dossiers. Il peut se tromper avec la clé ou le bucket. Par exemple, il crée une chose sandbox et puis le fait en production. Il peut alors se retrouver avec le bucket en production utilisé depuis sandbox. Bien sûr, cela sera rapidement découvert. Cela peut être corrigé d'une manière ou d'une autre, mais néanmoins, c'est une perte de temps et, dans une certaine mesure, de ressources.
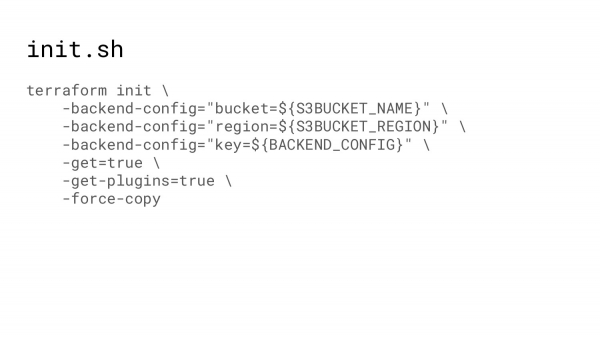
Que pouvons-nous faire ensuite ? Avant de travailler avec Terraform, il doit être initialisé. Lors de l'initialisation, Terraform télécharge tous les plugins. À un certain moment, il a été fragmenté d'un monolithe à une architecture plus microservices. Il est donc toujours nécessaire d'exécuter Terraform init pour qu'il télécharge tous les modules, tous les plugins.
Et on peut utiliser un script shell qui, d'une part, pourra récupérer toutes les variables. Un script shell n'est soumis à aucune limitation. D'autre part, les chemins. Si nous utilisons toujours le chemin présent dans le dépôt comme clé vers le fichier d'état, alors, par conséquent, l'erreur ici sera exclue.
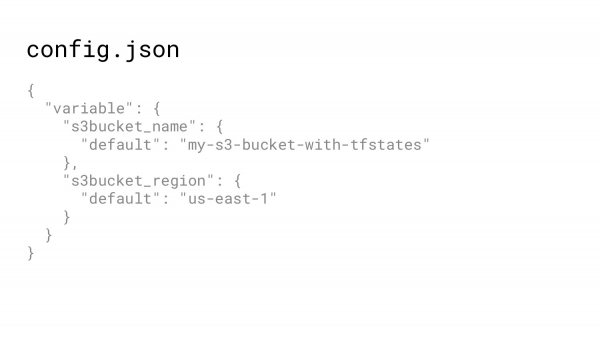
D'où obtenir des données ? D'un fichier JSON. Terraform permet d'enregistrer l'infrastructure non seulement en hcl (HashiCorp Configuration Language), mais aussi en JSON.
Le JSON est facilement lisible à partir d'un script shell. Par conséquent, on peut placer un fichier de configuration avec le bucket à un certain endroit. Et utiliser ce bucket à la fois dans le code Terraform et dans le script shell pour l'initialisation.
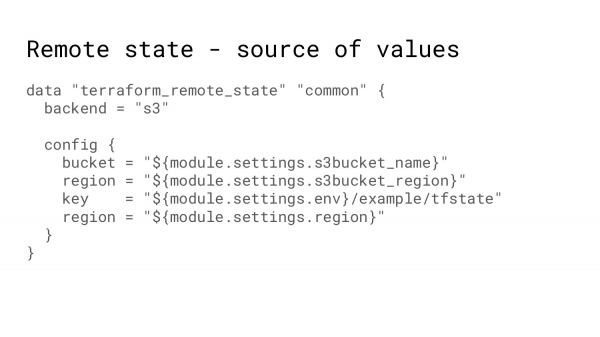
Pourquoi est-il important d'avoir un bucket pour Terraform ? Parce qu'il existe quelque chose appelé des fichiers d'état distants. C'est-à-dire que lorsque je déploie une ressource, pour dire à Amazon : « Veuillez mettre en service une instance », je dois spécifier de nombreux paramètres obligatoires.
Et ces identifiants sont stockés dans un autre dossier. Et je peux dire : « Terraform, va s'il te plaît chercher dans le fichier d'état de cette ressource et récupère-moi ces identifiants ». Ainsi, il y a une sorte de standardisation entre différentes régions ou environnements.
Il n'est pas toujours possible d'utiliser un fichier d'état distant. Par exemple, vous avez créé un VPC manuellement. Et le code Terraform qui crée le VPC est si différent que vous devrez passer beaucoup de temps à ajuster l'un par rapport à l'autre, c'est pourquoi vous pouvez utiliser la fonctionnalité suivante.
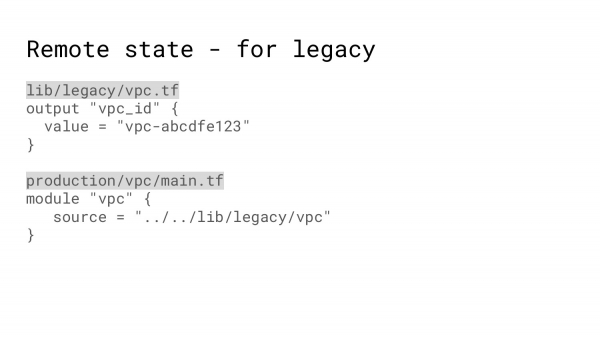
C'est-à-dire créer un module qui, en quelque sorte, crée le VPC et vous fournit des identifiants, alors qu'en réalité, il y a juste un fichier avec des valeurs codées en dur, qui peut être utilisé pour créer la même instance.
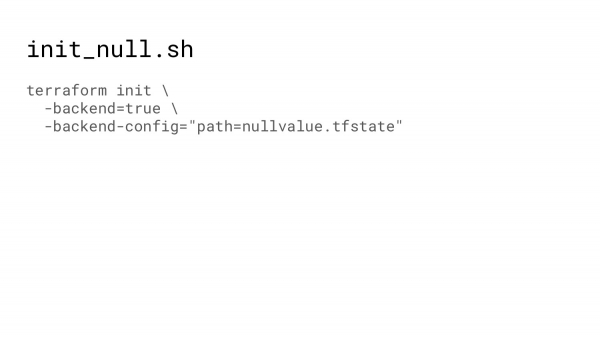
Il n'est pas toujours nécessaire de conserver le fichier d'état dans le cloud. Par exemple, lors de tests de modules, vous pouvez utiliser l'initialisation du backend, où le fichier sera simplement sauvegardé sur le disque pendant la période de test.
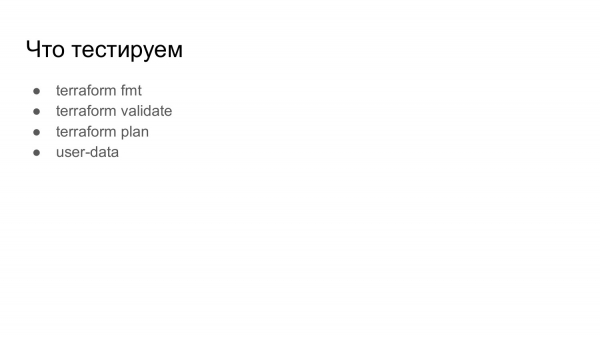
Maintenant, parlons un peu des tests. Que peut-on tester dans Terraform ? Probablement beaucoup de choses, mais je vais parler de ces 4 éléments.
HashiCorp a une idée précise de la façon de formater le code Terraform. Et Terraform fmt vous permet de formater le code que vous éditez selon cette norme. Par conséquent, les tests doivent obligatoirement vérifier si le formatage correspond à ce qu'a préconisé HashiCorp, afin qu'il n'y ait pas besoin de changer la position des parenthèses, etc.
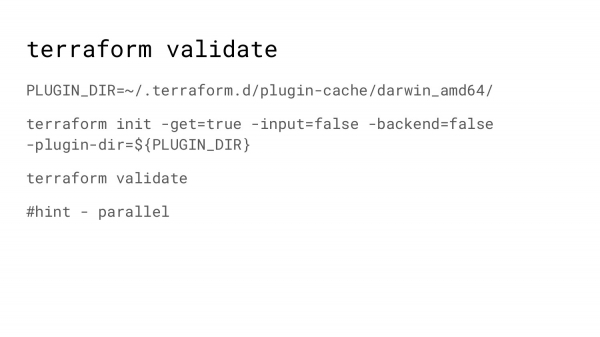
Le suivant est Terraform validate. Il fait un peu plus que vérifier la syntaxe - par exemple, vérifier si toutes les parenthèses sont appariées. Qu'est-ce qui est important ici ? Notre infrastructure est très étendue. Elle contient beaucoup de dossiers différents. Et dans chacun, il faut exécuter Terraform validate.
Par conséquent, pour accélérer les tests, nous exécutons plusieurs processus en parallèle, en utilisant le parallélisme.
Le parallélisme est une chose vraiment géniale, profitez-en.
Mais chaque fois que Terraform s'initialise, il se rend sur HashiCorp et demande : « Quelles sont les dernières versions des plugins ? Et ce plugin que j'ai en cache, est-ce le bon ou pas ? ». Et cela ralentissait à chaque étape.
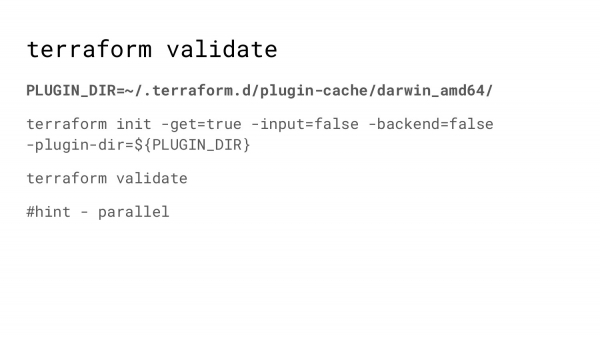
Si vous indiquez à Terraform où se trouvent les plugins, il dira : « D'accord, c'est probablement la version la plus récente. Je ne chercherai pas ailleurs, je vais commencer à valider votre code Terraform tout de suite ».
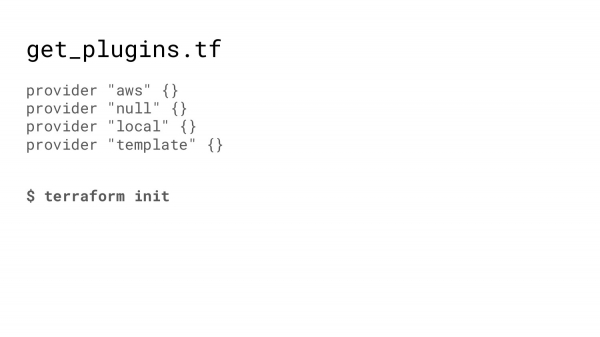
Pour remplir le dossier avec les plugins nécessaires, nous avons un code Terraform très simple qu'il suffit d'initialiser. Bien sûr, il faut mentionner tous les fournisseurs qui participent à votre code, sinon Terraform dira : « Je ne connais pas ce fournisseur, car il n'est pas dans le cache ».
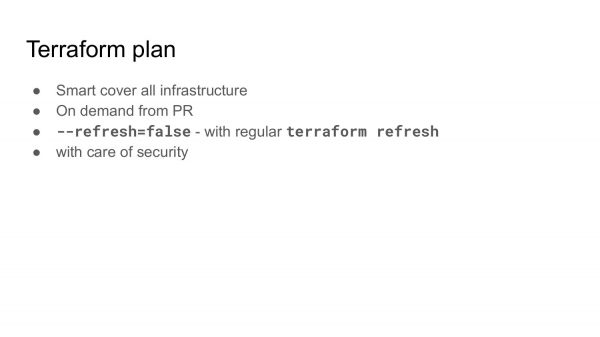
Ensuite, il y a le plan Terraform. Comme je l'ai dit, le développement est cyclique. Nous faisons le code avec des modifications. Et ensuite, nous devons savoir quelles modifications sont prévues pour l'infrastructure.
Et lorsque l'infrastructure est très, très grande, on peut changer un module, réparer un environnement de test ou une région spécifique et casser quelque chose d'à côté. C'est pourquoi le plan Terraform doit être fait pour l'ensemble de l'infrastructure et montrer les modifications prévues.
On peut le faire intelligemment. Par exemple, nous avons écrit un script en Python qui résout les dépendances. Selon que le module Terraform ait été modifié, ou simplement un composant spécifique, il élabore des plans pour tous les dossiers dépendants.
Les plans Terraform doivent être faits sur demande. Au moins, c'est ce que nous faisons.
Bien sûr, il est bon de faire des tests pour chaque modification, à chaque commit, mais les plans sont une affaire assez coûteuse. Et dans la demande de tirage, nous disons : « S'il te plaît, donne-moi les plans ». Un robot se déclenche et envoie dans les commentaires ou en pièce jointe tous les plans prévus en fonction de vos modifications.
Le plan est une chose assez coûteuse. Cela prend du temps, car Terraform se rend sur Amazon et demande : « Cet instance existe-t-il encore ? Est-ce que cet autoscale a bien ces paramètres ? ». Et pour accélérer cela, on peut utiliser un paramètre tel que refresh=false. Cela signifie que Terraform récupérera l'état depuis S3. Et il croira que l'état correspond exactement à ce qui se trouve sur Amazon.
Un tel plan Terraform s'exécute beaucoup plus rapidement, mais l'état doit correspondre à votre infrastructure, c'est-à-dire que, quelque part, à un moment donné, Terraform refresh doit être exécuté. Terraform refresh fait exactement cela, afin que l'état corresponde à ce qui se trouve dans l'infrastructure réelle.
Et il faut parler de la sécurité. C'est par là qu'il faut commencer. Là où vous exécutez Terraform, et où Terraform interagit avec votre infrastructure, il y a une vulnérabilité. Autrement dit, vous exécutez essentiellement du code. Et si une pull request contient un code malveillant, il peut s'exécuter sur l'infrastructure qui a trop d'accès. Donc, faites attention à l'endroit où vous exécutez le plan Terraform.
La prochaine chose dont je voudrais parler est le test de user-data.
Qu'est-ce que le user-data ? Sur Amazon, lorsque nous créons une instance, nous pouvons envoyer une sorte de message depuis l'instance – des métadonnées. Lorsque l'instance démarre, cloud-init est généralement toujours présent sur ces instances. Cloud-init lit ce message et dit : « Ok, aujourd'hui je suis un load balancer ». Et en accord avec ces instructions, il effectue certaines actions.
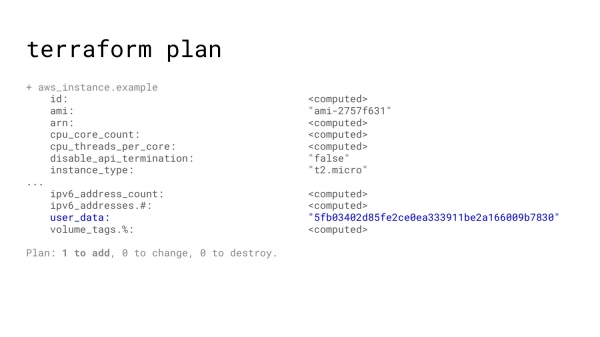
Mais, malheureusement, lorsque nous faisons un plan Terraform et un apply Terraform, le user-data ressemble à une bouillie de chiffres. Autrement dit, il vous envoie simplement un hachage. Et tout ce que vous pouvez voir dans le plan, c'est s'il y aura des changements ou si le hachage restera le même.
Et si on n'y prête pas attention, un petit fichier texte corrompu peut être envoyé à l'infrastructure réelle sur Amazon.
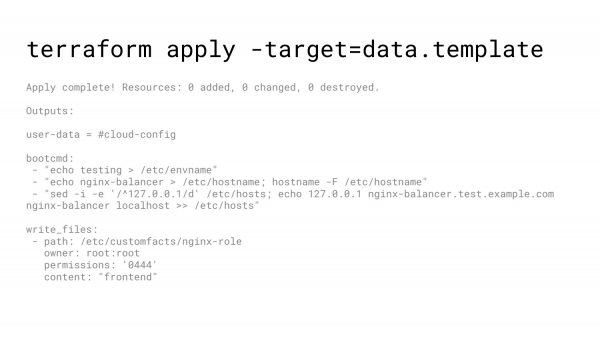
Comme option, lors de l'exécution, vous pouvez spécifier non pas toute l'infrastructure, mais seulement le modèle. Et dans le code, dire : « Veuillez m'afficher ce modèle ». Vous pouvez ainsi obtenir une impression de ce à quoi vos données sur Amazon ressembleront.
Une autre option est d'utiliser un module pour générer le user-data. Vous appliquez ce module, obtenez un fichier sur le disque, puis le comparez à un fichier de référence. Ainsi, si un débutant décide de modifier un peu le user-data, vos tests diront : « Ok, ici et là, il y a des changements – c'est normal ».
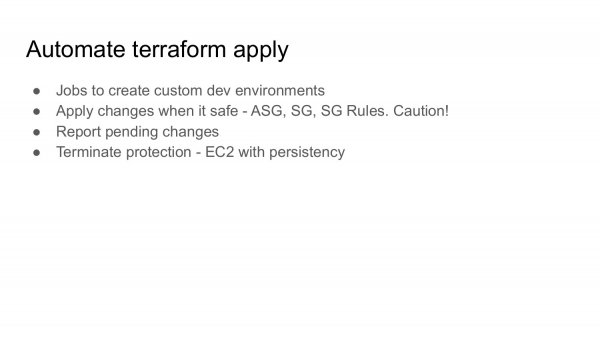
La prochaine chose dont je voudrais parler est l'automatisation du Terraform apply.
Il est certainement assez effrayant de faire un Terraform apply de manière automatisée, car qui sait quels changements sont arrivés et à quel point ils pourraient être destructeurs pour l'infrastructure en production.
Pour un environnement de test, tout cela est normal. Autrement dit, le job qui crée l'environnement de test est essentiel pour tous les développeurs. Et une expression comme « tout fonctionnait pour moi » n'est pas un mème amusant, mais une preuve que la personne s'est donnée la peine de déployer l'architecture, d'exécuter des tests sur cette architecture, et de vérifier que tout est en ordre pour dire : « Ok, le code que je publie a été testé. »
En production, dans sandbox et d'autres environnements qui sont plus critiques pour l'entreprise, vous pouvez appliquer partiellement certaines ressources de manière suffisamment sûre, car cela ne conduit pas à des conséquences fatales. Il s'agit des groupes d'autoscaling, des groupes de sécurité, des rôles, de route53, et la liste peut être assez longue. Mais restez attentif à ce qui se passe et consultez les rapports sur les applications automatiques.
Là où il est dangereux ou risqué d'appliquer, par exemple, lorsqu'il s'agit de ressources persistantes, comme des bases de données, il est préférable de recevoir des rapports indiquant que certains morceaux de l'infrastructure ont des modifications non appliquées. L'ingénieur, sous supervision, exécute alors des jobs pour les appliquer ou le fait depuis sa console.
Amazon dispose d'une fonction appelée protection contre la terminaison. Elle peut protéger dans certaines situations contre des modifications indésirables. Autrement dit, Terraform se connecte à Amazon et dit : « J'ai besoin de supprimer cette instance pour en créer une autre. » Et Amazon répond : « Désolé, pas aujourd'hui. Nous avons activé la protection contre la terminaison. »
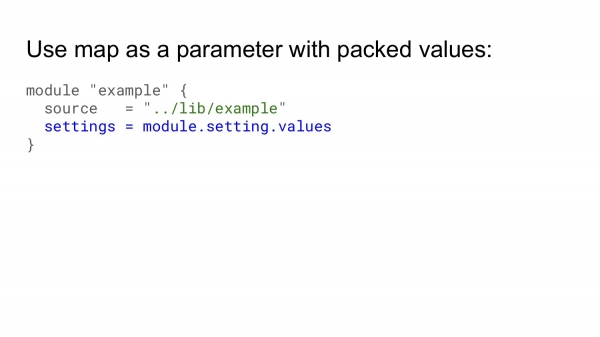
Et la cerise sur le gâteau – c'est l'optimisation du code. Lorsque nous travaillons avec du code Terraform, nous devons transmettre un grand nombre de paramètres au module. Ce sont ces paramètres nécessaires pour créer une ressource. Le code se transforme en de longues listes de paramètres à transmettre d'un module à l'autre, surtout lorsqu'il s'agit de modules imbriqués.
C'est très difficile à lire. Il est très compliqué de faire une révision. Et il arrive souvent que certains paramètres passent en revue et ne soient pas tout à fait ceux dont nous avons besoin. Cela coûte du temps et de l'argent de devoir les corriger plus tard.
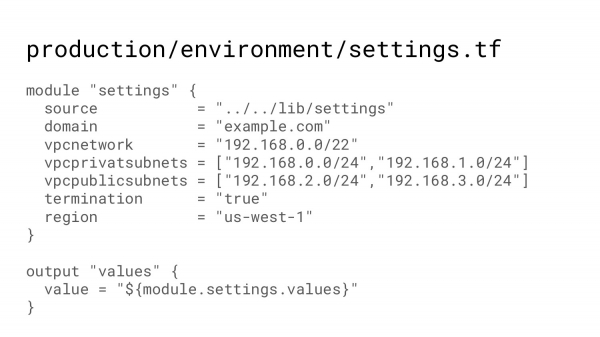
C'est pourquoi je vous propose d'utiliser une chose appelée paramètre complexe, qui inclut un certain arbre de valeurs. Autrement dit, vous avez besoin d'un répertoire où sont indiquées toutes les valeurs que vous aimeriez avoir dans un environnement donné.
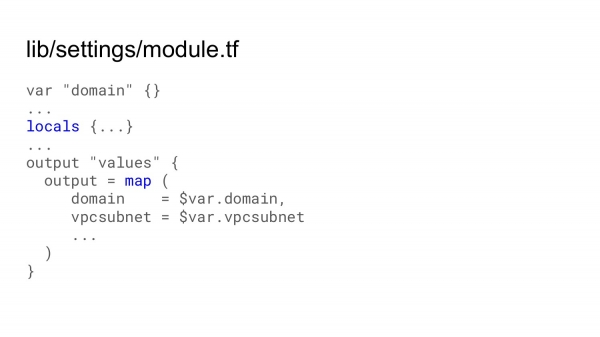
En invoquant ce module, il est possible d'obtenir un arbre généré dans un module commun, c'est-à-dire dans un module commun qui fonctionne de la même manière pour toute l'infrastructure.
Dans ce module, il est possible d'effectuer certains calculs en utilisant une fonctionnalité récente de Terraform, appelée locals. Puis, avec un output, vous pouvez produire un paramètre complexe qui peut inclure des hachages, des tableaux, etc.
C'est donc ici que se terminent toutes les meilleures découvertes que j'ai. Je voudrais raconter une anecdote sur Colomb. Quand il cherchait des financements pour son expédition afin de découvrir l'Inde (comme il le pensait alors), personne ne croyait en lui et on disait que c'était impossible. Alors il a dit : « Faites en sorte que l'œuf ne tombe pas ». Tous les banquiers, très riches et probablement intelligents, ont essayé de poser l'œuf de diverses manières, mais il tombait toujours. Alors Colomb a pris l'œuf, a appuyé légèrement dessus. La coquille s'est écrasée et l'œuf est resté immobile. Ils ont dit : « Oh, c’est trop simple ! ». Et Colomb a répondu : « Oui, c’est trop simple. Et quand je découvrirai l'Inde, tout le monde utilisera cette route commerciale ».
Ce que je vous ai raconté jusqu'à présent sont probablement des choses assez simples et triviales. Et quand vous en prenez connaissance et commencez à les utiliser, cela semble normal. Alors n'hésitez pas. Et si pour vous ce sont des choses tout à fait normales, au moins vous savez comment poser un œuf pour qu'il ne tombe pas.
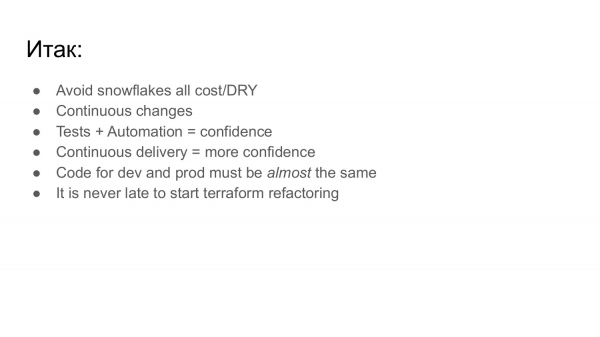
En résumé :
- Essayez d'éviter les flocons de neige. Et moins il y a de flocons, moins vous aurez besoin de ressources pour effectuer des modifications dans toute votre grande infrastructure.
- Modifications constantes. C'est-à-dire que lorsque des modifications ont été apportées au code, il faut rapidement aligner votre infrastructure avec ces changements. Il ne doit pas y avoir de situation où quelqu'un revient après deux ou trois mois pour voir Elasticsearch, fait un terraform plan et y découvre une multitude de changements qu'il n'attendait pas. Cela prendrait trop de temps pour remettre tout en ordre.
- Tests et automatisation. Plus votre code est couvert par des tests et des fonctionnalités, plus vous avez confiance dans le fait que vous faites tout correctement. La livraison automatisée augmentera votre confiance de manière exponentielle.
- Le code pour l'environnement de test et de production doit être pratiquement identique. Pratiquement, parce que la production est un peu différente et qu'il y aura tout de même des nuances qui dépasseront le cadre de l'environnement de test. Néanmoins, on peut en gros garantir cela.
- Et si vous avez beaucoup de code Terraform et qu'il faut beaucoup de temps pour le maintenir à jour, il n'est jamais trop tard pour faire du refactoring et le remettre en bonne forme.
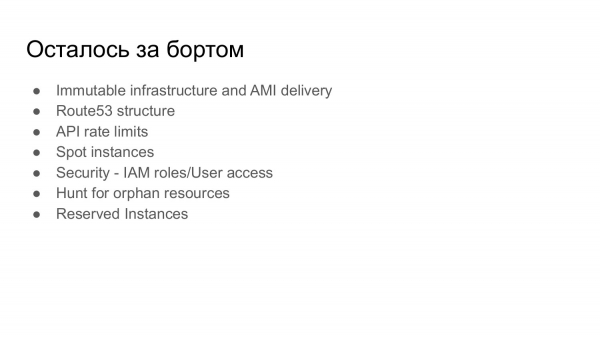
- Infrastructure immuable. Livraison AMI selon un calendrier.
- Structure pour Route53, lorsque vous avez beaucoup d'enregistrements et que vous souhaitez qu'ils soient dans un ordre cohérent.
- Lutte contre les limites de taux de l'API. C'est lorsque Amazon dit : « Ça y est, je ne peux plus accepter de requêtes, veuillez patienter ». Et la moitié de la société attend jusqu'à ce qu'elle puisse déployer son infrastructure.
- Instances spot. Amazon n'est pas une dépense bon marché et les spots permettent d'économiser beaucoup. On peut même donner toute une présentation à ce sujet.
- Sécurité et rôles IAM.
- Recherche de ressources perdues, lorsque vous avez dans Amazon des instances d'origine douteuse qui coûtent de l'argent. Même si une instance coûte 100-150 dollars par mois, cela fait plus de 1 000 dollars par an. Trouver ces ressources est une affaire lucrative.
- Et les instances réservées.
C'est tout pour moi. Terraform est vraiment génial, utilisez-le. Merci !
Questions
Merci pour la présentation ! Votre fichier d'état est stocké dans S3, comment gérez-vous le problème de plusieurs personnes qui pourraient accéder à ce fichier d'état et essayer de se déployer ?
Tout d'abord, nous ne sommes pas pressés. Deuxièmement, il y a des flags pour indiquer que nous travaillons sur une certaine partie du code. Donc, même si l'infrastructure est très grande, cela ne signifie pas que quelqu'un applique constamment des changements. Et lorsque la phase active était en cours, cela devenait un problème, nos fichiers d'état étaient stockés dans Git. C'était important, sinon quelqu'un allait créer un fichier d'état et nous devions les rassembler manuellement pour que tout puisse continuer. Maintenant, ce problème n'existe plus. En fait, Terraform a résolu cette tâche. Et s'il y a des changements constants, des verrous peuvent être utilisés pour prévenir ce que vous mentionnez.
Vous utilisez la version open source ou l'entreprise ?
Aucune version entreprise, c'est-à-dire tout ce qui peut être téléchargé gratuitement.
Je m'appelle Stanislav. Je voulais faire un petit complément. Vous avez parlé de la fonctionnalité d'Amazon qui permet de rendre une instance indestructible. Cela existe aussi dans Terraform, dans le bloc Life Second, on peut inscrire une interdiction de modification ou d'élimination.
J'étais limité par le temps. Bonne remarque.
Je voulais aussi poser deux questions. Premièrement, vous avez parlé des tests. Avez-vous utilisé des outils de test ? J'ai entendu parler du plugin Test Kitchen. Peut-être qu'il y a autre chose. Et j'aimerais également poser une question sur les Local Values. En quoi diffèrent-ils des Input Variables ? Et pourquoi ne puis-je pas paramétrer quelque chose uniquement via les Local Values ? J'ai essayé de comprendre ce sujet, mais je n'y suis pas parvenu.
Nous pouvons en discuter davantage en dehors de cette salle. Les outils de test – c'est complètement fait maison chez nous. Il n'y a rien là pour faire des tests. En fait, il existe des options où des tests automatisés élèvent l'infrastructure quelque part, vérifient qu'elle est OK, puis tout détruisent avec un rapport disant que votre infrastructure est toujours en bon état. Nous n'avons pas cela, car les stacks de tests sont lancés chaque jour. Et cela suffit. Et si quelque chose commence à se casser, cela va commencer à se casser sans que nous devions le vérifier ailleurs.
À propos des Local Values, poursuivons la conversation en dehors de la salle.
Salut ! Merci pour ta présentation ! Très instructif. Tu disais que vous aviez beaucoup de code répétitif pour décrire votre infrastructure. N'avez-vous pas envisagé de générer ce code ?
Excellente question, merci ! En fait, lorsque nous utilisons l'infrastructure comme code, nous supposons que nous regardons le code et que nous comprenons quelle infrastructure est derrière ce code. Si le code est généré, il nous faut imaginer quel code sera généré pour comprendre quelle infrastructure il y aura. Soit nous générons le code, nous le committons et, en substance, cela revient à la même chose. C'est pourquoi nous avons suivi la voie que nous avons écrite, nous l'avons obtenu. De plus, les générateurs sont apparus un peu plus tard, lorsque nous avons commencé à travailler. Et il était déjà trop tard pour changer.
Avez-vous entendu parler de jsonnet ?
Non.
Regarde, c'est une très bonne chose. Je vois un cas concret où je peux l'appliquer et générer une structure de données.
Les générateurs, c'est bien, comme dans l'anecdote sur le rasoir. C'est-à-dire qu'au début, les visages sont différents, mais ensuite, tout le monde a le même visage. Les générateurs sont très bien accueillis. Mais chez nous, malheureusement, les visages sont un peu différents. C'est un problème.
Regarde juste. Merci !
Je m'appelle Maxim, je viens de Sberbank. Vous avez un peu parlé de l'essai d'adapter Terraform à un langage de programmation. Ne serait-il pas plus simple d'utiliser Ansible ?
Ce sont des choses très différentes. On peut créer des ressources avec Ansible et avec Puppet, on peut créer des ressources sur Amazon. Mais Terraform est vraiment conçu pour cela.
Vous n'avez qu'Amazon ?
Ce n'est pas que nous n'avons qu'Amazon. Nous avons presque uniquement Amazon. Mais la caractéristique clé est que Terraform se souvient. Avec Ansible, si vous dites : « Montez-moi 5 instances », il va le faire, puis vous dites : « Maintenant, j'ai besoin de 3 ». Et Terraform dira : « Ok, j’en supprime 2 », alors qu'Ansible dira : « Ok, voici 3 ». Au total, cela fait 8.
Bonjour ! Merci pour votre présentation ! C'était très intéressant d'écouter parler de Terraform. Je veux d'abord faire un petit commentaire sur le fait que Terraform n'a toujours pas de version stable, donc soyez très prudent avec Terraform.
Mieux vaut tard que jamais. C'est-à-dire que si vous avez besoin d'une solution, vous retardez parfois ce qui n'est pas stable, etc., mais ça fonctionne et cela nous a aidés.
J'ai une question. Vous utilisez Remote backend, vous utilisez S3. Pourquoi n'utilisez-vous pas le backend officiel ?
Officiel ?
Terraform Cloud.
Quand cela a-t-il été lancé ?
Il y a environ 4 mois.
S'il était apparu il y a 4 ans, j'aurais probablement répondu à votre question.
Il y a déjà une fonction intégrée pour les verrous, et vous pouvez stocker le fichier d'état. Essayez-le. Mais je ne l'ai pas testé non plus.
Nous sommes dans un grand train qui roule à grande vitesse. Et on ne peut pas juste jeter quelques wagons.
Vous parliez de snowflakes, pourquoi n'avez-vous pas utilisé de branche ? Pourquoi ça n'a-t-il pas marché ?
Nous avons cette approche où toute l'infrastructure est dans un seul dépôt. Terraform, Puppet, tous les scripts en rapport, ils sont tous dans le même dépôt. De cette façon, nous pouvons garantir que les changements incrémentaux sont testés un par un. Si c'était plein de branches, ce type de projet serait pratiquement impossible à maintenir. Il passe six mois, et ils s'écartent tellement que cela devient juste une punition. C'est ce dont nous voulions fuir jusqu'à la refonte.
Donc, cela ne fonctionne pas ?
Ça ne fonctionne pas du tout.
Dans la branche, j'ai coupé le diaporama du dossier. C'est-à-dire que si nous faisons un dossier pour chaque projet de test, par exemple, l'équipe A a son propre dossier, l'équipe B a son propre dossier, cela ne fonctionne pas non plus. Nous avons créé un code unifié pour l'environnement de test, qui était suffisamment flexible pour convenir à tout le monde. C'est-à-dire que nous avons géré un seul code.
Bonjour ! Je m'appelle Yura ! Merci pour votre présentation ! J'ai une question sur les modules. Vous dites que vous utilisez des modules. Comment gérez-vous les changements dans un module qui ne sont pas compatibles avec les modifications d'une autre personne ? Est-ce que vous versionnez les modules ou essayez-vous de créer une solution miracle pour répondre à deux exigences ?
C'est un problème de grande ampleur. C'est ce dont nous souffrons, lorsque quelque changement apparemment inoffensif peut casser une partie de l'infrastructure. Et cela ne sera perceptible qu'après un certain temps.
C'est-à-dire qu'il n'y a pas encore de solution ?
Vous créez des modules universels. Évitez les flocons. Et tout ira bien. La seconde partie de la présentation traite de la manière d'éviter cela.
Bonjour ! Merci pour votre présentation ! Je voudrais préciser quelque chose. Il y a un gros problème en arrière-plan, pour lequel je suis venu. Comment Puppet et l'attribution des rôles sont-ils intégrés ?
User-data.
C'est-à-dire que vous lancez simplement un fichier et vous exécutez des choses en fonction de celui-ci ?
User-data est une note, c'est-à-dire que lorsque nous clonons une image, un Daemon se lève et, essayant de comprendre qui il est, lit la note disant qu'il est un équilibreur de charge.
C'est-à-dire que c'est un processus distinct qui est confié ?
Ce n'est pas nous qui l'avons inventé. Nous l'utilisons.
Bonjour ! J'ai justement une question sur User-data. Vous avez mentionné qu'il y avait des problèmes, que quelqu'un pouvait envoyer quelque chose de travers. Existe-t-il un moyen de stocker les user-data dans le même Git, afin qu'il soit toujours clair à quoi se réfère User-data ?
Nous générons l'User-data à partir du template. C'est-à-dire qu'un certain nombre de variables y parviennent. Terraform génère donc le résultat final. On ne peut pas simplement regarder le template et dire ce qui en sortira, car tous les problèmes viennent du fait que le développeur pense qu'il transmet une chaîne dans cette variable, tandis qu'un tableau arrive. Et là, bam, quelque chose ne fonctionne pas. Si c'est une nouvelle ressource et que la personne la déploie, elle voit que quelque chose ne fonctionne pas, et c'est rapidement résolu. Mais si c'est un groupe d'autoscaling qui a été mis à jour, à un moment donné, les instances du groupe d'autoscaling commencent à être remplacées. Et pouf, quelque chose ne fonctionne pas. C'est frustrant.
Cela signifie que la seule solution est de tester ?
Oui, vous voyez le problème, vous ajoutez des étapes de test. C'est-à-dire que l'output peut également être testé. Peut-être que ce n'est pas aussi pratique, mais on peut aussi mettre des balises – vérifiez que l'User-data est bien en place.
Je m'appelle Timur. C'est super qu'il y ait des présentations sur la bonne organisation de Terraform.
Je n'ai même pas commencé.
Je pense qu'à la prochaine conférence, cela pourrait être le cas. J'ai une question simple. Pourquoi ne hardcodez-vous pas la valeur dans un module séparé, au lieu d'utiliser des tfvars ? Qu'est-ce qui rend un module avec des valeurs meilleur qu’un tfvars ?
C'est-à-dire que je devrais écrire ici (diapositive : Production/environment/settings.tf) : domain = variable, domaine vpcnetwork, variable vpcnetwork et stvars – obtenir la même chose ?
Nous faisons exactement comme ça. Nous faisons référence au module de source setting, par exemple.
En gros, c'est comme un tfvars. Le tfvars est très pratique dans un environnement de test. J'ai un tfvars pour de grandes instances, pour de petites. Et j'ai juste jeté un fichier dans le dossier. Et j'ai obtenu ce que je voulais. Quand nous développons l'infrastructure, nous voulons qu'il soit possible de voir et de tout comprendre immédiatement. Sinon, il faut regarder ici, puis regarder dans les tfvars.
Donc, pour que tout soit au même endroit ?
Oui, le tfvars est lorsque vous avez un code unique. Et il est utilisé à différents endroits avec des nuances différentes. Dans ce cas, vous jetteriez le tfvars et obteniez vos nuances. Et nous, c'est l'infrastructure comme code pur. On regarde et on comprend.
Bonjour ! Avez-vous déjà rencontré des situations où le fournisseur de cloud interfère dans ce que vous avez fait avec Terraform ? Par exemple, lorsque nous modifions les métadonnées. Il s'agit de clés ssh. Et Google insère constamment ses propres métadonnées et ses clés. Terraform dit toujours qu'il y a des modifications. Après chaque exécution, même si rien ne change, il insiste sur le fait qu'il va mettre à jour ce champ.
Avec les clés, oui, mais une partie de l'infrastructure est affectée par ce problème, c'est-à-dire que Terraform ne peut rien changer. Nous ne pouvons rien modifier manuellement non plus. Nous devons vivre avec cela.
C'est-à-dire que vous y êtes confronté, mais vous n'avez rien trouvé, il continue de faire ce qu'il veut tout seul ?
Malheureusement, oui.
Bonjour ! Je m'appelle Stanislav Starkov. Mail.ru Group. Comment gérez-vous le problème de génération de balises sur ..., comment les transmettez-vous à l'intérieur ? Je comprends qu'il faut passer par User — data pour indiquer le nom d'hôte, pour cibler Puppet ? Et la deuxième partie de la question. Comment gérez-vous cette question dans SG, c'est-à-dire lorsque vous générez SG, des centaines d'instances similaires, comment les nommer correctement ?
Les instances qui sont très importantes pour nous, nous leur donnons des noms appropriés. Celles qui ne sont pas nécessaires portent une annotation indiquant qu'il s'agit d'un groupe d'autoscaling. En théorie, cela peut être supprimé pour en obtenir une nouvelle.
Concernant le problème de la balise, il n'y a pas de problème, mais il s'agit d'une tâche. Nous utilisons énormément les balises, car l'infrastructure est vaste et coûteuse. Nous devons observer où vont les dépenses d'argent, donc les balises nous permettent d'analyser où et pourquoi de l'argent est dépensé. Ainsi, nous pouvons suivre ce pour quoi beaucoup d'argent est dépensé ici.
De quoi portait l'autre question ?
Quand SG crée une centaine d'instances, comment faut-il les différencier ?
Non, ce n'est pas nécessaire. Chaque instance a un agent qui signale des problèmes. Si l'agent signale, c'est qu'il sait qu'il y a un problème et, au minimum, l'adresse IP existe. On peut déjà partir de là. D'autre part, nous utilisons Consul pour la découverte, là où nous n'avons pas Kubernetes. Et Consul montre aussi l'adresse IP de l'instance.
C'est-à-dire que vous vous basez sur l'adresse IP, et non sur le nom d'hôte ?
Il est impossible de se baser sur le nom d'hôte, il y en a beaucoup. Il y a des identifiants d'instance – AE, etc. On peut les trouver quelque part, on peut les rechercher.
Salut ! J'ai compris que Terraform est un bon outil conçu pour le cloud.
Pas seulement.
C'est exactement cette question qui m'intéresse. Si vous décidez de migrer massivement vers Bare Metal avec tous vos instances, cela ne posera-t-il aucun problème ? Ou devrez-vous tout de même utiliser d'autres produits, comme Ansible, qui a été mentionné ici ?
Ansible est un peu différent. C'est-à-dire qu'Ansible fonctionne une fois que l'instance est lancée. Alors que Terraform opère avant le lancement de l'instance. La transition vers Bare Metal – c'est non.
Pour l'instant, non, mais un jour le business dira : « Allons-y ».
La migration vers un autre cloud – oui, mais il y a un petit détail différent. Il faut rédiger le code Terraform de manière à pouvoir transférer vers un autre cloud avec le moins de douleur possible.
Au départ, l'objectif était que notre infrastructure soit agnostique, c'est-à-dire qu'elle puisse s'adapter à n'importe quel cloud, mais à un moment donné, le business a capitulé et a dit : « D'accord, dans les N prochaines années, nous ne partirons nulle part, nous pouvons utiliser les services d'Amazon ».
Terraform permet de créer des jobs en Front-End, de configurer PagerDuty, des documents de données, etc. Il a tellement de fonctionnalités. Il peut pratiquement contrôler le monde entier.
Merci pour la présentation ! J'utilise également Terraform depuis 4 ans. Au cours de la transition vers Terraform, vers l'infrastructure, vers la description déclarative, nous avons été confrontés à des situations où quelqu'un faisait quelque chose manuellement, et vous tentiez de faire un plan. Et vous obteniez une erreur quelconque. Comment gérez-vous ces problèmes ? Comment trouvez-vous les ressources perdues qui ont été spécifiées ?
Principalement à la main et à l'œil. Si nous voyons quelque chose d'étrange dans le rapport, nous analysons ce qui se passe, ou nous le supprimons simplement. En fait, les pull requests sont une pratique courante.
En cas d'erreur, effectuez-vous un rollback ? Avez-vous déjà essayé cela ?
Non, c'est une décision humaine au moment où le problème est constaté.
Source : habr.com
