

La première API de MoegoSklada est apparue il y a 10 ans. Depuis tout ce temps, nous travaillons sur les versions existantes de l'API et en développons de nouvelles. Déjà plusieurs versions de l'API ont été mises au rebut.
Cet article contiendra beaucoup de choses : comment l'API a été créée, pourquoi elle est nécessaire pour un service cloud, ce qu'elle apporte aux utilisateurs, sur quelles embûches nous avons trébuché et ce que nous voulons faire ensuite.
Je m'appelle Oleg Alexeev , je suis directeur technique et cofondateur de MoegoSklada.
Pourquoi créer une API pour le service
Nos clients, qui comptent des dizaines de milliers d'entrepreneurs, utilisent activement des solutions cloud : services bancaires, boutiques en ligne, gestion des stocks, CRM. Une fois connecté à l'un, il devient difficile de s'arrêter. Et voilà déjà le cinquième, le huitième, le dixième service qui facilite le travail des entrepreneurs, mais les utilisateurs doivent transférer manuellement les données entre ces services cloud. Le travail se transforme en cauchemar.
La solution évidente est de permettre aux utilisateurs de transférer des données entre les services cloud. Par exemple, importer et exporter des données sous forme de fichiers, qui peuvent ensuite être téléchargés dans le service approprié. Les fichiers sont généralement adaptés au format de chaque service. C'est un travail manuel plus ou moins simple, mais avec l'augmentation du nombre de ces services, il devient de plus en plus difficile de le réaliser.
Ainsi, la prochaine étape est l'API. Avec cela, le service cloud bénéficie de la connexion de plusieurs services en un seul point. L'apparition d'un tel écosystème attire de nouveaux clients grâce à des fonctionnalités supplémentaires. Un produit avec une nouvelle fonctionnalité devient plus rentable et utile.
En créant des interfaces de programmation propres, cela attire des vendeurs tierce partie sous la forme de programmeurs qui connaissent votre produit grâce à l'API. Ils commencent à construire des solutions basées sur l'API proposée et gagnent de l'argent en automatisant les tâches pour leurs clients.
Le système de comptabilité de MoegoSklada est construit sur des processus simples. L'essentiel est de travailler avec des documents de base, la possibilité de recevoir et d'expédier des marchandises, puis d'obtenir des rapports pour les entreprises basés sur ces documents. Il y a aussi le transfert de données, par exemple vers une comptabilité cloud, et leur réception depuis des systèmes bancaires ou des points de vente. De plus, nous travaillons avec des boutiques en ligne : nous obtenons des informations sur les produits et envoyons des données sur les stocks.
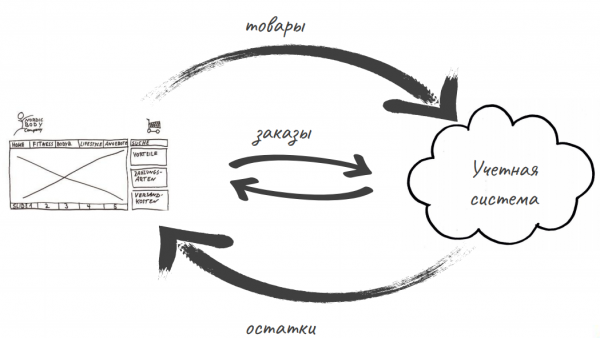
Première API de MonInventaire
Au cours de ses 10 années d'activité avec l'API, MonInventaire a développé toutes sortes d'intégrations permettant d'échanger des données, de travailler avec des banques, de traiter des paiements et d'utiliser la téléphonie externe.
Dans la première année, nous avons rendu possible l'exportation de toutes les données au format XML. À l'époque, il était bien plus compréhensible et habituel pour les utilisateurs de conserver les données hors ligne plutôt que dans un cloud, et nous leur avons donné cette opportunité. L'exportation était lancée manuellement depuis l'interface. On ne pouvait donc pas encore parler d'une véritable API.
À cette époque, nous avons commencé à collaborer avec l'entreprise Rusagro — ils utilisaient déjà un ERP 'mature' pour la planification de la production et de la vente, tandis que nous avons automatisé le chargement des wagons dans les usines avec MonInventaire. Ainsi, nous avons eu nos premiers balbutiements d'une véritable API : l'échange entre notre service et l'ERP se faisait par l'envoi d'un grand fichier contenant les données sur tous les types de documents.
C'est une option pas mal pour l'échange de données en lot, mais avec les documents, il fallait également transmettre leurs dépendances : des informations sur les produits, les partenaires et les entrepôts. Ce genre de fouillis n'est pas si difficile à générer lors de l'exportation, mais c'est plutôt compliqué à déchiffrer lors de l'importation, car dans un seul paquet se trouvent toutes les informations : à la fois sur les nouveaux documents et sur ceux déjà existants.
La première API XML n'a pas duré longtemps — après deux ans, nous avons commencé à la reconstruire. Dès le démarrage de son fonctionnement, nous avons fait plusieurs erreurs dans la conception de l'interface du programme.
Comment l'API XML a été réalisée : illustration d'un de nos architectes. D'ailleurs, attendez-vous à ses articles.
Voici nos principales erreurs :
- Le balisage JAXB a été fait directement sur les entités beans. Pour communiquer avec la base de données, nous utilisons Hibernate, et le balisage JAXB a également été fait sur ces mêmes beans. Cette erreur a émergé presque immédiatement : toute mise à jour de la structure des données nécessitait d'informer d'urgence tous ceux qui utilisaient l'API, ou de construire des béquilles pour assurer la compatibilité avec la structure de données précédente.
- L'API a émergé comme un complément, et au départ, nous n'avons pas défini quelle part du produit il représentait. Nous n'avons pas non plus réfléchi à savoir si l'API était quelque chose d'important, ni s'il était nécessaire de maintenir la compatibilité avec les premières versions. Pendant un moment, le nombre d'utilisateurs de l'API représentait environ 5 % d'un nombre total déjà faible, et ils n'ont pas attiré notre attention. La filtration universelle mise en place à l'époque a conduit à ce que nous soyons utilisés comme backend. Cette filtration n'était pas véritablement GraphQL, mais quelque chose de similaire — elle fonctionnait à travers une multitude de paramètres de la chaîne de requête. Avec un outil aussi puissant, il était difficile pour les utilisateurs de s'en passer, et nous avons commencé à recevoir des requêtes directement depuis l'interface utilisateur de leurs boutiques en ligne. La situation s'est révélée être une mauvaise surprise, car la fourniture d'un tel service devrait nécessiter une tarification différente et une compréhension totalement différente de l'API en tant que produit.
- Étant donné que l'API s'est développée non pas comme un produit principal, la documentation de l'API a été produite et publiée de manière résiduelle — par ingénierie inverse. Ce chemin semble assez simple et pratique, mais est en contradiction avec le travail contractuel. C'est lorsqu'il y a un certain composant avec un schéma de travail prédéfini. Le développeur le met en œuvre conformément à ce schéma et à cet objectif, le composant est testé, le client reçoit un produit conforme à la vision de l'analyste. L'ingénierie inverse, quant à elle, met sur le marché un produit qui existe simplement : avec des solutions de contournement, des décisions étranges et des solutions improvisées au lieu de la fonctionnalité requise.
- Tout le flux de requêtes reçues via l'API ne pouvait être analysé que par les journaux de Nginx ou du serveur d'application. Cela ne permettait pas de distinguer les domaines d'application, sauf à les classer par utilisateurs et abonnés. En l'absence de possibilités pour réguler l'enregistrement des applications ou des clients, il devient impossible d'analyser la situation. Ce problème a eu peu d'impact sur le développement de l'API, il est davantage lié à la compréhension de sa demande et de sa fonctionnalité.
Tentative numéro deux : REST API
En 2010, nous avons tenté de construire un système d'échange avec la comptabilité en ligne — BoukhSoft. Cela n'a pas décollé. Cependant, au cours de l'intégration, nous avons développé une API complète : un service REST d'échange, où il n'y avait pas de libertés telles que les appels RPC. Toute communication avec l'API a été réduite à un mode standard pour REST : le nom de l'entité est contenu dans la chaîne de requête, et l'opération qui s'applique à elle est définie à l'aide de la méthode HTTP. Nous avons ajouté un filtrage basé sur le moment de la mise à jour des entités, et les utilisateurs ont eu la possibilité de construire une réplication avec leurs systèmes.
La même année, nous avons introduit une API pour l'exportation des stocks et des articles. Les utilisateurs ont désormais accès via l'API aux parties les plus précieuses du système — l'échange de documents primaires et les données de calcul concernant les stocks et le coût des articles.
En décembre 2015, RetailCRM a publié sa première bibliothèque tierce pour accéder à notre API. Elle a été assez activement utilisée, tandis que la popularité du service en général augmentait, la charge sur l'API augmentait plus rapidement que celle sur l'interface web. Un jour, cette croissance s'est transformée en un saut de charge.
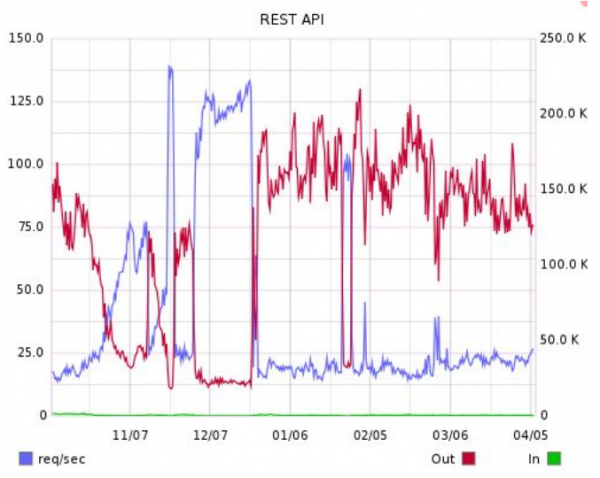
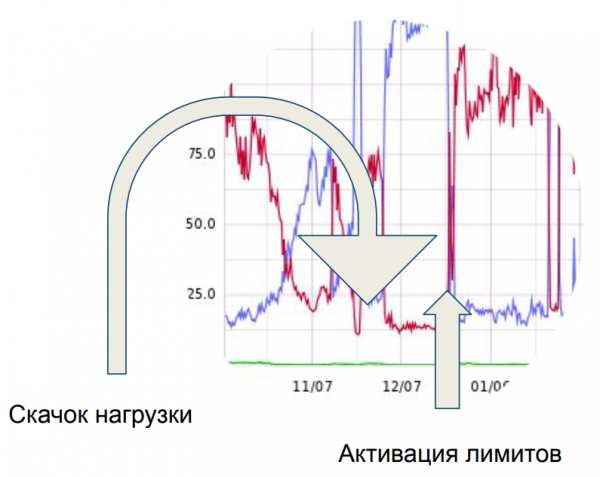
Et ce saut, que montre la flèche à gauche, a complètement stupéfié le serveur qui servait notre API. Nous avons passé une semaine à examiner quelle charge était réellement générée. Il s'est avéré qu'il s'agissait de ces mêmes requêtes, traduites vers notre API depuis les fronts des clients. Environ 50 clients ont consommé toute la charge. C'est à ce moment-là que nous avons compris une de nos erreurs — l'absence totale de limites.
Au final, nous avons introduit une limite sur le nombre de requêtes simultanées. Avec un seul compte, il n'était plus possible d'ouvrir plus de deux requêtes en même temps. Cela suffit pour fonctionner en mode de réplication pour l'échange de données en mode batch. Quant à ceux qui voulaient nous utiliser comme backend, ils ont dû se conformer davantage aux tarifs, car nous avons introduit dans leurs moyens logiciels le travail sur plusieurs comptes.
Mettre en ordre
Depuis 2014, la demande pour l'API existante est devenue une partie importante des affaires, et la propre API générait le plus grand volume de données dans les échanges avec les clients. En 2015, nous avons lancé un projet de mise en ordre de l'API. Nous avons choisi le format JSON au lieu de XML et avons commencé à le construire en fonction des caractéristiques que nous avons identifiées lors de la mise en œuvre de la version précédente :
- La possibilité de gérer les versions. La versionnage permet de développer une nouvelle version sans affecter l'application existante et sans perturber le travail des utilisateurs.
- La possibilité pour l'utilisateur de voir les métadonnées dans la réponse même qu'il reçoit.
- La possibilité d'échanger de gros documents. Si nous traitons un document contenant plus de 4-5 mille lignes, cela devient un problème pour le serveur : une transaction longue, une longue requête http. Nous avons construit un mécanisme spécial permettant de mettre à jour le document par parties et de gérer les éléments individuels de ce document, en les envoyant au serveur.
- Les outils de réplication étaient déjà présents dans la version précédente.
- Limites de charge - héritage des erreurs commises dans la version précédente. Des limites ont été mises en place concernant le nombre de requêtes par période de temps, le nombre de requêtes parallèles et les requêtes provenant d'une seule adresse IP.
Depuis, nous avons publié deux versions mineures de l'API et lancé plusieurs API spécialisées, mais notre approche est restée essentiellement la même. Le format d'échange mis à jour et la nouvelle architecture ont permis de corriger les défauts de l'API beaucoup plus rapidement.
L'API de MonStock aujourd'hui
Aujourd'hui, l'API de MonStock résout de nombreuses tâches :
- échange de données avec des boutiques en ligne, des systèmes comptables, des banques;
- récupération de données calculées, de rapports;
- utilisation comme backend pour des applications client - nos applications mobiles et le point de vente de bureau fonctionnent via l'API
- envoi de notifications sur les changements de données dans MonStock - webhooks;
- téléphonie;
- systèmes de fidélité.
Sur la base de l'API, notre directeur général Askar Rakhimberdiev a écrit en quatre heures un bot Telegram qui récupère les stocks via l'API :
Voici maintenant des chiffres précis.
Voici nos statistiques concernant l'ancien API REST :
- 400 entreprises;
- 600 utilisateurs;
- 2 millions de requêtes par jour;
- 200 Go/jour de trafic sortant.
Et voici où nous en sommes avec toutes les API de MonStock :
- plus de 70 intégrations (une partie d'entre elles peut être consultée ici );
- 8500 entreprises;
- 12 000 utilisateurs;
- 46 millions de requêtes par jour;
- 2 To/jour de trafic sortant.
Que faire ensuite
Les plans de développement de l'API sont en discussion active. Nous essayons de prendre en compte l'expérience d'exploitation fournie par nos utilisateurs. Tout ne peut pas être mis en œuvre immédiatement, mais une nouvelle version de l'API avec des métadonnées plus pratiques et une structure moins encombrante, ainsi que l'OAuth pour l'authentification et une API pour les applications intégrées dans l'interface, est proche.
Pour suivre les nouvelles, vous pouvez consulter le site spécial pour les développeurs d'intégrations avec MonStock : .
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish