

Récemment, j'ai expliqué comment utiliser des recettes standards à partir d'une base de données PostgreSQL. Aujourd'hui, nous allons aborder comment rendre l'écriture dans la base de données plus efficace sans avoir recours à des réglages complexes dans la configuration — simplement en organisant correctement les flux de données.
#1. Секционирование
Cet article traite de la manière et de la raison pour laquelle il est important d'organiser a déjà été abordé, ici nous parlerons des pratiques d'application de certaines approches dans le cadre de notre .
« Il y a longtemps... »
Initialement, comme tout MVP, notre projet a démarré sous une charge relativement légère — la surveillance n'était effectuée que pour une dizaine de serveurs critiques, toutes les tables étaient relativement compactes... Mais le temps a passé, le nombre d'hôtes surveillés a continué d'augmenter, et en essayant encore une fois de gérer l'une des tables de 1.5 To, nous avons compris que continuer ainsi était possible, mais très inconfortable.
Les temps étaient presque légendaires, différentes versions de PostgreSQL 9.x étaient en cours, donc tout le partitionnement devait être effectué « manuellement » — via l'héritage des tables et des déclencheurs de routage dynamique. EXECUTE.
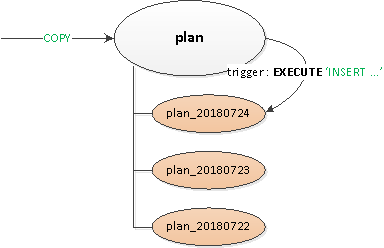
La solution obtenue s'est révélée suffisamment universelle pour pouvoir être transposée à toutes les tables :
- Une table « parent » vide a été déclarée, sur laquelle tous les index et déclencheurs nécessaires étaient décrits..
- L'écriture du point de vue du client se faisait dans la table « racine », et à l'intérieur à l'aide de un déclencheur de routage
AVANT INSERTl'écriture était « physiquement » insérée dans la section appropriée. Si celle-ci n'existait pas encore, nous attrapions une exception et… - … à l'aide de une section était créée selon le modèle de la table parent avec une contrainte sur la date souhaitée,de sorte qu'à la lecture des données, cela ne se fasse que dans celle-ci.
PG10 : première tentative
Mais le partitionnement par héritage était historiquement mal adapté au traitement d'un flux actif d'écritures ou à un grand nombre de sections enfants. Par exemple, on peut se souvenir que l'algorithme de sélection de la section appropriée avait une complexité quadratique, ce qui, avec 100+ sections, fonctionnait, vous comprenez comment...
Dans PG10, cette situation a été considérablement optimisée en introduisant la prise en charge du . Nous avons donc immédiatement essayé de l'appliquer juste après la migration du stockage, mais…
Comme il s'est avéré après avoir fouillé le manuel, une table nativement partitionnée dans cette version :
- ne prend pas en charge la description des index
- ne prend pas en charge les triggers
- ne peut pas être elle-même un « descendant »
- ne prend pas en charge
INSERT ... ON CONFLICT - ne sait pas générer une section automatiquement
Après avoir reçu un coup de pied au visage, nous avons compris qu'il était impossible de contourner la modification de l'application et avons retardé nos recherches pendant six mois.
PG10 : deuxième chance
Ainsi, nous avons commencé à résoudre les problèmes rencontrés un à un :
- Puisque les triggers et
ON CONFLICTnous étaient parfois nécessaires, nous avons créé une table proxy. - Nous avons éliminé le « routage » dans les triggers — c'est-à-dire de
EXECUTE. - Nous avons extrait séparément la table modèle avec tous les index, afin qu'ils ne figurent même pas dans la table proxy.
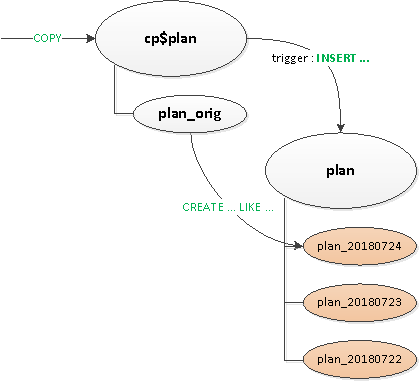
Enfin, après tout cela, nous avons nativement partitionné la table principale. La création d'une nouvelle section reste pour l'application.
Nous « sculptons » les dictionnaires
Comme dans tout système analytique, nous avions aussi des « faits » et des « découpes » (dictionnaires). Dans notre cas, cela était représenté par exemple par des requêtes lentes de type similaire ou le texte même de la requête.
Les « faits » étaient déjà partitionnés par jour depuis longtemps, donc nous avons pu supprimer les sections obsolètes sans problème (après tout, ce sont juste des logs !). En revanche, pour les dictionnaires, cela a posé problème…
Ce n'est pas qu'il y en avait énormément, mais environ pour 100 To de « faits », il y avait un dictionnaire de 2,5 To. Il est difficile de supprimer quoi que ce soit d'une telle table dans un délai raisonnable, et l'écriture dans celle-ci devenait de plus en plus lente.
On dirait un dictionnaire… où chaque entrée devrait être représentée exactement une fois… et c'est vrai, mais !.. Personne ne nous empêche d'avoir un dictionnaire séparé pour chaque jour! Oui, cela apporte une certaine redondance, mais cela permet :
- d'écrire/ lire plus rapidement grâce à une taille de section plus petite
- de consommer moins de mémoire grâce à des index plus compacts
- de stocker moins de données grâce à la possibilité de supprimer rapidement les éléments obsolètes
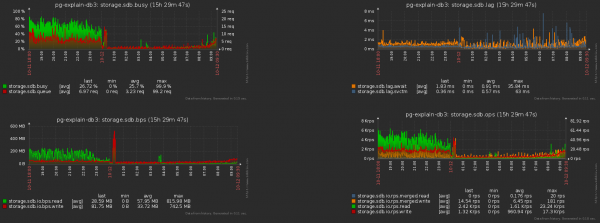
À la suite de l'ensemble de ces mesures la charge CPU a diminué d'environ 30 %, et celle du disque d'environ 50 %:
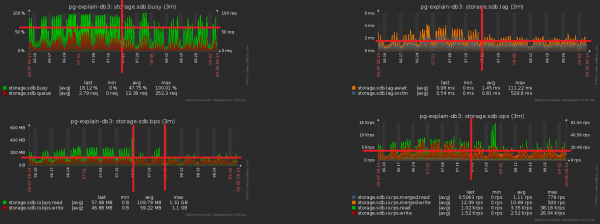
Nous avons continué à écrire dans la base exactement la même chose, juste avec une charge moindre.
#2. Эволюция и рефакторинг БД
Nous avons donc convenu que nous avons une section dédiée pour chaque jour avec des données. En effet, CHECK (dt = '2018-10-12'::date) — c'est la clé de partitionnement et la condition d'inclusion d'un enregistrement dans une section particulière.
Comme tous les rapports de notre service sont établis sur la base d'une date spécifique, les index, même ceux des « temps non partitionnés », étaient tous de type (Serveur, Date, Modèle de plan), (Serveur, Date, Nœud de plan), (Date, Classe d'erreur, Serveur),…
Mais maintenant, chaque section a ses propres instances de chaque tel index... Et dans chaque section, la date est une constante... Cela signifie que nous inscrivons maintenant une constante comme l'un des champs dans chaque index, ce qui augmente à la fois son volume et le temps de recherche, sans apporter aucun résultat. Nous avons laissé des pièges pour nous-mêmes, oups... L'orientation de l'optimisation est évidente — il suffit de
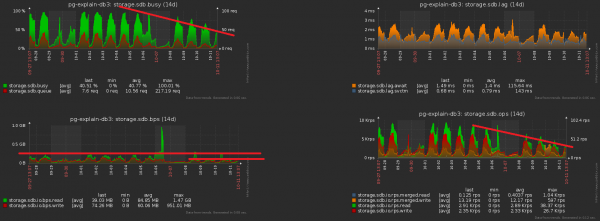
retirer le champ de la date de tous les index des tables partitionnées. Avec nos volumes, le gain est d'environ 1 To/semaine Et maintenant, remarquons que ce téraoctet devait également être écrit d'une manière ou d'une autre. Cela signifie que nous devons également!
charger moins le disque ! Sur cette image, on peut bien voir l'effet obtenu après le nettoyage que nous avons consacré une semaine à réaliser :L'un des grands problèmes des systèmes chargés est
#3. «Размазываем» пиковую нагрузку
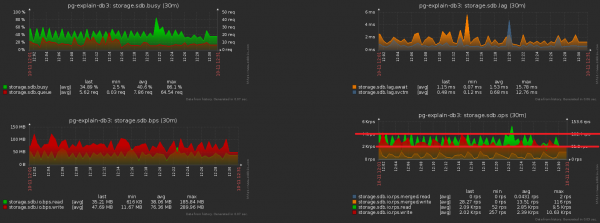
la synchronisation excessive de certaines opérations qui ne le nécessitent pas. Parfois « parce qu'on ne l'a pas remarqué », parfois « c'était plus simple », mais tôt ou tard, il faut s'en débarrasser. En rapprochant l'image précédente, nous voyons que le disque
« pompe » la charge avec une amplitude double entre les relevés voisins, ce qui ne devrait clairement pas être « statistiquement » le cas avec un tel nombre d'opérations : Il est assez simple d'y parvenir. Notre surveillance était déjà configurée pour
près de 1000 serveurs , chacun traité par un flux logique distinct, et chaque flux envoie les informations accumulées vers la base à une fréquence définie, à peu près comme ceci :setInterval(sendToDB, interval)
Le problème réside précisément dans le fait quetous les flux démarrent à peu près en même temps , donc les moments d'envoi coïncident presque toujours « jusqu'à la pointe ». Oups n°2...Heureusement, cela se corrige assez facilement,
en ajoutant un « décalage aléatoire » dans le temps : setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))
Le troisième problème traditionnel du highload est#4. Кэшируем, что нужно можно
l'absence de cache là où il devrait être. pourrais être.
Par exemple, nous avons rendu possible l'analyse par nœud de plan (tous ces Scan Seq sur les utilisateurs), mais penser tout de suite qu'ils sont, dans l'ensemble, identiques — c'est oublier.
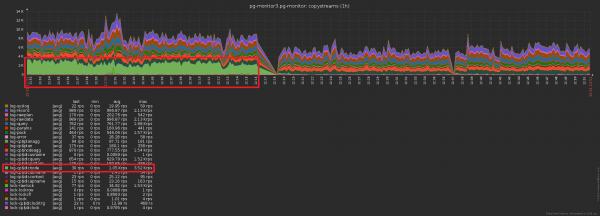
Non, bien sûr, rien n'est réécrit dans la base, cela coupe le déclencheur avec INSERT ... ON CONFLICT DO NOTHING. Mais ces données atteignent quand même la base, et cela implique aussi une lecture supplémentaire pour vérifier le conflit. Cela doit être fait. Oups n°3… La différence dans le nombre d'enregistrements envoyés à la base avant/après l'activation du caching est évidente :
Et cela — une diminution concomitante de la charge sur le stockage :
«Téraoctets par jour» sonne seulement effrayant. Si vous faites tout correctement, c'est juste
Au total
2^40 octets / 86400 secondes = ~12.5 Mo/s , ce que même les disques durs IDE de bureau pouvaient gérer. 🙂Et pour être sérieux, même avec un «biais» de charge multiplié par dix pendant une journée, vous pouvez tranquillement respecter les capacités des SSD modernes.
Récemment, j'ai expliqué comment augmenter les performances des requêtes SQL «de lecture» grâce à des recettes standard.
Source : habr.com
