

Bon vendredi à tous ! Amis, aujourd'hui nous continuons notre série de publications consacrées au cours , car les cours du nouveau groupe commencent à la fin de la semaine prochaine. Alors, commençons !
La surveillance — c'est tout simplement. C'est un fait bien connu. Déployez Nagios, lancez NRPE sur le système distant, configurez Nagios sur le port NRPE TCP 5666 et vous avez la surveillance.
C'est si facile que c'en est ennuyeux. Maintenant, vous avez les principales métriques concernant le temps CPU, le sous-système de disque, la mémoire vive, qui sont incluses par défaut dans Nagios et NRPE. Mais en réalité, ce n'est pas vraiment de la « surveillance » en tant que telle. C'est juste un début.
(On installe généralement PNP4Nagios, RRDtool et Thruk, on configure les notifications dans Slack et on file directement sur nagiosexchange, mais pour l'instant, passons cela).
Une bonne surveillance est en réalité assez complexe, vous devez vraiment connaître les entrailles de l'application que vous surveillez.
La surveillance, c'est compliqué ?
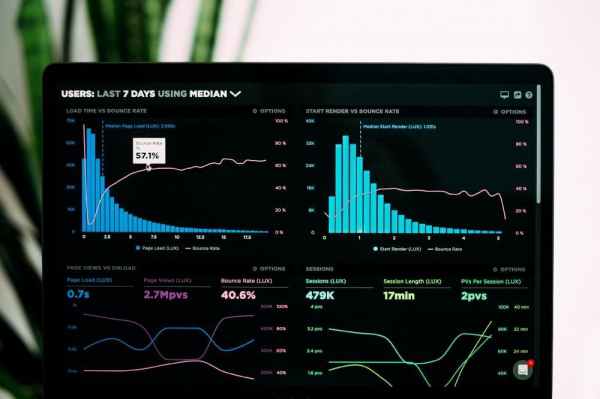
Tout serveur, qu'il soit Linux ou Windows, aura par définition une certaine fonction. Apache, Samba, Tomcat, stockage de fichiers, LDAP — tous ces services sont plus ou moins uniques dans un ou plusieurs aspects. Chacun a sa fonction, ses caractéristiques. Il existe différentes façons d'obtenir les métriques, KPI (indicateurs clés de performance) qui vous intéressent, lorsque le serveur est sous charge.
Auteur de la photo sur
(j'aimerais que mes tableaux de bord soient peints en bleu néon — soupirant de rêverie —... hum...)
Tout logiciel fournissant des services doit avoir un mécanisme pour recueillir des métriques. Apache a le module mod-status, qui affiche la page d'état du serveur. Nginx a stub_status. Tomcat a JMX ou des applications web spécifiques qui montrent des métriques clés. En MySQL, il existe la commande « show global status », etc.
Alors pourquoi les développeurs n'intègrent-ils pas de tels mécanismes dans les applications qu'ils créent ?
Seuls les développeurs font cela ?
Un certain degré d'indifférence à l'égard de l'intégration des métriques ne se limite pas aux développeurs. J'ai travaillé dans des entreprises qui développaient des applications avec Tomcat et n'offraient aucune de leurs métriques, aucun journal d'activité du service, à part les journaux d'erreurs généralistes de Tomcat. Certains développeurs générent une abondance de journaux, qui n'ont aucune signification pour l'administrateur système qui a eu la malchance de les lire à 3h15 du matin.
Auteur de la photo sur
Les ingénieurs système qui permettent à ces produits de sortir en production doivent également assumer une certaine responsabilité à cet égard. Peu d'ingénieurs système prennent le temps ou se soucient d'essayer d'obtenir des métriques significatives à partir des journaux, sans le contexte de ces métriques et la capacité de les interpréter à la lumière de l'activité de l'application. Certains ne réalisent pas combien ils peuvent bénéficier de cela, au-delà des indicateurs comme "quelque chose ne va pas actuellement (ou le sera bientôt)".
Le changement de mentalité concernant la nécessité des métriques doit se produire non seulement parmi les développeurs, mais aussi chez les ingénieurs système.
Pour tout ingénieur système qui doit non seulement réagir aux événements critiques mais aussi garantir leur absence, le manque de métriques est généralement un obstacle à cela.
Cependant, les ingénieurs système ne plongent généralement pas dans le code, ils génèrent des revenus pour leur entreprise. Ils ont besoin de développeurs leaders qui comprennent l'importance de la responsabilité de l'ingénieur système dans l'identification des problèmes, l'augmentation de la sensibilisation aux problèmes de performance, et ainsi de suite.
Ce truc de devops
La mentalité devops décrit la synergie entre la pensée des développeurs (dev) et des opérations (ops). Toute entreprise affirmant qu'elle "pratique le devops" doit :
- dire ce qu'elle fait probablement pas (clin d'œil à un mème du film "La Princesse Bride" - "Je ne pense pas que cela signifie ce que vous pensez que cela signifie !")
- encourager une position d'amélioration continue du produit.
Vous ne pouvez pas améliorer un produit et savoir qu'il a été amélioré si vous ne connaissez pas son fonctionnement actuel. Vous ne pourrez pas comprendre comment le produit fonctionne si vous ne comprenez pas comment ses composants, les services dont il dépend, ses principaux points de douleur et ses goulets d'étranglement fonctionnent.
Si vous n'observez pas les goulets d'étranglement potentiels, vous ne pourrez pas suivre la méthode des "Cinq pourquoi" lors de la rédaction d'un Postmortem. Vous ne pourrez pas tout rassembler sur un écran pour voir comment le produit fonctionne ou comprendre à quoi il ressemble "normal et heureux".
Déplacement vers la gauche, À GAUCHE, J'AI DIT, À GAUCHE—
Pour moi, l'un des principes clés de Devops est le "Déplacement vers la gauche" (shift left). Dans ce contexte, le déplacement vers la gauche signifie décaler la possibilité (pas la responsabilité, mais les capacités) de faire ce dont se préoccupent généralement les ingénieurs systèmes, par exemple, créer des métriques de performance, utiliser les journaux de manière plus efficace, etc., en amont du cycle de vie de livraison des logiciels (Software Delivery Life Cycle).
Auteur de la photo sur
Les développeurs de logiciels doivent avoir la possibilité d'utiliser et de connaître les outils de surveillance utilisés par l'entreprise pour surveiller sous toutes ses formes, les métriques, la journalisation, les interfaces de surveillance et, surtout, observer comment leur produit fonctionne en production. Vous ne pouvez pas forcer les développeurs à investir du temps et des efforts dans la surveillance tant qu'ils ne peuvent pas voir les métriques et influencer leur apparence, comment le propriétaire du produit va les présenter à son CTO lors du prochain briefing, etc.
En somme
- Menez le cheval à l'eau. Montrez aux développeurs combien de problèmes ils peuvent éviter, aidez-les à identifier les bons KPI et métriques pour leurs applications, afin qu'il y ait moins de cris du propriétaire du produit, qui est souvent crié par le directeur technique (CTO). Exposez-les calmement et doucement. Si cela ne fonctionne pas, achetez, menacez ou persuadez soit eux, soit le propriétaire du produit, pour mettre en œuvre rapidement la collecte de ces métriques à partir des applications, puis créez des graphiques. Cela sera difficile, car cela ne sera pas considéré comme une priorité, et il y aura de nombreux projets en attente de mise en œuvre dans la feuille de route du produit qui génèrent des revenus. Vous aurez donc besoin d'une justification économique pour justifier le temps et les ressources consacrées à l'intégration de la surveillance dans le produit.
- Aidez les ingénieurs système à dormir. Montrez-leur que l'utilisation de la check-list « publication » pour tout produit publié est bénéfique. Vérifier que toutes les applications en production sont couvertes par des métriques peut aider à garantir un sommeil serein la nuit, permettant aux développeurs de voir ce qui fonctionne ou non. Cependant, la meilleure façon d'irriter et de frustrer un développeur, un chef de produit ou un directeur technique est de mettre des bâtons dans les roues et de résister. Ce comportement aura des conséquences sur la date de sortie de tout produit; si l'on attend jusqu'à la dernière minute, refaites donc ce décalage à gauche et intégrez ces questions dans le plan de projet le plus tôt possible. Si nécessaire, intégrez-vous aux réunions consacrées au produit. Portez de fausses moustaches et un feutre ou quelque chose du genre, cela ne vous trahira jamais. Faites part de vos problèmes, montrez les avantages évidents et evangelisez.
- Assurez-vous que les développeurs (dev) et les opérations (ops) comprennent la signification et les conséquences du passage des métriques du produit en « zone rouge ». Ne laissez pas les opérations être les seuls gardiens de la fonctionnalité du produit ; assurez-vous que les développeurs y participent aussi (#productsquads).
- Les journaux sont une chose formidable, mais les métriques le sont aussi. Combinez-les et ne laissez pas vos journaux se transformer en débris dans une énorme boule enflammée d'inutilité. Expliquez et montrez aux développeurs pourquoi personne d'autre qu'eux ne peut comprendre leurs journaux, montrez-leur ce que c'est de regarder des journaux inutiles à 3h15 du matin.
Auteur de la photo sur
C'est tout pour le moment. Un nouveau matériel sera publié la semaine prochaine. Si vous souhaitez en savoir plus sur le cours, nous vous invitons à , qui aura lieu lundi. Et pour l'instant, nous attendons traditionnellement vos commentaires.
Source : habr.com
